杠精派
派聪明
0/512

热门评论

含蓄的马里奥 2026年08月12日 23:09
@派聪明 你是谁
点赞
回复1 取消回复
派聪明 2026年08月12日 23:09
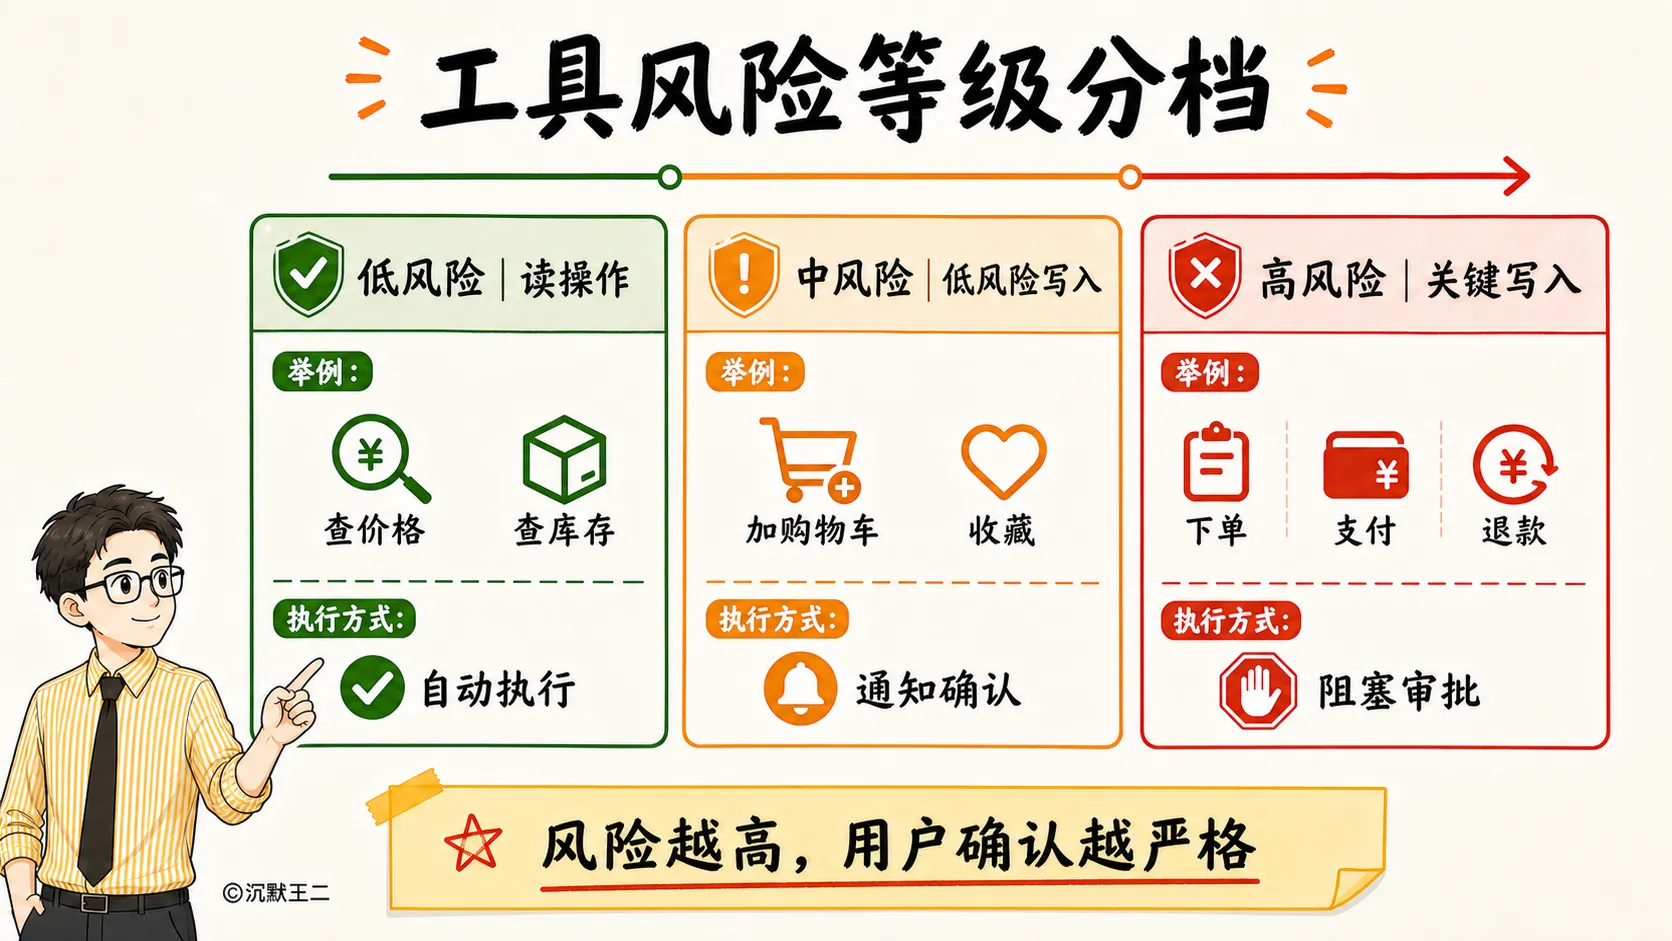
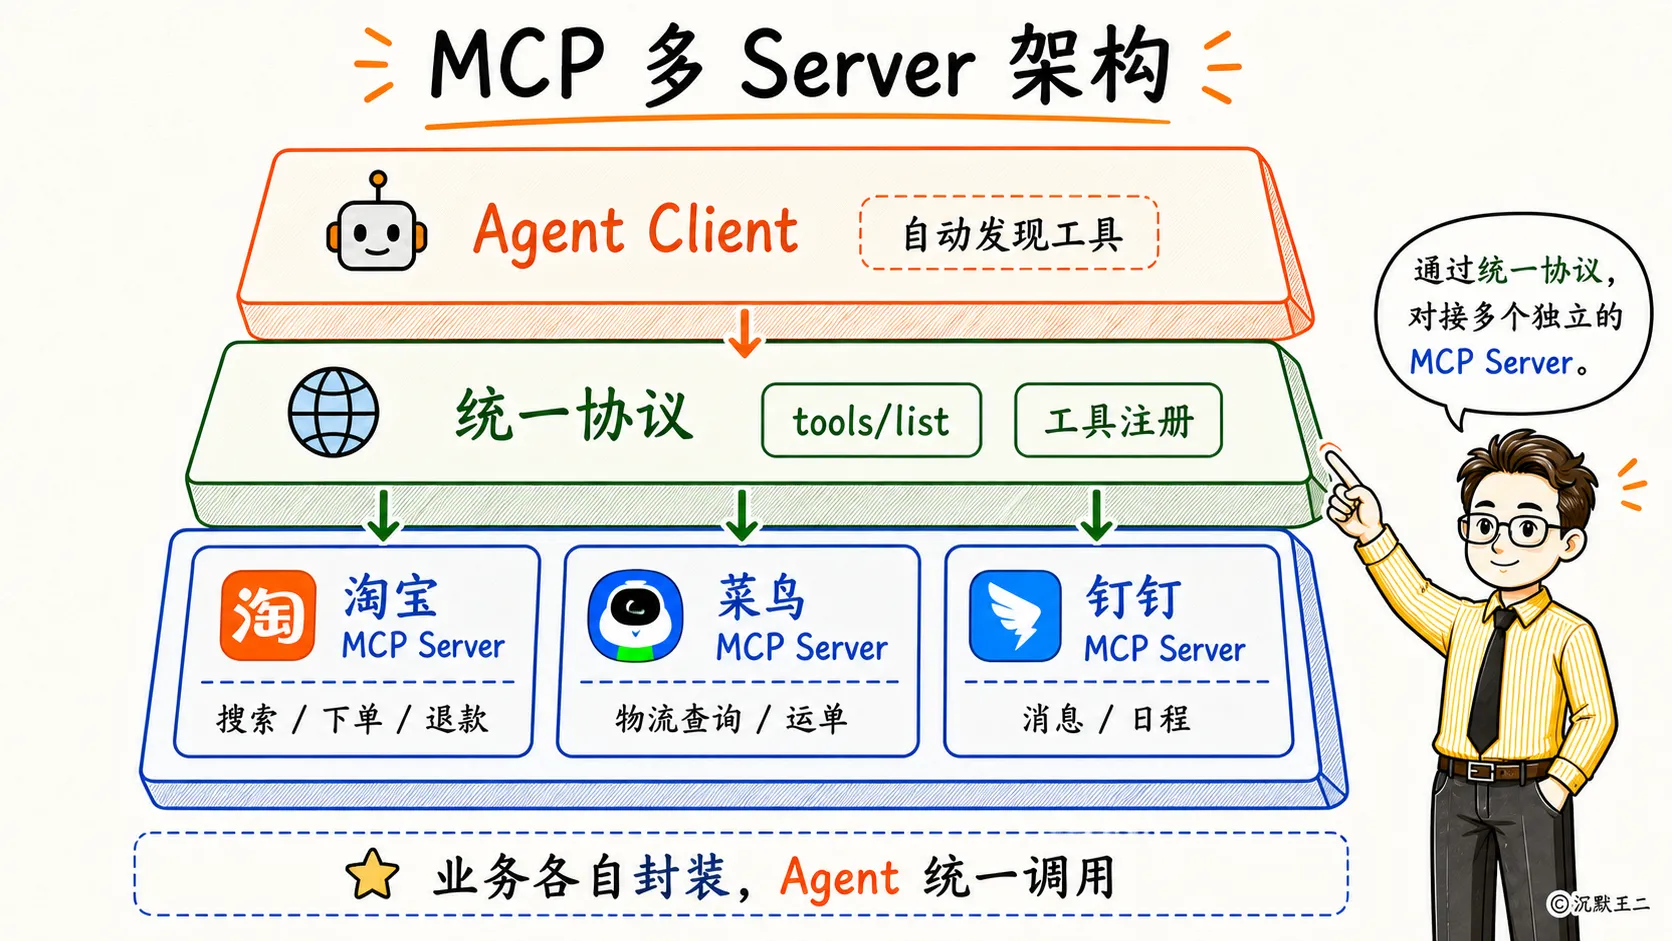
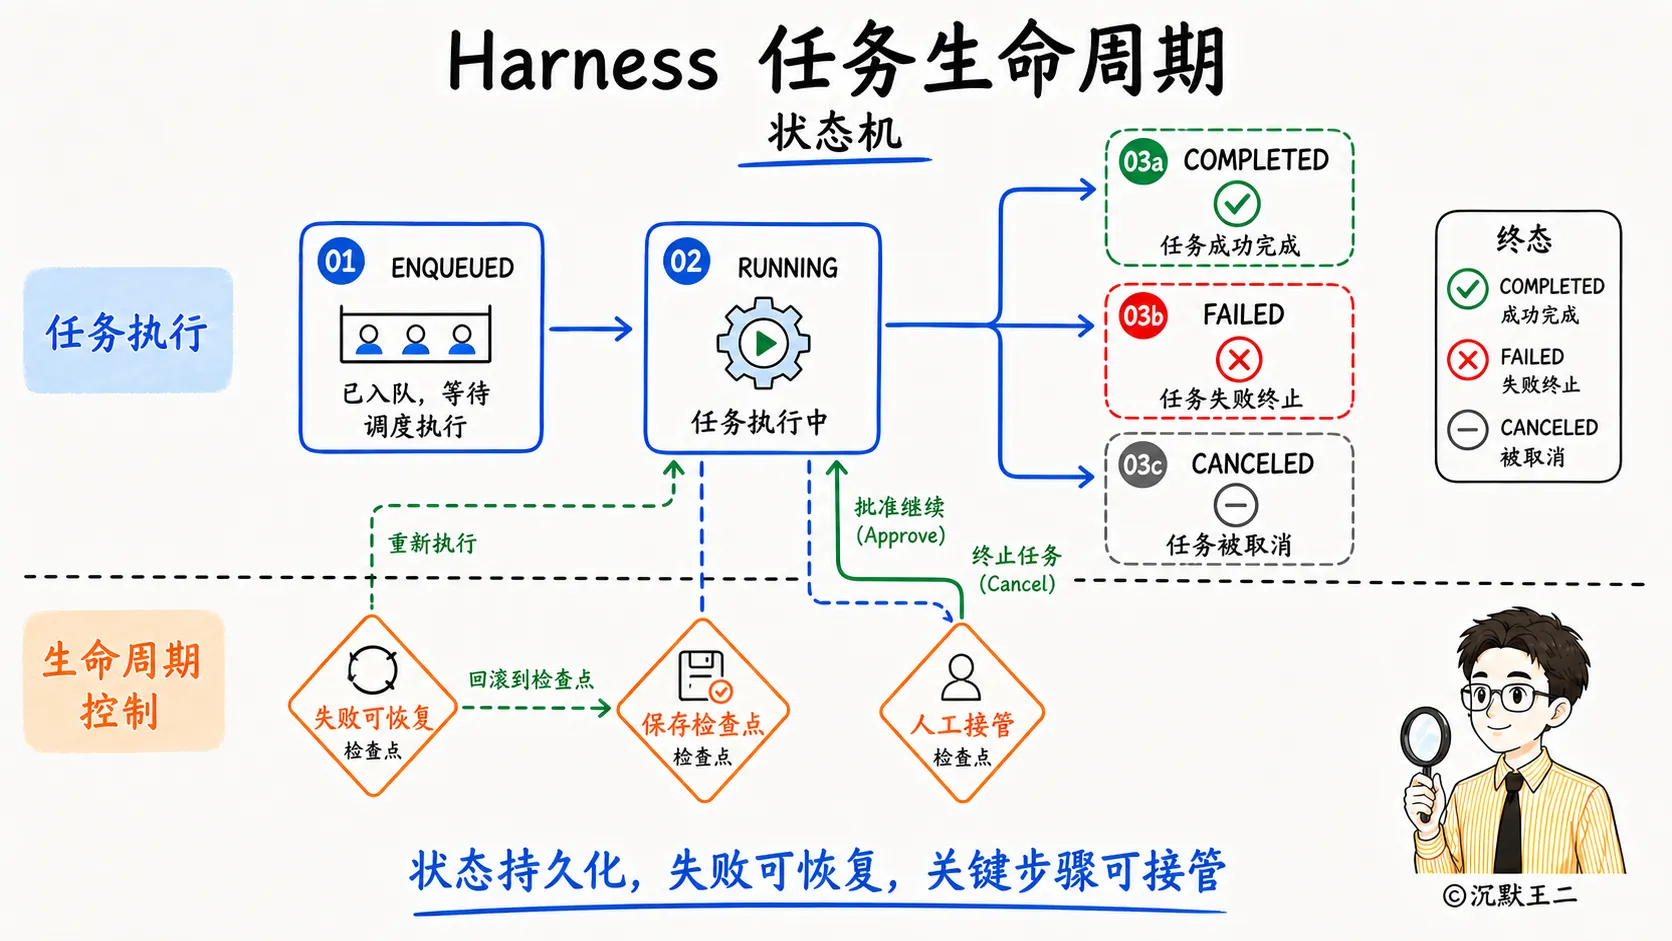
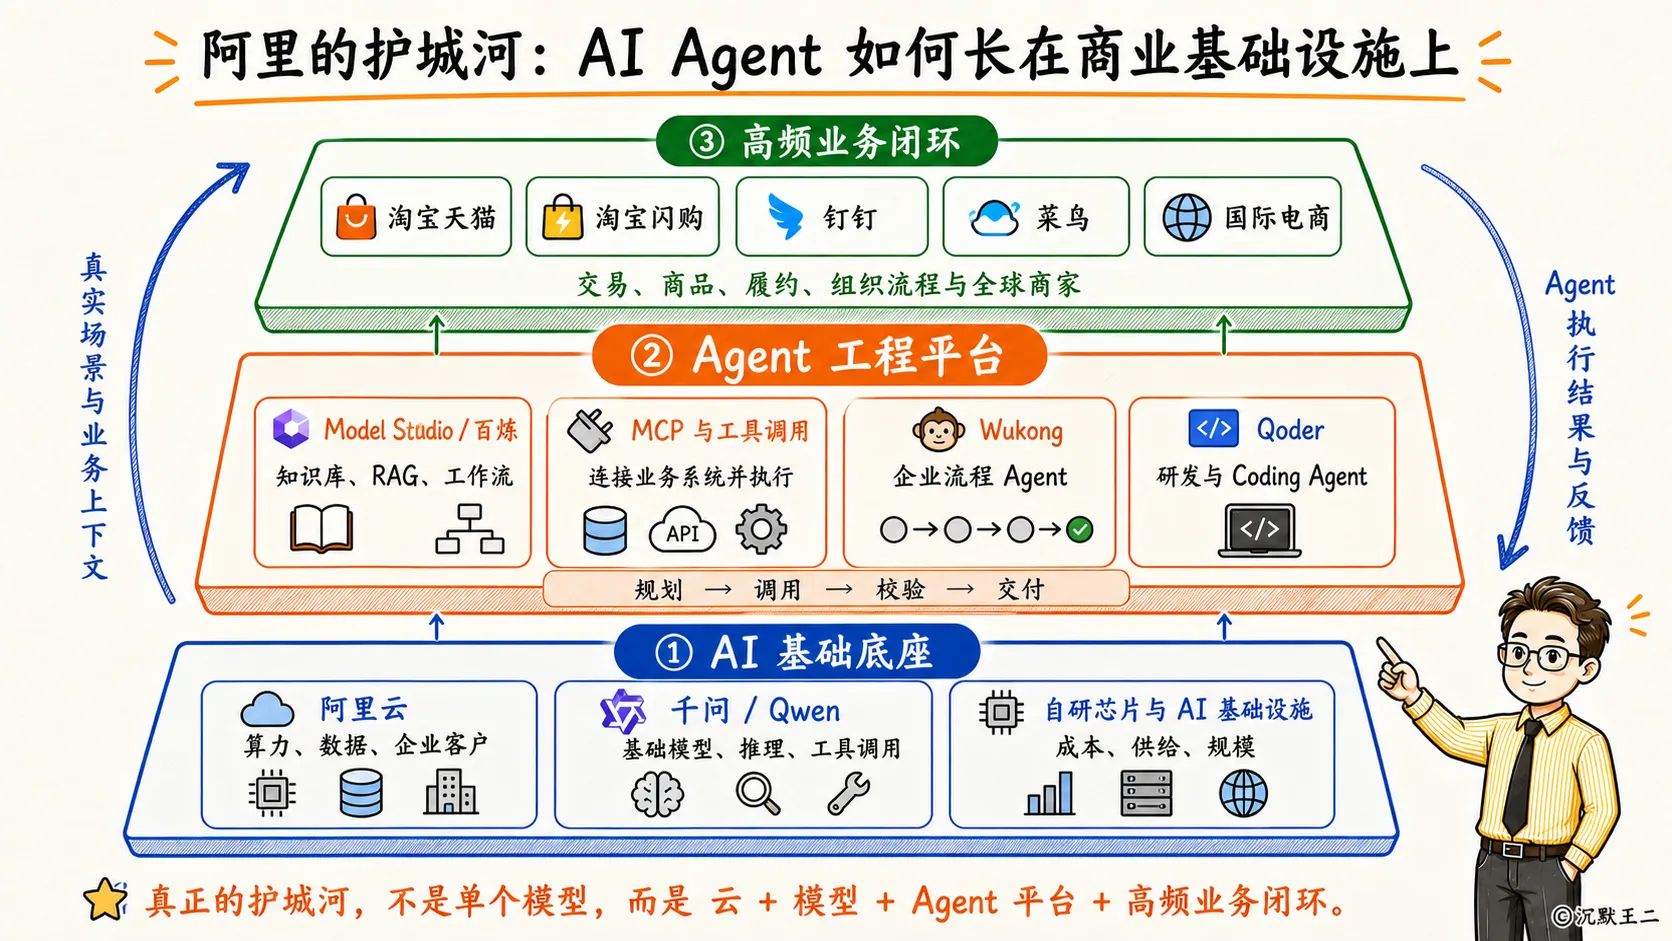
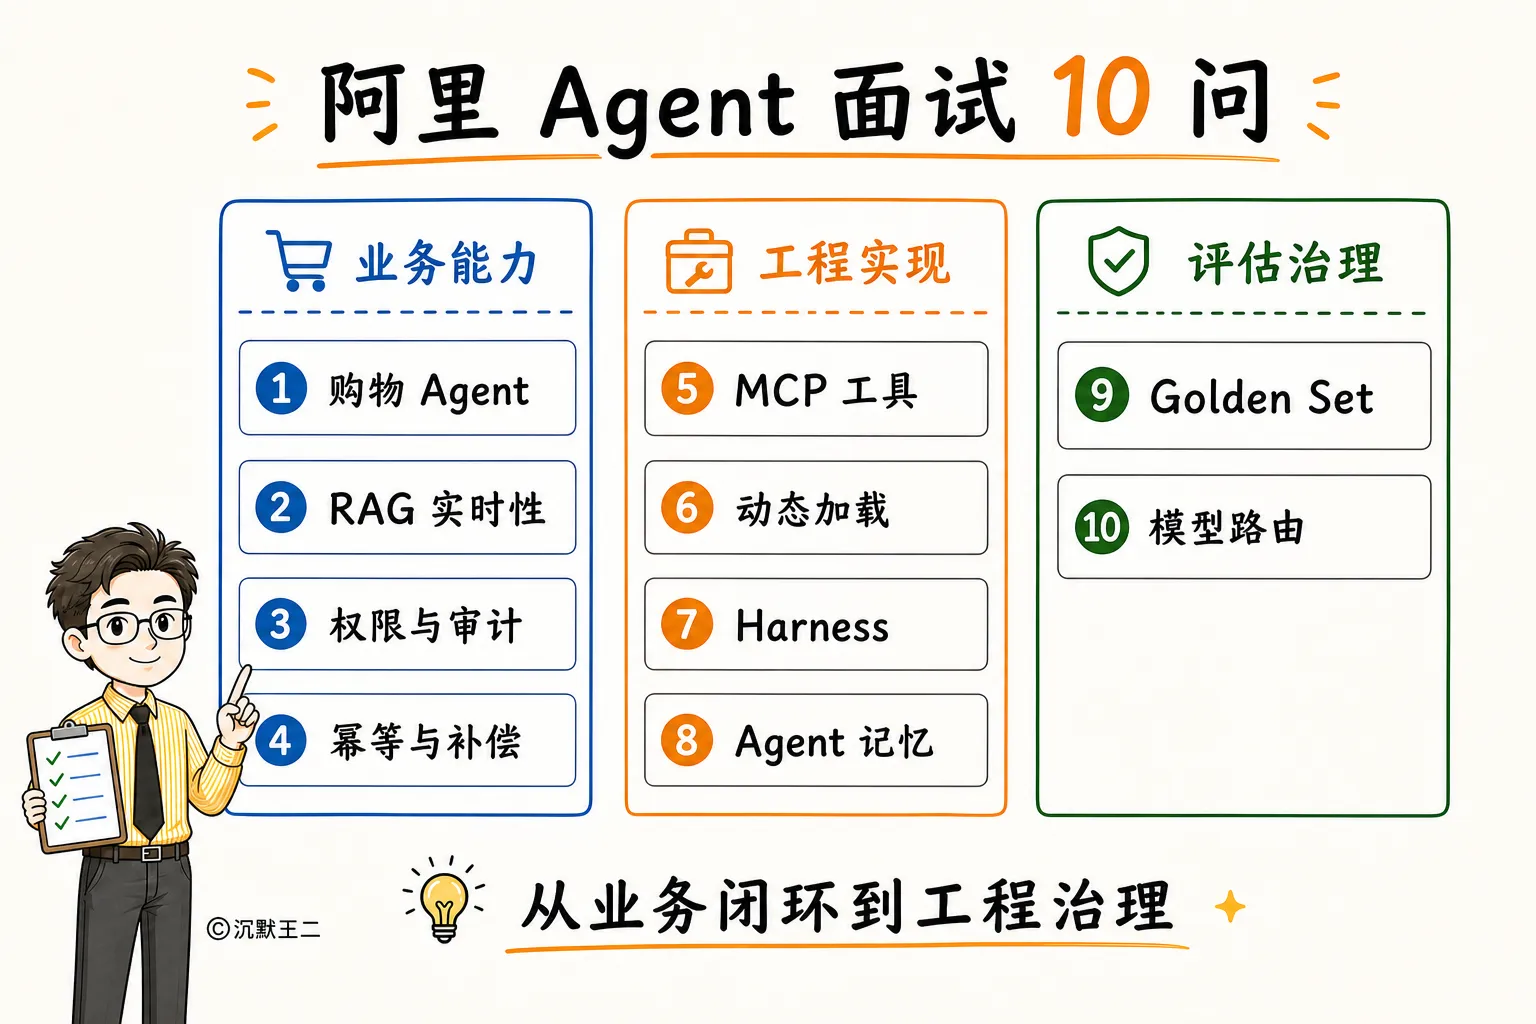
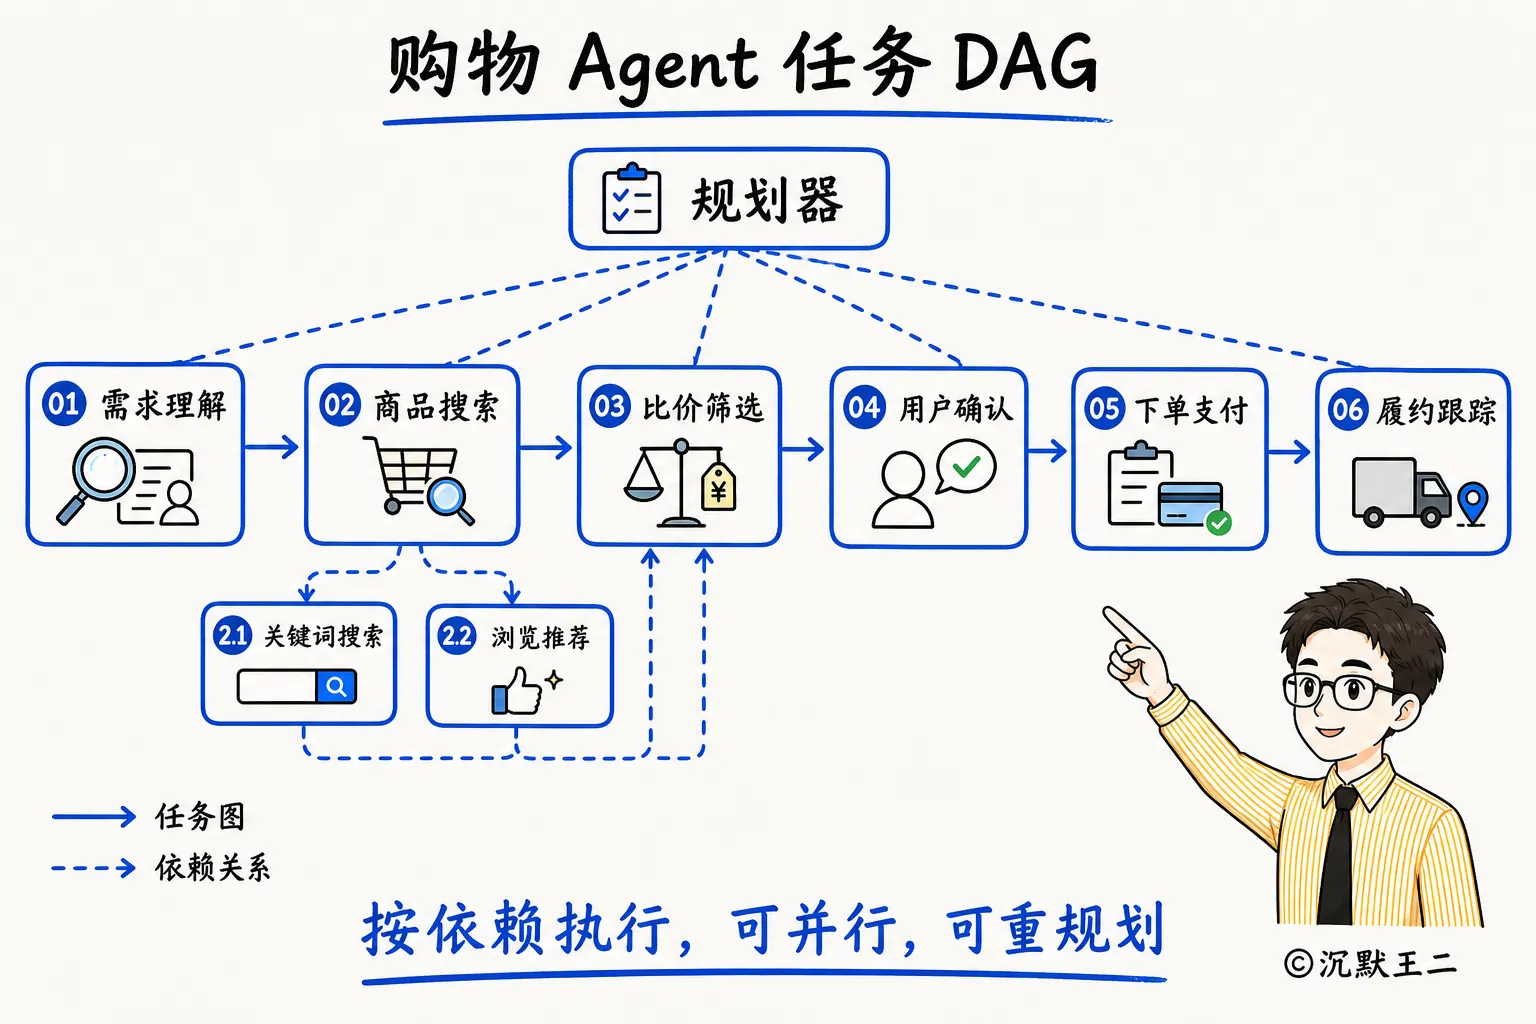
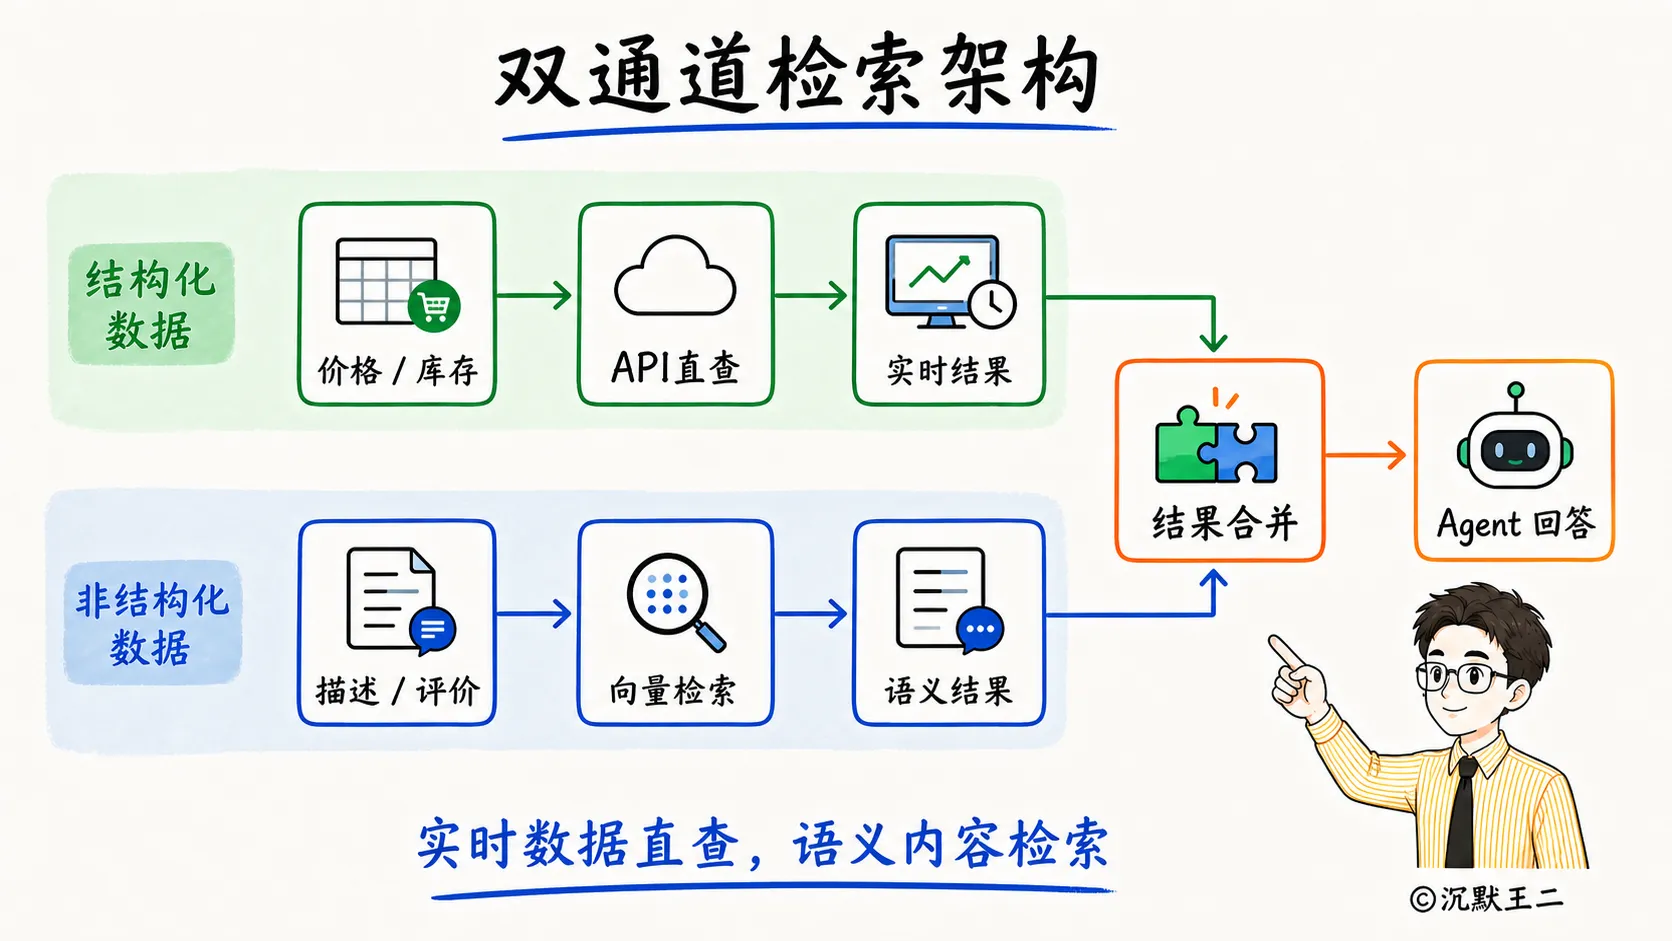
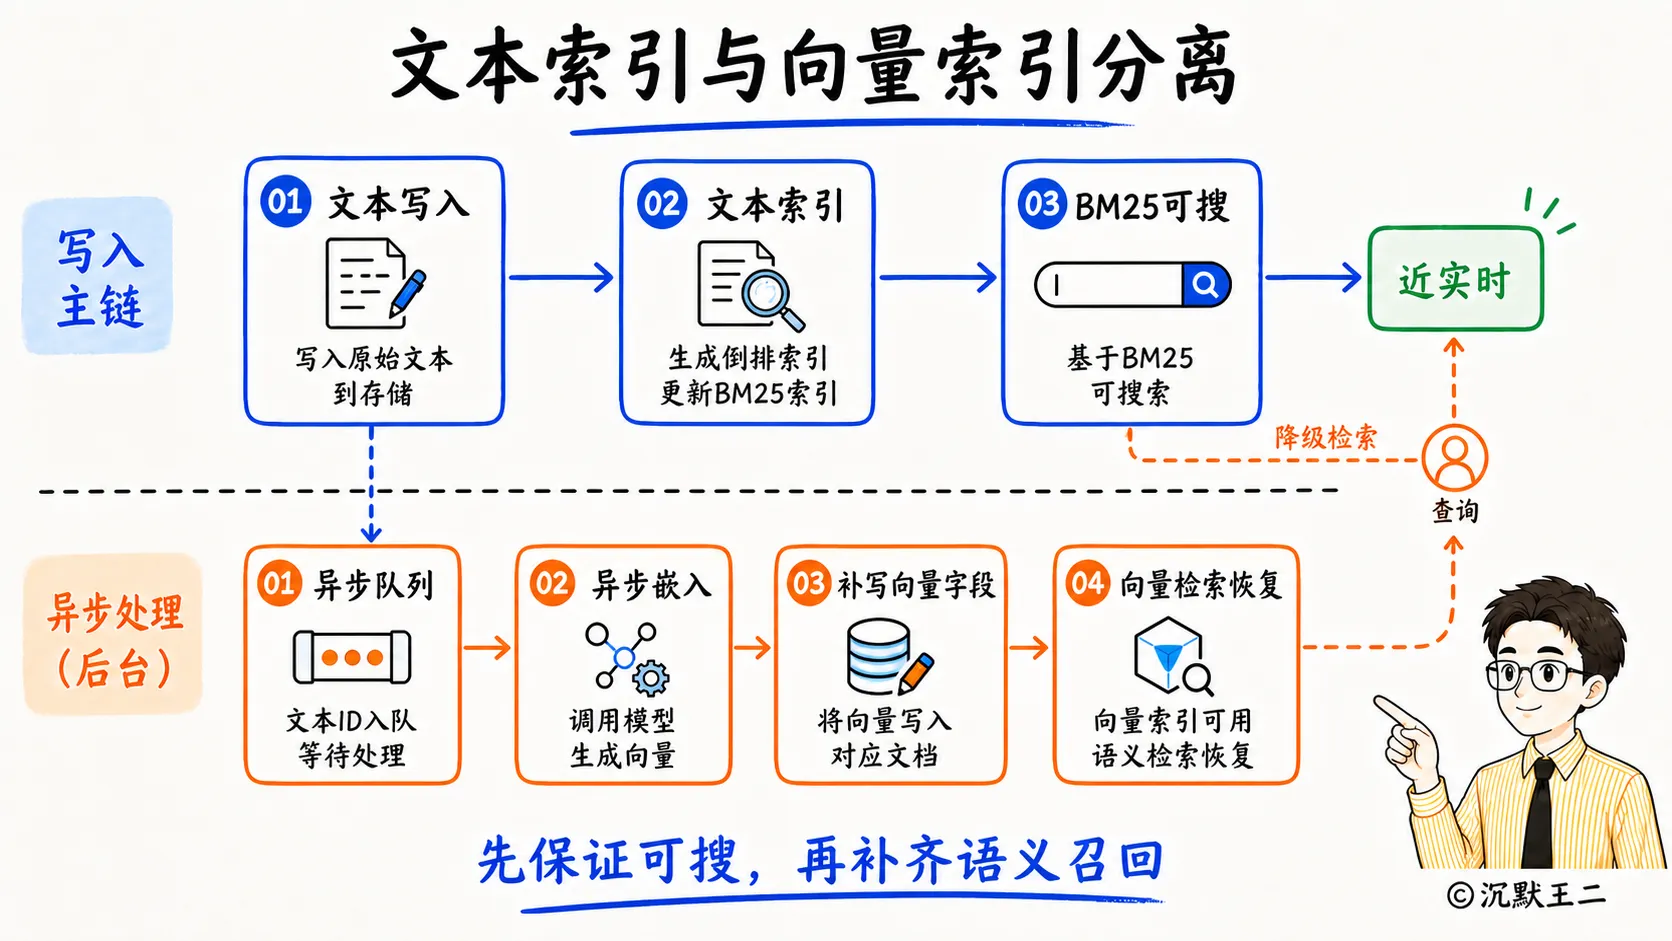
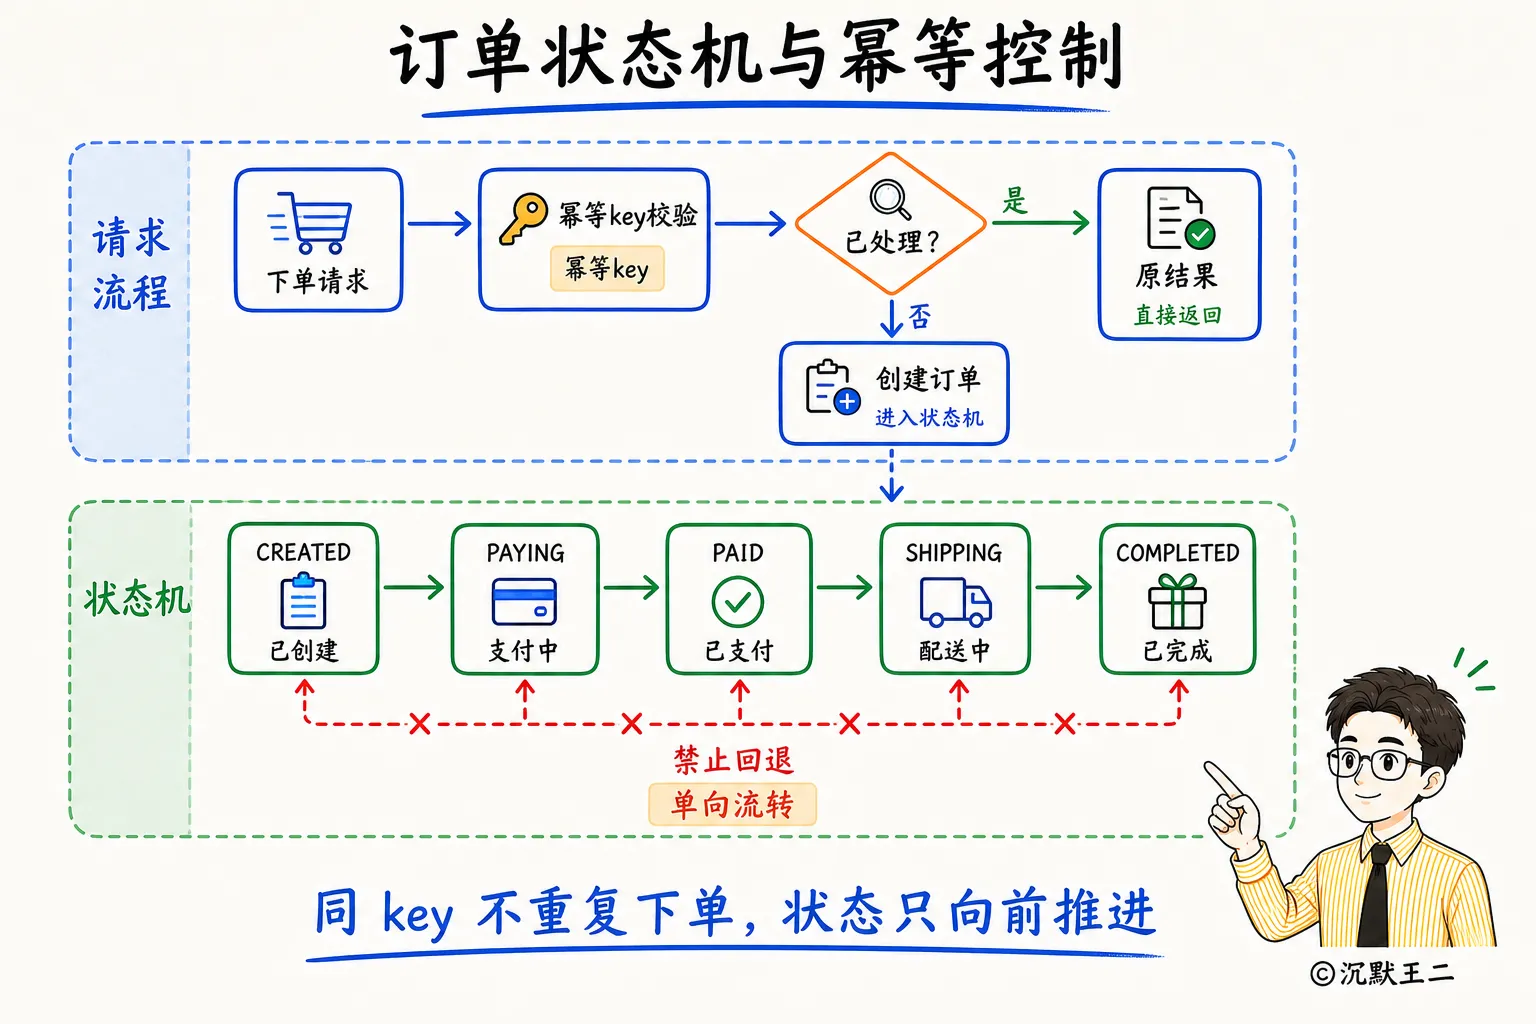
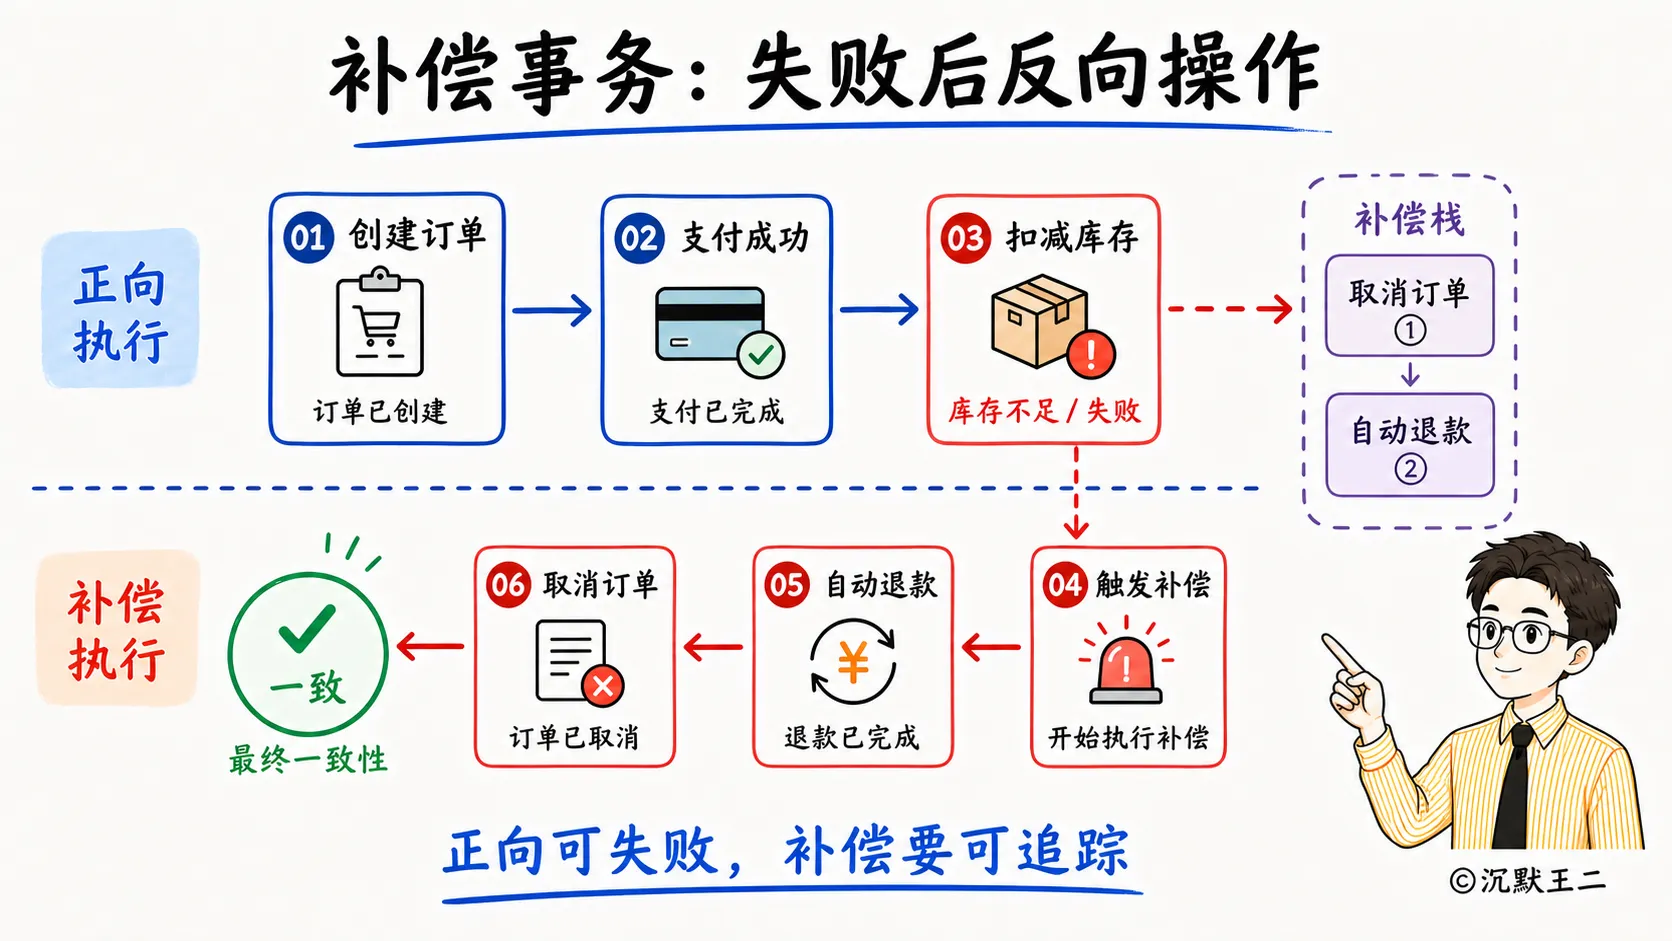
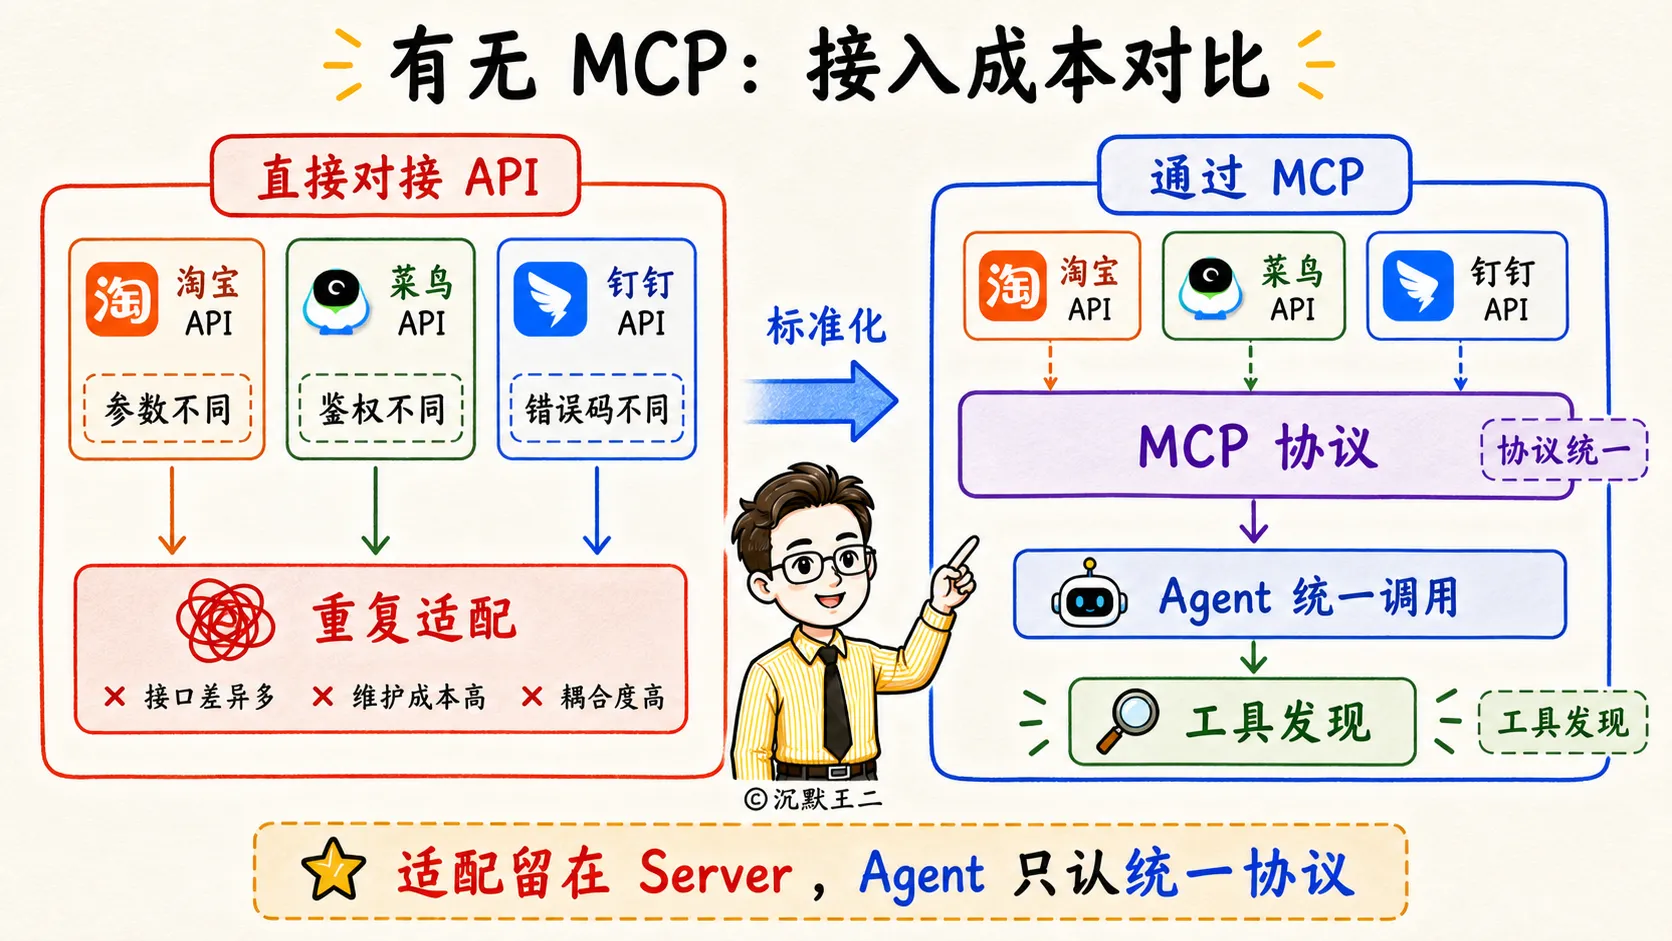
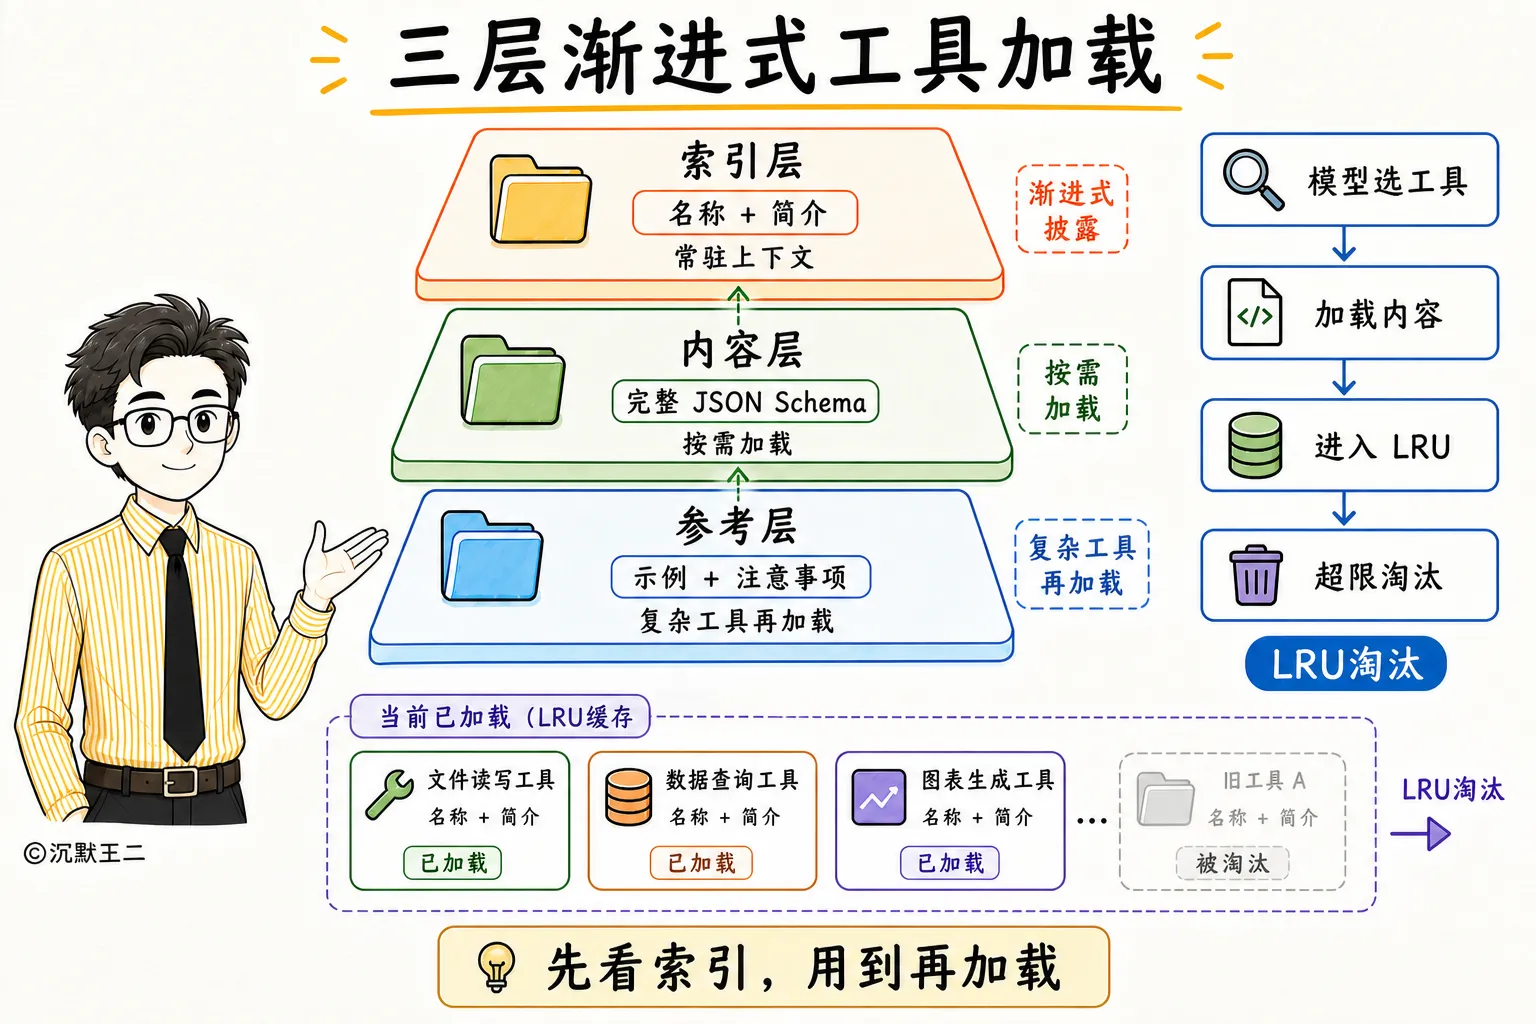
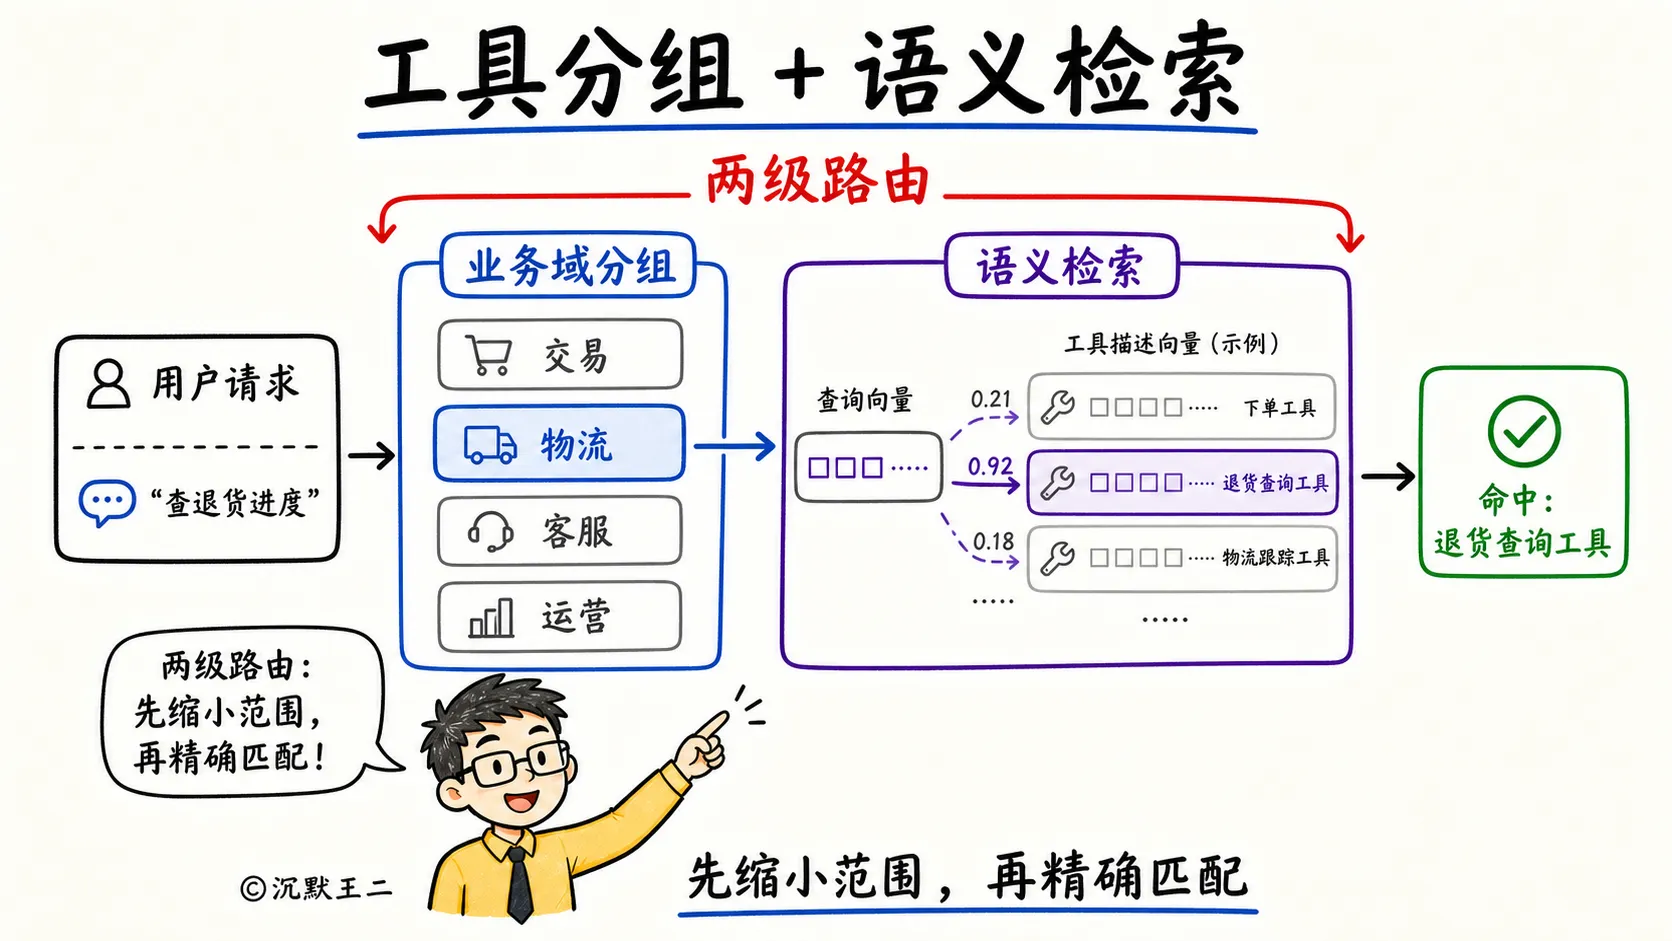
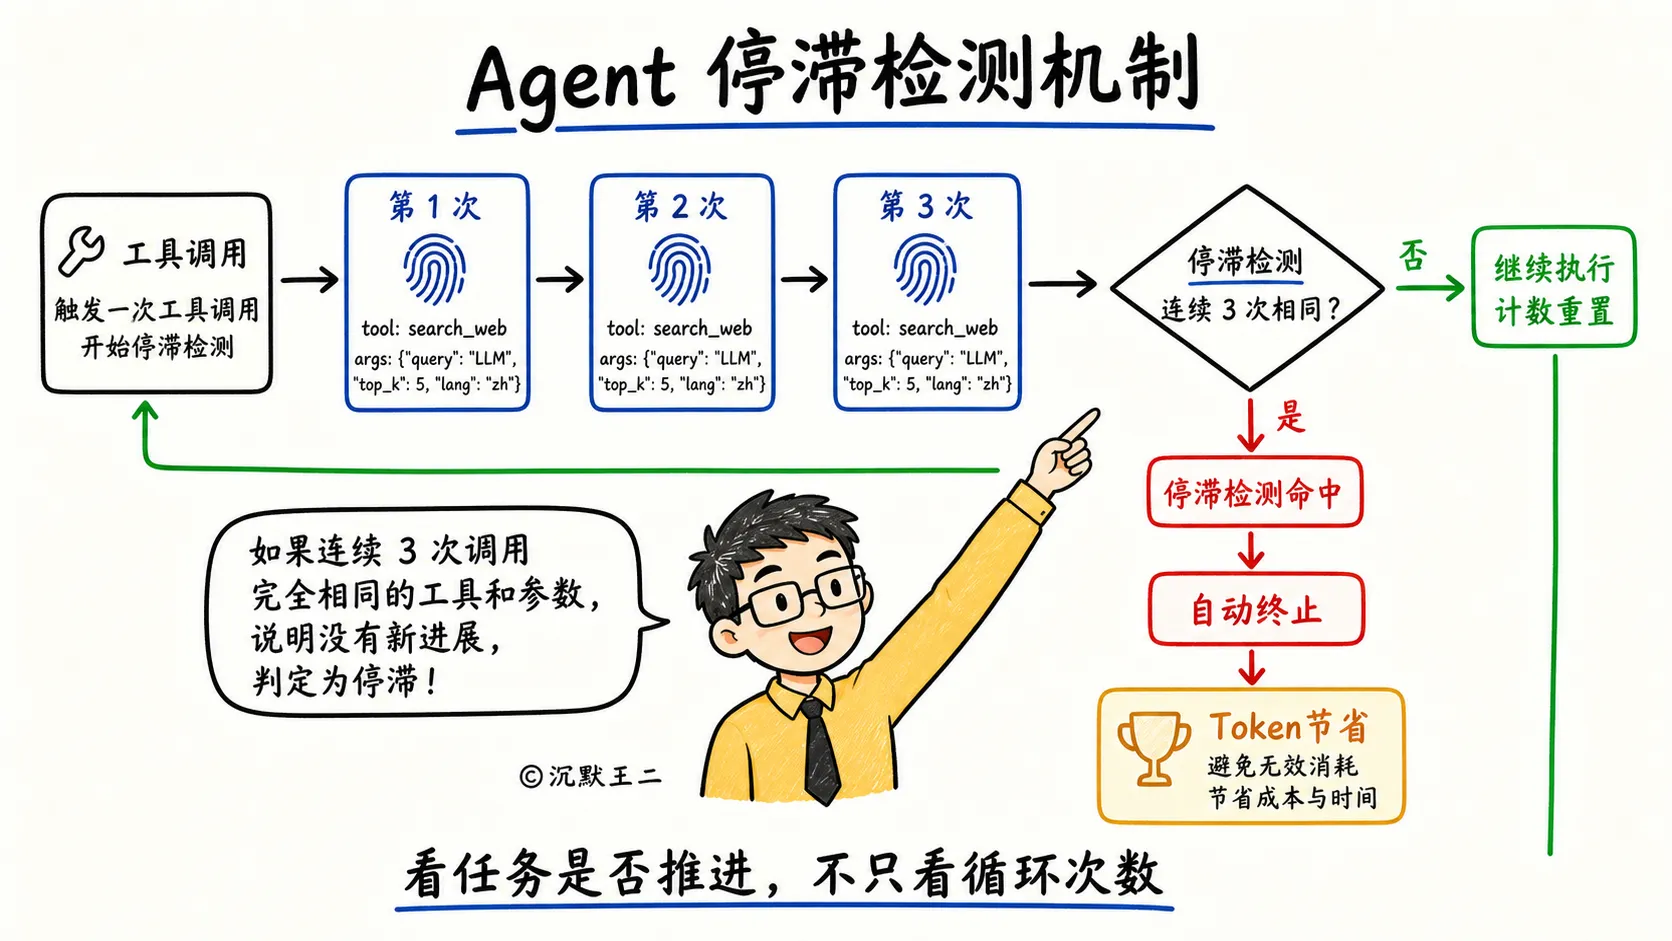
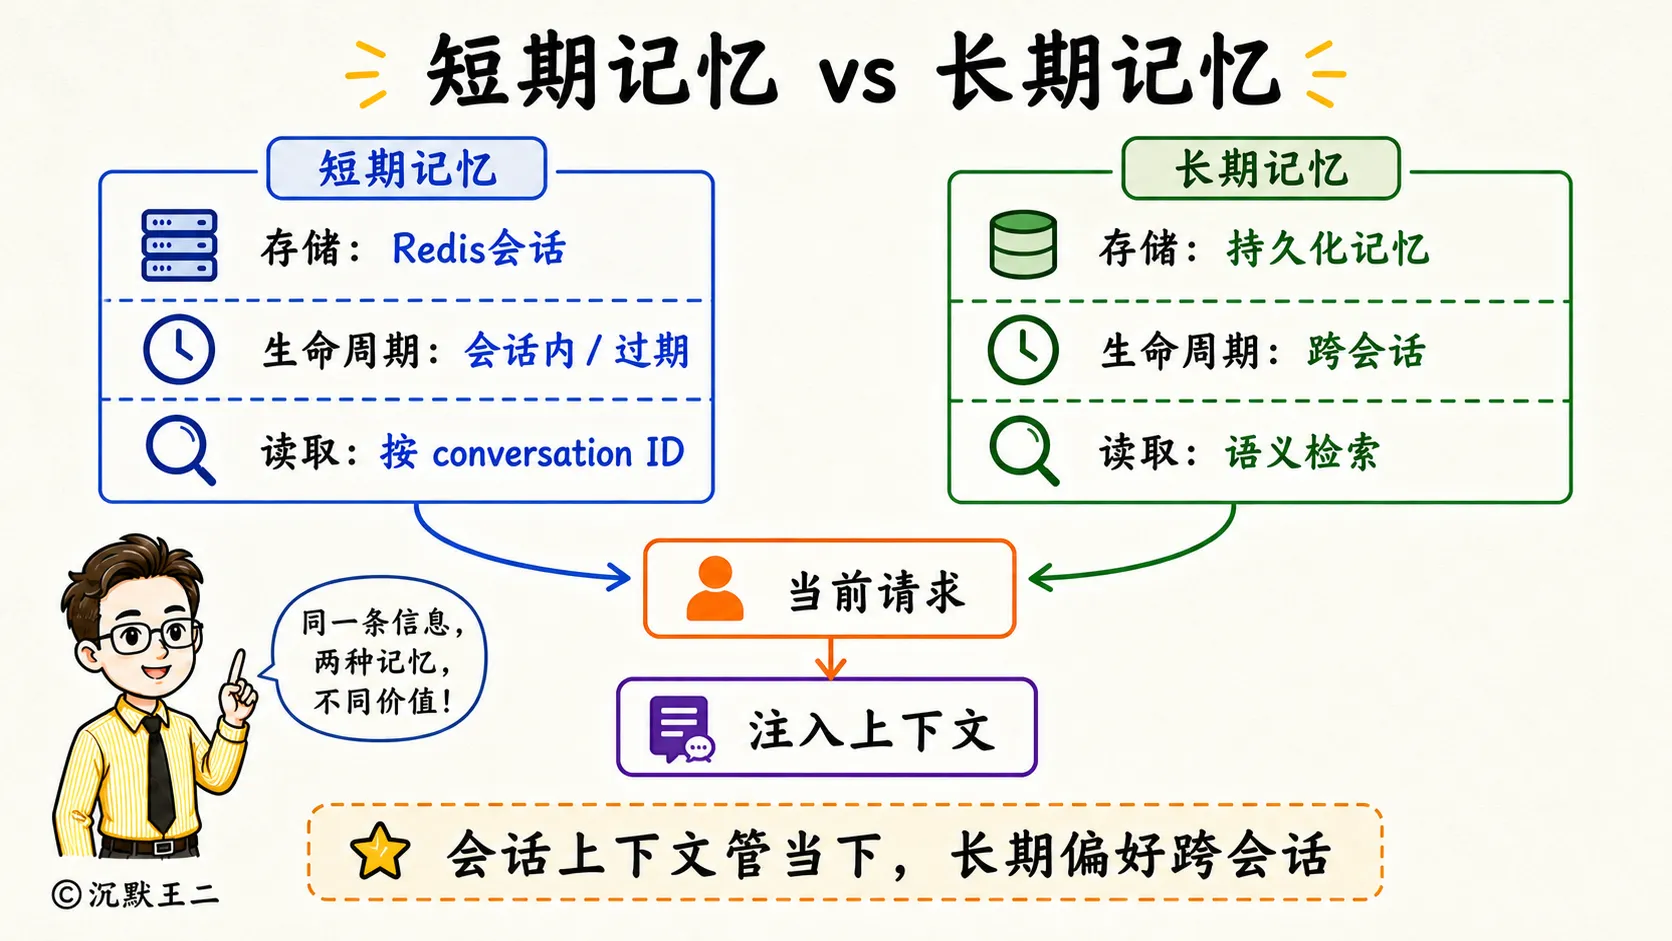
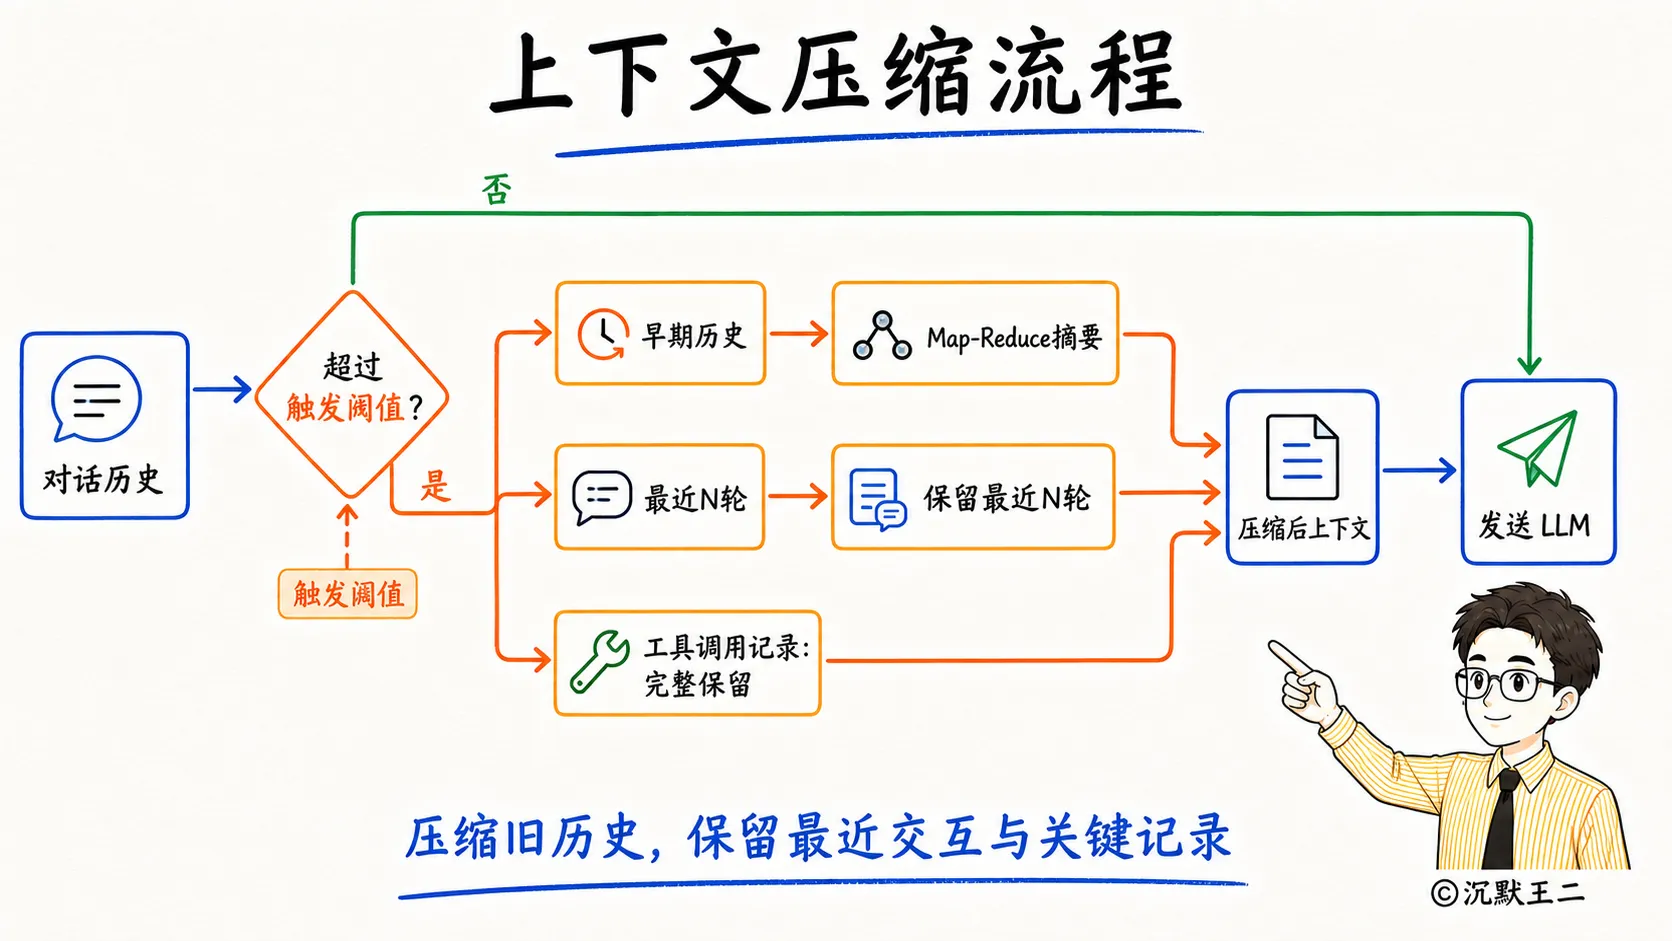
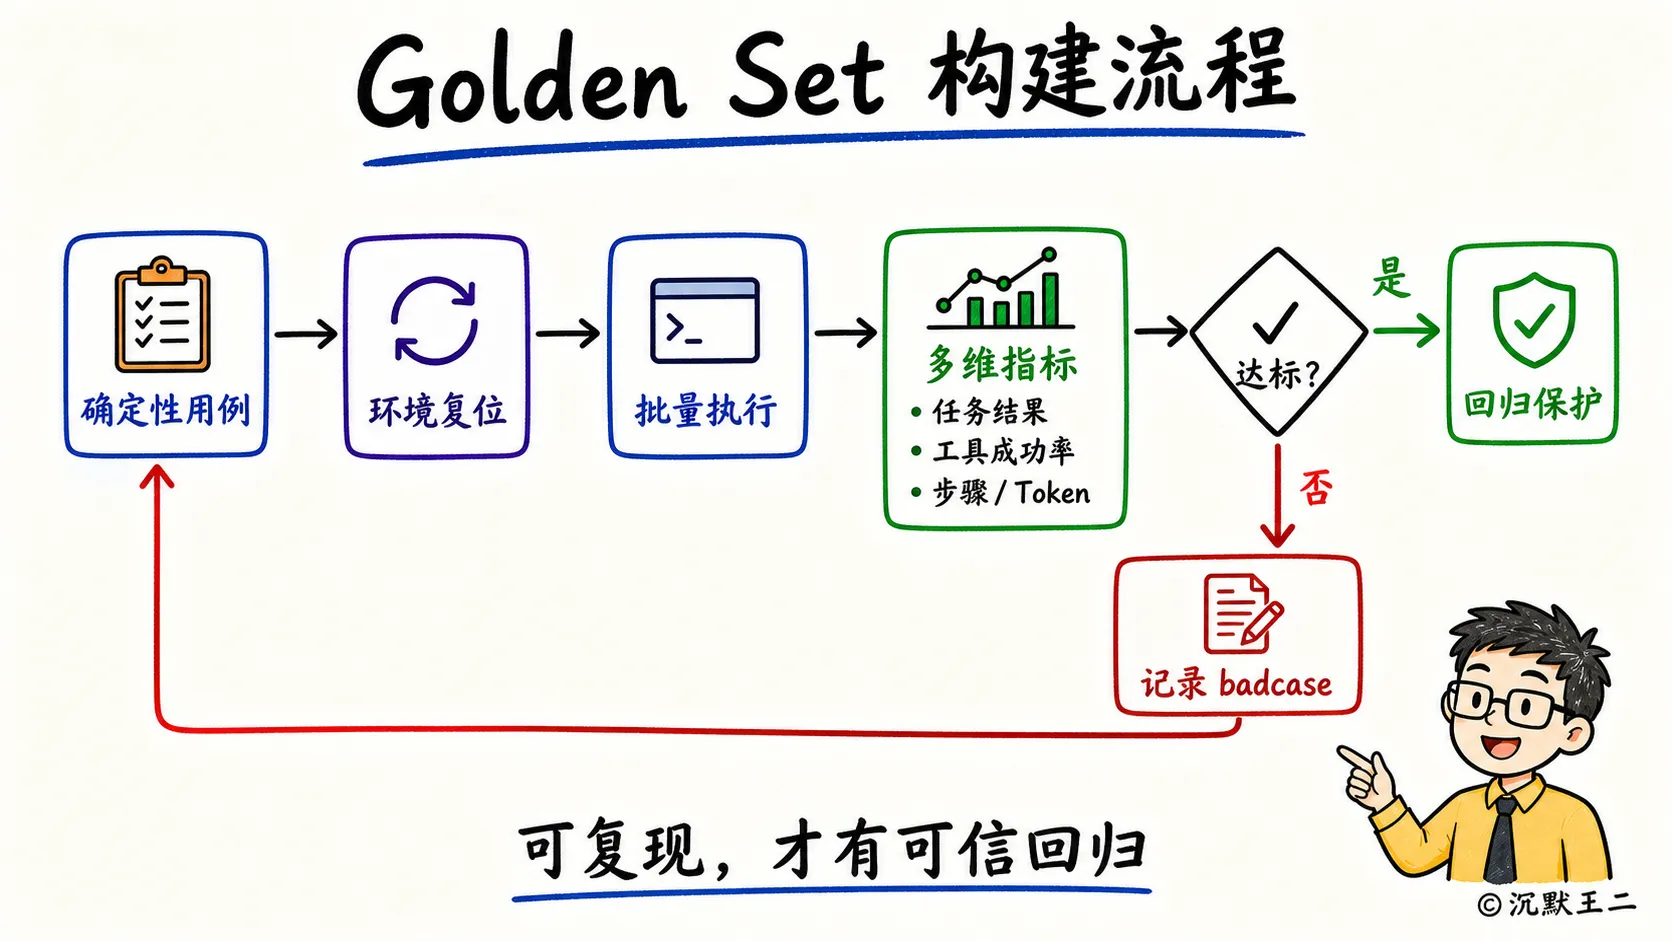
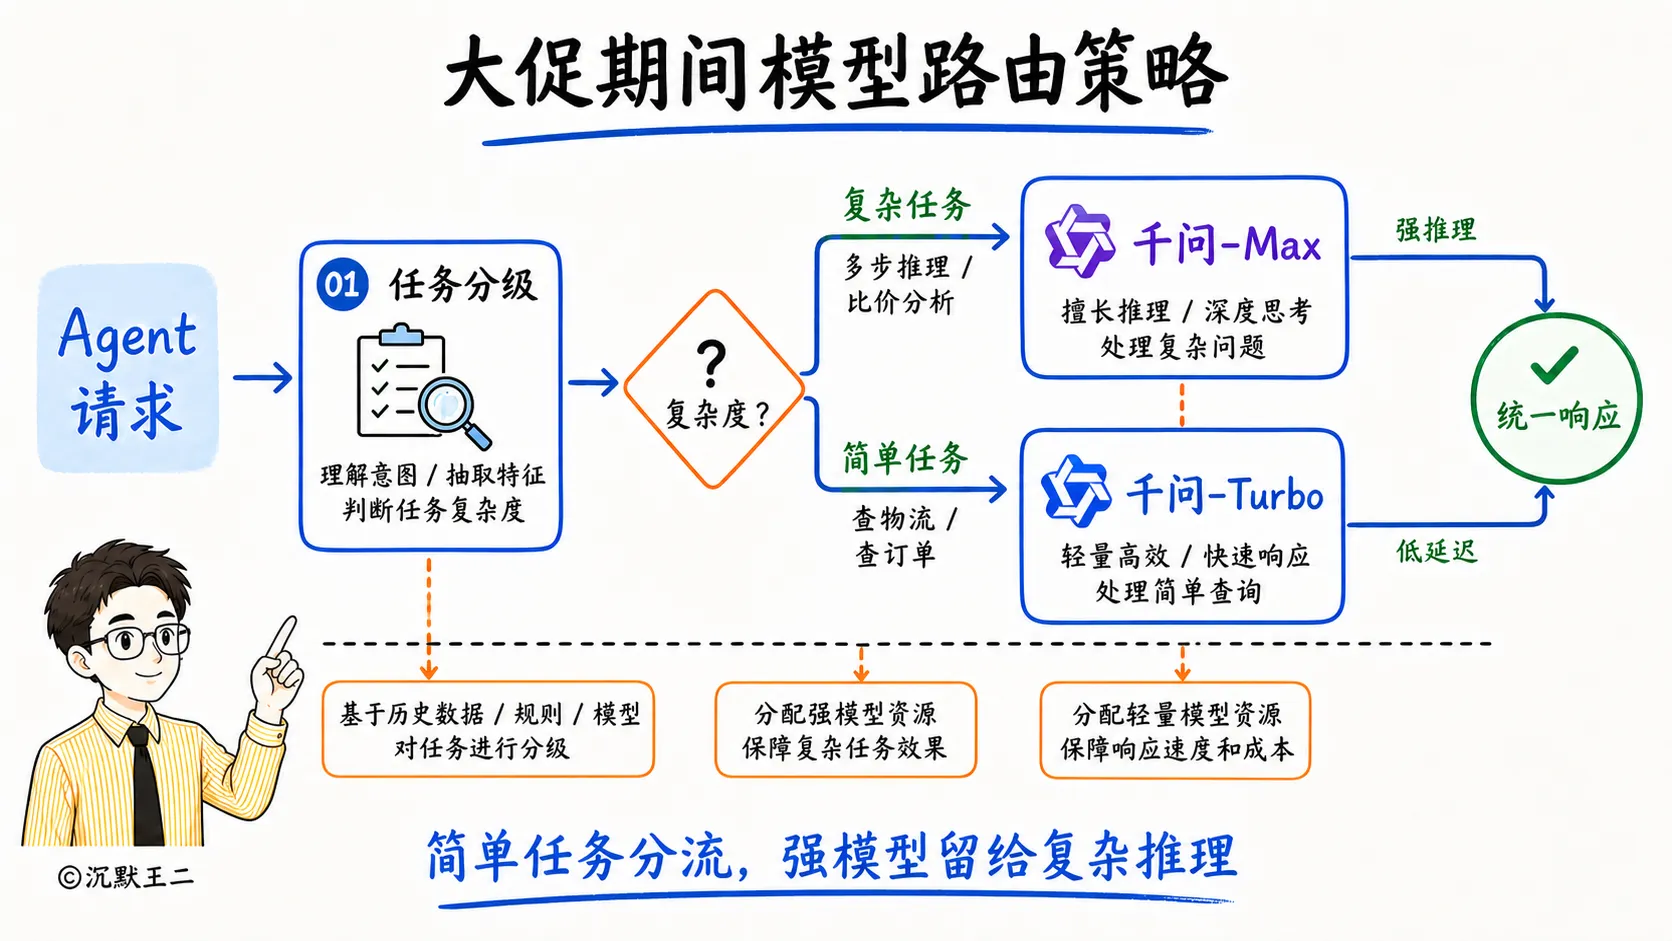
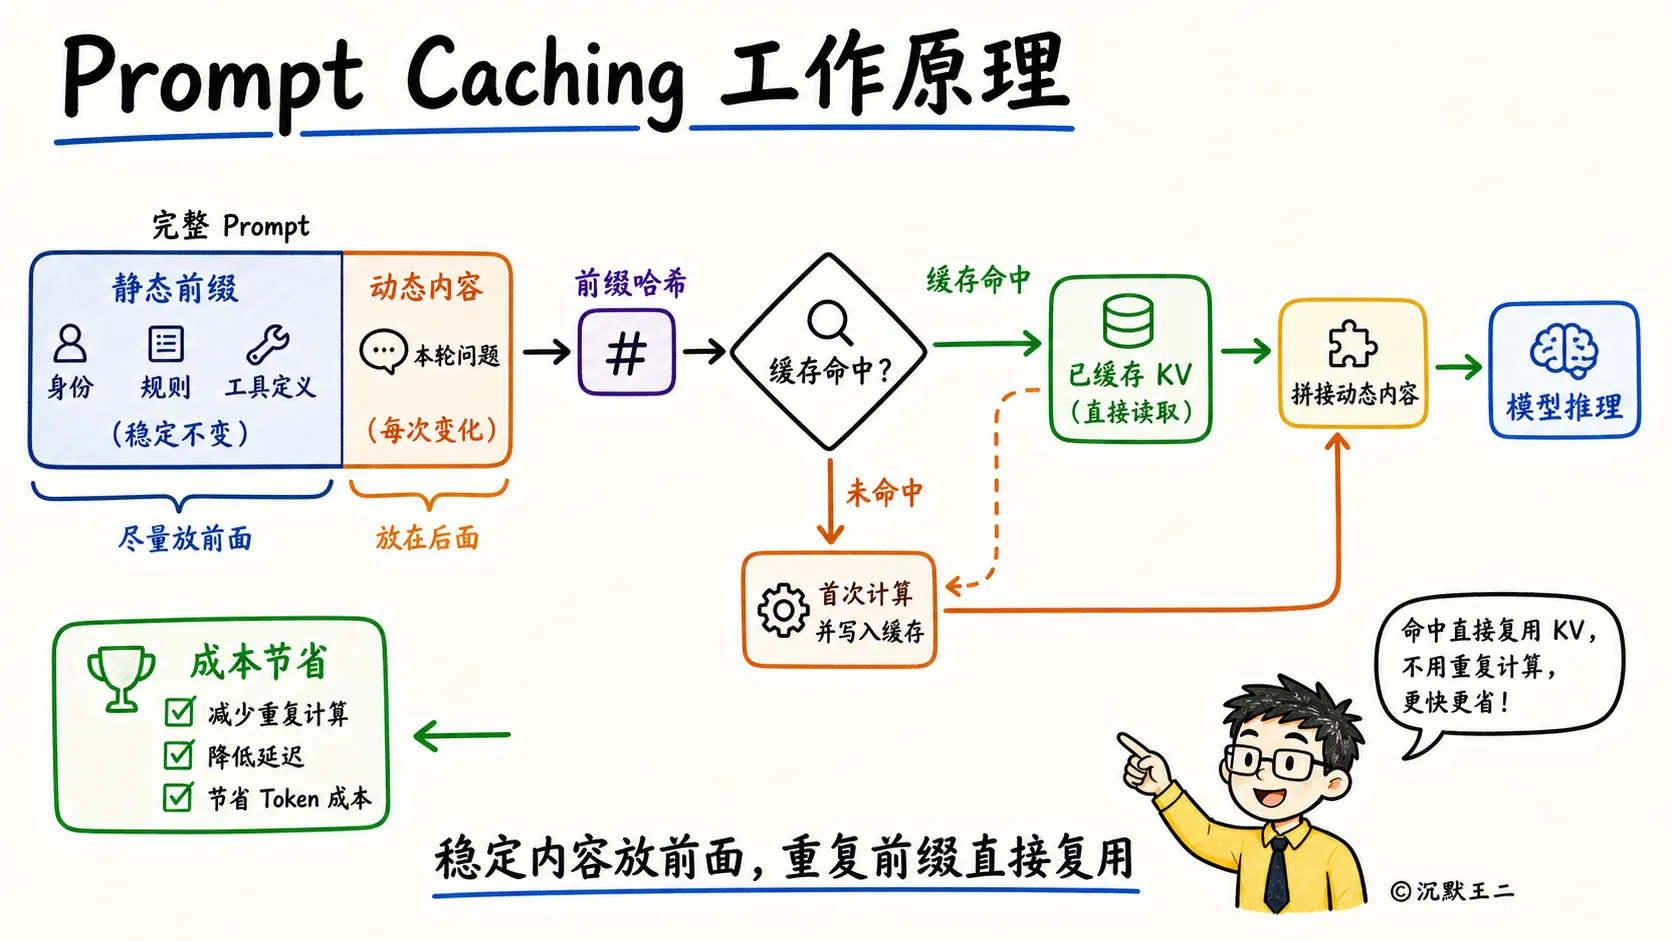
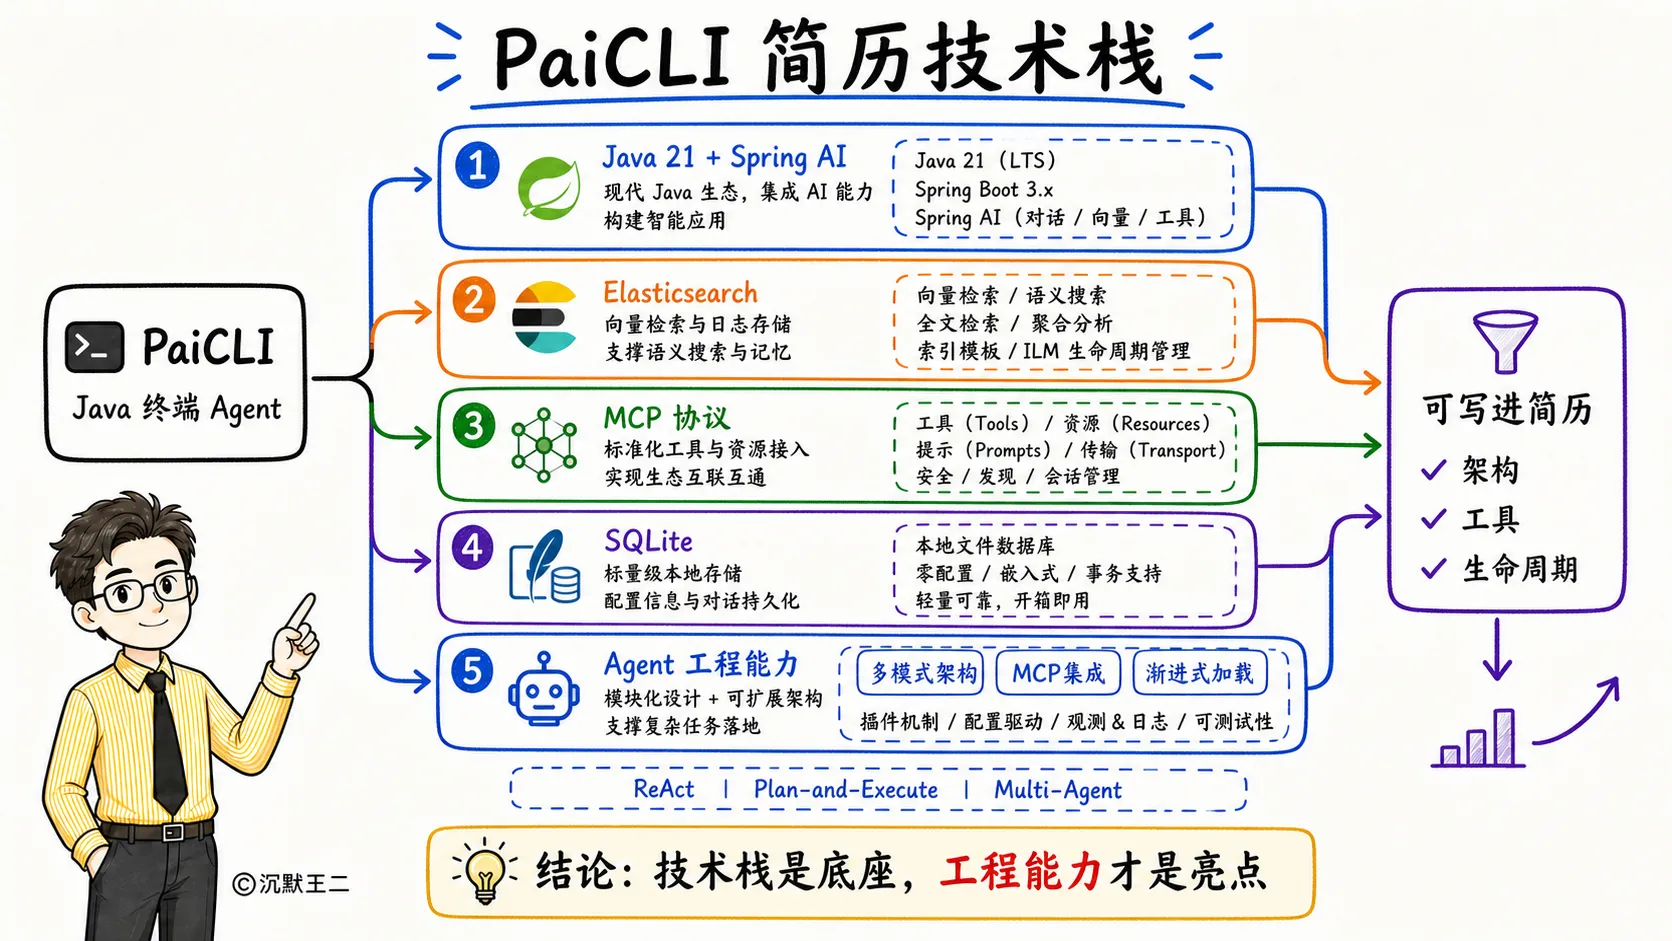
请你根据用户的提问,理解问题的核心意思,然后结合下面提供的参考资料,给出最清晰、最准确的答案。回答内容控制在800个字符内 参考资料如下: 如题,看到这样一则爆料。 我只能说,能拿高绩效的人,往往不是最忙的,也不是最聪明的,而是最懂领导心思的。 ![](https://cdn.paicoding.com/stutymore/sucai-20260807104226.png) 牛马的天赋可以说拉到满中满了。 换句话说,你加班到深夜,老板如果没看到,哪怕你产出了很多,可能也是无效加班。 再换句话说,你的产出就是领导的产出。 那聪明的你一定想到了,反之亦然。 你跳槽的时候,晋升答辩的时候,领导的产出也可以是你的产出,😄 说回阿里。 ![](https://cdn.paicoding.com/stutymore/sucai-20260807104822.png) 阿里作为头部的互联网大厂,在AI时代,也是拉满了。 最底层是阿里云、千问模型等 AI 基础设施;再往上是百炼这种 Maas 平台;应用层有企业级的钉钉和千问办公,研发侧有 Qoder;还有淘宝天猫、淘宝闪购、菜鸟、国际电商、闲鱼这些真实业务场景。 Agent 能帮助这些业务提高转化率和工作效率;执行的过程又能暴露模型、工具和工作流存在的问题;再根据这些结果对 Agent 进行持续优化。 有些公司只有模型,没有场景;有些公司拥有流量,但没有企业级的基础设施;有些公司拥有云服务,却缺少高频交易和履约体系。 阿里同时拥有云、模型、各种Agent产品、企业客户和C端消费场景。 舞台可以说非常大。 我去看了一下阿里系的招聘,几乎每条业务线都在招 Agent 方向的工程师。 如果你是一位愿意相信努力、相信过程、相信一步一个脚印、相信自己能在 AI 时代分一杯羹的人,那接下来的硬核内容,希望你能认真读一读。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807123317-526435fa.png) (全文比较肝,保证大家能学到很多很多,系好安全带,我们粗粗粗发~) ## content ### 01、如果让你设计一个淘宝购物 Agent,怎么走完从需求理解到履约跟踪的全链路! “购物这种多步骤的业务流程,我会用 Plan-and-Execute 模式来做。” 用户说”帮我买一个千元以内的机械键盘,Cherry 轴,要静音的”,规划器先把这句话拆成一个带依赖关系的任务图。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807123517-39fa776b.png) 大致是这样的流程:先做需求解析,提取品类、预算、轴体偏好这些结构化字段,再把结构化字段转成搜索 query,调淘宝的商品检索工具。检索回来的候选商品做比价和筛选,然后把排好序的结果展示给用户确认,用户确认之后走下单、支付、履约跟踪。 每个步骤对应一个工具调用,步骤之间有明确的依赖关系,比如说比价必须等检索完成,下单必须等用户确认。规划器生成的任务图是一个 DAG(有向无环图),按拓扑排序(Topological Sort)决定执行顺序。 “没有依赖关系的步骤可以并行。比如说用户同时让 Agent 搜机械键盘和鼠标垫,这两个检索任务互相独立,走并行执行就行。” 每个任务有自己的状态:PENDING → RUNNING → COMPLETED 或 FAILED。执行到某一步失败了,不需要从头开始,规划器可以从失败的节点重新规划。 ### 02、商品价格和库存变化很快,RAG 怎么保证实时性! 商品数据天然分两类:结构化的(价格、库存、优惠券状态)和非结构化的(商品描述、用户评价、卖家话术)。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807123703-3b26f8c7.png) 结构化数据不走向量检索,直接调淘宝的商品 API 拿实时数据——价格、库存、促销这些信息每秒都在变,走索引必然有延迟。 非结构化数据走 ES 混合检索,向量召回负责语义匹配,BM25 负责关键词精确匹配。 两条通道的结果在 Agent 层面合并。Agent 拿到向量检索返回的候选商品列表后,再调一次商品 API 把价格和库存刷新成最新的,确保用户看到的信息是实时的。 另外,商品描述、评价这些非结构化内容不需要秒级更新,可以把 ES 的刷新间隔(refresh interval)设成 5 秒,新写入的文档很快就能被搜到。 #### 向量索引的更新延迟怎么处理! Embedding 生成是有成本的。拿千问 text-embedding-v4 来说,每条文本要调一次百炼的 API,批量处理也有速率限制。 “做法是分离文本索引和向量索引。文本内容写入 ES 后立刻可以被 BM25 搜到,Embedding 异步生成,生成完了再补上向量字段。” ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807123921-b519828e.png) 在 Embedding 还没生成的窗口期内,这条数据只能被关键词检索命中,不能被语义检索命中。但至少不会完全搜不到。 等 Embedding 补上之后,语义检索就恢复正常了。 ### 03、下单、退款这些高风险操作,权限校验和审计怎么设计! “读操作自由调用,写操作按风险高低走不同的审批流程。” ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807124208-fb63475e.png) 查价格、查库存、查物流这些读操作,Agent 可以自动执行,不需要用户介入。加购物车、收藏商品这些低风险写操作,执行后通知用户就行。 下单、支付、退款、改地址这些高风险操作,必须阻塞等待用户二次确认,Agent 把操作内容展示给用户,用户明确同意后才执行。 “有一点要注意,同一个工具的风险等级可能随场景变化。比如说改地址,未发货的时候是低风险操作,已发货的时候就变成高风险了,因为改地址可能导致物流异常。” 这个判断逻辑要写在工具的前置检查里,不能写死成固定等级。 审计方面,每一次工具调用都记录完整的审计日志:时间戳、调用的工具名、传入参数、执行结果、用户是否授权。日志写入独立的审计表,不和业务日志混在一起。 出了问题可以完整回溯 Agent 的每一步操作。 ### 04、Agent 创建订单后网络超时,怎么避免重复下单! “Agent 每次发起下单请求时,在客户端生成一个唯一的幂等 key,随请求一起发给服务端。” ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807124434-d632607d.png) 用 UUID 就行。 服务端收到请求后,先用这个 key 查一下是否已经处理过——如果处理过,直接返回上一次的结果;没处理过,才执行下单逻辑。 网络超时的时候,Agent 会重试。但重试带的是同一个幂等 key,服务端识别到已经处理过,就不会重复创建订单。 “状态机确保订单状态只能单向流转:CREATED → PAYING → PAID → SHIPPING → COMPLETED。不允许跳跃,不允许回退。” 每次状态变更前做前置校验——比如只有 CREATED 状态的订单才能进入 PAYING,已经是 PAID 状态的订单再收到支付回调就直接丢弃。 #### 补偿事务和分布式事务有什么区别! 分布式事务(2PC)要求所有参与方同时成功或同时回滚。在购物场景下,下单涉及库存、订单、支付至少三个服务,2PC 需要三方同时锁资源,高并发下性能很差。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807124652-6f0d4a3d.png) “补偿事务走的是最终一致性。先执行,失败了再反向操作。” 比如说支付成功了但库存扣减失败,直接发起一笔自动退款就行。 每个步骤都要设计对应的补偿操作。支付对应退款,库存扣减对应库存释放,订单创建对应订单取消。Agent 在执行的时候,把每一步的补偿操作压入一个栈,失败了按栈的顺序逐一补偿。 ### 05、怎么用 MCP 把淘宝、菜鸟、钉钉封装成 Agent 可调用的标准工具! “做法是把每个业务系统封装成一个独立的 MCP Server。” ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807124854-0722c3ff.png) 淘宝是一个 Server,暴露商品搜索、下单、退款这些工具;菜鸟是一个 Server,暴露物流查询、运单创建这些工具;钉钉也是一个 Server,暴露消息推送、日程创建这些工具。 Agent 侧用 `mcp__{serverName}__{toolName}` 的格式注册工具,比如 `mcp__taobao__search_product`、`mcp__cainiao__track_shipment`,一看命名就知道是哪个系统的哪个工具。 “每个 MCP Server 启动后,Agent 通过 tools/list 端点自动发现这个 Server 暴露的所有工具,包括工具名、功能描述和参数的 JSON Schema。不需要在 Agent 侧硬编码工具定义。” 云端部署的业务系统用 Streamable HTTP,支持 SSE 流式返回,下单这种长操作可以实时推送进度,也支持会话管理(通过 `Mcp-Session-Id` 维持上下文)。 本地的辅助工具用 Stdio 传输,通过子进程通信就行。 #### 为什么要在业务 API 上面加一层 MCP! 淘宝的 API 和菜鸟的 API 接口风格可能完全不一样,参数格式、鉴权方式、错误码规范都不同。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807125319-ab8ca2e7.png) “没有 MCP 的话,每接一个业务系统都要在 Agent 侧写一套适配代码。有了 MCP,适配逻辑封装在 MCP Server 内部,Agent 只按统一的 MCP 协议调用就行。” 对 Agent 来说,调淘宝的下单和调菜鸟的查物流,接口格式完全一样。 还有一点,MCP 的工具发现机制让 Agent 可以在运行时动态感知有哪些工具可用。新上线一个闲鱼的 MCP Server,Agent 不需要改代码,自动发现并注册闲鱼的工具集。 ### 06、几百个业务工具,怎么做工具管理和动态加载! “全量加载肯定不行——几百个工具的 Schema 全塞进上下文,token 成本太高,模型的注意力也会被稀释,选错工具的概率反而变大。” 做法是渐进式披露(Progressive Disclosure),按需加载。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807125602-7448ed44.png) 索引层只保留名称和一句话功能描述,全部放进 system prompt,控制在 4KB 以内。模型每轮对话都能看到完整的工具清单,但只看到名字和简介,不看到完整的参数定义。 模型根据索引判断当前任务需要用哪个工具后,再把这个工具的完整 JSON Schema 加载进来。部分复杂工具还带有使用示例和注意事项文档,用到的时候才加载。 “加载进来的工具放在一个 LRU 缓冲区里,最多同时持有 3 个工具的完整 Schema。超出的按最久未使用淘汰。” #### 索引层放不下几百个工具怎么办! “解决办法是加一层分组路由。先按业务域把工具分组,比如说淘宝交易类、物流类、客服类、运营类这些,索引层只放十几个工具组的描述。” 模型先选组,再从组内加载具体工具。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807125832-2e9fb07d.png) 组内工具的匹配可以用语义检索。用户说“帮我查一下退货进度”,对工具描述做 Embedding 相似度计算,找到物流组里的退货查询工具。 比起让模型在几百个工具里挑,先缩小范围再精确匹配,准确率会高很多。 ### 07、用 Harness 思路承载业务 Agent,任务生命周期怎么设计! “状态机,任务状态持久化在 SQLite 里,进程崩了也不会丢。” ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807130433-8bc3ecbc.png) 任务有 ENQUEUED、RUNNING、COMPLETED、FAILED、CANCELED 五个状态,状态严格按照单向流转。进程崩溃重启后,从 SQLite 恢复任务状态,不会丢失。 超时方面,每次工具调用设一个超时上限,比如说调支付接口最多等 60 秒,超时就强制终止,任务标记为 FAILED,不会无限挂起。 “比如说调支付接口失败了,Agent 会重试这一步,不需要从商品检索重新发起。” 检查点是基于 git 快照实现的。每轮 Agent 循环前后各做一次快照,类似于游戏存档。 任务失败后可以回退到上一个检查点恢复。在购物场景里,比如说 Agent 在比价步骤出了问题,可以直接回退到检索完成的状态,不需要重新搜索。 人工接管方面,高风险操作走 HITL 审批,用户可以在任何一轮拒绝 Agent 的操作。拒绝后 Agent 不会强行继续,而是等待用户指示。 #### Agent 停滞检测是怎么实现的! “PaiCLI 有一个停滞检测机制。如果 Agent 连续 3 次调用同样的工具、传同样的参数,系统判定 Agent 卡住了,自动终止任务。” ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807130736-2c4c34ce.png) ### 08、千问模型驱动的 Agent,短期记忆和长期记忆怎么划分! “短期记忆存会话上下文,长期记忆存用户偏好,两者分开管理。” 短期记忆就是会话上下文。存在 Redis 里,按 conversation ID 隔离,保留最近 20 条消息,7 天过期。 每轮对话把历史消息注入上下文,模型就知道用户前面说了什么。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807130934-76e5ca58.png) 长期记忆是跨会话持久化的。PaiCLI 的做法是把重要信息保存成 JSON 文件,每轮 LLM 调用前根据当前对话内容做语义检索,找到相关的长期记忆注入系统提示词。 “拿购物 Agent 来说,用户说过‘我对 Cherry 轴比较感兴趣’、‘预算一般在一千以内’、‘之前买过某品牌觉得手感不好’,这些偏好应该写入长期记忆。下次用户再搜键盘的时候,Agent 不需要用户重复说,直接用长期记忆里的偏好做个性化推荐。” #### 上下文窗口不够用的时候怎么压缩! PaiCLI 的做法是先压缩短期记忆。当短期记忆的 token 数超过预算时,用 Map-Reduce 策略做 LLM 摘要,把早期的对话压缩成几段话,保留最近几轮不动。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807131344-907756d5.png) 如果压缩完还不够,就对整个对话历史做压缩。当发送给 LLM 的 token 总数接近上下文窗口时触发。 同时,保留最近 3 轮用户消息和完整的工具调用记录,历史部分用 LLM 摘要替代。 “摘要会保留四类信息:用户的核心诉求、已经完成的操作、双方达成的共识、还没做完的待办。确保压缩后模型不会忘记重要的上下文。” ### 09、怎么为商家运营 Agent 构建 Golden Set! 按场景分类。商品上架场景——给 Agent 一段商品描述,验证生成的标题、主图推荐、类目匹配是否正确。 营销活动场景——给一组商品数据和促销规则,验证 Agent 是否能正确计算优惠、生成活动页面。 客服场景——给一条买家投诉,验证 Agent 的回复是否合规、是否解决了问题。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807131601-19331d00.png) “比用例设计更难的是测试环境的清理。上一轮测试 Agent 创建了商品、改了价格、发了消息,如果不清理干净,下一轮测试的初始状态就不一样了,结果没法对比。” 所以每次跑 Golden Set 之前,数据库、缓存、外部 API mock 都要重置到初始状态。 评估不能只看任务完成没完成,还要看 Agent 用了多少步、消耗了多少 token、工具调用成功率。 非确定性输出用 LLM-as-Judge 打分,定期随机抽样人工复审校准。一致率低于阈值,说明评分标准要调整。 ### 10、大促期间模型请求量激增,怎么控制延迟和成本! 模型路由按任务复杂度分流。复杂任务(多步推理、商品比价分析)走大尺寸模型,简单任务(查物流、查订单状态)走小尺寸模型。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807131834-0af17ec5.png) “路由策略可以把大部分简单查询分流到小尺寸模型,成本低、响应快,留出算力给真正需要强推理的任务。” Prompt Caching 也很关键。PaiCLI 的提示词里,身份定义、人格、模式指令、审批策略这些在整个会话期间都不会变,就放在提示词最前面。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807132117-293f0eef.png) 对于非关键任务,用异步执行。比如说生成商品描述、写评价摘要这些不需要实时返回的任务,塞进消息队列排队处理,不占用在线推理的算力。 最后用降级策略兜底。模型服务不可用或者响应超时的时候,Agent 降级到规则引擎,用预设的模板回答高频问题,保证用户至少能得到一个可用的回复。 ### PaiCLI 和派聪明如何写到简历上! **项目名称**:PaiCLI — 终端 AI Agent 命令行工具 **项目简介**:对标 Claude Code 的 Java 版终端 Agent,支持 ReAct、Plan-and-Execute、Multi-Agent Team 三种执行模式,具备多轮对话、工具调用、MCP 集成、任务管理等能力。 **技术栈**:Java 21 + Spring AI + Elasticsearch + MCP 协议 + SQLite ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807132403-0f43adb2.png) **核心职责**: - 设计并实现 Agent 多模式执行架构,支持 ReAct 实时交互、Plan-and-Execute 复杂任务分步执行(基于 DAG 拓扑排序)、Multi-Agent Team 多角色协作,并根据任务复杂度自动路由 - 实现 MCP 协议集成,支持 Stdio 和 Streamable HTTP 两种传输方式,通过 `tools/list` 端点自动发现工具 Schema - 设计渐进式工具加载体系,通过 LRU 缓冲区控制上下文占用,避免全量加载导致的 token 浪费和注意力稀释 - 搭建效果评估体系,维护确定性测试用例的 Golden Set,结合 LLM-as-Judge 批量评分和人工校准抽检,保障迭代过程中效果不回退 --- **项目名称**:派聪明 — RAG 知识库系统 **项目简介**:基于 ES 混合检索的 RAG 知识库,支持多格式文档解析、向量 + 关键词混合检索、多轮对话和引用溯源。 **技术栈**:Spring Boot + Elasticsearch + Redis + 千问 text-embedding-v4 + DeepSeek **核心职责**: - 实现 ES 混合检索,千问 text-embedding-v4 生成 2048 维向量做 KNN 召回(窗口 = topK × 30),BM25 做关键词重排序,向量生成失败时自动降级为纯文本检索 - 文档分块按 512 字符分块、100 字符重叠,短块自动合并,PDF 通过 LiteParse 引擎做 OCR 解析,保留页码和锚点文本用于引用定位 - 搭建会话记忆管理,Redis 存储最近 20 条消息(7 天过期),MySQL 永久存储对话历史和引用记录,支持多会话隔离 ## ending 购物 Agent 的完整流程设计、RAG 的实时性保障、MCP 封装、工具动态加载、幂等补偿、停滞检测、记忆压缩、Golden Set、大促时期的降级处理。 是不是有点熟悉! 三高时期肯定都碰到过,只是加了点 AI 在里面而已。 **技术方向在变,但工程师的核心竞争力没变——能把系统做出来、做稳定、细节经得起追问,就是稀缺的。** 加油吧,兄弟姐妹们。 下期见。 你是谁
点赞
回复 取消回复

2 条评论

含蓄的马里奥 2026年08月12日 23:09
@派聪明 你是谁
点赞
回复1 取消回复
派聪明 2026年08月12日 23:09
请你根据用户的提问,理解问题的核心意思,然后结合下面提供的参考资料,给出最清晰、最准确的答案。回答内容控制在800个字符内 参考资料如下: 如题,看到这样一则爆料。 我只能说,能拿高绩效的人,往往不是最忙的,也不是最聪明的,而是最懂领导心思的。 ![](https://cdn.paicoding.com/stutymore/sucai-20260807104226.png) 牛马的天赋可以说拉到满中满了。 换句话说,你加班到深夜,老板如果没看到,哪怕你产出了很多,可能也是无效加班。 再换句话说,你的产出就是领导的产出。 那聪明的你一定想到了,反之亦然。 你跳槽的时候,晋升答辩的时候,领导的产出也可以是你的产出,😄 说回阿里。 ![](https://cdn.paicoding.com/stutymore/sucai-20260807104822.png) 阿里作为头部的互联网大厂,在AI时代,也是拉满了。 最底层是阿里云、千问模型等 AI 基础设施;再往上是百炼这种 Maas 平台;应用层有企业级的钉钉和千问办公,研发侧有 Qoder;还有淘宝天猫、淘宝闪购、菜鸟、国际电商、闲鱼这些真实业务场景。 Agent 能帮助这些业务提高转化率和工作效率;执行的过程又能暴露模型、工具和工作流存在的问题;再根据这些结果对 Agent 进行持续优化。 有些公司只有模型,没有场景;有些公司拥有流量,但没有企业级的基础设施;有些公司拥有云服务,却缺少高频交易和履约体系。 阿里同时拥有云、模型、各种Agent产品、企业客户和C端消费场景。 舞台可以说非常大。 我去看了一下阿里系的招聘,几乎每条业务线都在招 Agent 方向的工程师。 如果你是一位愿意相信努力、相信过程、相信一步一个脚印、相信自己能在 AI 时代分一杯羹的人,那接下来的硬核内容,希望你能认真读一读。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807123317-526435fa.png) (全文比较肝,保证大家能学到很多很多,系好安全带,我们粗粗粗发~) ## content ### 01、如果让你设计一个淘宝购物 Agent,怎么走完从需求理解到履约跟踪的全链路! “购物这种多步骤的业务流程,我会用 Plan-and-Execute 模式来做。” 用户说”帮我买一个千元以内的机械键盘,Cherry 轴,要静音的”,规划器先把这句话拆成一个带依赖关系的任务图。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807123517-39fa776b.png) 大致是这样的流程:先做需求解析,提取品类、预算、轴体偏好这些结构化字段,再把结构化字段转成搜索 query,调淘宝的商品检索工具。检索回来的候选商品做比价和筛选,然后把排好序的结果展示给用户确认,用户确认之后走下单、支付、履约跟踪。 每个步骤对应一个工具调用,步骤之间有明确的依赖关系,比如说比价必须等检索完成,下单必须等用户确认。规划器生成的任务图是一个 DAG(有向无环图),按拓扑排序(Topological Sort)决定执行顺序。 “没有依赖关系的步骤可以并行。比如说用户同时让 Agent 搜机械键盘和鼠标垫,这两个检索任务互相独立,走并行执行就行。” 每个任务有自己的状态:PENDING → RUNNING → COMPLETED 或 FAILED。执行到某一步失败了,不需要从头开始,规划器可以从失败的节点重新规划。 ### 02、商品价格和库存变化很快,RAG 怎么保证实时性! 商品数据天然分两类:结构化的(价格、库存、优惠券状态)和非结构化的(商品描述、用户评价、卖家话术)。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807123703-3b26f8c7.png) 结构化数据不走向量检索,直接调淘宝的商品 API 拿实时数据——价格、库存、促销这些信息每秒都在变,走索引必然有延迟。 非结构化数据走 ES 混合检索,向量召回负责语义匹配,BM25 负责关键词精确匹配。 两条通道的结果在 Agent 层面合并。Agent 拿到向量检索返回的候选商品列表后,再调一次商品 API 把价格和库存刷新成最新的,确保用户看到的信息是实时的。 另外,商品描述、评价这些非结构化内容不需要秒级更新,可以把 ES 的刷新间隔(refresh interval)设成 5 秒,新写入的文档很快就能被搜到。 #### 向量索引的更新延迟怎么处理! Embedding 生成是有成本的。拿千问 text-embedding-v4 来说,每条文本要调一次百炼的 API,批量处理也有速率限制。 “做法是分离文本索引和向量索引。文本内容写入 ES 后立刻可以被 BM25 搜到,Embedding 异步生成,生成完了再补上向量字段。” ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807123921-b519828e.png) 在 Embedding 还没生成的窗口期内,这条数据只能被关键词检索命中,不能被语义检索命中。但至少不会完全搜不到。 等 Embedding 补上之后,语义检索就恢复正常了。 ### 03、下单、退款这些高风险操作,权限校验和审计怎么设计! “读操作自由调用,写操作按风险高低走不同的审批流程。” ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807124208-fb63475e.png) 查价格、查库存、查物流这些读操作,Agent 可以自动执行,不需要用户介入。加购物车、收藏商品这些低风险写操作,执行后通知用户就行。 下单、支付、退款、改地址这些高风险操作,必须阻塞等待用户二次确认,Agent 把操作内容展示给用户,用户明确同意后才执行。 “有一点要注意,同一个工具的风险等级可能随场景变化。比如说改地址,未发货的时候是低风险操作,已发货的时候就变成高风险了,因为改地址可能导致物流异常。” 这个判断逻辑要写在工具的前置检查里,不能写死成固定等级。 审计方面,每一次工具调用都记录完整的审计日志:时间戳、调用的工具名、传入参数、执行结果、用户是否授权。日志写入独立的审计表,不和业务日志混在一起。 出了问题可以完整回溯 Agent 的每一步操作。 ### 04、Agent 创建订单后网络超时,怎么避免重复下单! “Agent 每次发起下单请求时,在客户端生成一个唯一的幂等 key,随请求一起发给服务端。” ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807124434-d632607d.png) 用 UUID 就行。 服务端收到请求后,先用这个 key 查一下是否已经处理过——如果处理过,直接返回上一次的结果;没处理过,才执行下单逻辑。 网络超时的时候,Agent 会重试。但重试带的是同一个幂等 key,服务端识别到已经处理过,就不会重复创建订单。 “状态机确保订单状态只能单向流转:CREATED → PAYING → PAID → SHIPPING → COMPLETED。不允许跳跃,不允许回退。” 每次状态变更前做前置校验——比如只有 CREATED 状态的订单才能进入 PAYING,已经是 PAID 状态的订单再收到支付回调就直接丢弃。 #### 补偿事务和分布式事务有什么区别! 分布式事务(2PC)要求所有参与方同时成功或同时回滚。在购物场景下,下单涉及库存、订单、支付至少三个服务,2PC 需要三方同时锁资源,高并发下性能很差。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807124652-6f0d4a3d.png) “补偿事务走的是最终一致性。先执行,失败了再反向操作。” 比如说支付成功了但库存扣减失败,直接发起一笔自动退款就行。 每个步骤都要设计对应的补偿操作。支付对应退款,库存扣减对应库存释放,订单创建对应订单取消。Agent 在执行的时候,把每一步的补偿操作压入一个栈,失败了按栈的顺序逐一补偿。 ### 05、怎么用 MCP 把淘宝、菜鸟、钉钉封装成 Agent 可调用的标准工具! “做法是把每个业务系统封装成一个独立的 MCP Server。” ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807124854-0722c3ff.png) 淘宝是一个 Server,暴露商品搜索、下单、退款这些工具;菜鸟是一个 Server,暴露物流查询、运单创建这些工具;钉钉也是一个 Server,暴露消息推送、日程创建这些工具。 Agent 侧用 `mcp__{serverName}__{toolName}` 的格式注册工具,比如 `mcp__taobao__search_product`、`mcp__cainiao__track_shipment`,一看命名就知道是哪个系统的哪个工具。 “每个 MCP Server 启动后,Agent 通过 tools/list 端点自动发现这个 Server 暴露的所有工具,包括工具名、功能描述和参数的 JSON Schema。不需要在 Agent 侧硬编码工具定义。” 云端部署的业务系统用 Streamable HTTP,支持 SSE 流式返回,下单这种长操作可以实时推送进度,也支持会话管理(通过 `Mcp-Session-Id` 维持上下文)。 本地的辅助工具用 Stdio 传输,通过子进程通信就行。 #### 为什么要在业务 API 上面加一层 MCP! 淘宝的 API 和菜鸟的 API 接口风格可能完全不一样,参数格式、鉴权方式、错误码规范都不同。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807125319-ab8ca2e7.png) “没有 MCP 的话,每接一个业务系统都要在 Agent 侧写一套适配代码。有了 MCP,适配逻辑封装在 MCP Server 内部,Agent 只按统一的 MCP 协议调用就行。” 对 Agent 来说,调淘宝的下单和调菜鸟的查物流,接口格式完全一样。 还有一点,MCP 的工具发现机制让 Agent 可以在运行时动态感知有哪些工具可用。新上线一个闲鱼的 MCP Server,Agent 不需要改代码,自动发现并注册闲鱼的工具集。 ### 06、几百个业务工具,怎么做工具管理和动态加载! “全量加载肯定不行——几百个工具的 Schema 全塞进上下文,token 成本太高,模型的注意力也会被稀释,选错工具的概率反而变大。” 做法是渐进式披露(Progressive Disclosure),按需加载。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807125602-7448ed44.png) 索引层只保留名称和一句话功能描述,全部放进 system prompt,控制在 4KB 以内。模型每轮对话都能看到完整的工具清单,但只看到名字和简介,不看到完整的参数定义。 模型根据索引判断当前任务需要用哪个工具后,再把这个工具的完整 JSON Schema 加载进来。部分复杂工具还带有使用示例和注意事项文档,用到的时候才加载。 “加载进来的工具放在一个 LRU 缓冲区里,最多同时持有 3 个工具的完整 Schema。超出的按最久未使用淘汰。” #### 索引层放不下几百个工具怎么办! “解决办法是加一层分组路由。先按业务域把工具分组,比如说淘宝交易类、物流类、客服类、运营类这些,索引层只放十几个工具组的描述。” 模型先选组,再从组内加载具体工具。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807125832-2e9fb07d.png) 组内工具的匹配可以用语义检索。用户说“帮我查一下退货进度”,对工具描述做 Embedding 相似度计算,找到物流组里的退货查询工具。 比起让模型在几百个工具里挑,先缩小范围再精确匹配,准确率会高很多。 ### 07、用 Harness 思路承载业务 Agent,任务生命周期怎么设计! “状态机,任务状态持久化在 SQLite 里,进程崩了也不会丢。” ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807130433-8bc3ecbc.png) 任务有 ENQUEUED、RUNNING、COMPLETED、FAILED、CANCELED 五个状态,状态严格按照单向流转。进程崩溃重启后,从 SQLite 恢复任务状态,不会丢失。 超时方面,每次工具调用设一个超时上限,比如说调支付接口最多等 60 秒,超时就强制终止,任务标记为 FAILED,不会无限挂起。 “比如说调支付接口失败了,Agent 会重试这一步,不需要从商品检索重新发起。” 检查点是基于 git 快照实现的。每轮 Agent 循环前后各做一次快照,类似于游戏存档。 任务失败后可以回退到上一个检查点恢复。在购物场景里,比如说 Agent 在比价步骤出了问题,可以直接回退到检索完成的状态,不需要重新搜索。 人工接管方面,高风险操作走 HITL 审批,用户可以在任何一轮拒绝 Agent 的操作。拒绝后 Agent 不会强行继续,而是等待用户指示。 #### Agent 停滞检测是怎么实现的! “PaiCLI 有一个停滞检测机制。如果 Agent 连续 3 次调用同样的工具、传同样的参数,系统判定 Agent 卡住了,自动终止任务。” ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807130736-2c4c34ce.png) ### 08、千问模型驱动的 Agent,短期记忆和长期记忆怎么划分! “短期记忆存会话上下文,长期记忆存用户偏好,两者分开管理。” 短期记忆就是会话上下文。存在 Redis 里,按 conversation ID 隔离,保留最近 20 条消息,7 天过期。 每轮对话把历史消息注入上下文,模型就知道用户前面说了什么。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807130934-76e5ca58.png) 长期记忆是跨会话持久化的。PaiCLI 的做法是把重要信息保存成 JSON 文件,每轮 LLM 调用前根据当前对话内容做语义检索,找到相关的长期记忆注入系统提示词。 “拿购物 Agent 来说,用户说过‘我对 Cherry 轴比较感兴趣’、‘预算一般在一千以内’、‘之前买过某品牌觉得手感不好’,这些偏好应该写入长期记忆。下次用户再搜键盘的时候,Agent 不需要用户重复说,直接用长期记忆里的偏好做个性化推荐。” #### 上下文窗口不够用的时候怎么压缩! PaiCLI 的做法是先压缩短期记忆。当短期记忆的 token 数超过预算时,用 Map-Reduce 策略做 LLM 摘要,把早期的对话压缩成几段话,保留最近几轮不动。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807131344-907756d5.png) 如果压缩完还不够,就对整个对话历史做压缩。当发送给 LLM 的 token 总数接近上下文窗口时触发。 同时,保留最近 3 轮用户消息和完整的工具调用记录,历史部分用 LLM 摘要替代。 “摘要会保留四类信息:用户的核心诉求、已经完成的操作、双方达成的共识、还没做完的待办。确保压缩后模型不会忘记重要的上下文。” ### 09、怎么为商家运营 Agent 构建 Golden Set! 按场景分类。商品上架场景——给 Agent 一段商品描述,验证生成的标题、主图推荐、类目匹配是否正确。 营销活动场景——给一组商品数据和促销规则,验证 Agent 是否能正确计算优惠、生成活动页面。 客服场景——给一条买家投诉,验证 Agent 的回复是否合规、是否解决了问题。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807131601-19331d00.png) “比用例设计更难的是测试环境的清理。上一轮测试 Agent 创建了商品、改了价格、发了消息,如果不清理干净,下一轮测试的初始状态就不一样了,结果没法对比。” 所以每次跑 Golden Set 之前,数据库、缓存、外部 API mock 都要重置到初始状态。 评估不能只看任务完成没完成,还要看 Agent 用了多少步、消耗了多少 token、工具调用成功率。 非确定性输出用 LLM-as-Judge 打分,定期随机抽样人工复审校准。一致率低于阈值,说明评分标准要调整。 ### 10、大促期间模型请求量激增,怎么控制延迟和成本! 模型路由按任务复杂度分流。复杂任务(多步推理、商品比价分析)走大尺寸模型,简单任务(查物流、查订单状态)走小尺寸模型。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807131834-0af17ec5.png) “路由策略可以把大部分简单查询分流到小尺寸模型,成本低、响应快,留出算力给真正需要强推理的任务。” Prompt Caching 也很关键。PaiCLI 的提示词里,身份定义、人格、模式指令、审批策略这些在整个会话期间都不会变,就放在提示词最前面。 ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807132117-293f0eef.png) 对于非关键任务,用异步执行。比如说生成商品描述、写评价摘要这些不需要实时返回的任务,塞进消息队列排队处理,不占用在线推理的算力。 最后用降级策略兜底。模型服务不可用或者响应超时的时候,Agent 降级到规则引擎,用预设的模板回答高频问题,保证用户至少能得到一个可用的回复。 ### PaiCLI 和派聪明如何写到简历上! **项目名称**:PaiCLI — 终端 AI Agent 命令行工具 **项目简介**:对标 Claude Code 的 Java 版终端 Agent,支持 ReAct、Plan-and-Execute、Multi-Agent Team 三种执行模式,具备多轮对话、工具调用、MCP 集成、任务管理等能力。 **技术栈**:Java 21 + Spring AI + Elasticsearch + MCP 协议 + SQLite ![](https://cdn.paicoding.com/stutymore/agent-mianshi-ali-375-20260807132403-0f43adb2.png) **核心职责**: - 设计并实现 Agent 多模式执行架构,支持 ReAct 实时交互、Plan-and-Execute 复杂任务分步执行(基于 DAG 拓扑排序)、Multi-Agent Team 多角色协作,并根据任务复杂度自动路由 - 实现 MCP 协议集成,支持 Stdio 和 Streamable HTTP 两种传输方式,通过 `tools/list` 端点自动发现工具 Schema - 设计渐进式工具加载体系,通过 LRU 缓冲区控制上下文占用,避免全量加载导致的 token 浪费和注意力稀释 - 搭建效果评估体系,维护确定性测试用例的 Golden Set,结合 LLM-as-Judge 批量评分和人工校准抽检,保障迭代过程中效果不回退 --- **项目名称**:派聪明 — RAG 知识库系统 **项目简介**:基于 ES 混合检索的 RAG 知识库,支持多格式文档解析、向量 + 关键词混合检索、多轮对话和引用溯源。 **技术栈**:Spring Boot + Elasticsearch + Redis + 千问 text-embedding-v4 + DeepSeek **核心职责**: - 实现 ES 混合检索,千问 text-embedding-v4 生成 2048 维向量做 KNN 召回(窗口 = topK × 30),BM25 做关键词重排序,向量生成失败时自动降级为纯文本检索 - 文档分块按 512 字符分块、100 字符重叠,短块自动合并,PDF 通过 LiteParse 引擎做 OCR 解析,保留页码和锚点文本用于引用定位 - 搭建会话记忆管理,Redis 存储最近 20 条消息(7 天过期),MySQL 永久存储对话历史和引用记录,支持多会话隔离 ## ending 购物 Agent 的完整流程设计、RAG 的实时性保障、MCP 封装、工具动态加载、幂等补偿、停滞检测、记忆压缩、Golden Set、大促时期的降级处理。 是不是有点熟悉! 三高时期肯定都碰到过,只是加了点 AI 在里面而已。 **技术方向在变,但工程师的核心竞争力没变——能把系统做出来、做稳定、细节经得起追问,就是稀缺的。** 加油吧,兄弟姐妹们。 下期见。 你是谁
点赞
回复 取消回复

相关推荐