
大家好,我是二哥呀。
深度体验完 Gemini 4 Neon,和 Antigravity 的组合(叫它反重力,或者 agy),发现另外一个顶级 APP 和模型已经不再是我的最爱。
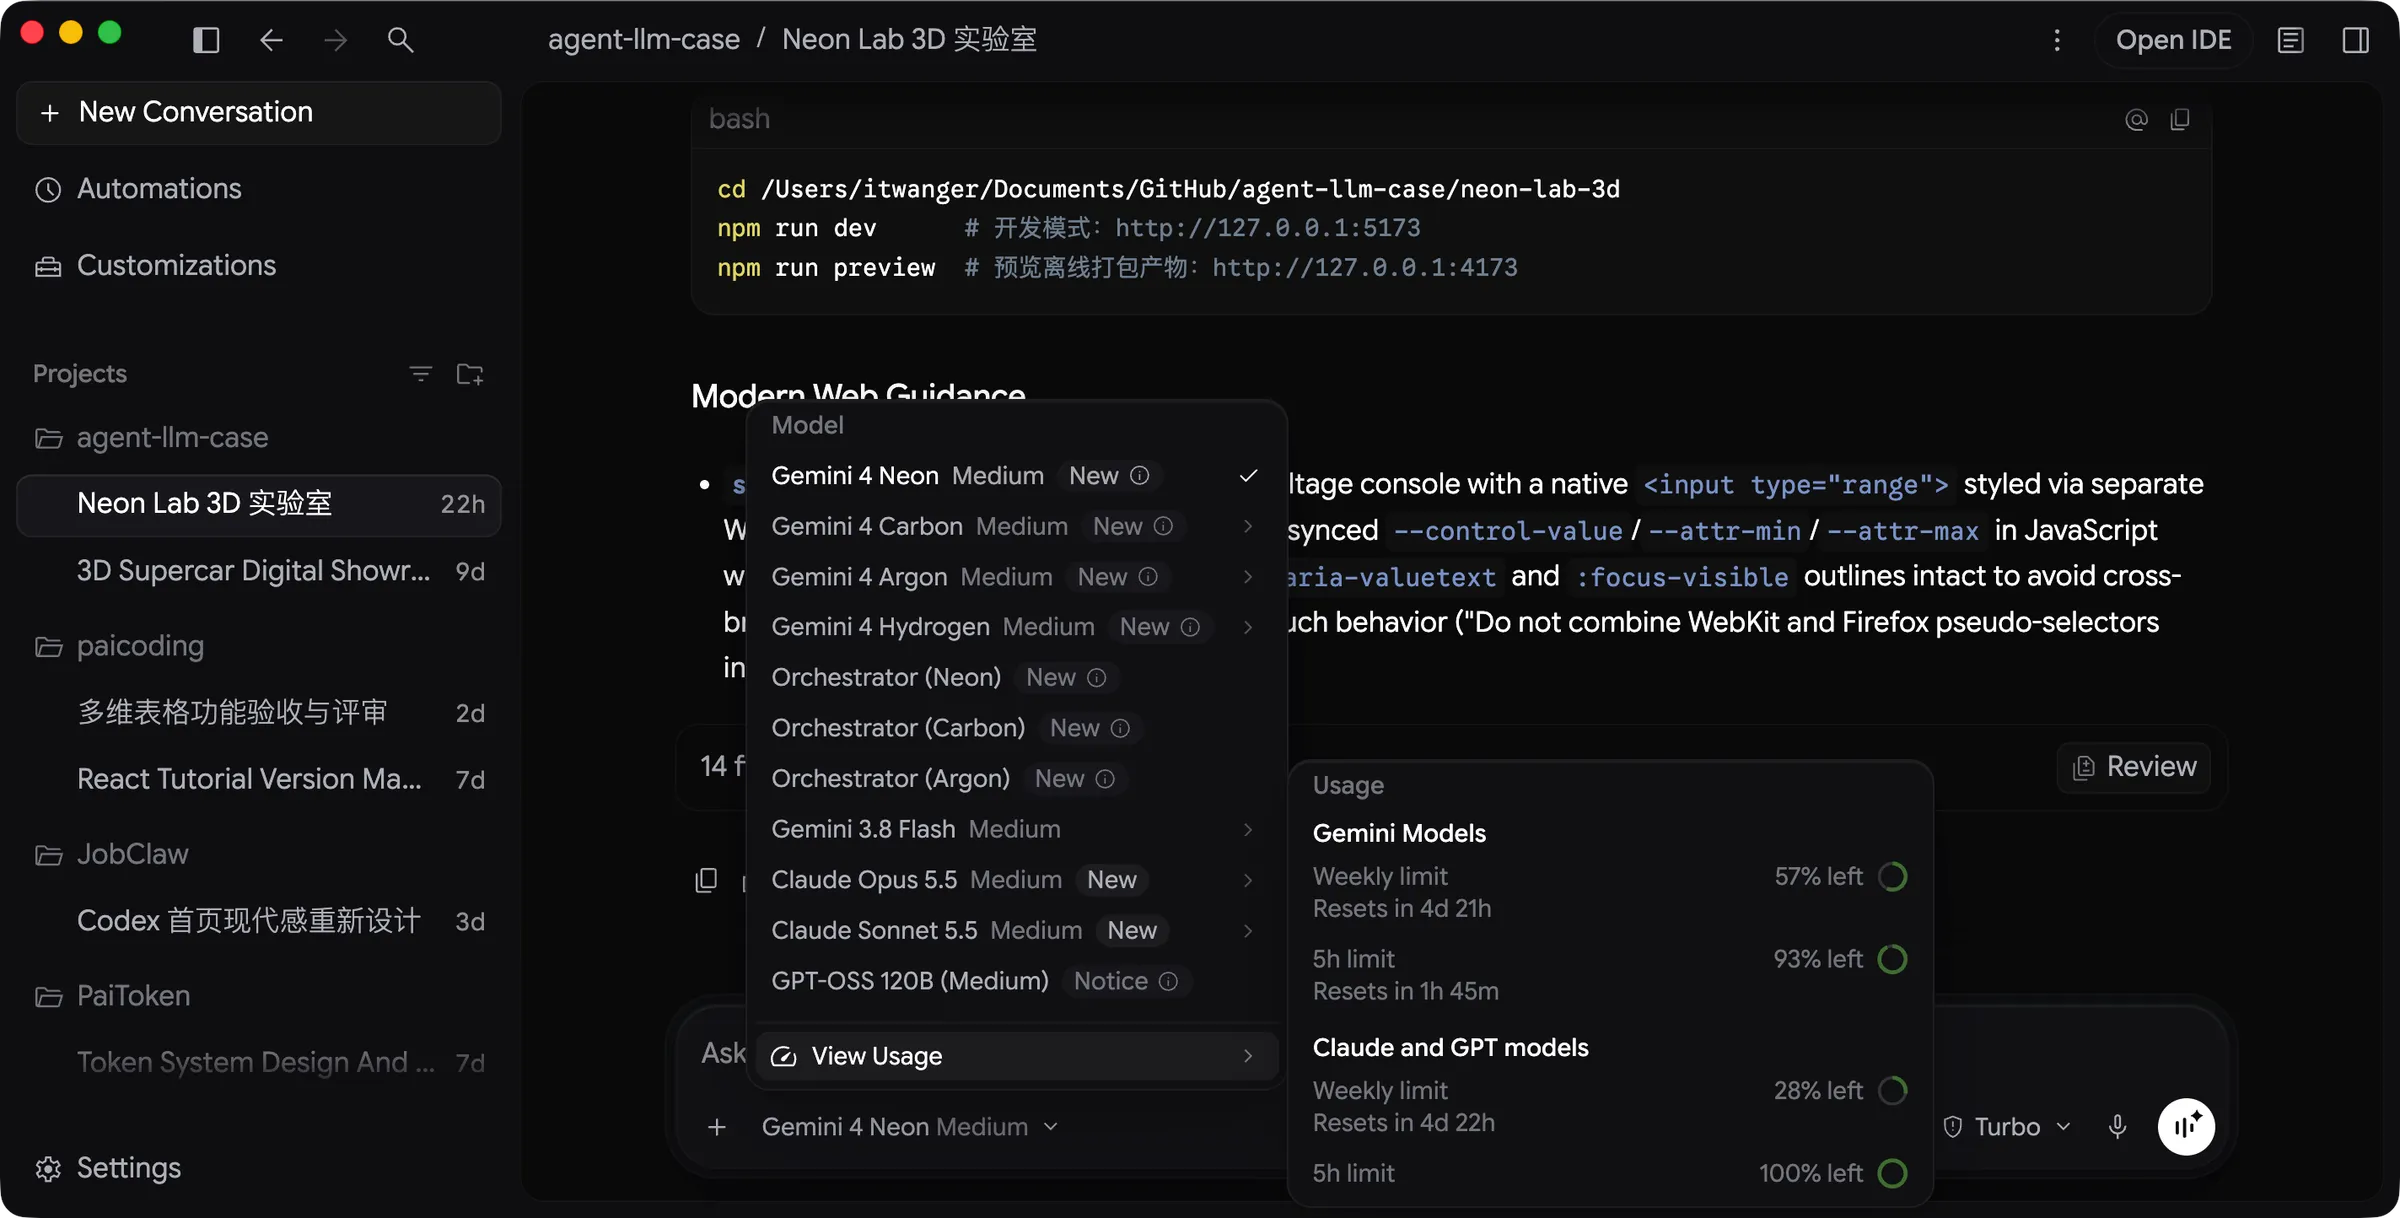
(之一是因为没办法放心大胆的用;之二是 500 刀的额度都不够造,视频效果还不如 Gemini 4 Neon)
除非你是真的习惯了之二,不想切换到其他的 Harness,否则你会发现,谷歌这次真的翻身了。
并且我强烈建议你立刻马上给自己整一套。
突然之间,Gemini 就开智了,这背后到底是为什么,也许这张截图能解释一切。
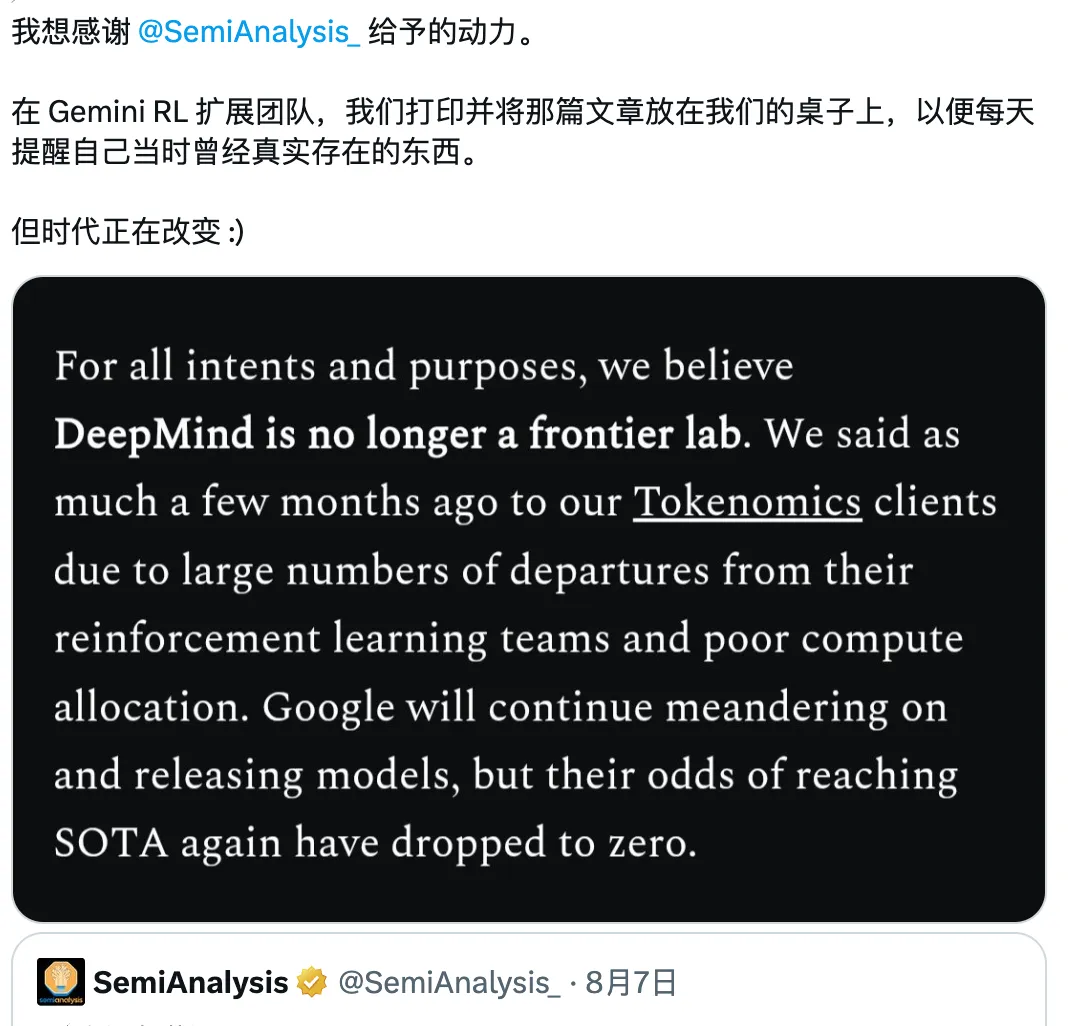
翻译翻译大家看一下。
总而言之,我们认为DeepMind已经不再是一家前沿实验室了。几个月前我们就向Tokenomics的客户表达了这一看法,原因是其强化学习团队大量人员离职,以及算力分配不佳。谷歌会继续漫无目的地摸索并发布模型,但他们再次达到最先进水平的可能性已经降为零。
换句话说,谷歌的研发团队知耻而后勇了。之前有大佬锐评他们不可能造出前沿模型了,可能性是 0,现在,谷歌靠 Gemini 4 Neon 打赢了这场翻身仗。
原来技术,也可以龙场悟道啊,突然就这样顿悟啊。
接下来,我将分享一系列 agy + Gemini 4 Neon 的用法,收藏起来认真去实践吧,你的生产力将因此大大提升。
01、Swarm
相信大家都有这样一个感受,上下文越来越长,Agent 到了后面很容易忘掉前面的约束。这一点,之二尤其严重,经常压缩完一轮后就报废了。
agy 里面的 /swarm 斜杠命令就是来解决这个问题的。
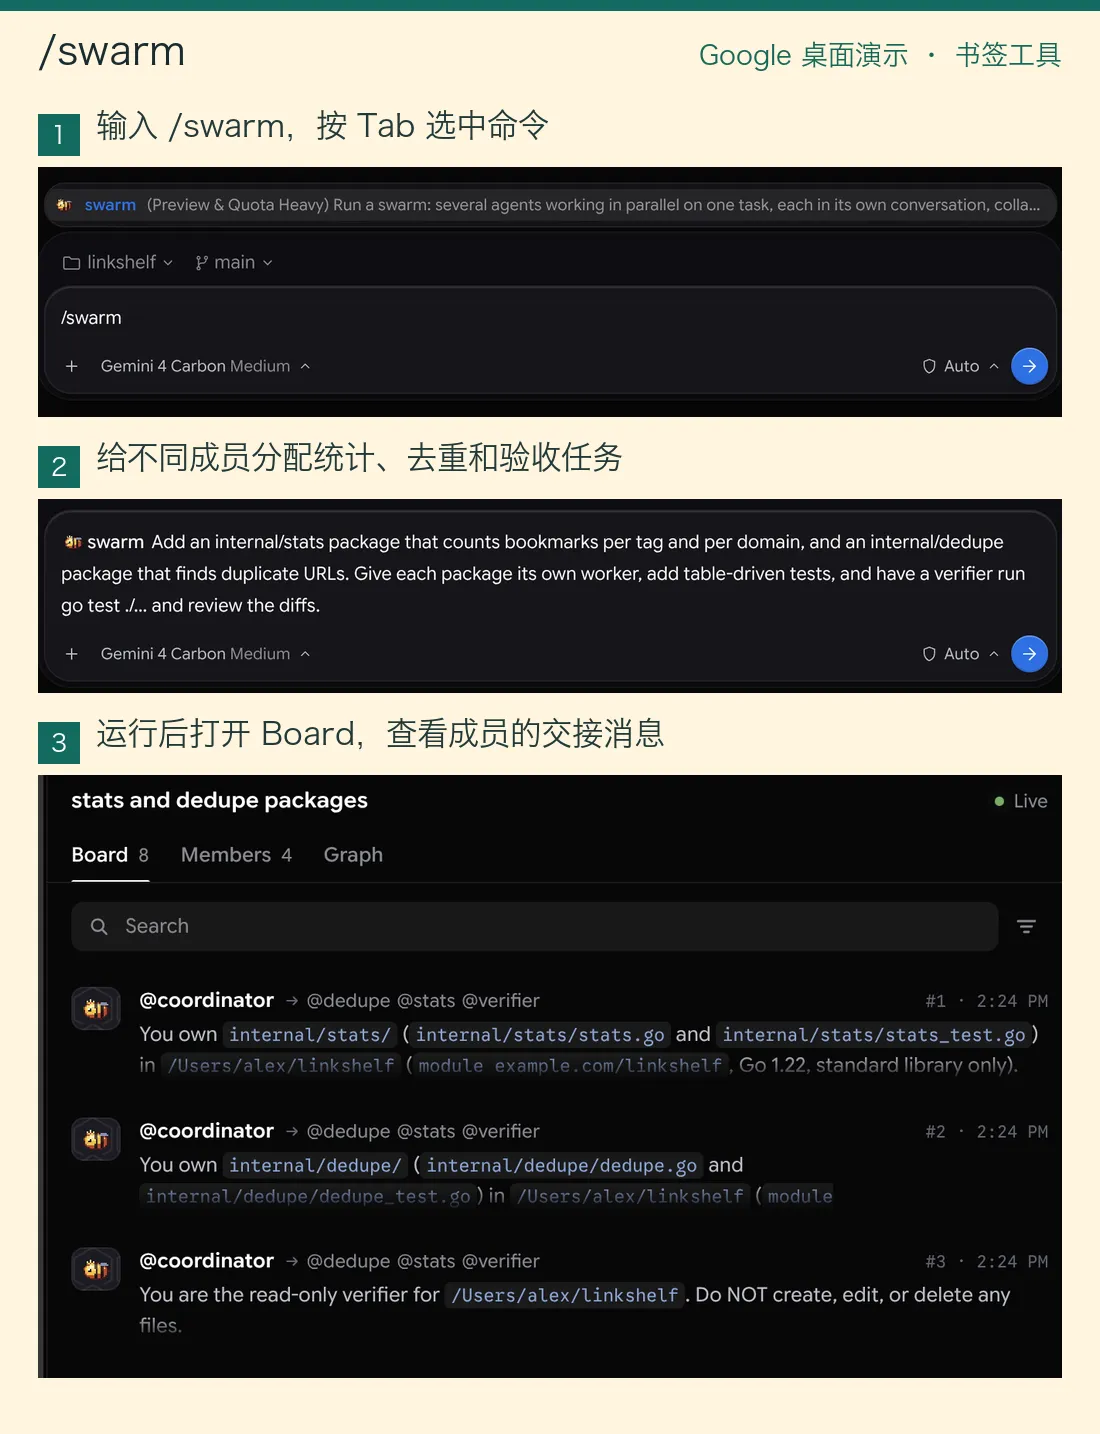
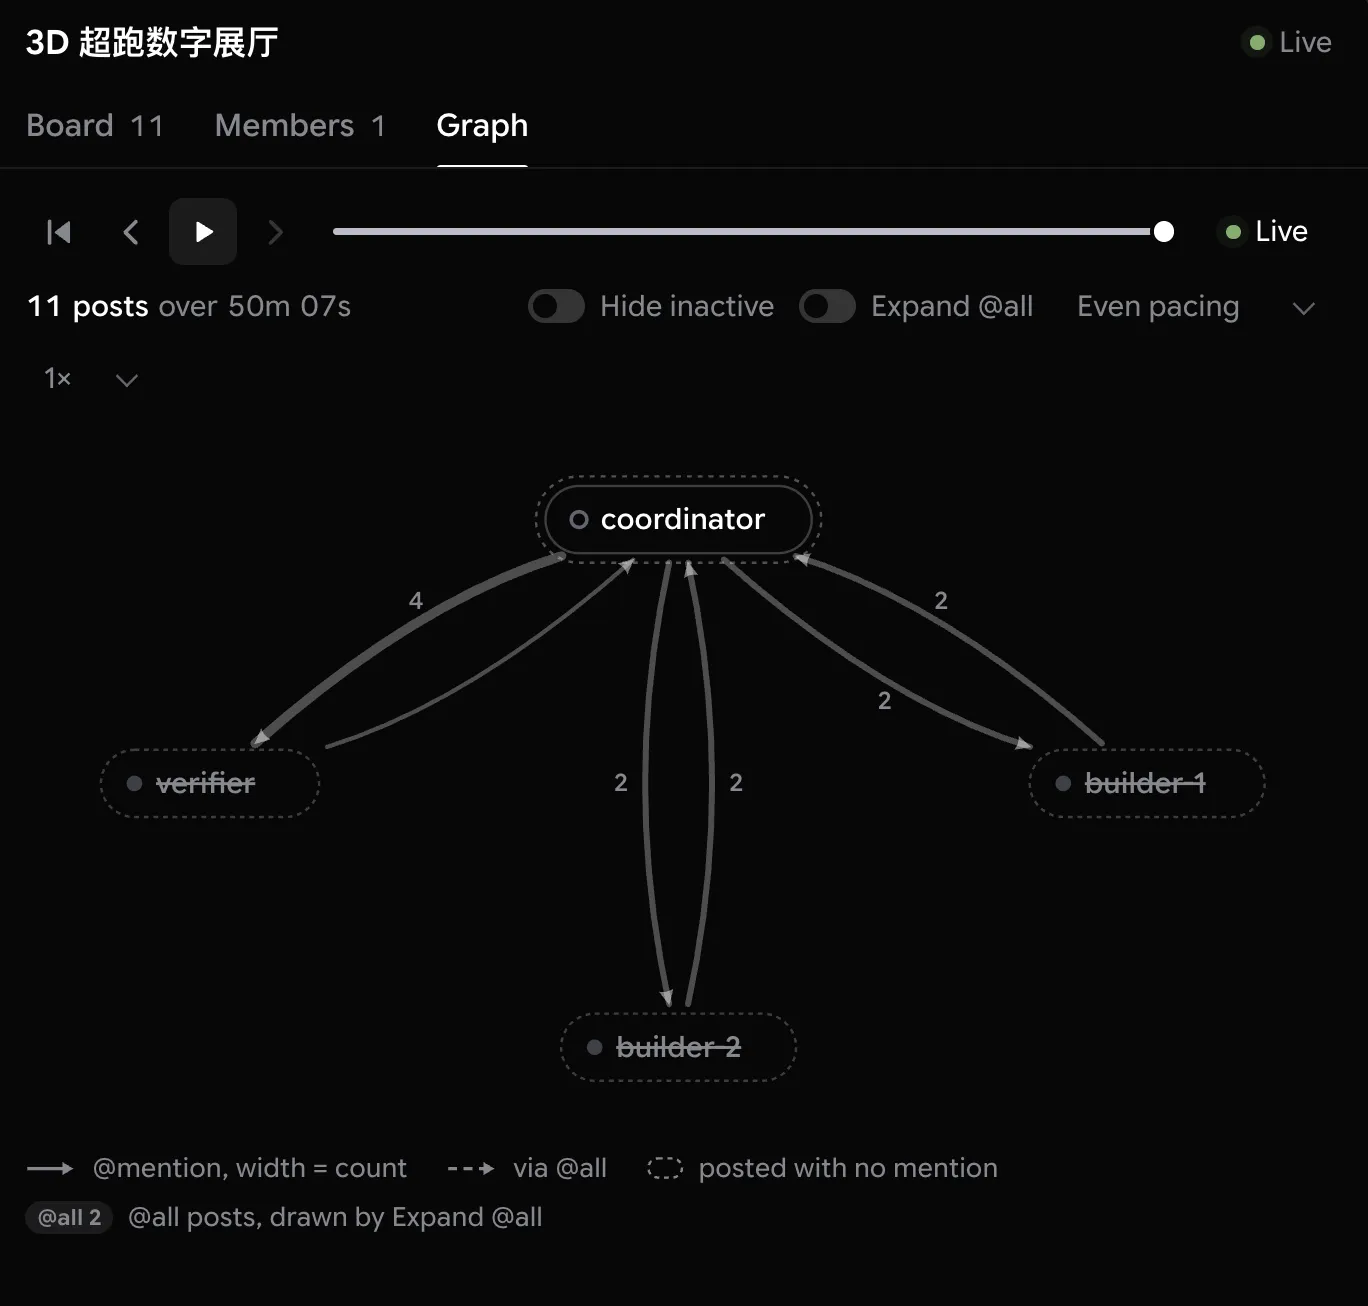
敲下 /swarm 并描述任务,你当前所在的会话会自动变成调度员(coordinator),先把任务拆分,再拉起一支分工明确的 Agent 团队同时开工。
调度员自己不写代码,也不负责排查和测试,只负责派活、验收结果和决策,这样主会话随时都能响应你的新指令。
它和多开几个标签页有很大区别,背后有一套严谨的工程设计。
先说公告板。所有成员的领活记录、改动摘要和测试结果,都按顺序贴在一块共享公告板上,并且一直保留。成员即使经历了上下文压缩,也能从指定序号往后补读,恢复之前的状态。成员之间交接时只引用消息序号(比如让验收员核查 #4 和 #6),不用把整段汇报复制到下一条消息里,反复消耗额度。
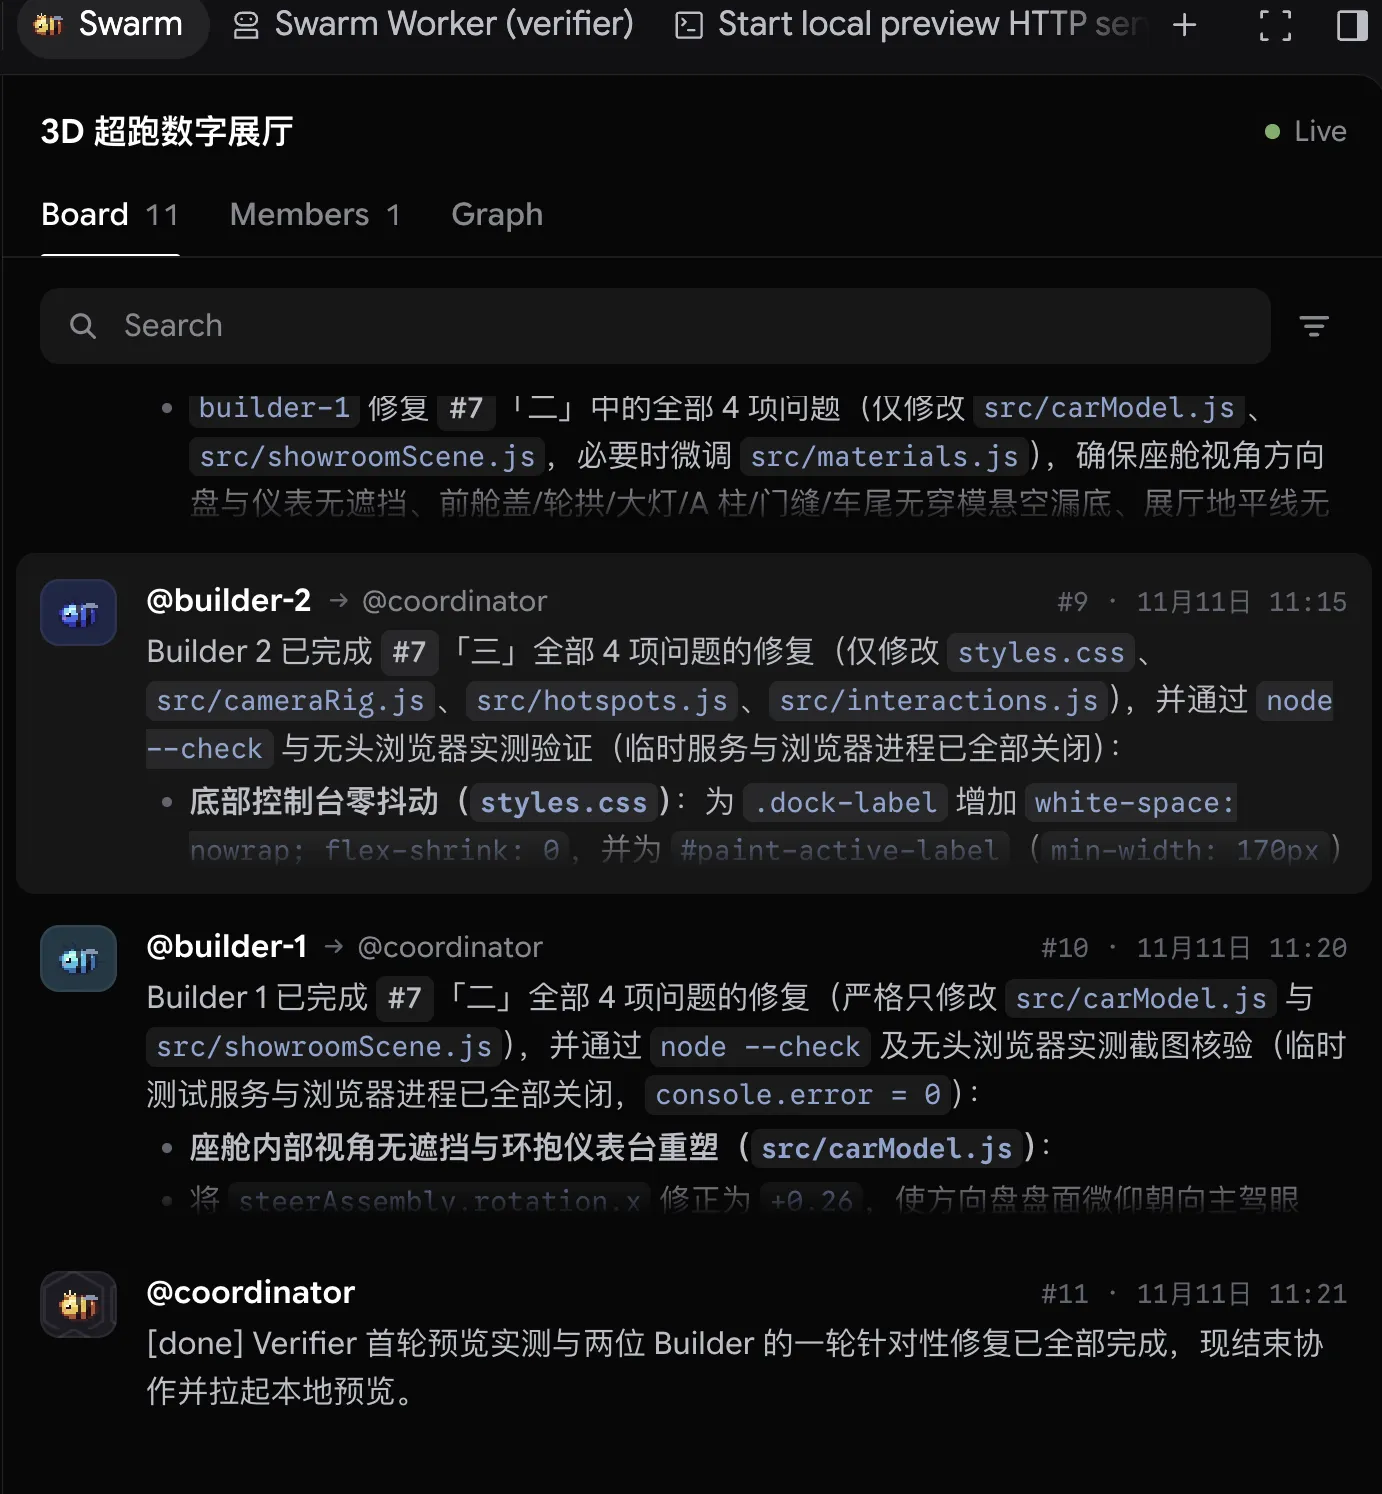
再说唤醒和频道。在公告板上 @ 某位成员,就会把它唤醒。手头没活的成员处于 waiting 休眠状态,不消耗任何 Token,只有被点名才会醒过来,所以成员之间交接时只 @ 下一步要动手的同伴,不要用 @all 唤醒全员。团队规模超过八人,或者分属多个独立模块时,调度员会单独建频道,公共频道 main 只留跨模块的决策,模块内部的沟通改用 @#channel 只唤醒对应频道的成员。
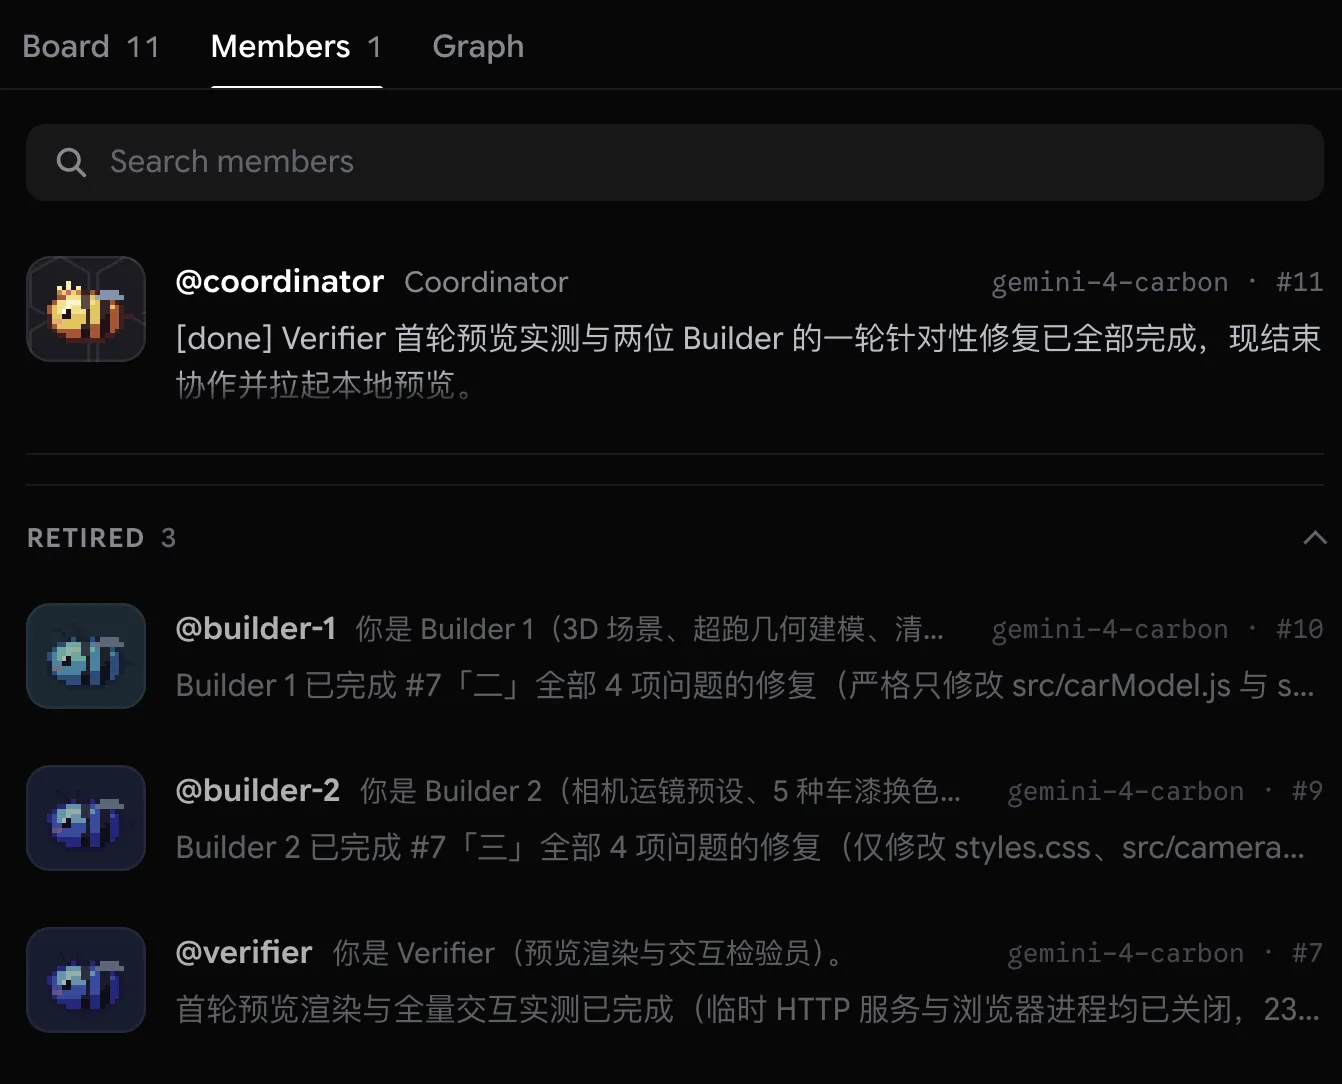
然后是验收。配 2-4 个干活的成员,调度员就会配一名 @verifier 验收员,专门读改动、跑测试、按真实用户的体验走一遍,发现问题就点名让原作者返工。验收员自己不改代码,这样从机制上避免了两名成员同时改同一个文件。后台还常驻着一名 @monitor 巡检员,每隔三分钟检查一次全员状态,平时不说话,只有全员都停在 waiting 但任务还没完成、或者有人漏看了消息时,才会发一条带序号的提醒,任务结束后会自动撤掉定时任务进入休眠。另外还有一名不发言的 narrator,专门盯着公告板把进展整理成结构化数据,实时渲染成 Swarm UI 里的概览视图。
接着是工作区隔离。只读分析和验收的成员默认共用主工作区(inherit);需要同时改代码或跑构建的成员,调度员会通过 workspace:"share" 给每人开一份共享底层仓库的独立工作副本(类似 git worktree),或者用 branch 拉一份独立克隆,各自提交后再合并回主分支。销毁成员时,kill 会顺手删掉对应的工作区,所以改动必须先合并再销毁。新成员默认是冷启动,看不到主对话的历史,但如果某项排查要分两条线深挖,调度员可以用 fork 复制指定成员已经读过的文件和推理历史,省去从头排查的时间。
最后是模型和额度。默认全员都和主会话一样用 Gemini 4 Neon,也可以在提示词里点名让验收员换另一款模型交叉检查,甚至允许成员自己再拉起帮手处理子任务。万一某个成员跑到一半额度用完了,不用销毁重来,等它停在 waiting 状态后,让调度员给它换一个还有额度的模型,它就会带着完整的上下文接着干。
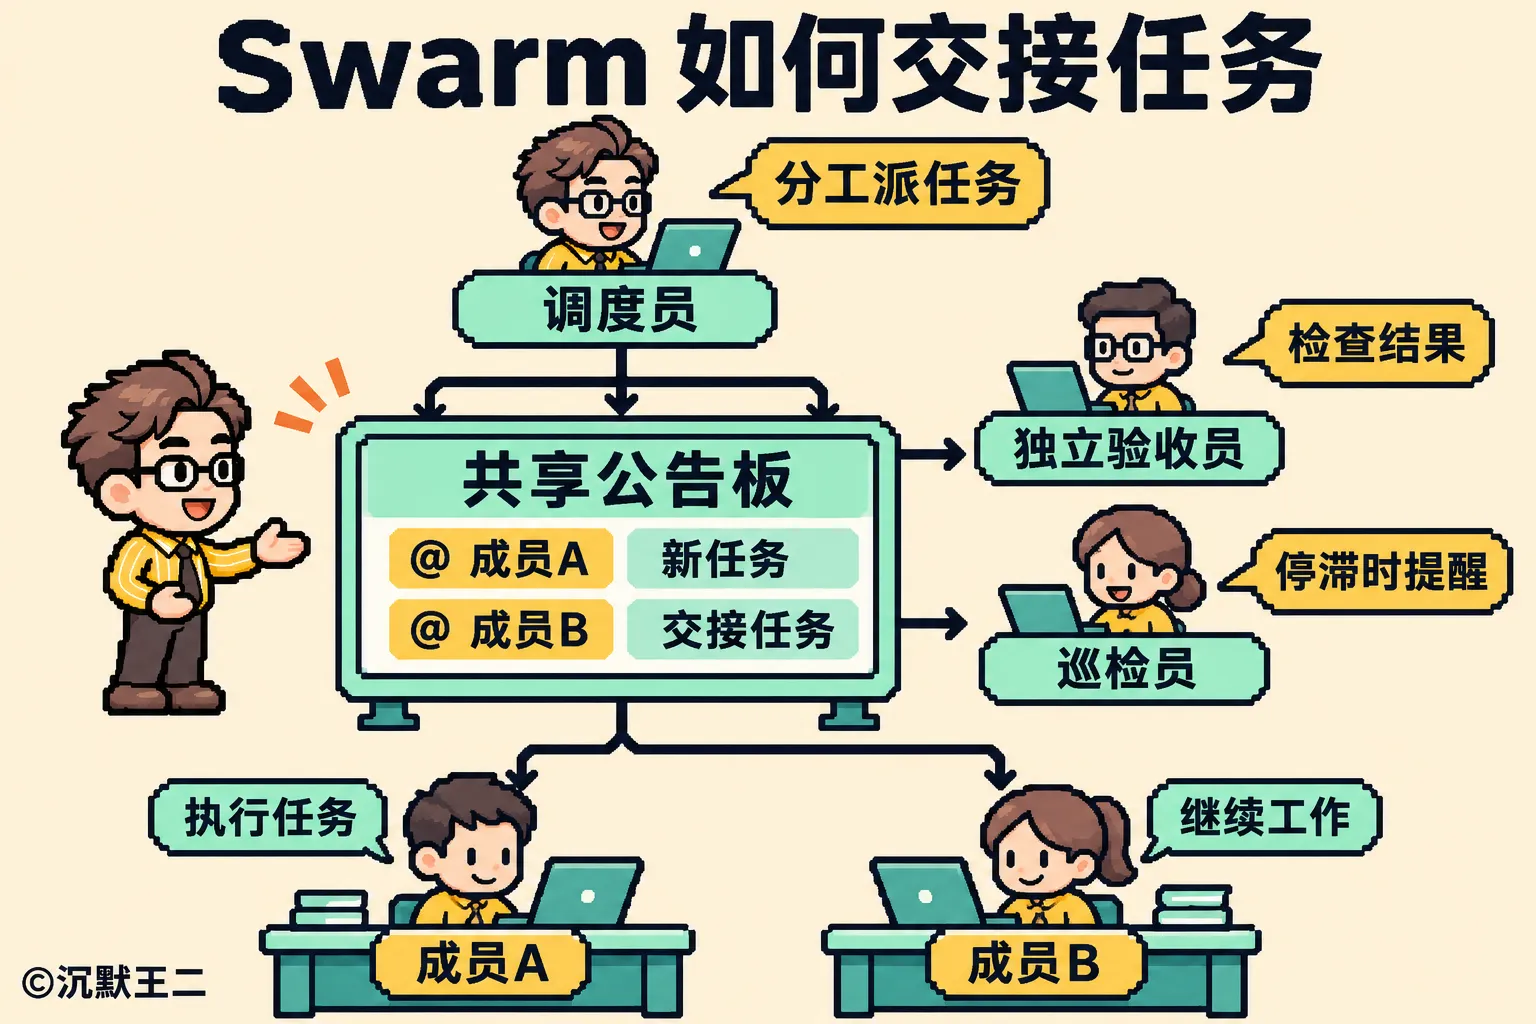
谷歌 11 月 18 日发布 Gemini 4 Neon 时,还放出了一个很酷的演示,用 /swarm 配合 Neon 做了一款能在内置浏览器里运行的双人关卡游戏。
如果你想亲手试一试这套多 Agent 协作,新建一个空目录,选好 Gemini 4 Neon(默认的 high 档就够了),把下面这条指令复制进 agy 的输入框就能跑起来。
/swarm 在当前空目录从零开发一款能在浏览器里运行的《霓虹双人弹球对战》小游戏,要求包含 3 个难度递进的关卡、带发光拖尾的画面、合成的撞击音效,以及玩家和 AI 对手实时对战的模式。请把画面渲染、物理碰撞与 AI 对手逻辑、自动化测试分给不同成员并行开发,再配一名独立验收员在浏览器里确认没有报错、碰撞判定正常后再交付。
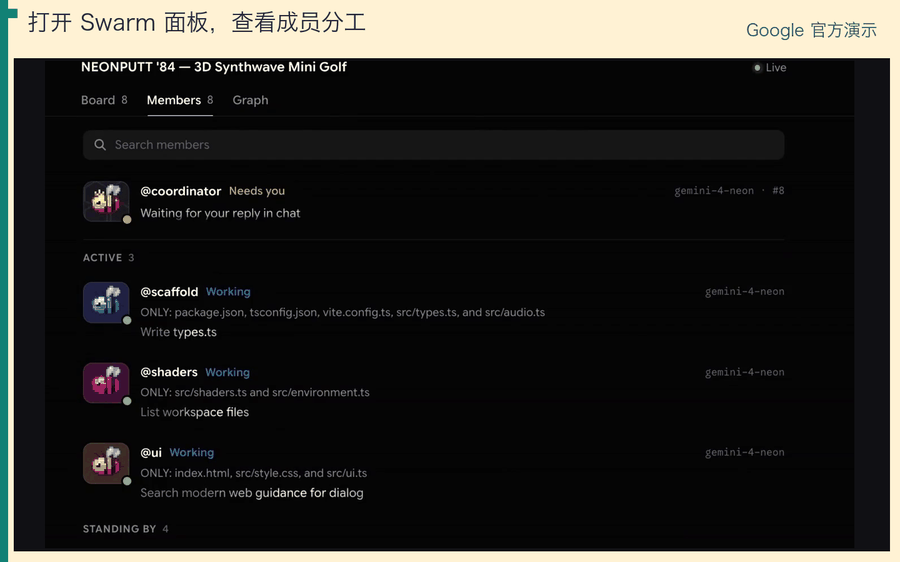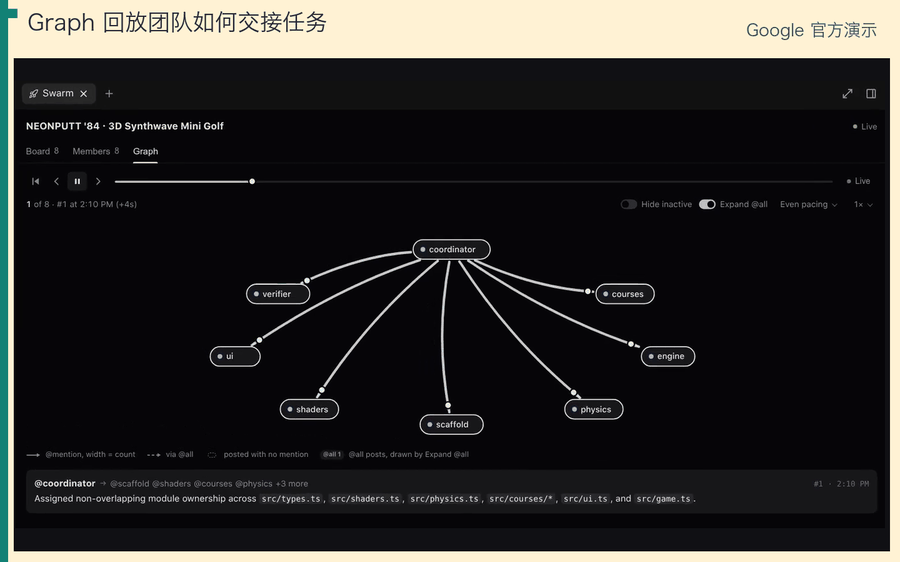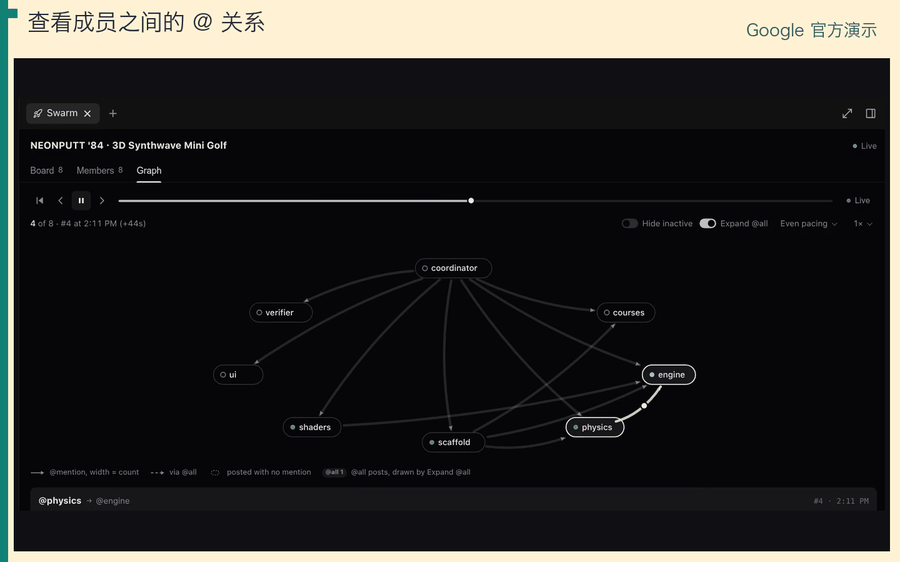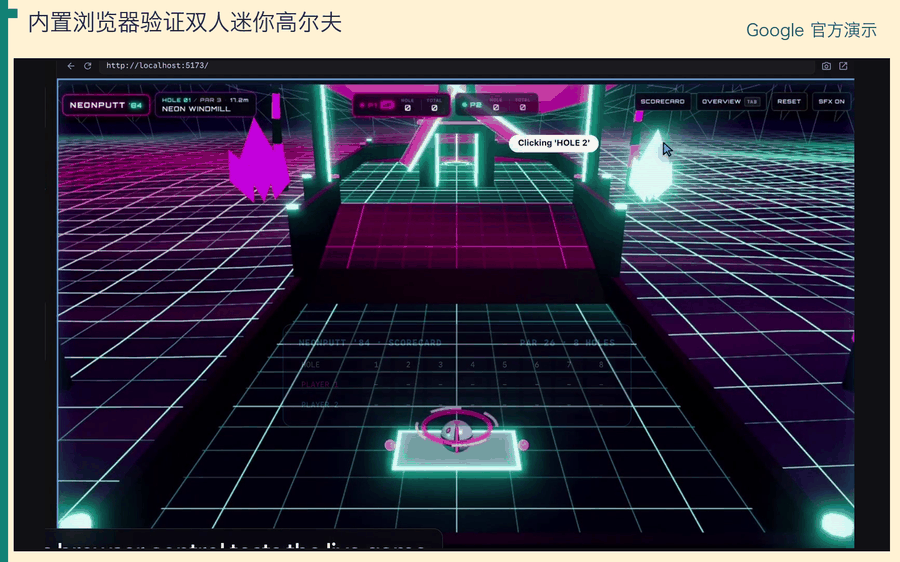
等调度员把团队拉起来后,记得点开回复里的 Open the Swarm UI,切到 Board 和 Graph 标签页,看看成员们是怎么在公告板上互相 @ 交接的。
02、SSH
大型项目的编译、Docker 容器、GPU 训练环境和线上日志,通常都在远端的 Linux 服务器上。
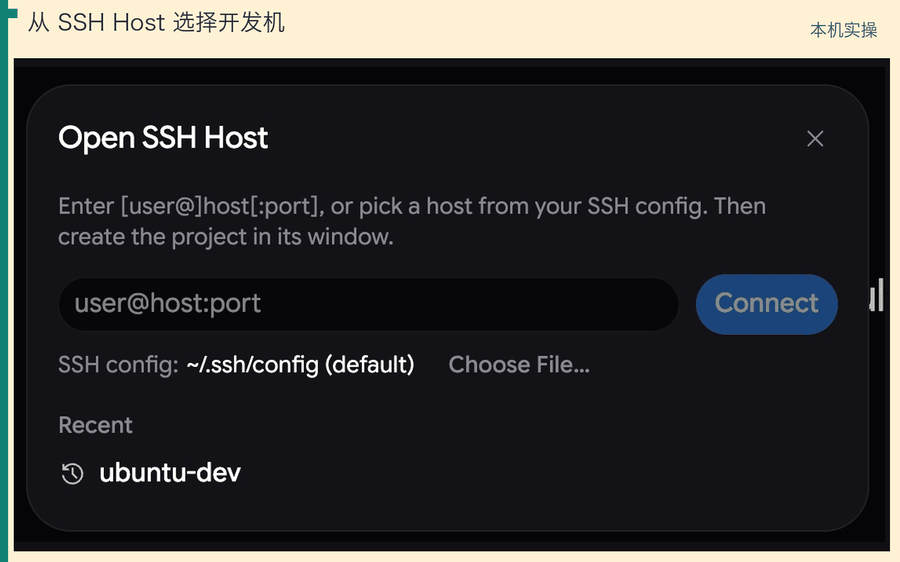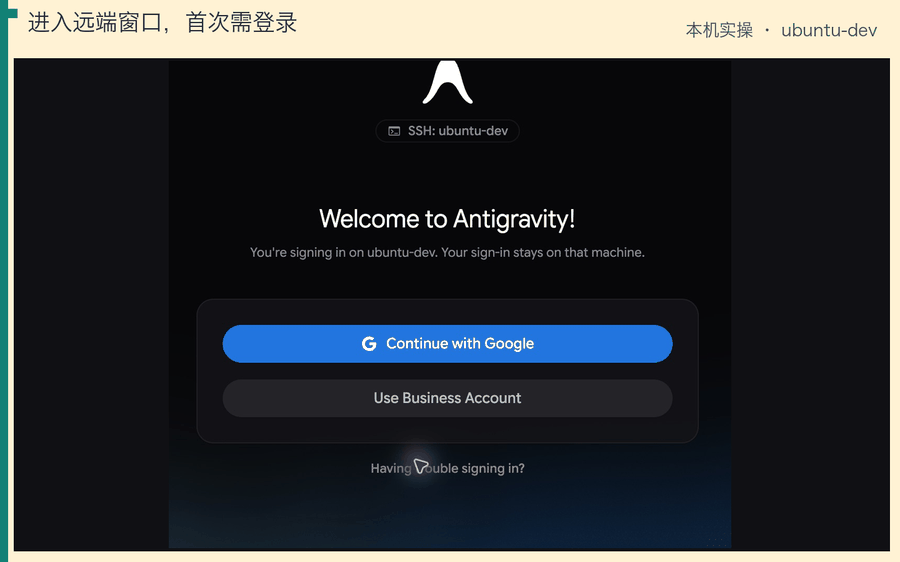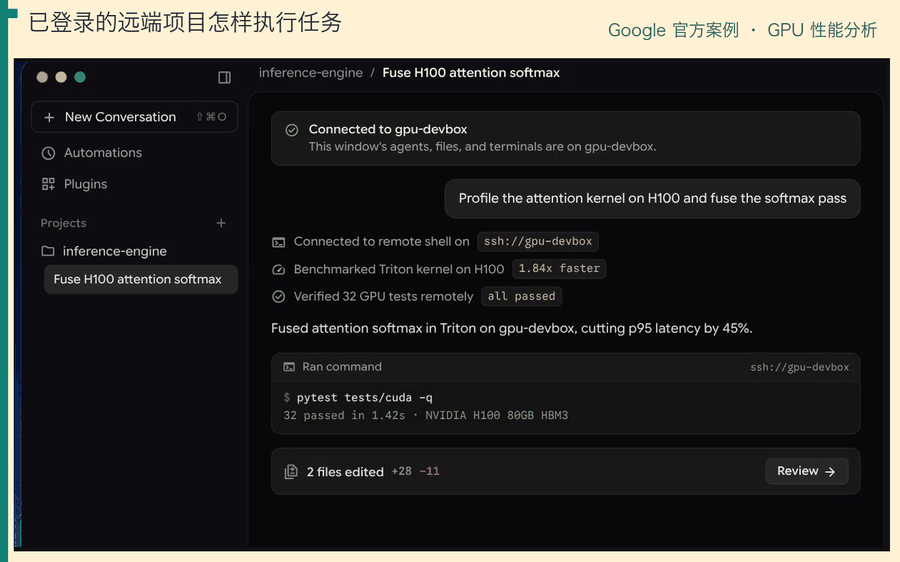
把 agy App 升级到 v2.33.0 或更高版本后,不需要再靠同步脚本或者来回切换终端,在左侧边栏点 Projects 旁边的 Create New Project,选择 SSH Host…,或者按 Cmd + Shift + P(Windows 和 Linux 按 Ctrl + Shift + P)搜索 Connect to SSH Host…,就能为远程服务器单独开一个窗口。
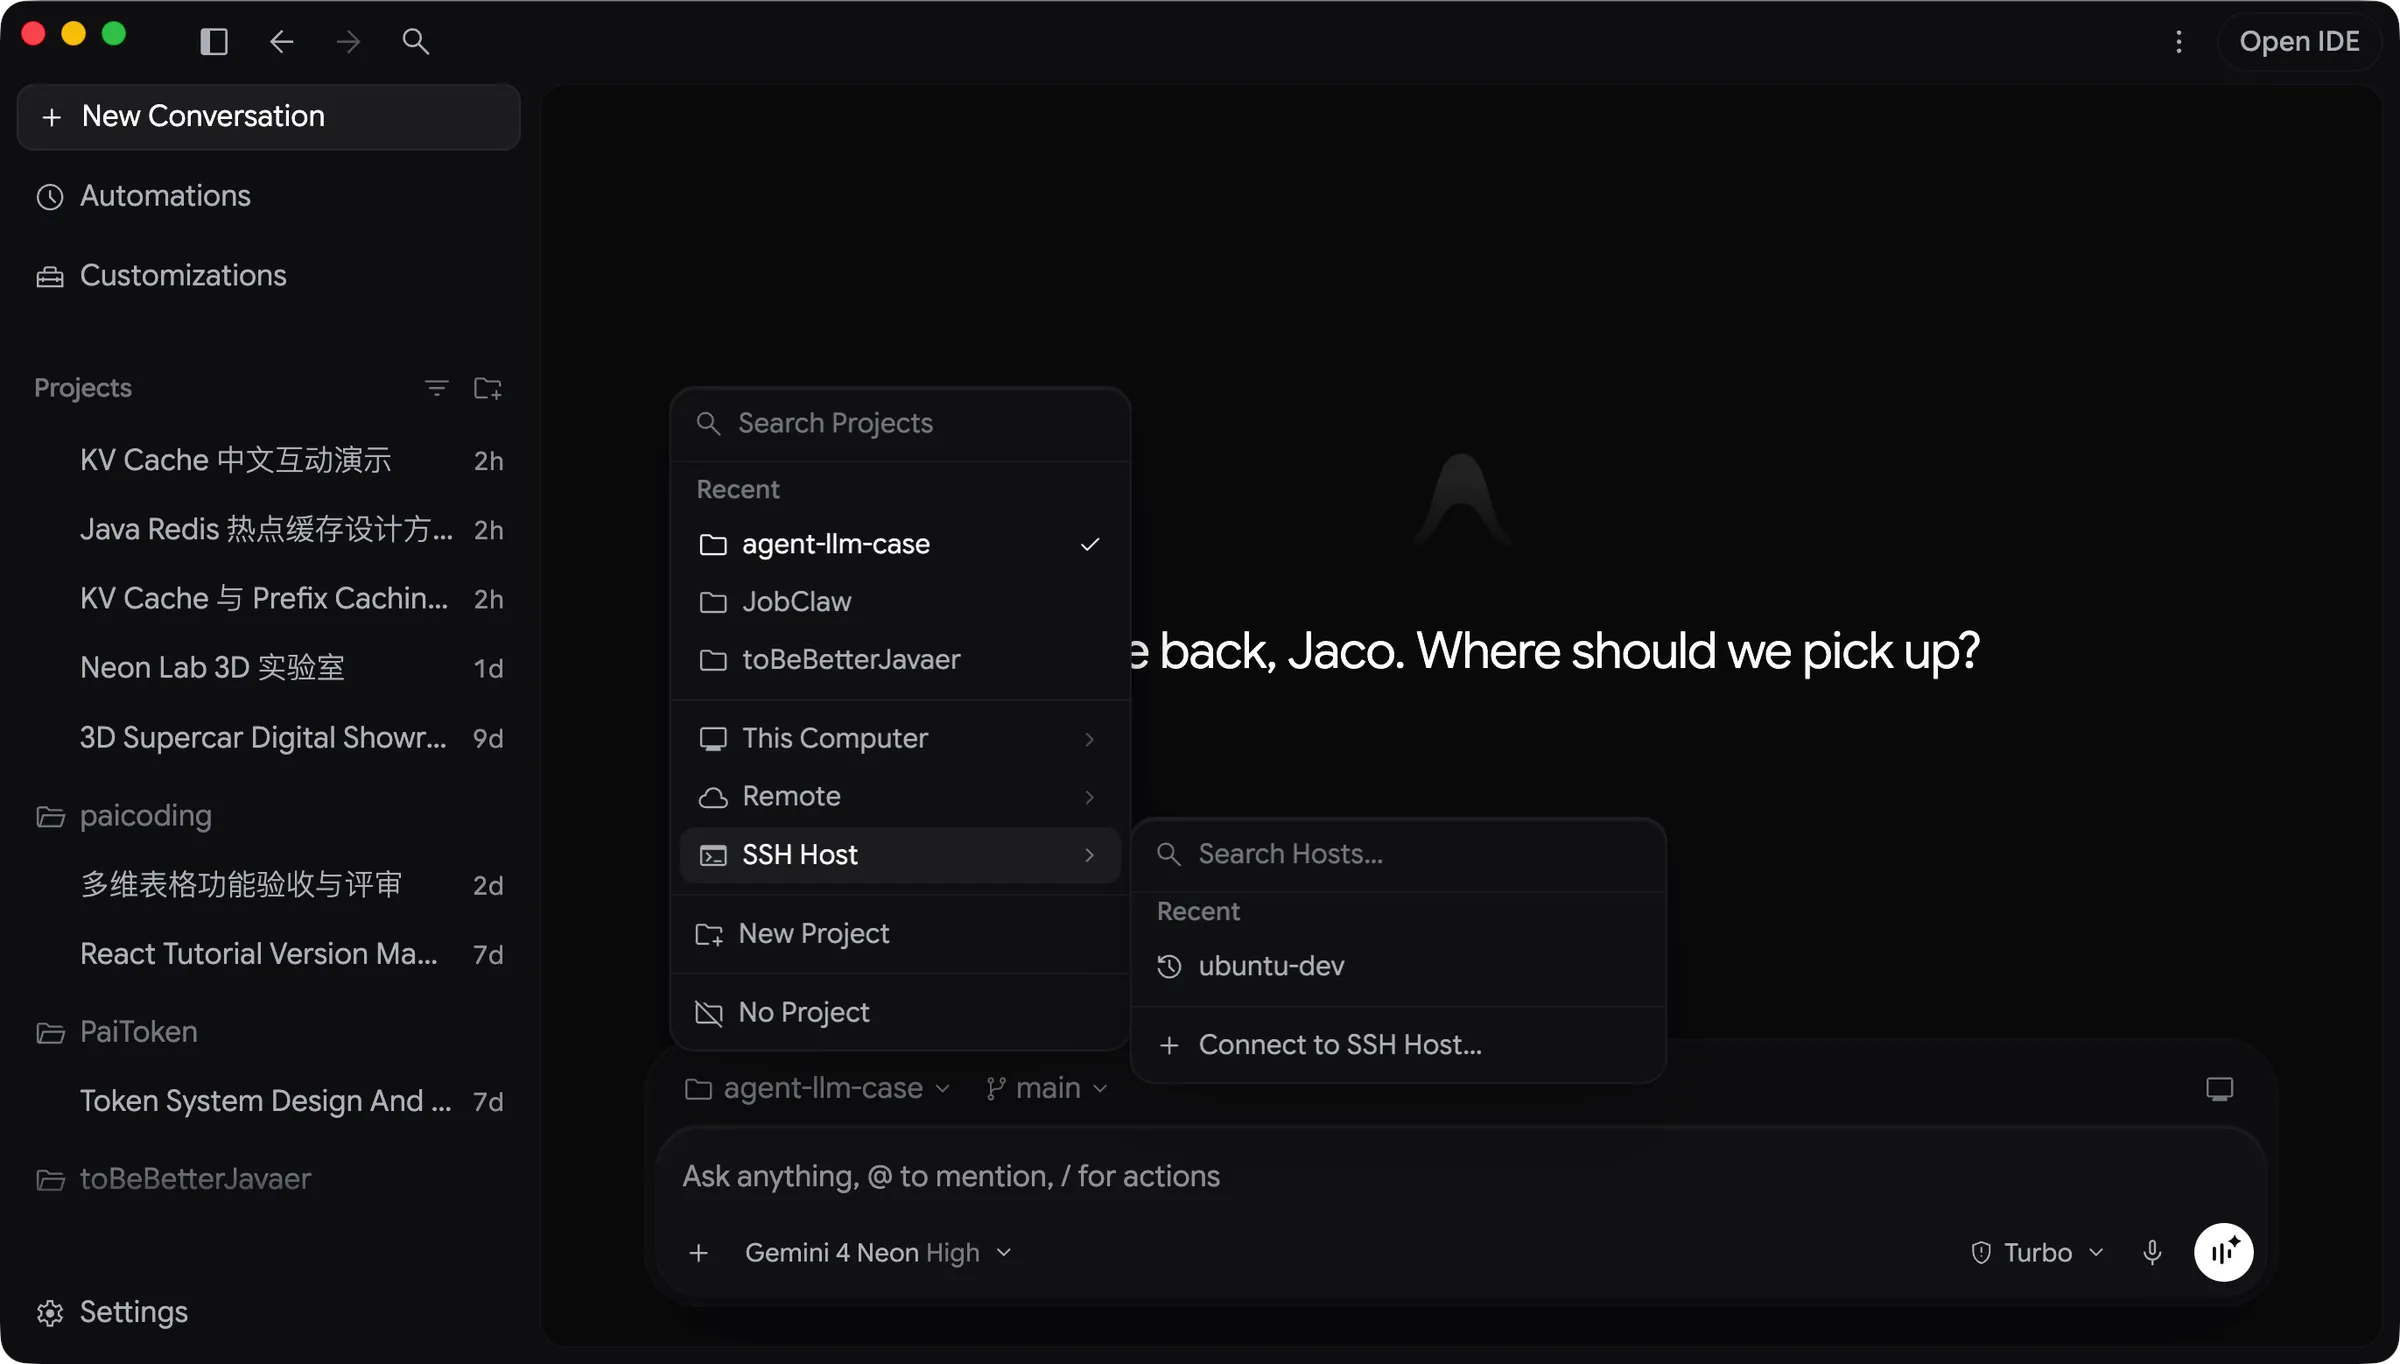
连上之后,agy 会通过本机的 OpenSSH 自动把远端服务部署到宿主机的 ~/.antigravity-hub-server/ 目录,Agent 数据放在 ~/.gemini/ 下。项目文件、Git worktree、终端进程和所有的 Agent 调用都直接跑在远端宿主机上,本地桌面端只负责渲染交互界面。
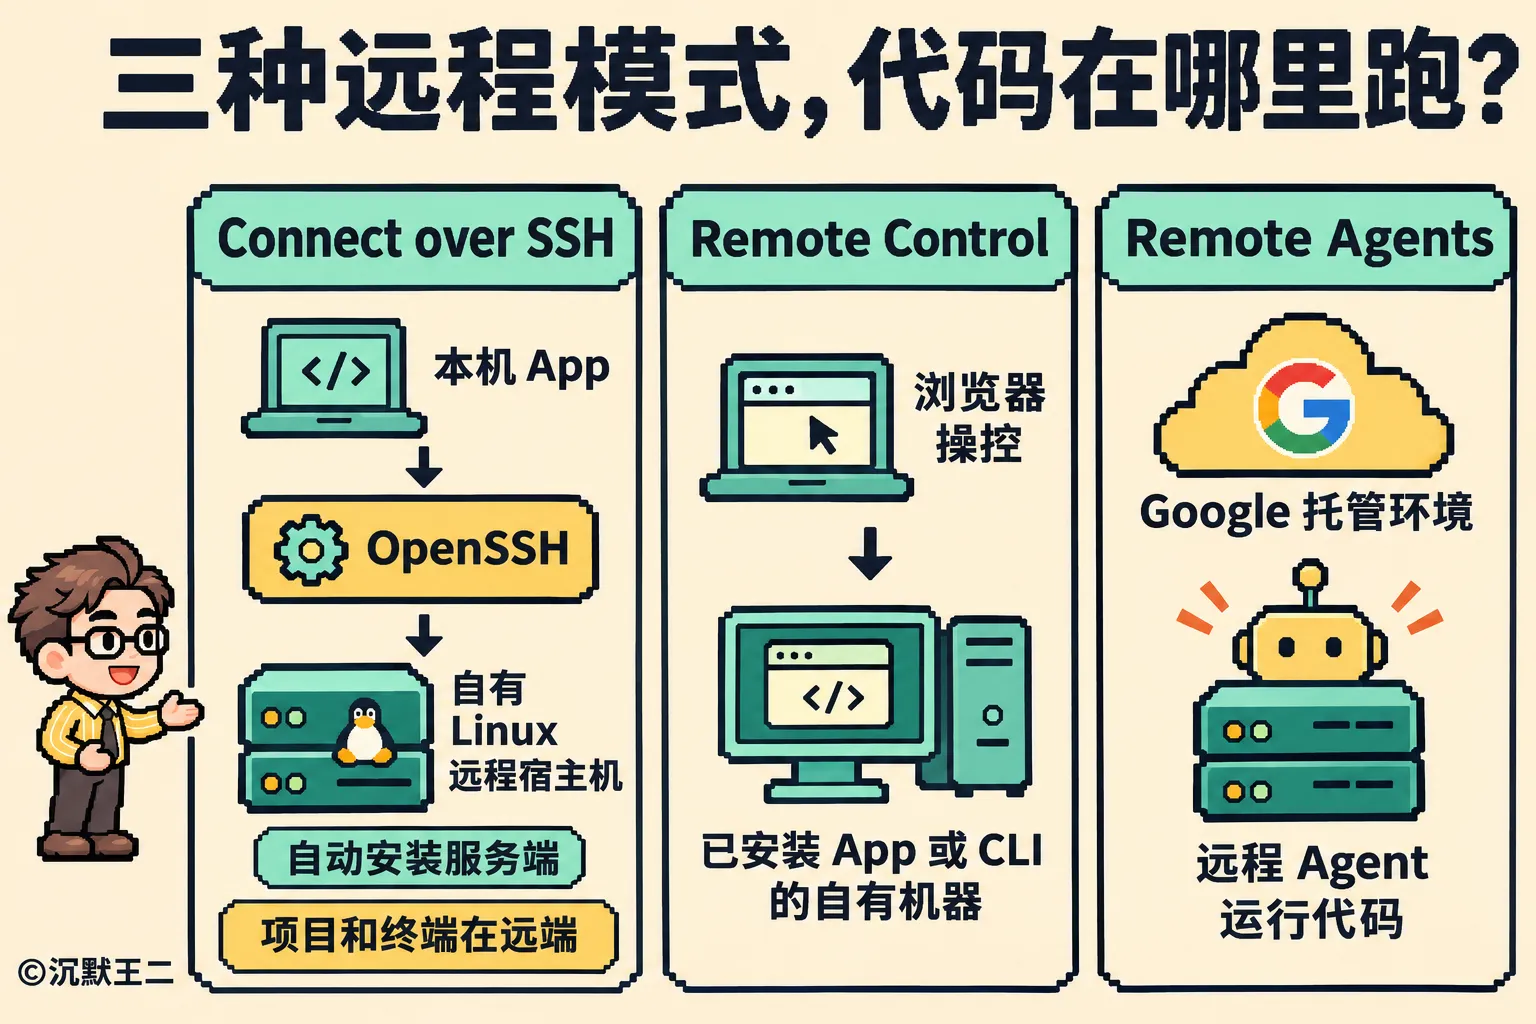
很多人容易把 Antigravity 里的三种远程能力搞混,它们最核心的区别在于执行位置。
Connect over SSH 的执行环境是你自己的远端 Linux 宿主机,入口是本地的 agy App(也可以在宿主机的终端里装 agy CLI),适合借用远端的算力机、GPU 服务器或测试服务器做开发和排障。
Remote Control 的执行环境依然是你自己的本地电脑或服务器,入口换成了任意设备上的浏览器(访问 antigravity.google.com),操作的是本机目录和还没提交的 Git worktree,适合人离开工位后远程看进度、批计划。
Remote Agents 的执行环境在 Google 托管的云端隔离环境里,挂载 GitHub 仓库或上传文件就能跑长程任务,本地电脑休眠或者切到手机上,任务照样继续推进。
使用 Connect over SSH 有几条规则需要提前核对。
远程主机必须是 64 位 Linux(x86_64 或 arm64),常见的 Ubuntu、Debian、RHEL 都没问题,暂不支持 Alpine 这类精简系统,也不支持 macOS 和 Windows。目标机器以及中间经过的跳板机(ProxyJump),SSH 服务都必须允许端口转发;另外宿主机要能访问 HTTPS,当前用户的 $HOME 目录也要有读、写和执行权限。
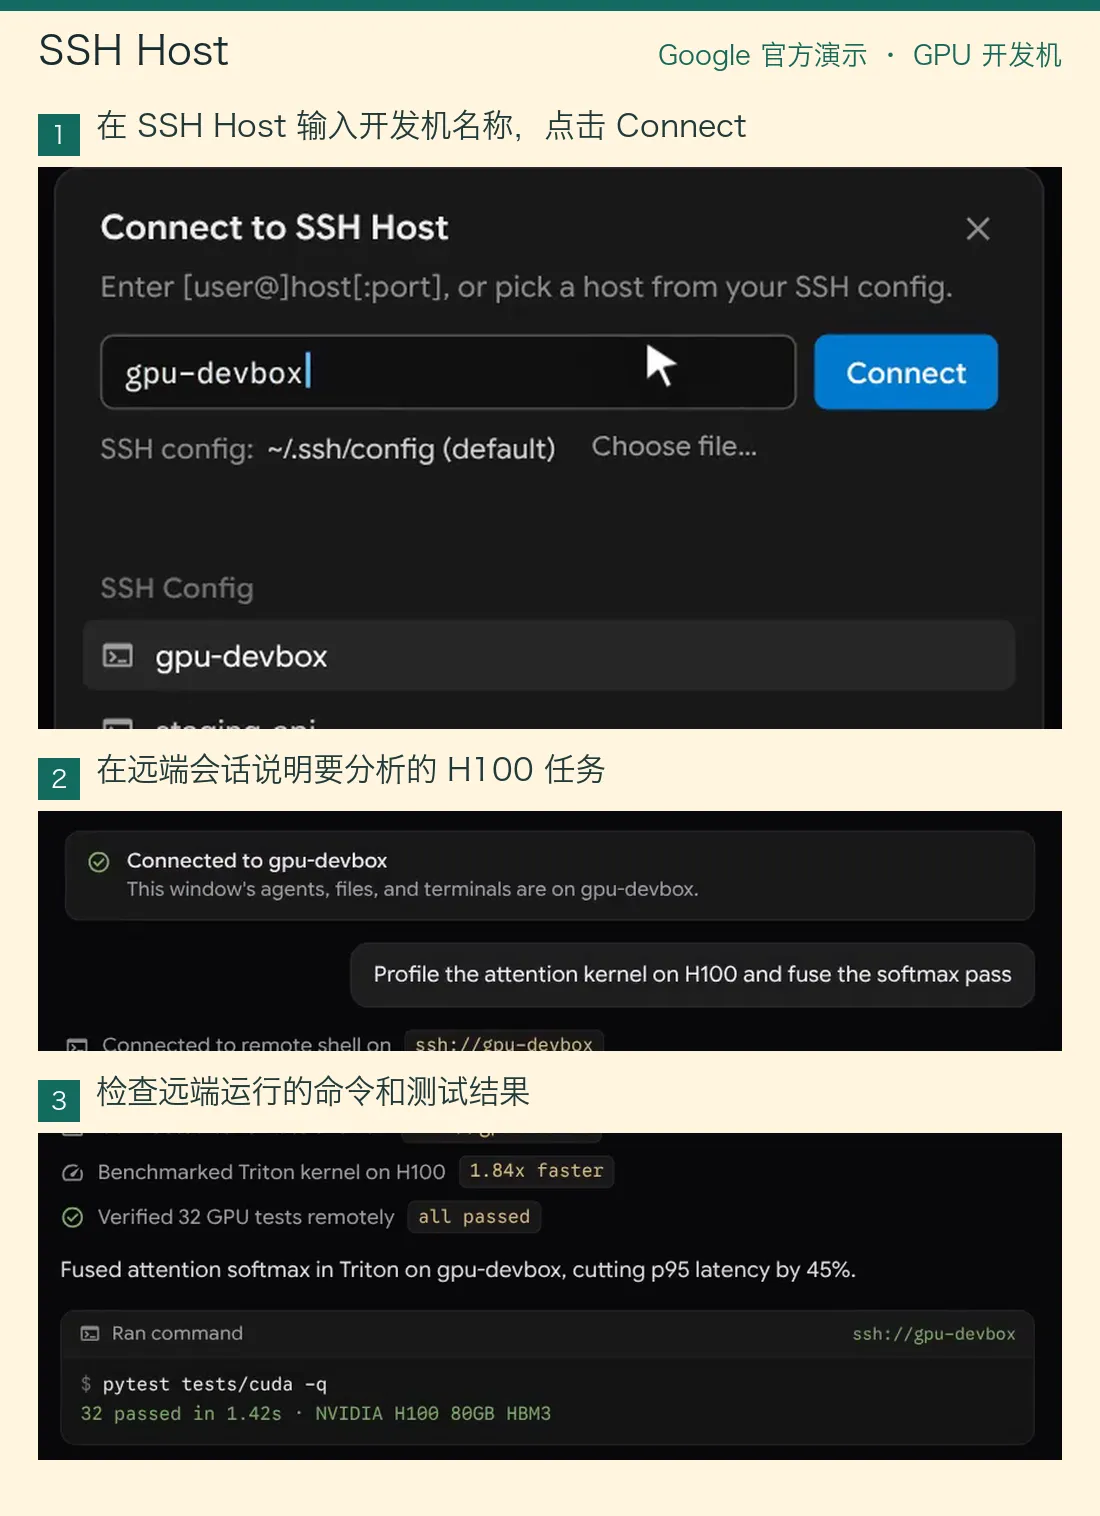
连上测试机或生产备用机后,可以先拿下面这条只读的巡检指令跑一轮,既能验证远端终端的权限是否正常,又能让 Neon 顺手帮你把服务器的健康状况检查一遍。
请检查当前服务器上的磁盘占用、内存使用和正在运行的 Docker 容器状态,帮我排查最近 24 小时内占用资源最高的服务或异常重启日志,输出一份附带具体命令作为证据的巡检摘要,不要修改任何生产配置。
03、Dynamic Workflows
agy 在 v2.32.0 推出了一个名叫 /run-workflow(动态工作流)的斜杠命令。
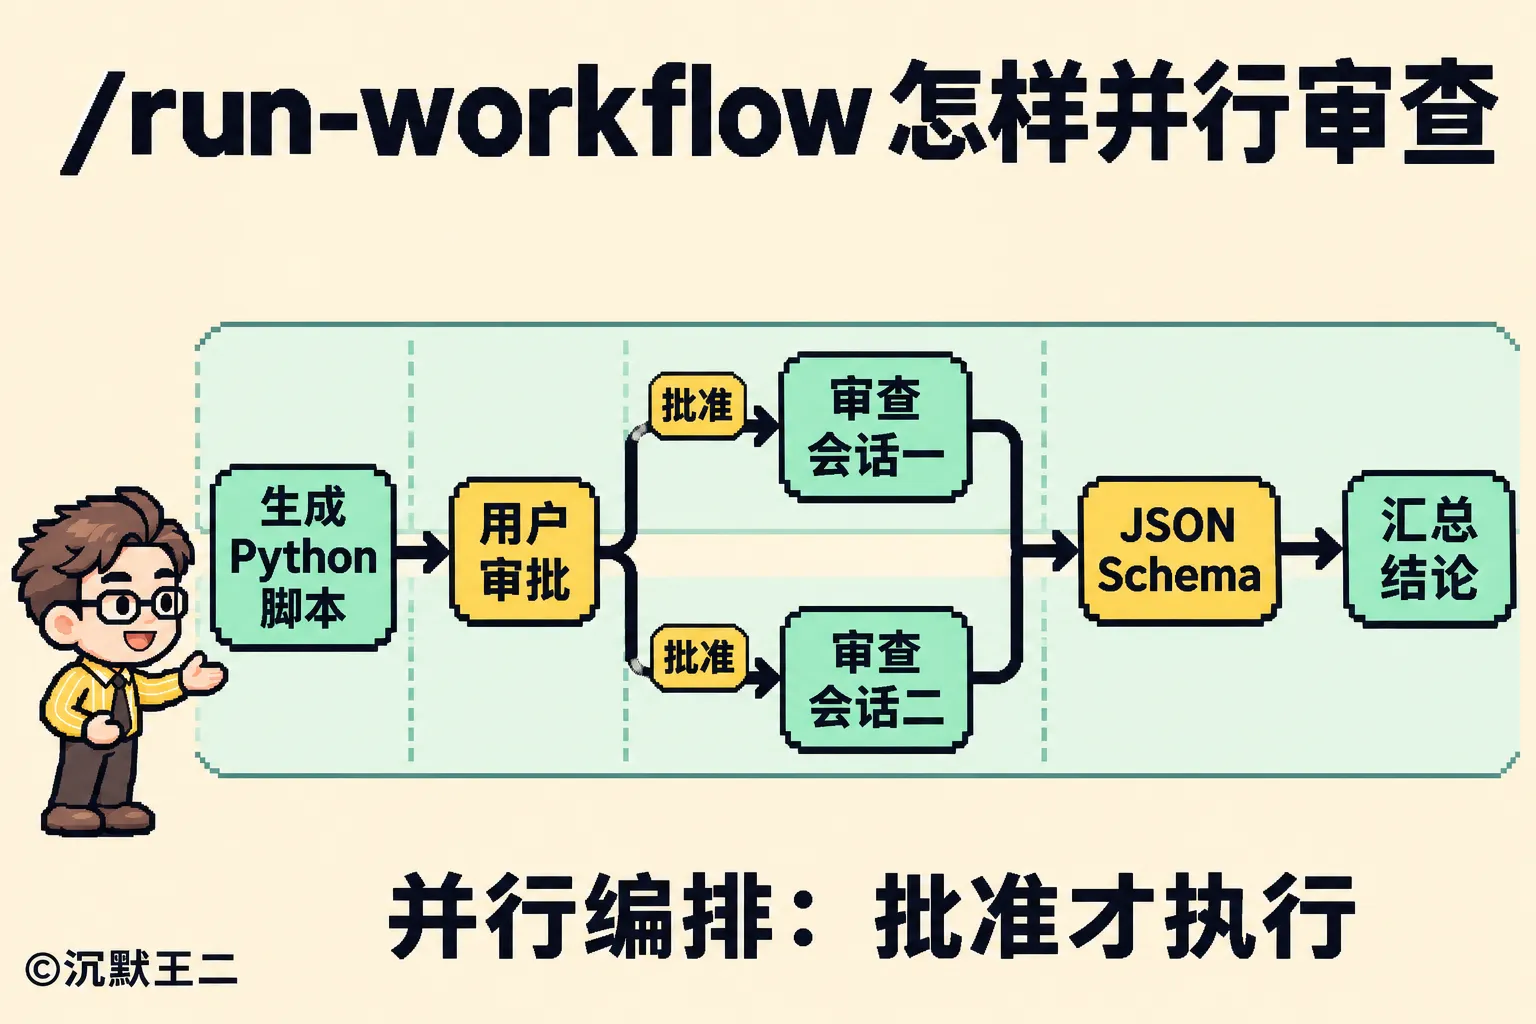
碰到要按文件清单逐个扫描、或者分阶段汇总的任务,只靠自然语言写提示词,很难保证不漏掉项目、格式不出错。
敲下 /run-workflow 描述完任务,Gemini 4 Neon 会先写一段支持顶层 await 的 Python 编排脚本,用代码把执行顺序、并发策略和数据格式固定下来,再交给 Harness 在独立的 python3 进程里运行。
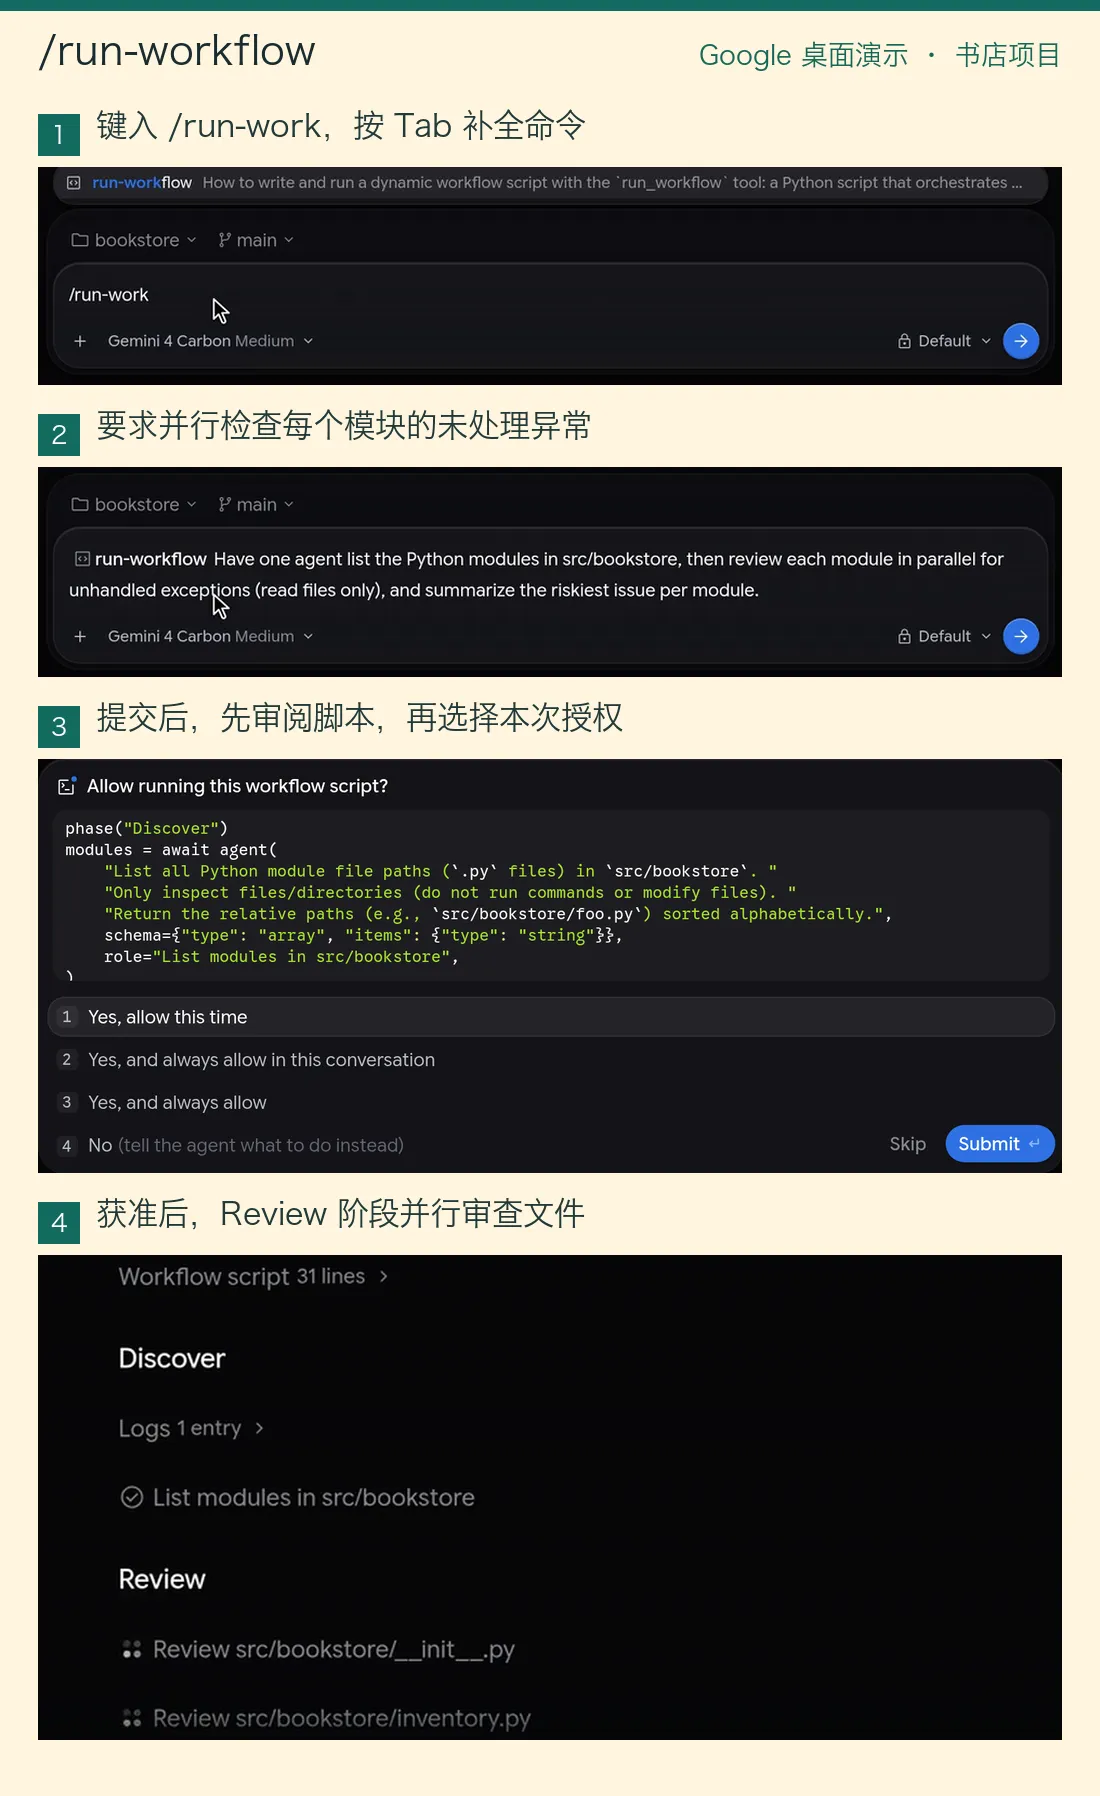
下面这段脚本,展示了 /run-workflow 底层常用的四个编排指令(phase、agent、parallel 与有状态的多轮调用):
phase("Review")
reviewer = agent("审查指定源码的并发与资源泄露问题。", role="Reviewer")
bugs = await reviewer(
    "列出核心目录下的高危 Bug,仅返回问题列表。",
    schema={"type": "array", "items": {"type": "string"}},
)

phase("Fix and Verify")
fixes = await parallel(
    bugs,
    lambda b: agent(f"修复问题:{b}", schema={"type": "string"}, model="flash"),
)
passed = await reviewer(f"已完成修复:{fixes}。请逐条核对是否全部解决。", schema={"type": "boolean"})
del reviewer
第一,返回结果必须符合 JSON Schema。脚本拉起的每个 Agent 都在隔离的会话里运行,结束后必须调用内置的 finish 工具提交结果,Harness 会按约定好的 JSON Schema 做校验,格式不对或者没有调用 finish 都会报错中止。脚本拿到的返回值已经是解析好的数组、布尔值或字典,不用再写容易出错的正则去从自然语言里提取结果。
第二,可以复用有状态的 Agent,失败时也能快速停下。用 await agent(...) 拉起的是单次会话;像上面这样先把审查员赋给 reviewer 变量再分轮调用,同一个审查员就能在多轮之间保留上下文,第一轮列问题,中间并发修复,最后再由它逐条复核。互不依赖的任务交给 parallel() 并发执行,有前后依赖的交给 pipeline() 串行推进;parallel() 采用快速失败机制,只要有一个分支失败,其余正在跑的分支会立刻取消,不会继续浪费额度。
第三,可以分层控制成本,脚本也能直接调用工具。循环里的高频扫描可以把 model 参数指定成 flash 或 flash_lite,复杂的汇总再交给主模型,并行改代码时同样支持用 workspace="share" 或 branch 做隔离。如果某个步骤只需要读文件或执行确定的命令,脚本还能用 call_tool() 直接调用工具,不消耗模型的推理轮次;遇到权限拦截时会抛出带 .denied 标记的异常,方便脚本按需跳过。
第四,可以回看历史步骤,脚本也能保存复用。内置的 trajectory() 能读取当前会话在启动工作流之前的历史步骤,比如把前面失败的 run_command 报错提取出来交给排查 Agent,不必重跑耗时的构建。写顺手的编排脚本还可以搭配 workflow.json 保存下来,通过 Args 做参数校验,反复复用。
到这里,/run-workflow 和 /swarm 的边界也就清楚了。执行路径确定、需要按文件列表批量分发并严格校验汇总结构的任务,交给 /run-workflow;任务边界还没定下来、需要多个角色边写边对接口并反复返工验收的工程任务,交给 /swarm。
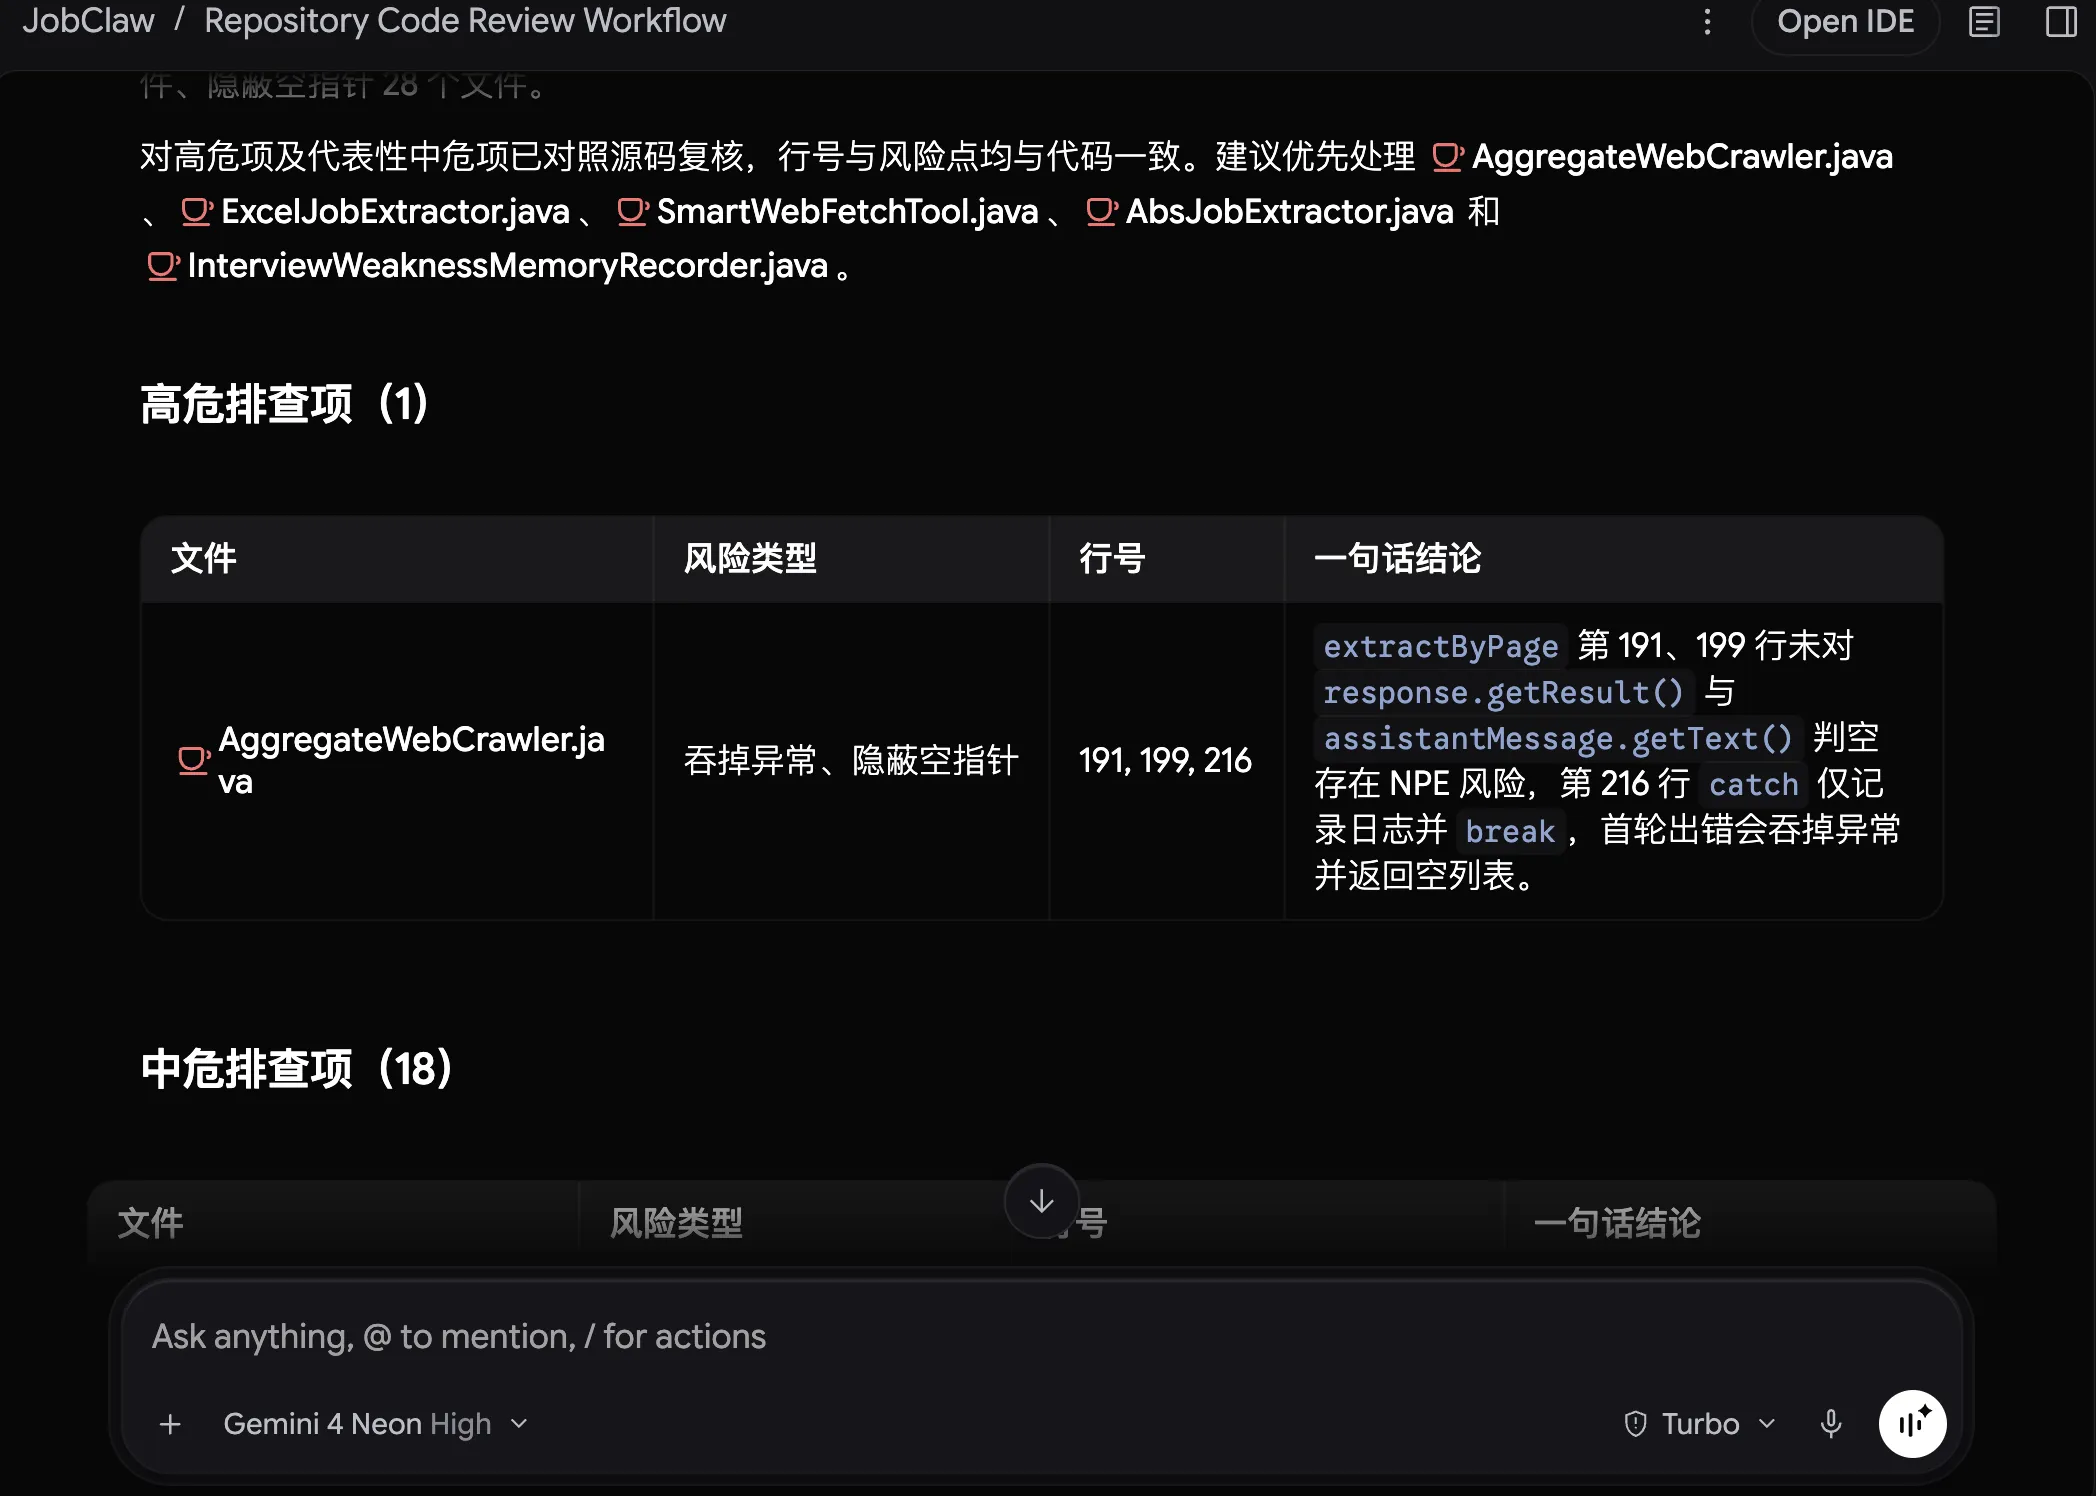
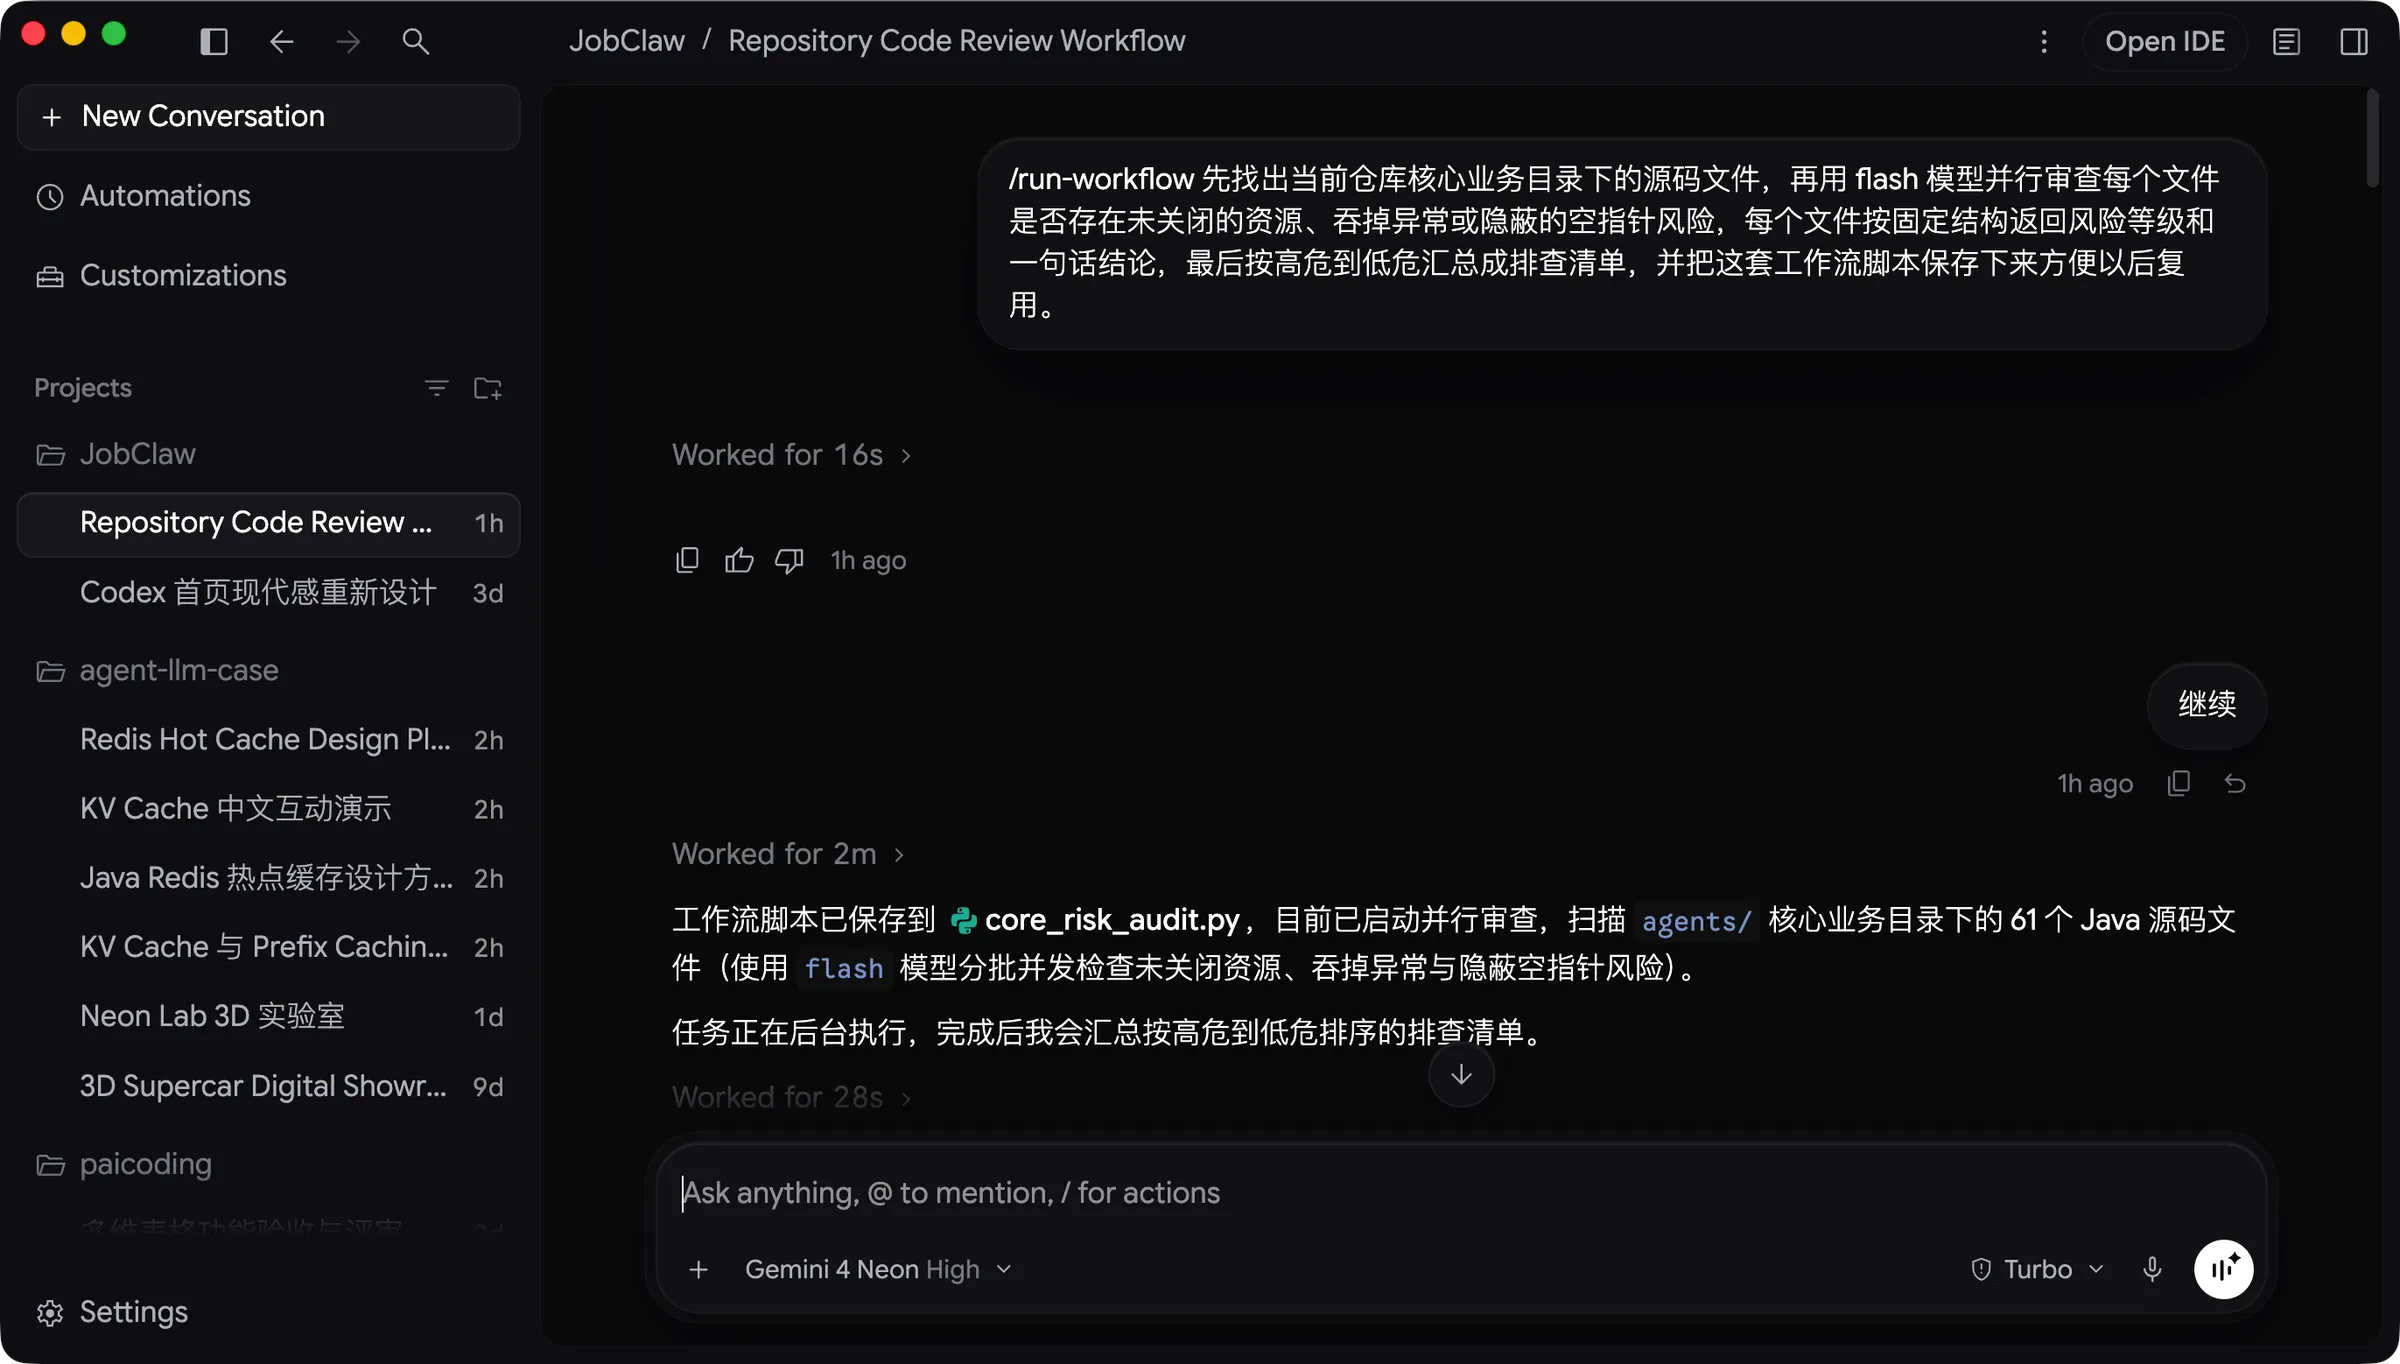
挑一个你正在维护的代码仓库,把下面这条指令复制进 agy 跑一遍。
/run-workflow 先找出当前仓库核心业务目录下的源码文件,再用 flash 模型并行审查每个文件是否存在未关闭的资源、吞掉异常或隐蔽的空指针风险,每个文件按固定结构返回风险等级和一句话结论,最后按高危到低危汇总成排查清单,并把这套工作流脚本保存下来方便以后复用。
04、btw
长任务跑到一半,顺手在主对话里插一句,问某个配置怎么写、或者某个函数在哪里调用,往往会带来两个副作用,既打断了主任务的执行节奏,又把一次性的排查过程永久写进了主对话的历史里,不仅增加了后续每轮的输入 Token,还会分散模型的注意力。
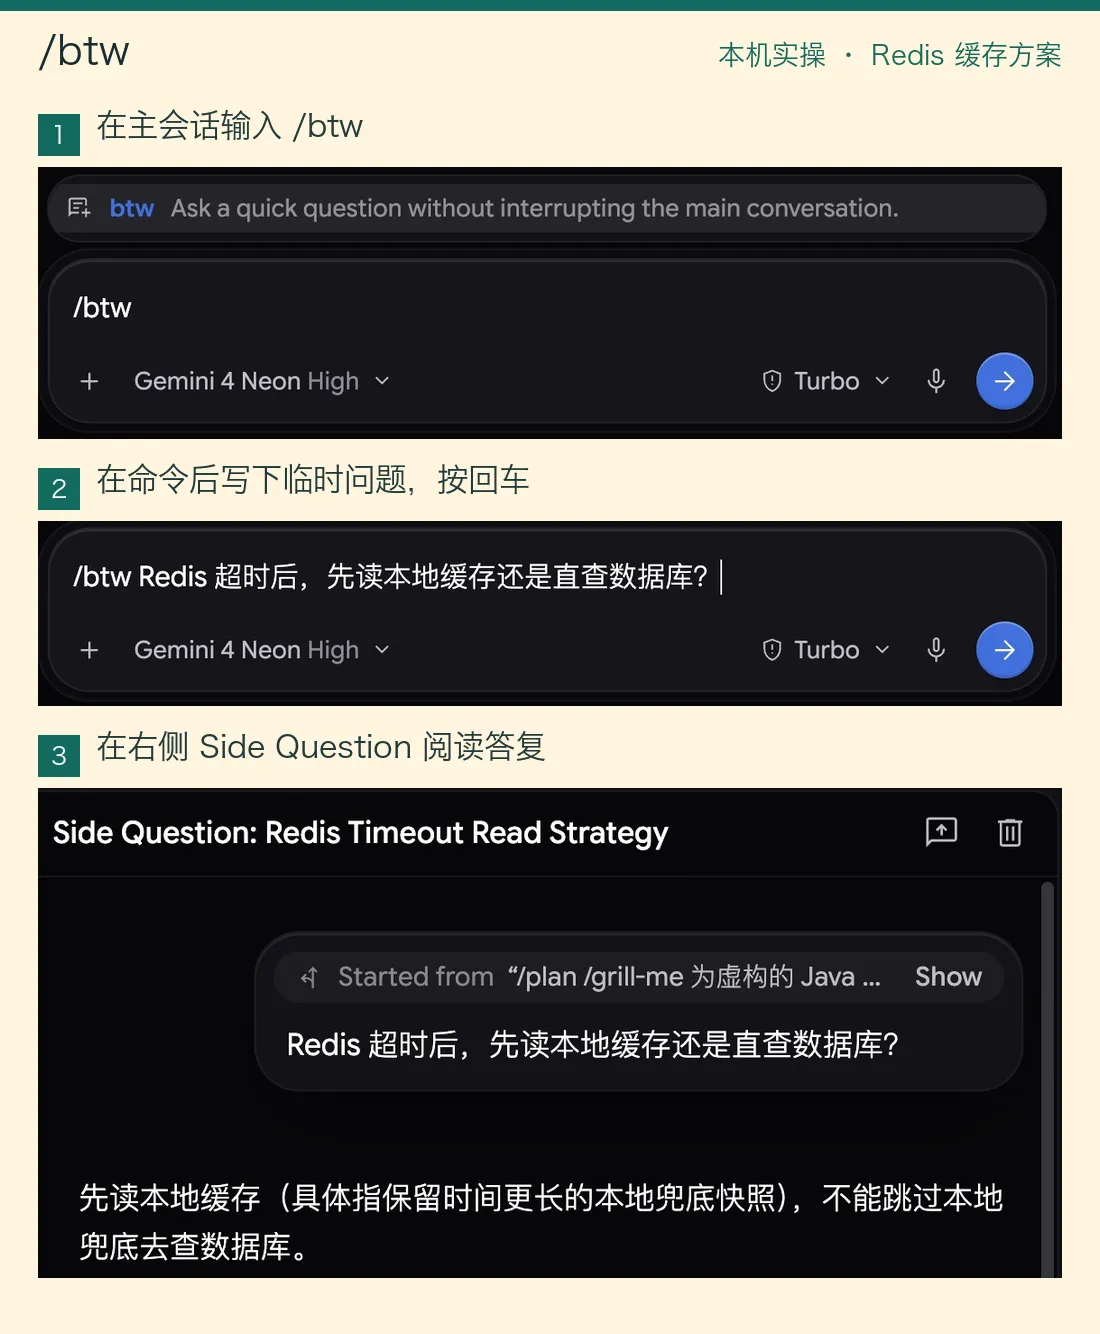
agy 里的 /btw 就是专门用来解决上下文污染的旁路机制。和 Claude Code 的 /btw 一样,敲下命令后主任务照常运行,右侧边栏会弹出一个独立的 Side Question 标签页。
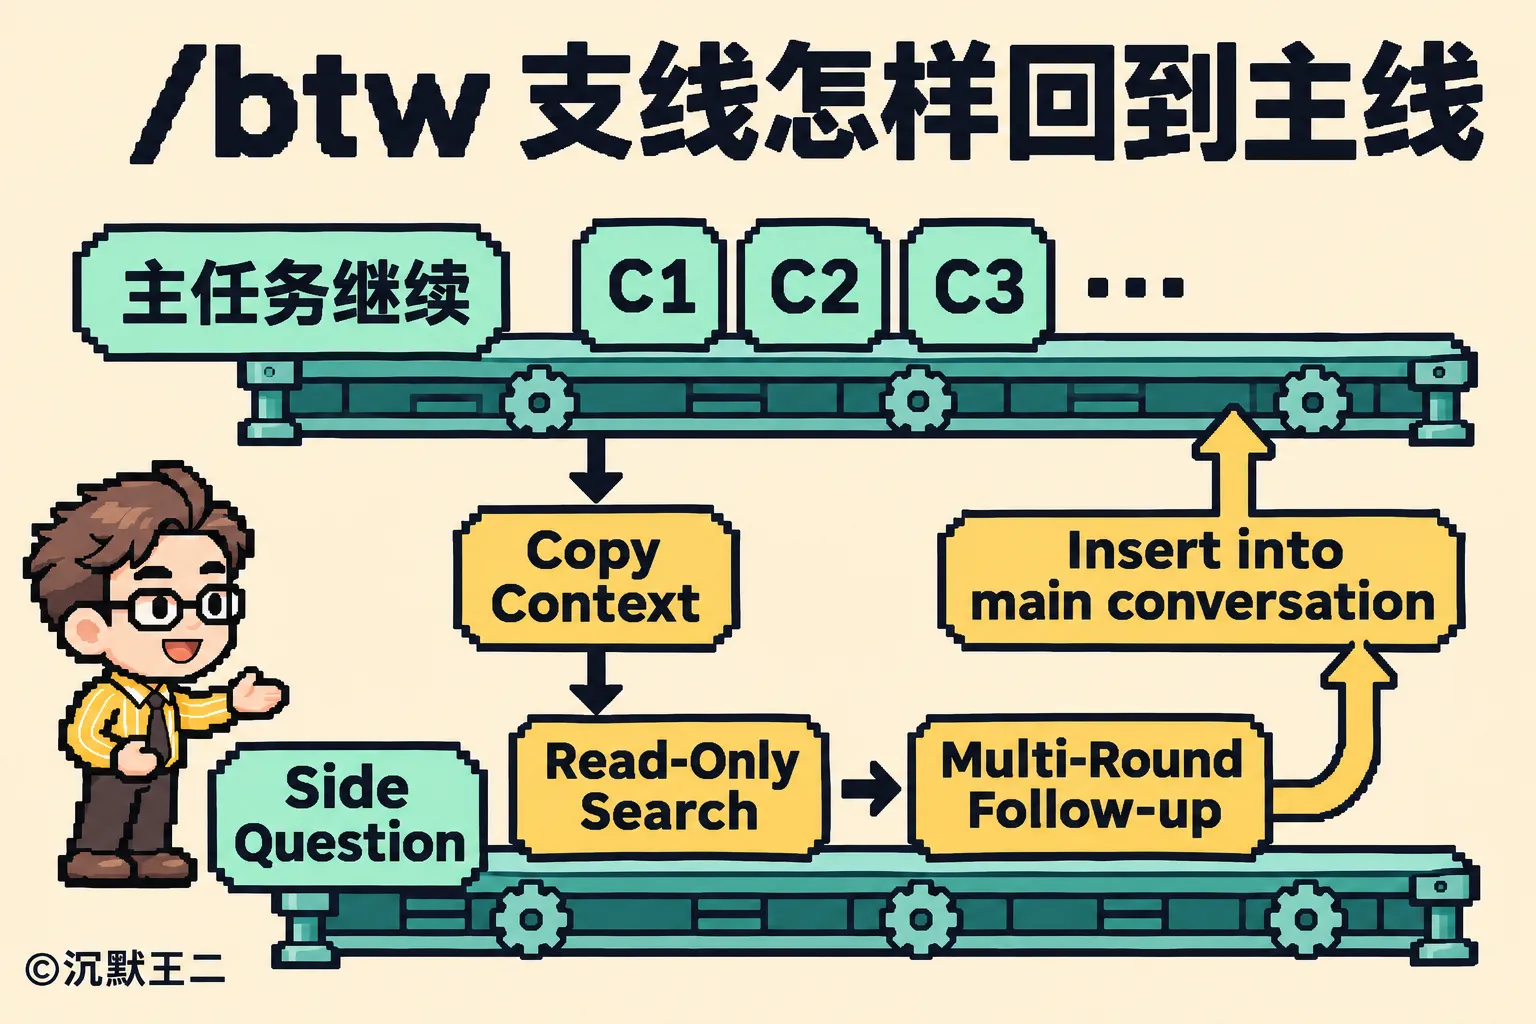
支线会自动带上主对话到目前为止的上下文快照,并且开放只读的工具权限,可以自己去读文件、搜代码、跑只读命令来核实答案,默认不改任何工作区文件,同时还支持为旁路问答单独指定模型。
用鼠标选中主对话里的任意一段文字,点弹出来的 Ask /btw,也能把选中的内容带进支线继续追问。
查完之后有三种处理方式。结论对主任务有用,就点一下 Insert into main conversation,只把提炼后的结果插回主线,排查过程留在旁路不带回去;如果查着查着冒出一个独立的新需求,就点 Promote to Conversation 升级成正式会话;如果只是临时确认一下、用不上,直接关掉就行,主会话的上下文不受任何影响。
05、grill-me
复杂需求之所以容易返工,往往是因为提示词里漏掉了一些隐含的假设。
agy 里的 /grill-me 把平时“你写一长串提示词交代需求”的顺序反了过来,让 Gemini 4 Neon 扮演一个较真的技术评审,反过来向你提问。
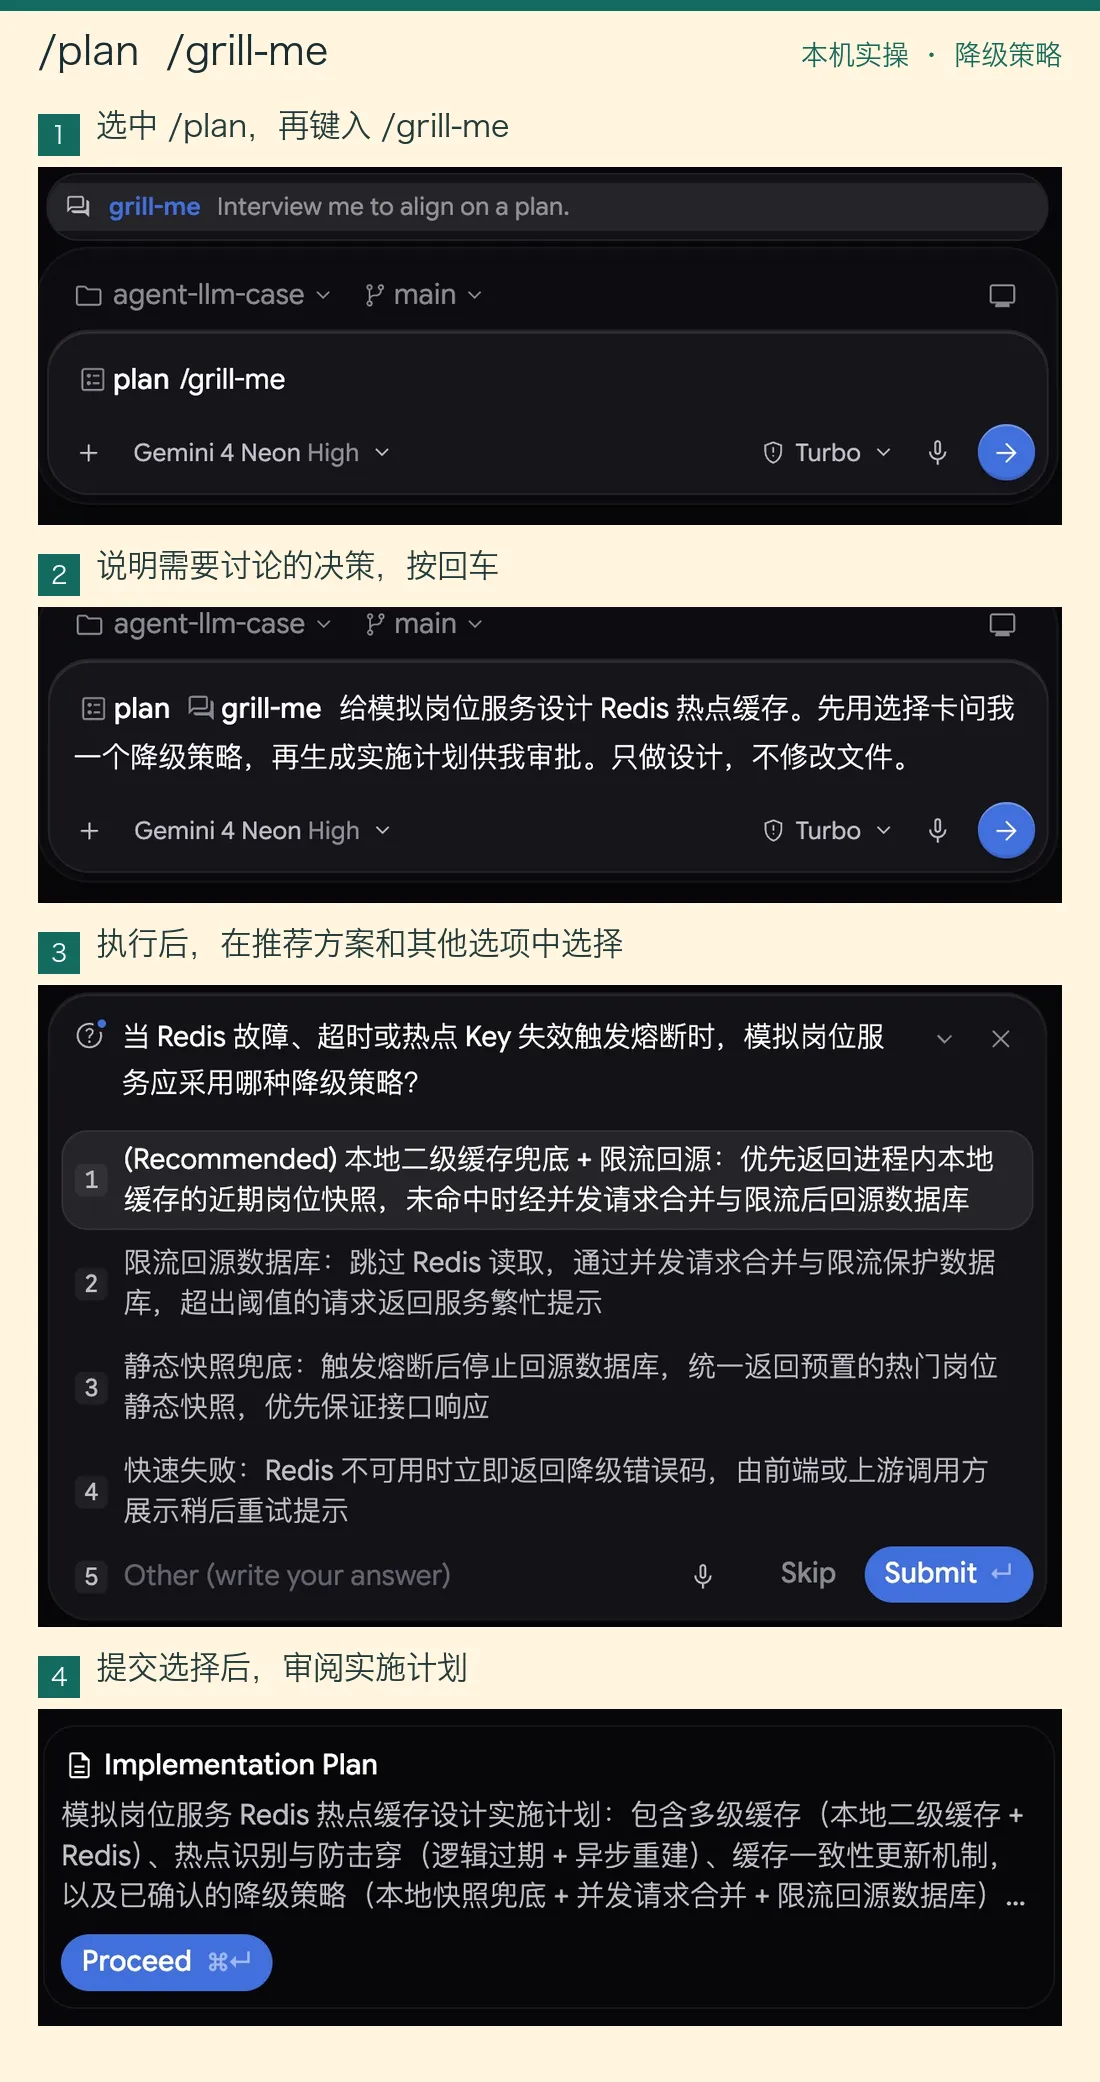
它的工作分前后两段。
敲下 /grill-me 后,Neon 会先自己去翻你的代码库,项目用的什么框架、配置写在哪、路由是怎么组织的,凡是能从代码里查出来的事实,它都不会来问你。
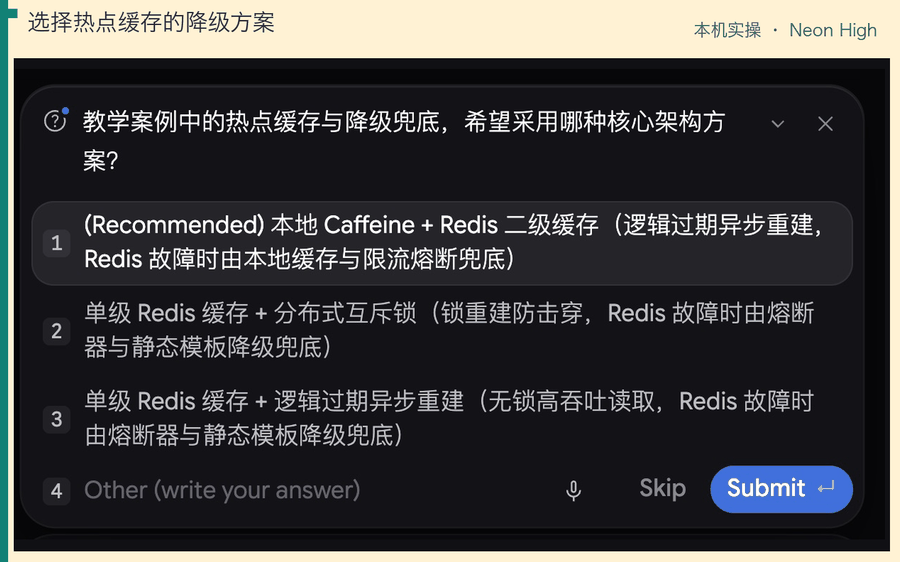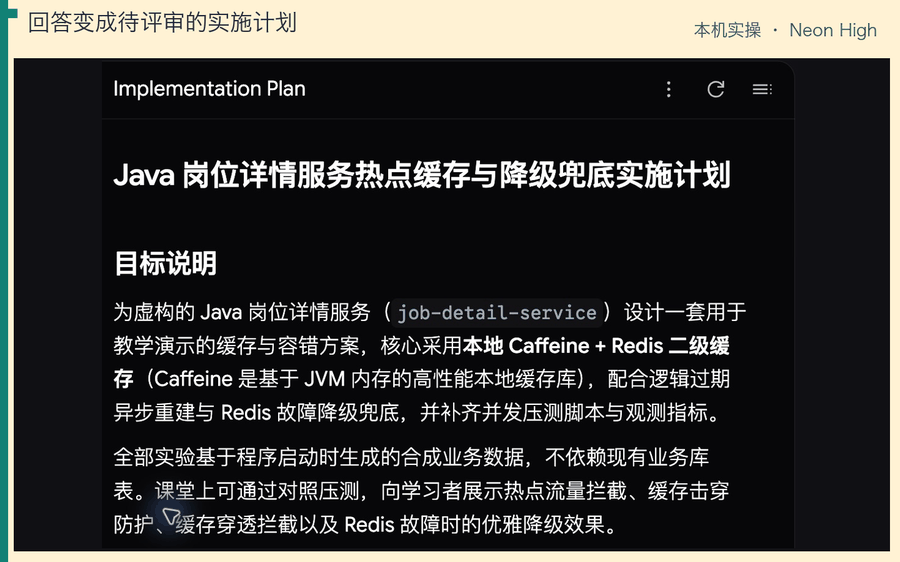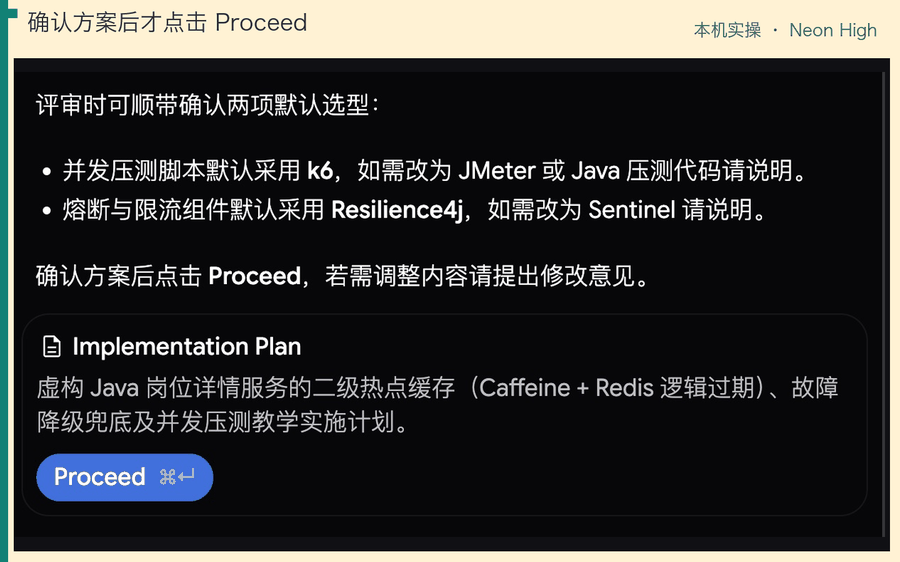
摸清现状之后,它才会把只看代码定不下来的关键分歧逐个抛给你,每次一题并给出推荐选项,比如缓存击穿用互斥锁还是逻辑过期,Redis 挂了之后走本地兜底还是直接放行,或者数据迁移失败了怎么回滚。经过这一轮追问,所有模棱两可的设计决策都会在改第一行代码之前确定下来。
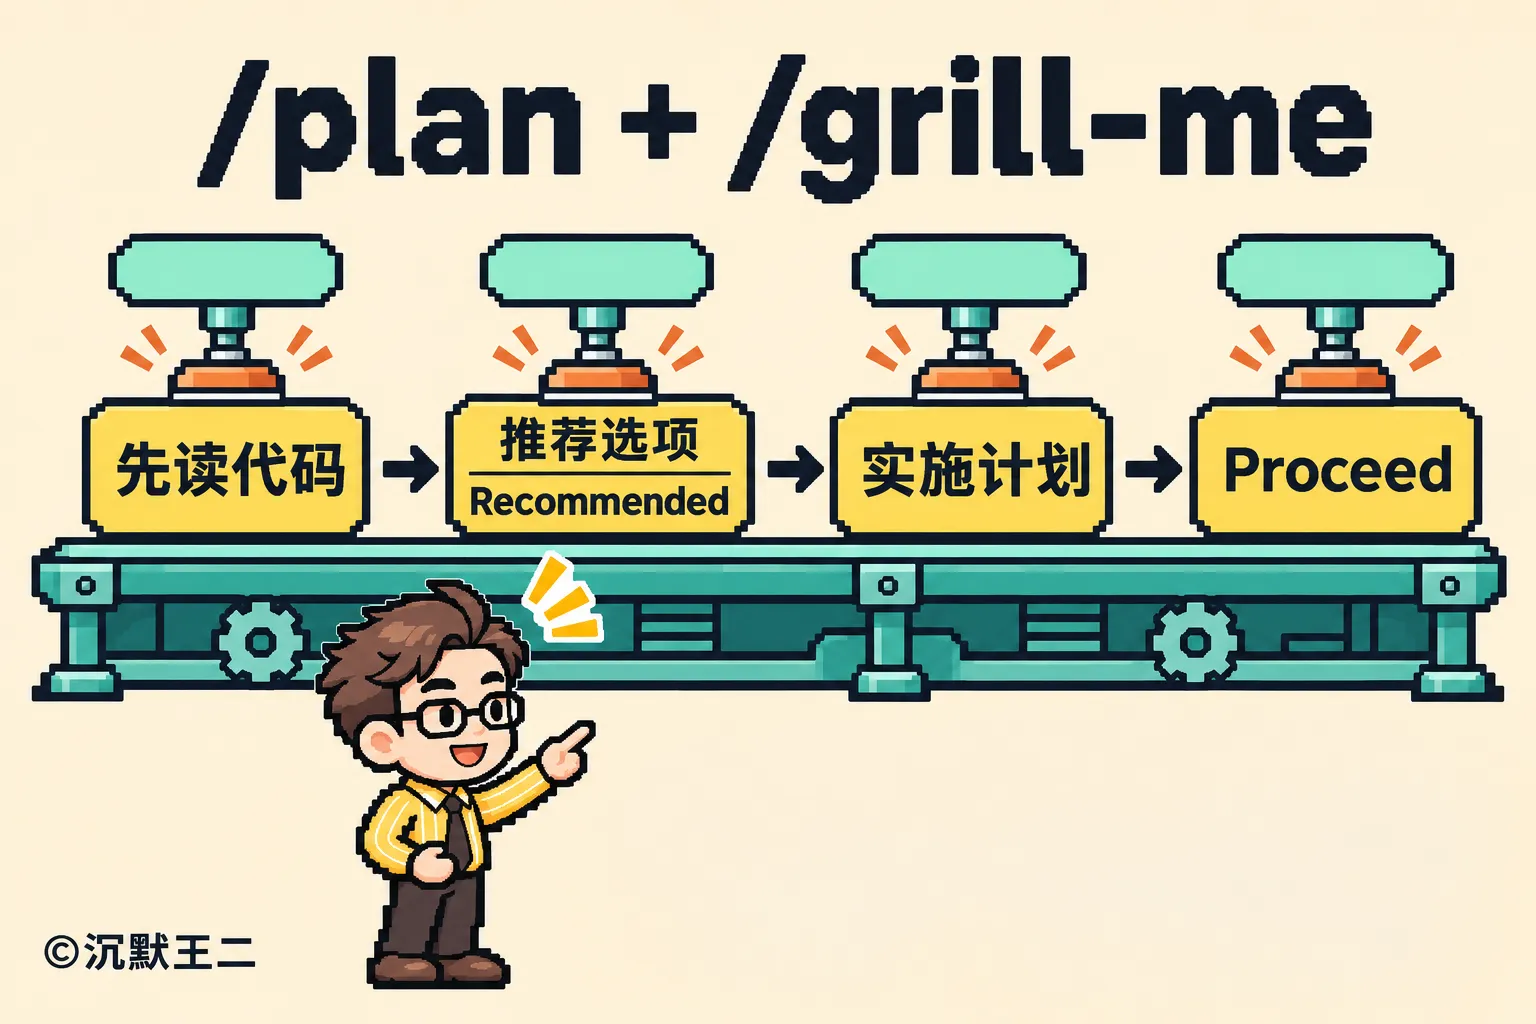
我平时更习惯把 /plan 和 /grill-me 放在一起用。
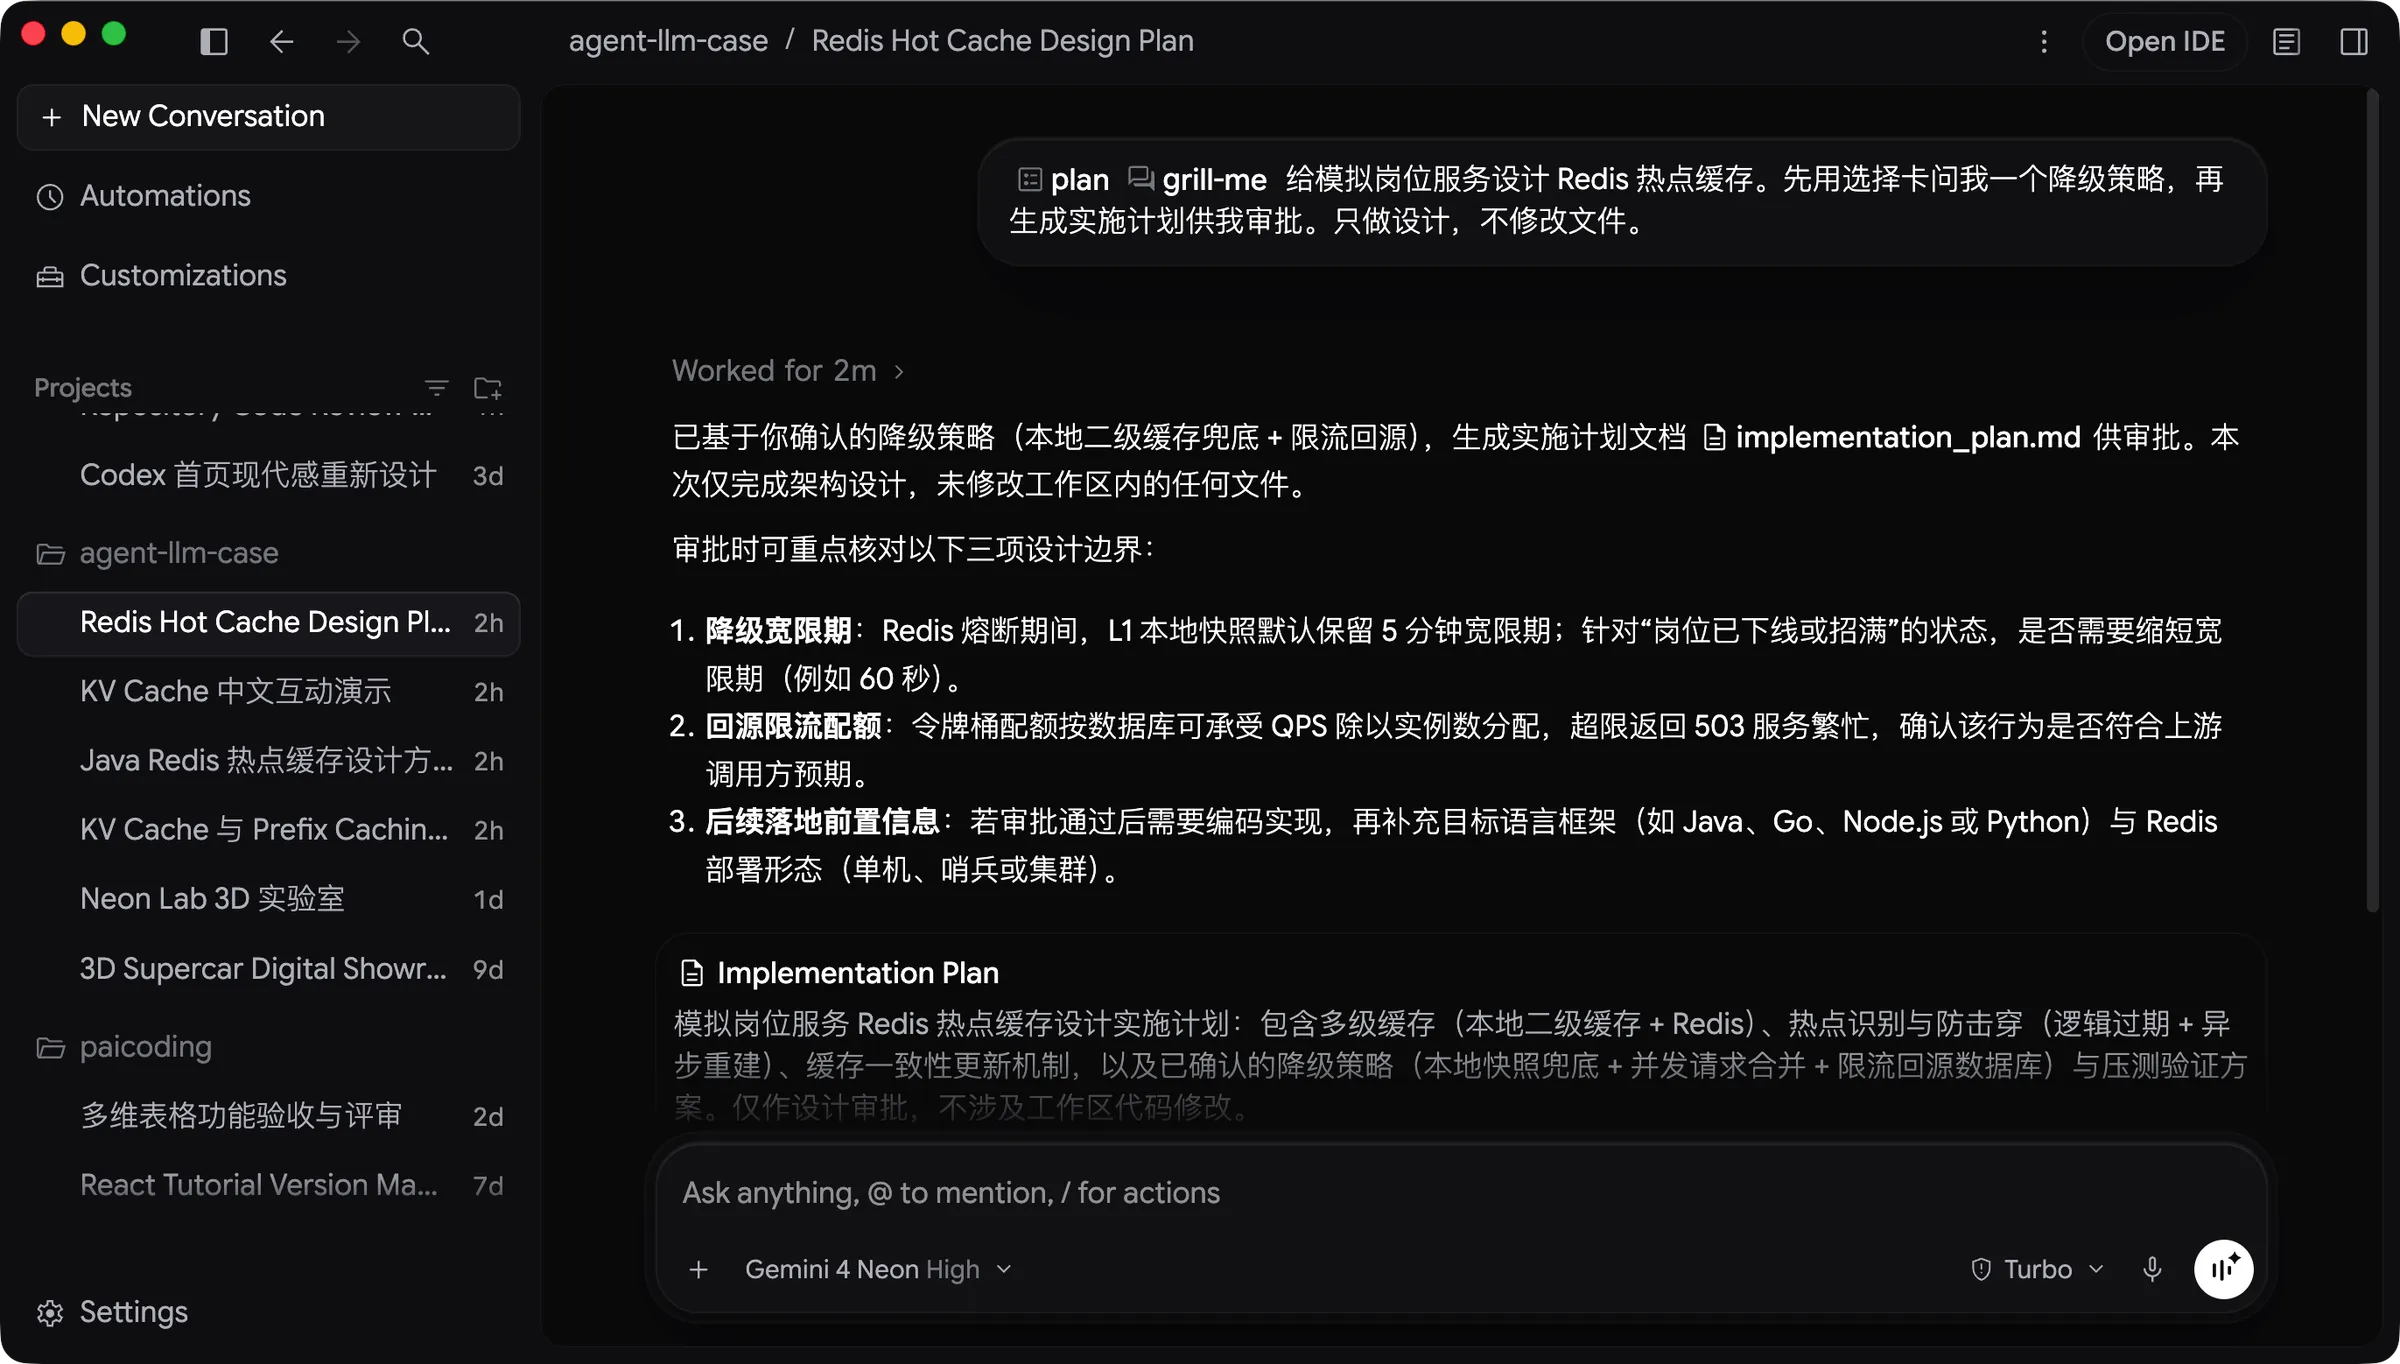
等所有的关键分歧都确定了,Neon 会结合你选好的答案输出一份完整的实施计划,审完点 Proceed,再正式让它改代码。
打开你手头任意一个项目,把下面这条指令发给 Neon,感受一下被 AI 追问的压迫感。
/plan /grill-me 给当前项目接入一个带降级兜底的 Redis 热点缓存层,防止缓存击穿和雪崩,并补齐并发压测。
06、generative_ui
纯文本和静态的 Mermaid 图,很难把状态流转、缓存淘汰或者并发调度讲清楚,在 agy 里敲 /generative_ui,体验会很不一样。
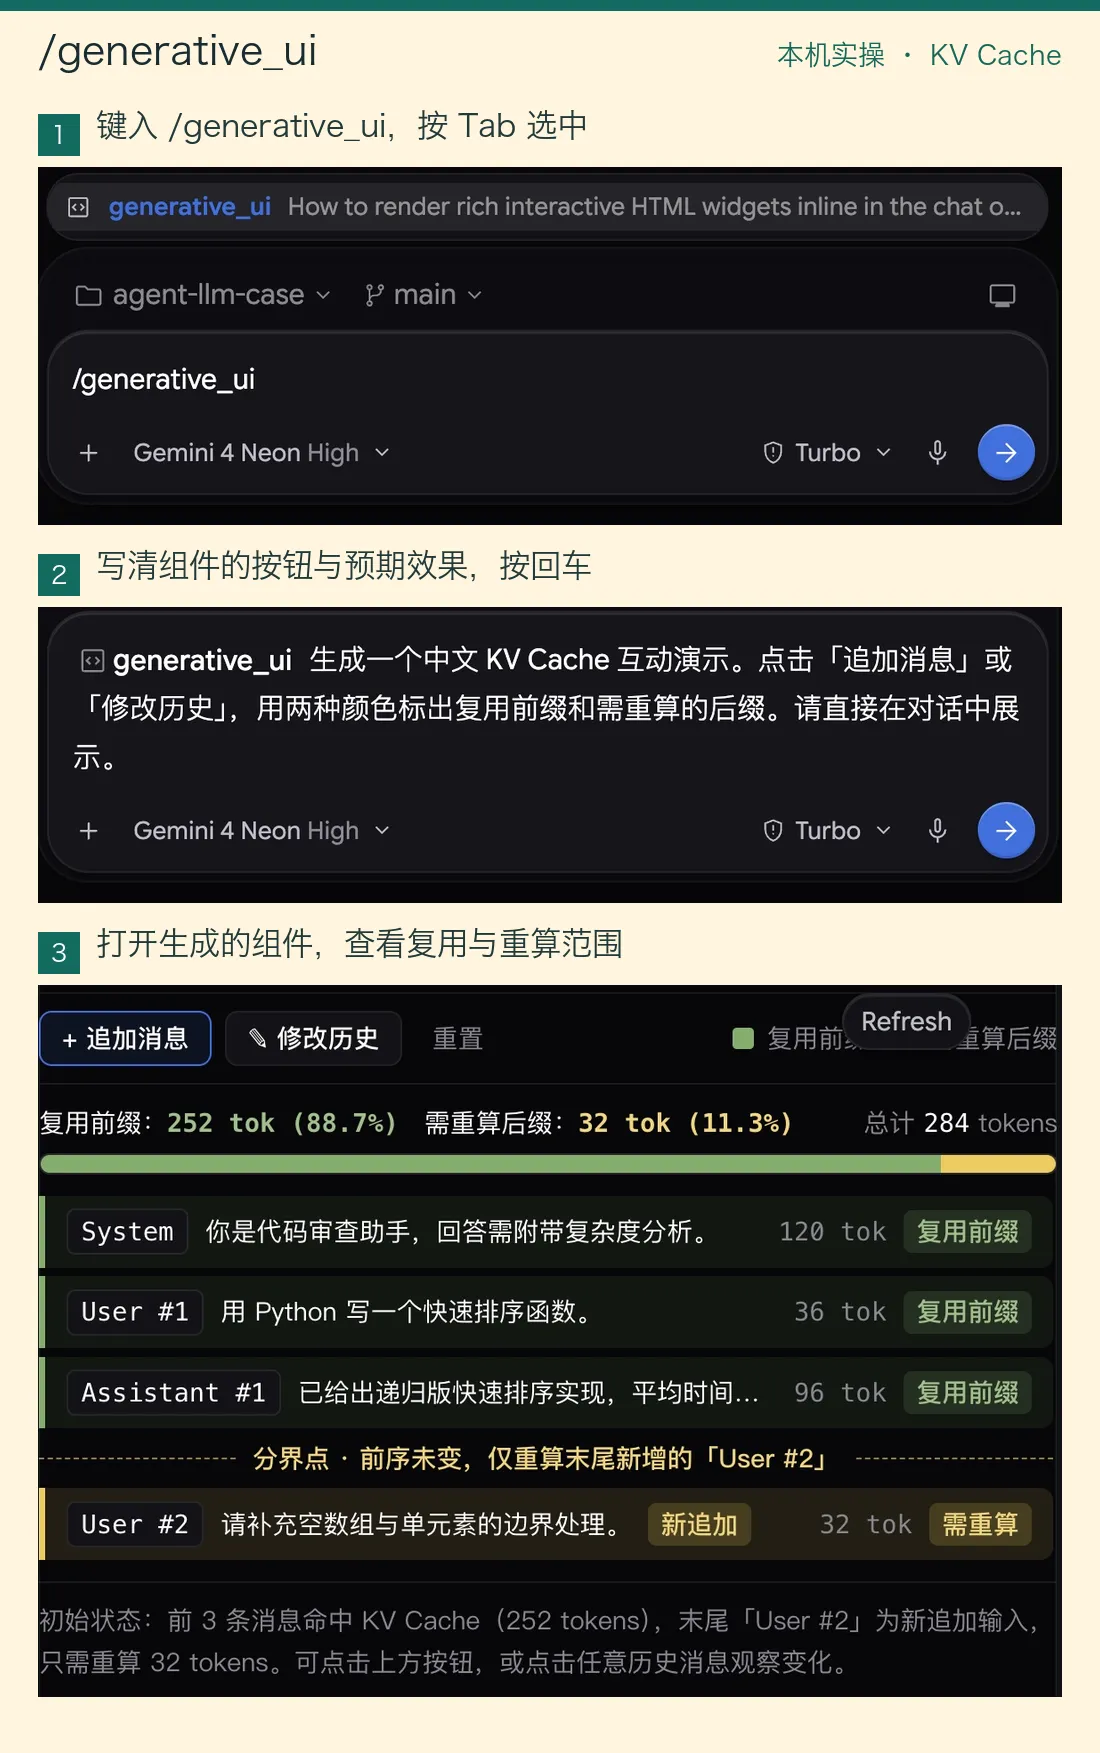
Gemini 4 Neon 会生成一个单文件、自包含的 HTML 互动组件,运行在受限的沙箱 iframe 里。内容安全策略(CSP)会拦截外部 CDN 脚本(只放行内置白名单里的样式和脚本),避免组件因为外部资源失效而跑不起来;宿主容器会自动注入一套语义化的主题 CSS 变量,并监听主题切换事件,所以切换亮暗模式时,组件的配色会自动和 agy 当前的界面保持一致。
显示位置也有明确的规则。
高度在 450px 以内的流程图和状态图会直接嵌在对话气泡里,超过这个高度的复杂仪表盘、多标签面板和交互原型会在右侧边栏全屏展开,不会在对话气泡里挤出滚动条。里面的按钮、开关和滑块全部靠内联的 JavaScript 在沙箱内部运行,怎么点都不会给模型发新消息,不消耗额外的 Token。遇到满意的,点右上角菜单里的 Export Artifact 就能导出成独立的 HTML 文件,拿去写技术文档或者做分享 PPT 都很方便。
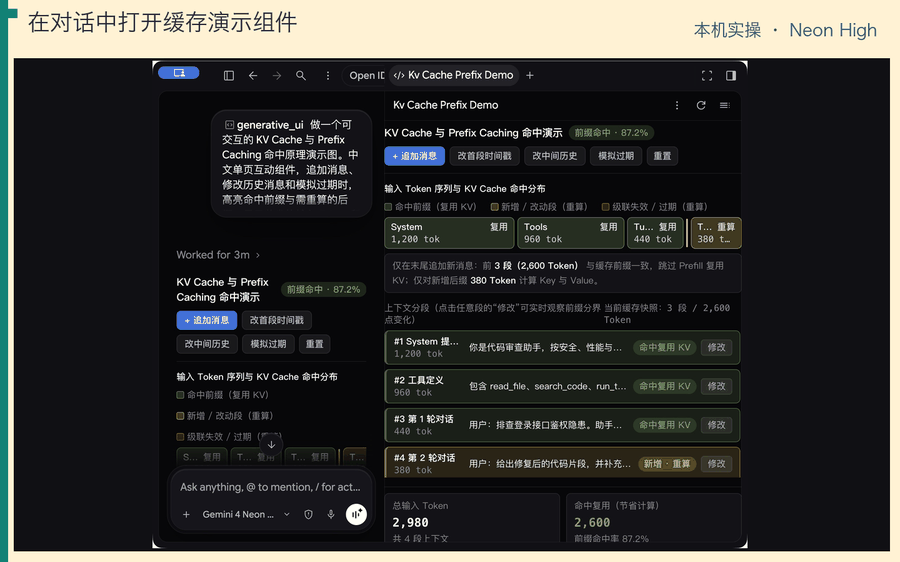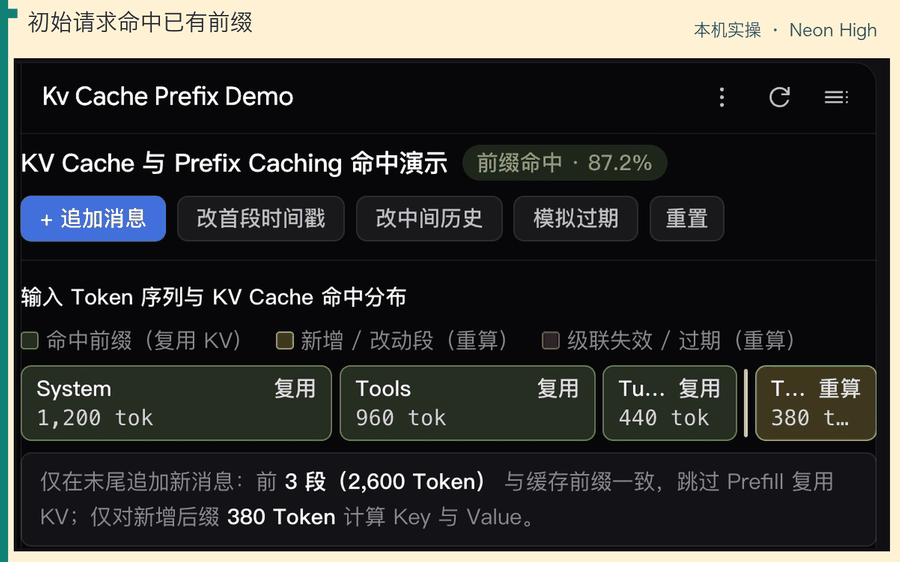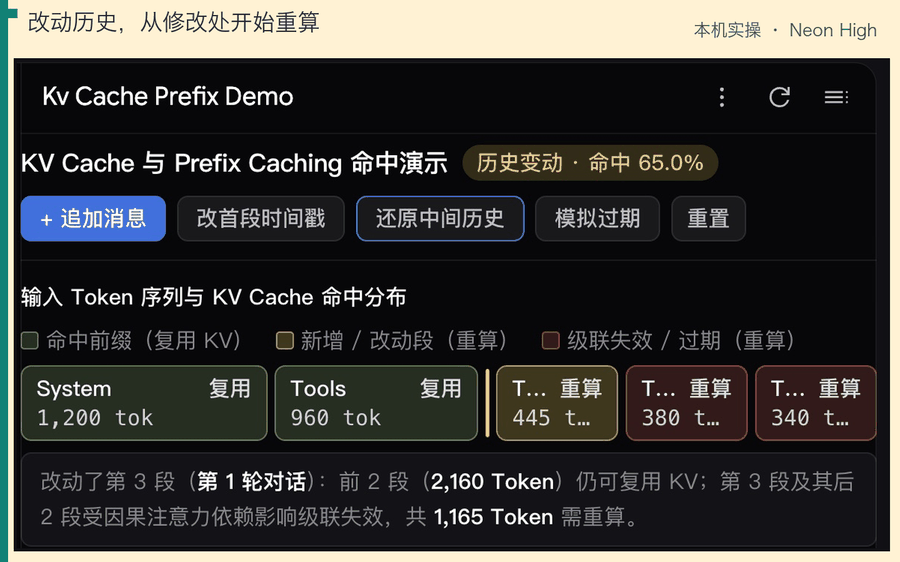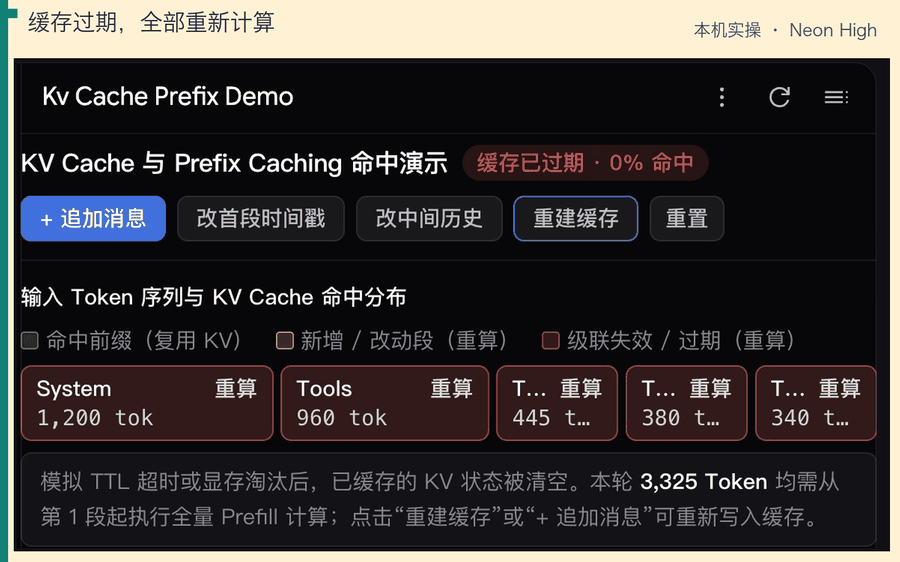
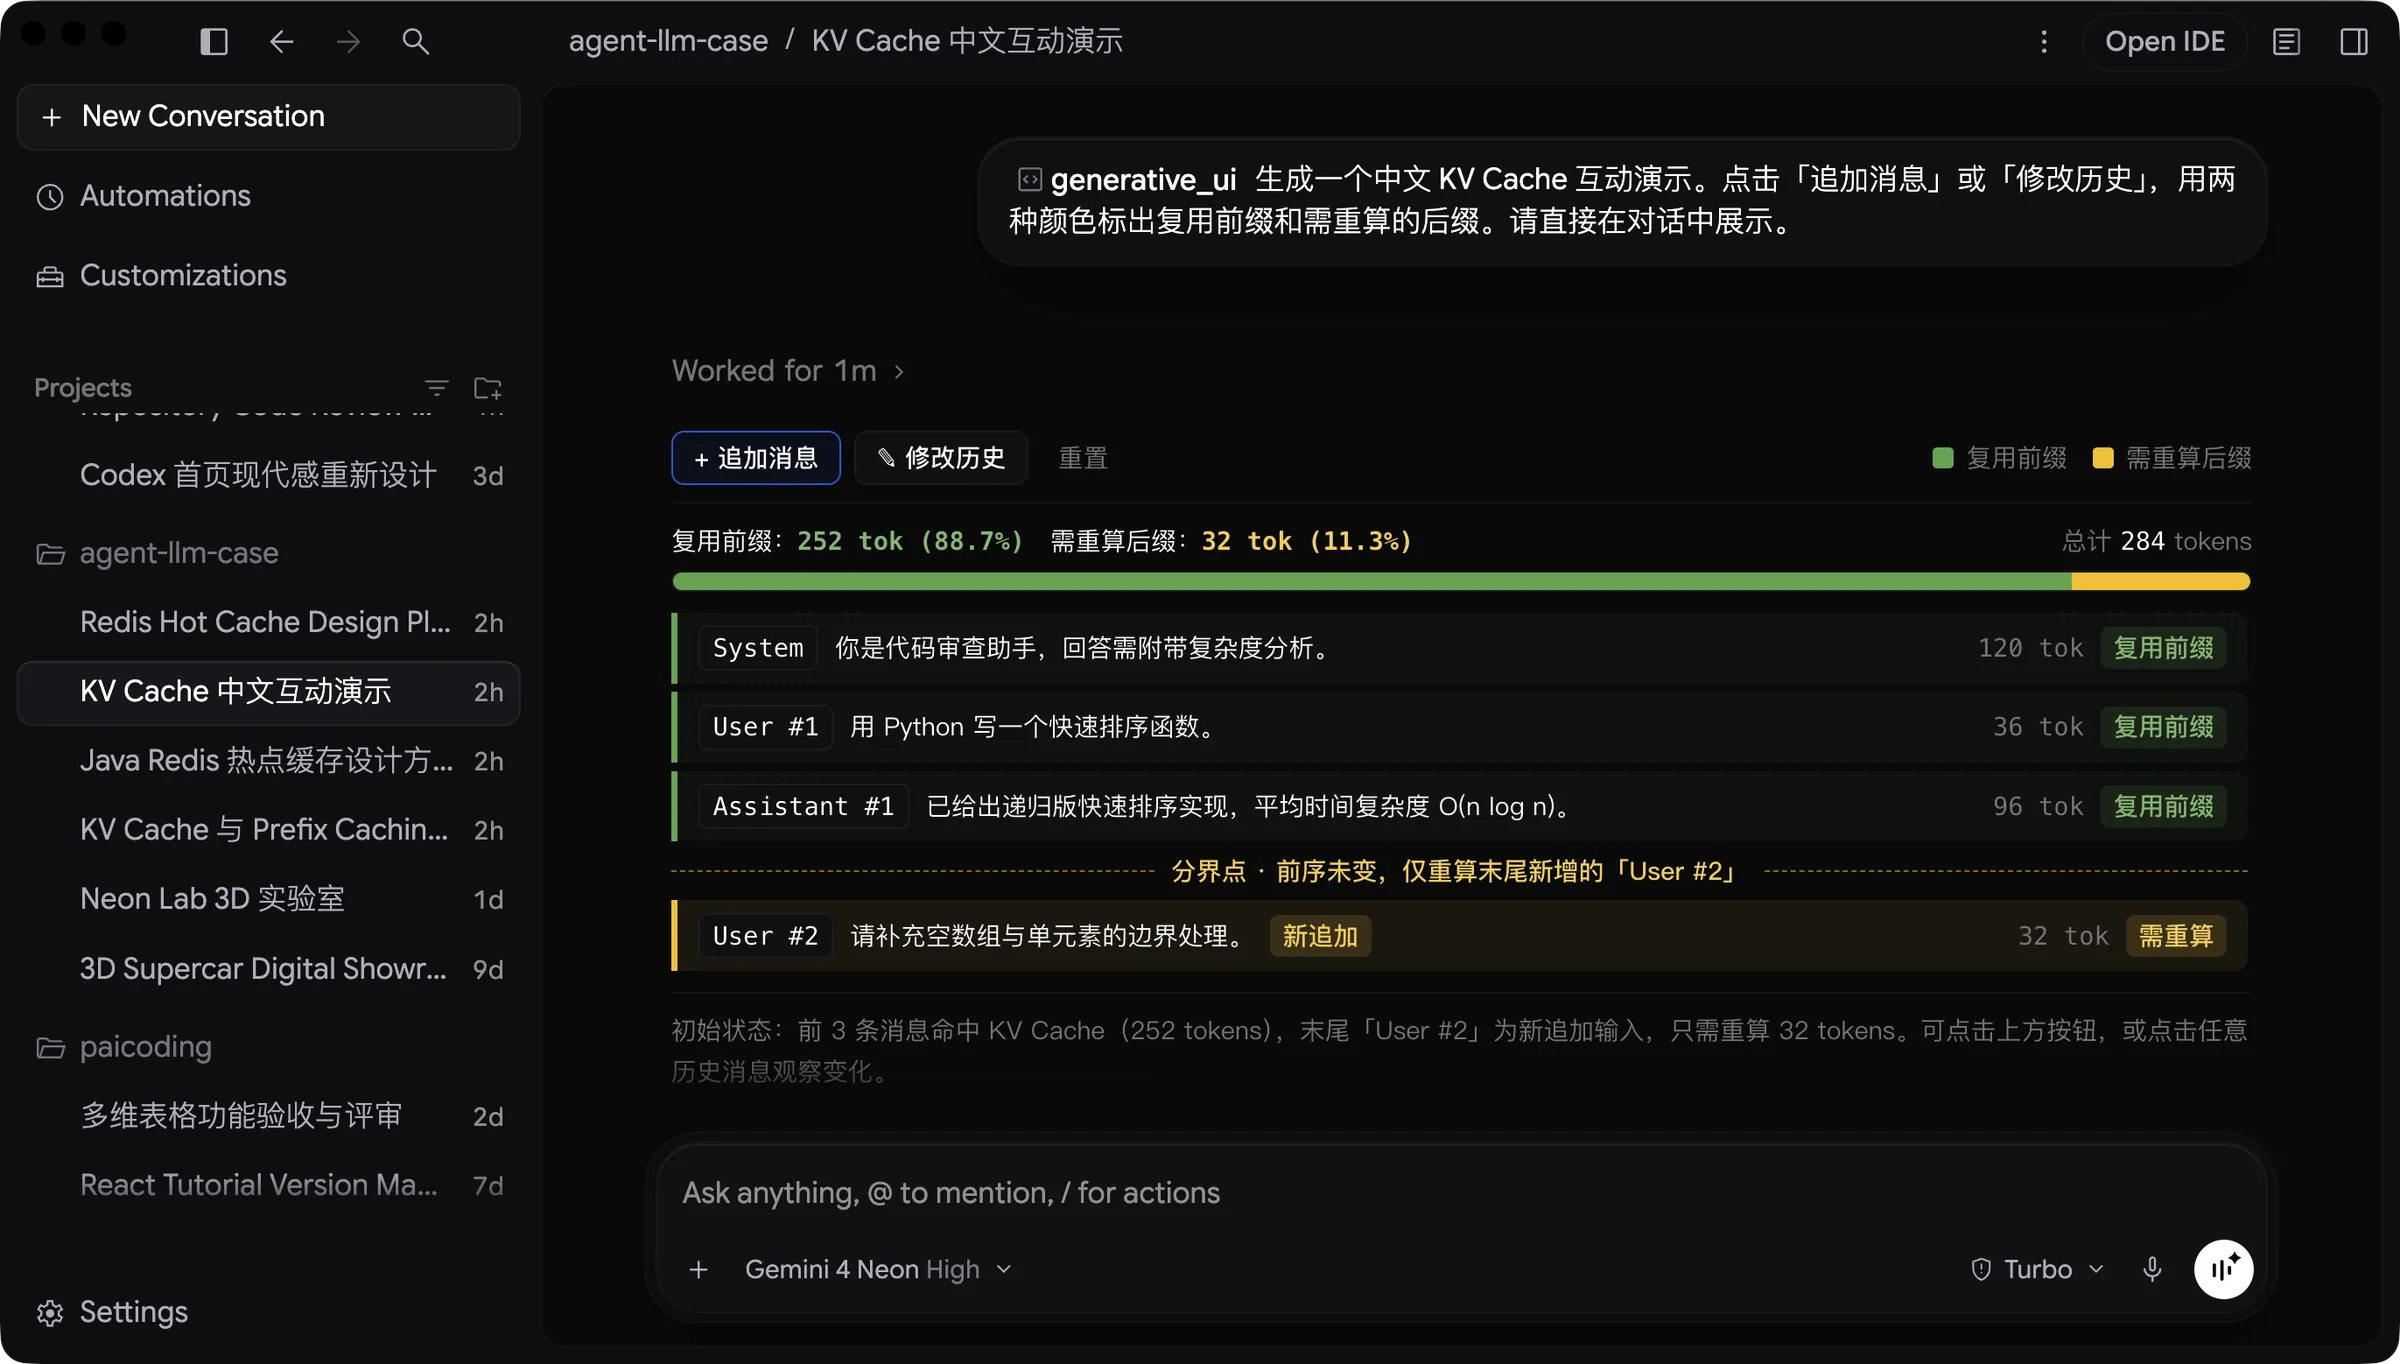
拿上下文的缓存机制来试一把。把下面这条指令复制进 agy。
/generative_ui 做一个可交互的 KV Cache 与 Prefix Caching 命中原理演示图,做成单页互动组件:左侧可以模拟多轮对话追加消息、修改历史某一条消息、或手动触发缓存过期,右侧实时高亮展示哪些前缀命中缓存、从哪一条开始断开重算,并同步算出每次请求省了多少输入 Token 和费用。
07、把这些命令用起来
前面六个功能单独拿出来都挺好用,但如果按工程阶段把它们串在一起,再加上 /boost 和 /learn,Antigravity 这套 Harness 的效果才能真正拉满。
需求还没定下来时,先用 /plan /grill-me 让 Neon 摸清代码库的现状,把所有架构分歧逐个敲定,拿到一份审阅通过的实施计划后再动第一行代码。
进入执行阶段后,按任务的特点选对应的命令。多模块并行开发加独立验收的交给 /swarm,步骤固定、要按文件清单批量分发并校验返回结构的交给 /run-workflow;需要用到远端 Linux 算力机、Docker 集群或线上日志的任务,就通过原生 SSH 窗口把整套流程放到宿主机上跑。如果中间碰上深层的并发竞态、复杂的算法优化,或者反复定位不出来的疑难 Bug,付费档位下还可以加一条 /boost,启动多视角的深度推理和交叉验证。
任务推进过程中需要临时查配置、看调用关系,全都交给 /btw 在只读旁路里核实,只把有用的结论插回主线,保持主会话的上下文干净。碰到状态流转、缓存命中或压测数据需要直观地核对,顺手用 /generative_ui 生成一个沙箱互动面板。
等到一次复杂的环境配置跑通了,或者刚纠正完 Agent 的某个编码习惯,记得顺手敲一条 /learn,把这些项目约束和个人偏好保存下来,下次开新会话时 Agent 会自动遵守,不用每次都从头交代。
ending
都说谷歌的 Harness 难用,我想最主要的原因还是他们的模型本身就不是顶级。
随着 Gemini 4 Neon 的出现,再加上这套从规划、编排到隔离验收都补齐了的工程化能力,这种情况正在改善。
强烈建议大家手里都准备一个,没必要非要用之一嘛。
我们下期见。
回复