
用 LangGraph4j 编排多 Agent 工作流
Spring AI 的 ChatClient 解决的是“一问一答”的问题。
发 Prompt,走调用链,返回结果。
但求职派的岗位数据采集需要把四个步骤串成一条流水线,先判断输入类型,再调用大模型提取结构化信息,然后按业务规则清洗字段,最后发布到正式岗位库。
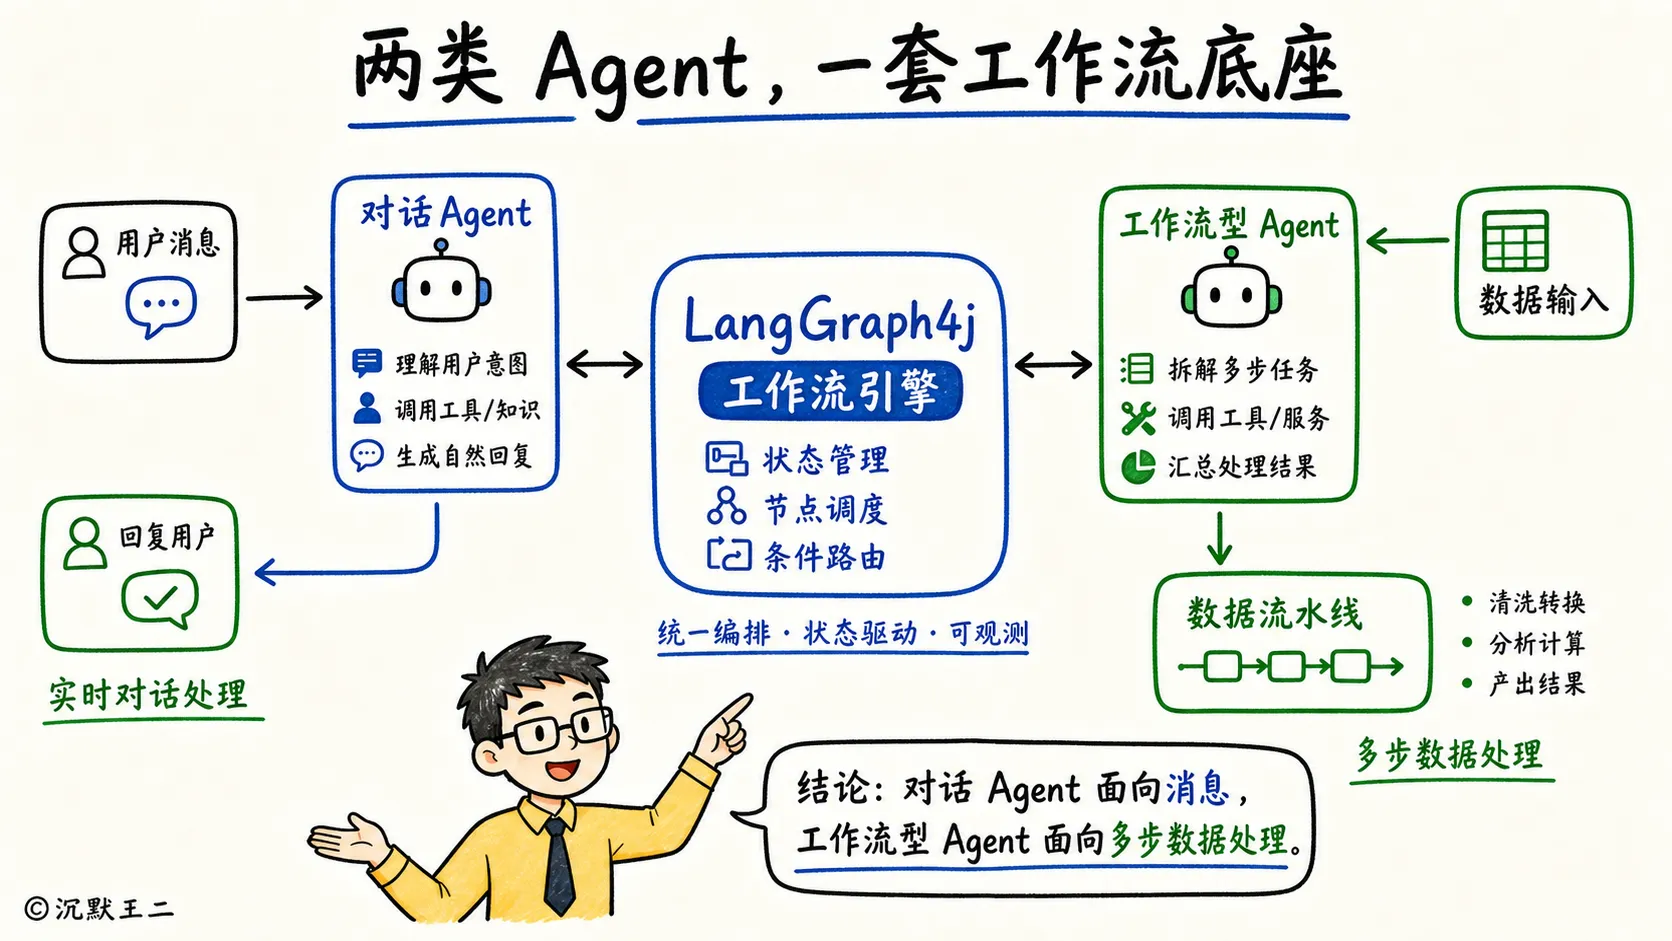
LangGraph4j 是 Java 生态下的 Agent 工作流引擎,核心思路是把多个处理节点编排成一张有向图,让数据按照条件分支流转。
求职派用它来跑岗位数据的自动采集流水线,四个节点、三个条件分支、一个共享的状态对象。
这篇内容会用求职派的生产源码给大家分析清楚——节点和条件边怎么定义、状态怎么在节点之间传递、什么时候该用工作流引擎而不是对话型 Agent。
01、ChatClient 处理不了什么场景?
ChatClient 的执行模式是线性的。Prompt 进来,经过 Advisor 链处理,调用大模型,如果模型需要调用工具就自动回调,最后返回结果。
这个模式已经足以覆盖绝大多数场景了。问答、翻译、摘要、甚至带工具调用的 ReAct 循环,都是“一进一出”的模式。
但有一类任务超出了它的能力范围。
举个例子,用户提交了一段评价文本,系统需要先判断好评还是差评。好评的话自动回复“感谢好评”;差评则要提取关键信息,转给人工客服跟进售后。
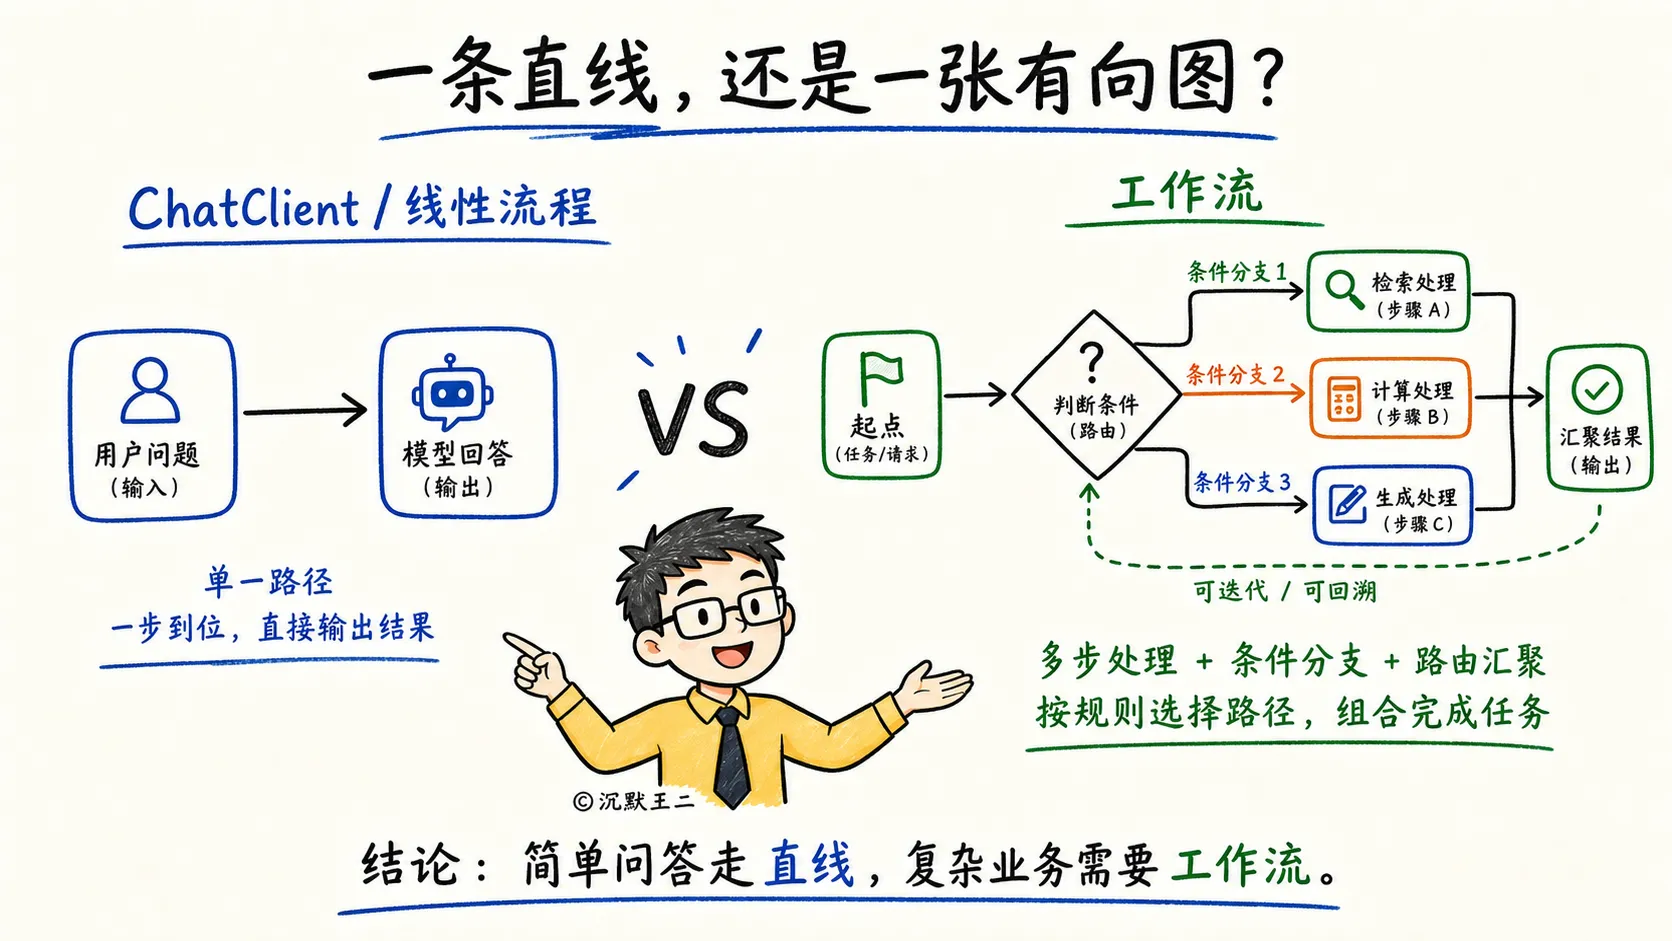
这个场景有三个特征是 ChatClient 不具备的。
- 多步骤。判断、回复、提取、转交,至少三到四步独立处理逻辑。
- 条件分支。好评和差评走的是完全不同的执行路径。
- 步骤间的状态传递。后面的步骤需要读取到前面步骤的输出结果。
把这些逻辑全塞进一个 Prompt 里让大模型自己判断,勉强也能跑。
但逻辑一旦复杂起来,你会发现自己在用 Prompt Engineering 模拟一个工作流引擎,而且每个步骤都没有办法独立测试和监控。
LangGraph4j 就是专门用来解决这类多步骤编排问题的。
02、LangGraph4j 的核心模型是什么?
LangGraph4j 是 Python 社区 LangGraph 的 Java 移植版,用“有向图”来描述工作流。
理解三个概念就能上手。
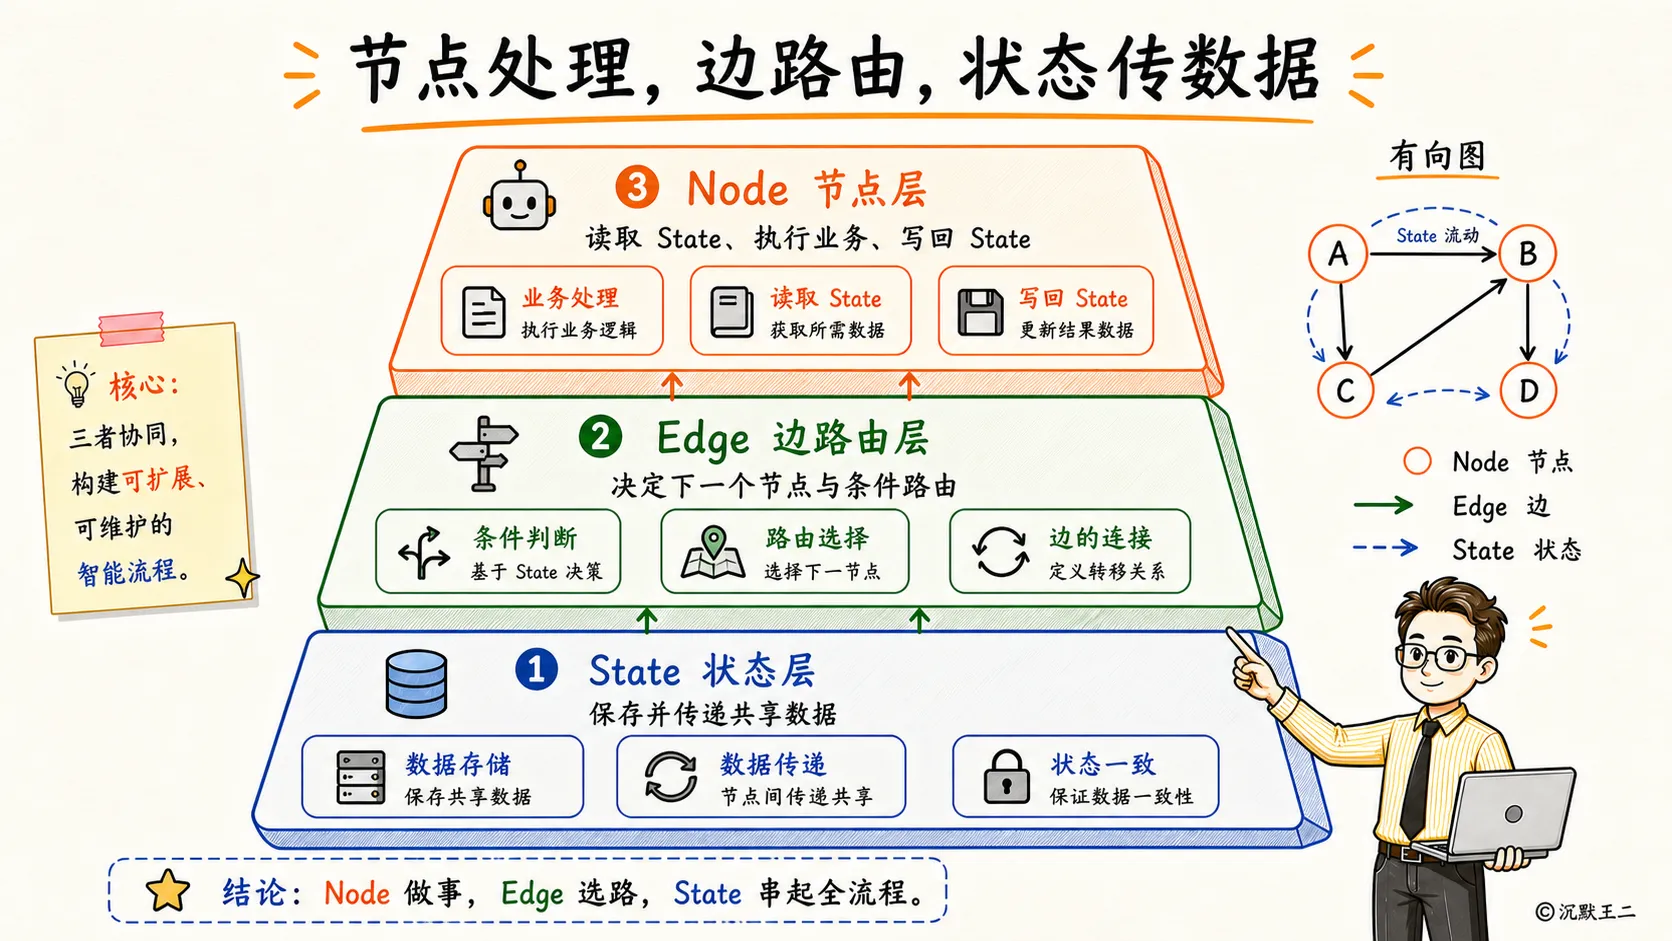
节点
图里的每一个处理步骤就是一个节点。它接收当前的状态对象,执行一段业务逻辑,返回需要更新的状态字段。
节点之间彼此独立,不会直接调用对方的方法。所有的数据传递都通过状态对象来完成。
边
边决定了节点的执行顺序,分为两种。
固定边,A 执行完之后一定走到 B,没有任何条件判断。
条件边,A 执行完之后,根据当前状态里的数据决定走 B 还是走 C,或者直接走到终点,结束。
条件边是工作流引擎和普通顺序调用的核心区别,它让流程有了“拐弯”的能力。
状态
状态是所有节点共享的数据容器。每个节点从状态里读...
企业级Agent工作流编排项目PaiFlow
Vibe Coding版本的PaiAgent
派聪明RAG AI知识库Java版本+Go版本
微服务 PmHub、技术派、MYDB
求职派JobClaw(OpenClaw/Hermes架构
PaiCLI(类似Claude Code的Agent
派简历(代码已完成)
等实战项目。
1. 微信扫右侧的优惠券加入知识星球
2. 解锁星球的实战项目教程和源码: 项目源码+教程获取
3人已点赞
回复