
大家好,我是二哥呀。
求职派在后台积累了大量的校招与实习岗位数据。如果这些数据只能通过网页或者小程序供大家检索,它的价值其实只发挥了一半。
如果我们能把这套职位库做成一个标准的 MCP 服务,让外部的 AI 助手直接按需调用,体验就会完全不同。
无论是 Claude Desktop、Cursor、Trae,还是大家自己搭建的智能体,都可以通过标准协议接入求职派,实时完成岗位筛选与智能推荐。
这篇内容将完整记录求职派首个 MCP 服务的诞生过程,带大家一步步跑通协议配置、工具定义、权限鉴权与客户端联调。
系好安全带,我们粗粗发~
01、为什么要把求职派做成一个 MCP Server?
在传统开发模式下,如果想把系统的数据能力开放给外部 AI,我们通常需要单独写一套 RESTful 接口。
客户端为了调用这套接口,既要理解参数格式,又要自己编写解析代码。一旦接口定义发生变化,两端都需要同步修改。
MCP 的出现,改变了这种繁琐的对接方式。
它提供了一套基于 JSON-RPC 的统一交互规范,服务端只要声明自己拥有的工具和输入描述,客户端就能在运行时自主发现并完成调用。
我们的一期设计目标非常明确,就是根据用户的个人背景与求职意向,为其推荐匹配的校招机会。
比如用户可以在 AI 助手里直接提问“帮我看看今年有哪些适合计算机专业应届生的深圳岗位”,或者“我想进银行类国企,有什么正在开放的校招吗”。
AI 助手会通过统一协议访问求职派服务端,自动提取用户的查询条件,最终返回结构化的推荐职位。
整个交互过程可以拆分为两个阶段。
首先是配置阶段,用户把求职派的连接端点配置到客户端工具(例如 Trae)中,双方完成握手与能力协商。
随后是使用阶段,用户在客户端发起对话,大模型识别到查询意图后,触发求职派的工具方法并渲染返回结果。
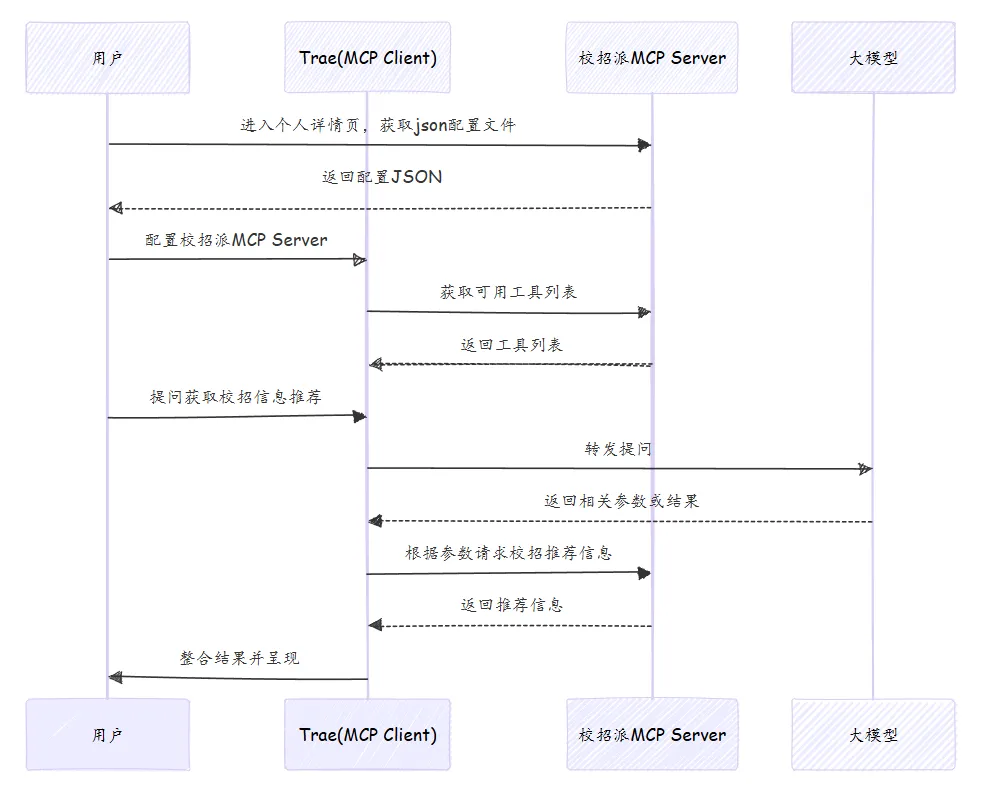
通过上面的时序图可以看出,客户端与服务端之间解耦得非常彻底。我们只需要专心把服务端的接口和数据逻辑做好,剩下的意图解析与调用编排全部交给大模型来完成。
02、Spring AI 下如何快速搭建一个 MCP Server?
在 Spring AI 生态中搭建服务端并不复杂,官方已经为我们提供了高度封装的 Starter 依赖。
第一步,我们需要在工程的依赖管理文件里引入对应的 WebMVC Starter 依赖包。
<dependency>
    <groupid>org.springframework.ai</groupid>
    <artifactid>spring-ai-starter-mcp-server-webmvc</artifactid>
</dependency>
引入依赖之后,Spring Boot 就会自动装配底层的传输通道与请求调度器。
接下来,我们需要在配置文件中声明服务的核心参数与传输端点。
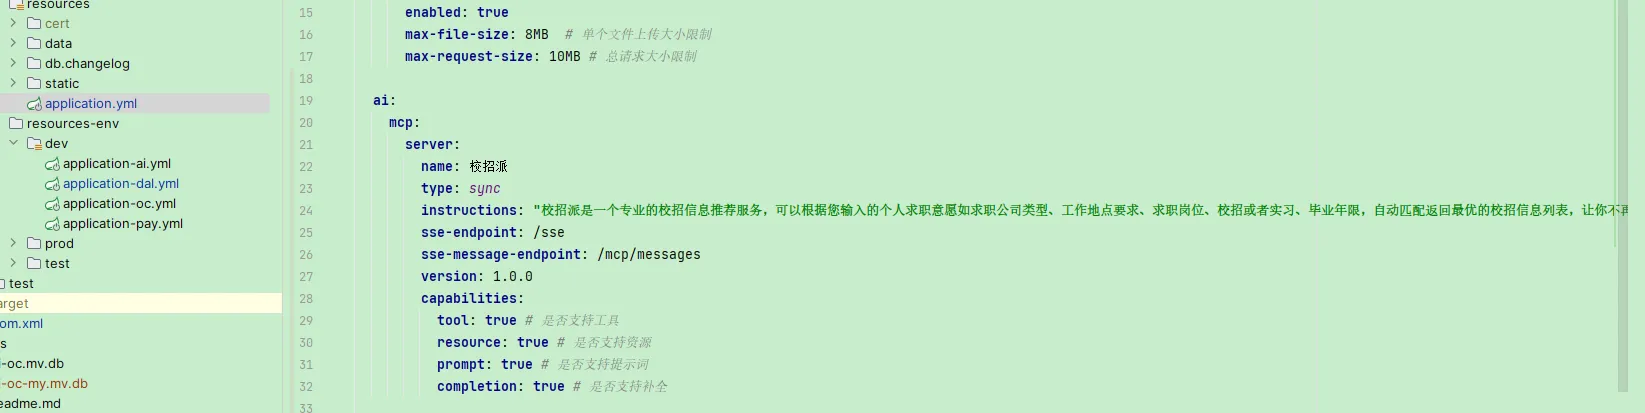
具体的配置内容如下所示。
spring:
  ai:
    mcp:
      server:
        name: 求职派
        type: sync
        instructions: "求职派是一个专业的校招信息推荐服务,可以根据您输入的个人求职意愿如求职公司类型、工作地点要求、求职岗位、校招或者实习、毕业年限,自动匹配返回最优的校招信息列表,让你不再错过招聘信息"
        sse-endpoint: /sse
        sse-message-endpoint: /mcp/messages
        version: 1.0.0
        capabilities:
          tool: true # 是否支持工具
          resource: true # 是否支持资源
          prompt: true # 是否支持提示词
          completion: true # 是否支持补全
其中参数 sse-endpoint 代表客户端建立监听通道的地址,服务端会通过长连接向客户端推送通知。
参数 sse-message-endpoint 则是客户端向服务端发送具体调用指令的消息入口。
我们在属性 instructions 里用清晰的自然语言描述了求职派的核心能力,这部分内容会在握手阶段直接同步给客户端,帮助大模型快速建立系...
回复