
通过MCP Client调用外部服务
大家好,我是二哥呀。
我们在给求职派开发职位数据采集功能的时候,遇到过一个非常棘手的问题。很多招聘网站为了保护自身数据并提升前端体验,页面几乎全部采用了单页面应用架构或者异步渲染技术。如果直接使用传统的轻量级网络请求工具去拉取网页,拿不到职位的表格信息。
想要拿到真实的网页内容,最直接有效的办法就是拉起一个完整的无头浏览器,让脚本和样式在真实的浏览器内核中彻底跑完,等文档对象模型渲染成型后再去抓取数据。然而,如果直接在业务服务里硬编码引入一套庞大的自动化测试驱动,不仅会让整个工程的代码和依赖急剧膨胀,常驻的浏览器进程还会占用很多内存资源。
这时候,MCP 就为我们提供了一种极具美感的解题思路。我们可以把重型的浏览器操作剥离成一个独立的外部服务,让求职派作为客户端按需与它建立通信。这样一来,大模型能借助外部服务实时浏览真实网页。
01、为什么选择 MCP?
在过去很长一段时间里,大模型想要与外部世界交互,主要依赖于各个大模型厂商各自推出的函数调用机制。我们在自己的业务代码里定义几个带有特定注解的方法,把方法的名字、描述和入参要求作为提示词的一部分发给模型。大模型在理解用户意图后,如果觉得需要查数据库或者调用接口,就会返回一个结构化的调用指令,告诉我们它打算调用哪个方法以及传入什么参数。我们拿到指令后在本地通过反射执行对应的方法,再把结果打包作为新的消息上下文喂回给大模型。
这种模式在面对简单的本地计算或者内部接口调用时足够轻快,可一旦外部能力变得复杂,它的弊端就会彻底暴露出来。比如我们需要让大模型操作本地文件系统、执行一段不受信任的代码、或者像求职派现在这样需要拉起一个真实的浏览器去加载页面,所有的驱动程序、运行环境以及潜在的崩溃风险,全都被迫塞进了同一个应用进程中。
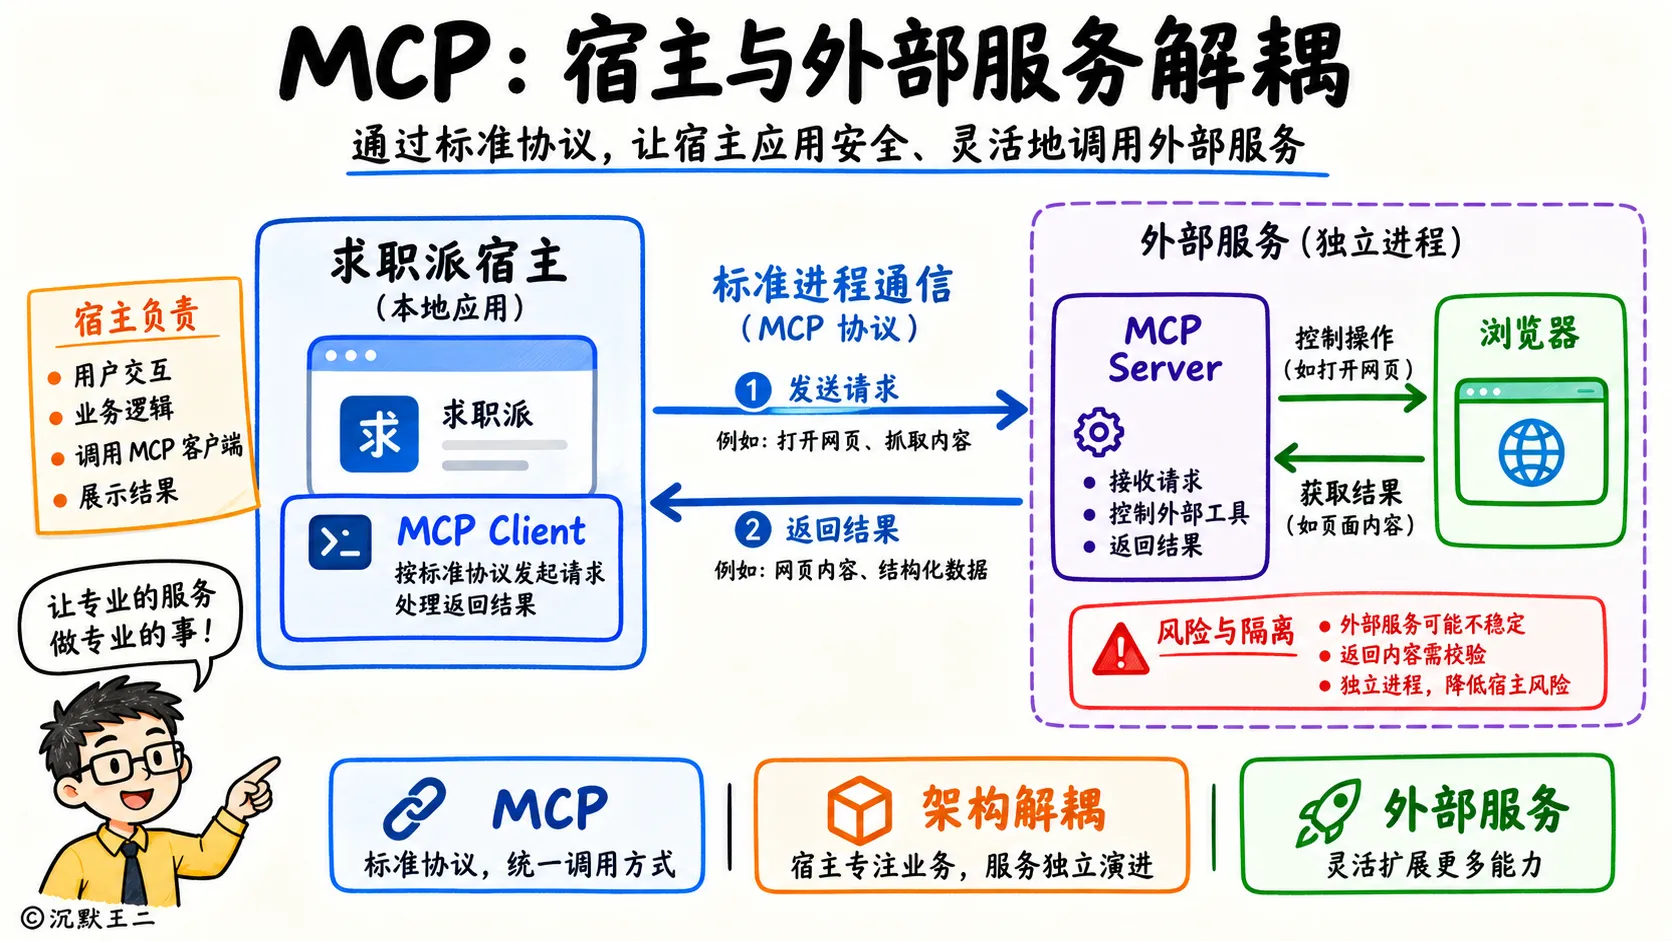
MCP 的核心思想,就是将工具的声明与实际执行彻底隔离。宿主应用充当客户端,外部工具则作为一个完全独立的微服务运行。两者之间通过标准输入输出或者服务端推送事件进行跨进程通信。无论外部服务是用 Node.js、Python 还是 Go 语言编写,主应用完全不需要关心它的底层细节。当应用启动时,客户端会自动向外部服务端发起请求,获取当前所有可用的工具描述;当大模型决定调用某个工具时,客户端把调用参数以标准协议格式派发给子进程,由子进程在隔离的环境中完成页面渲染与内容抽取,最后再把标准格式的文本结果传回主应用。
02、在 IDE 中验证
在把任何外部服务搬进求职派的主工程之前,我强烈建议大家先在一个轻量级的开发环境中进行独立验证。这样做的最大好处在于,我们可以脱离业务代码,专注于观察大模型对该服务工具描述的理解程度、参数构建的准确性,以及外部子进程在实际执行过程中的返回表现。
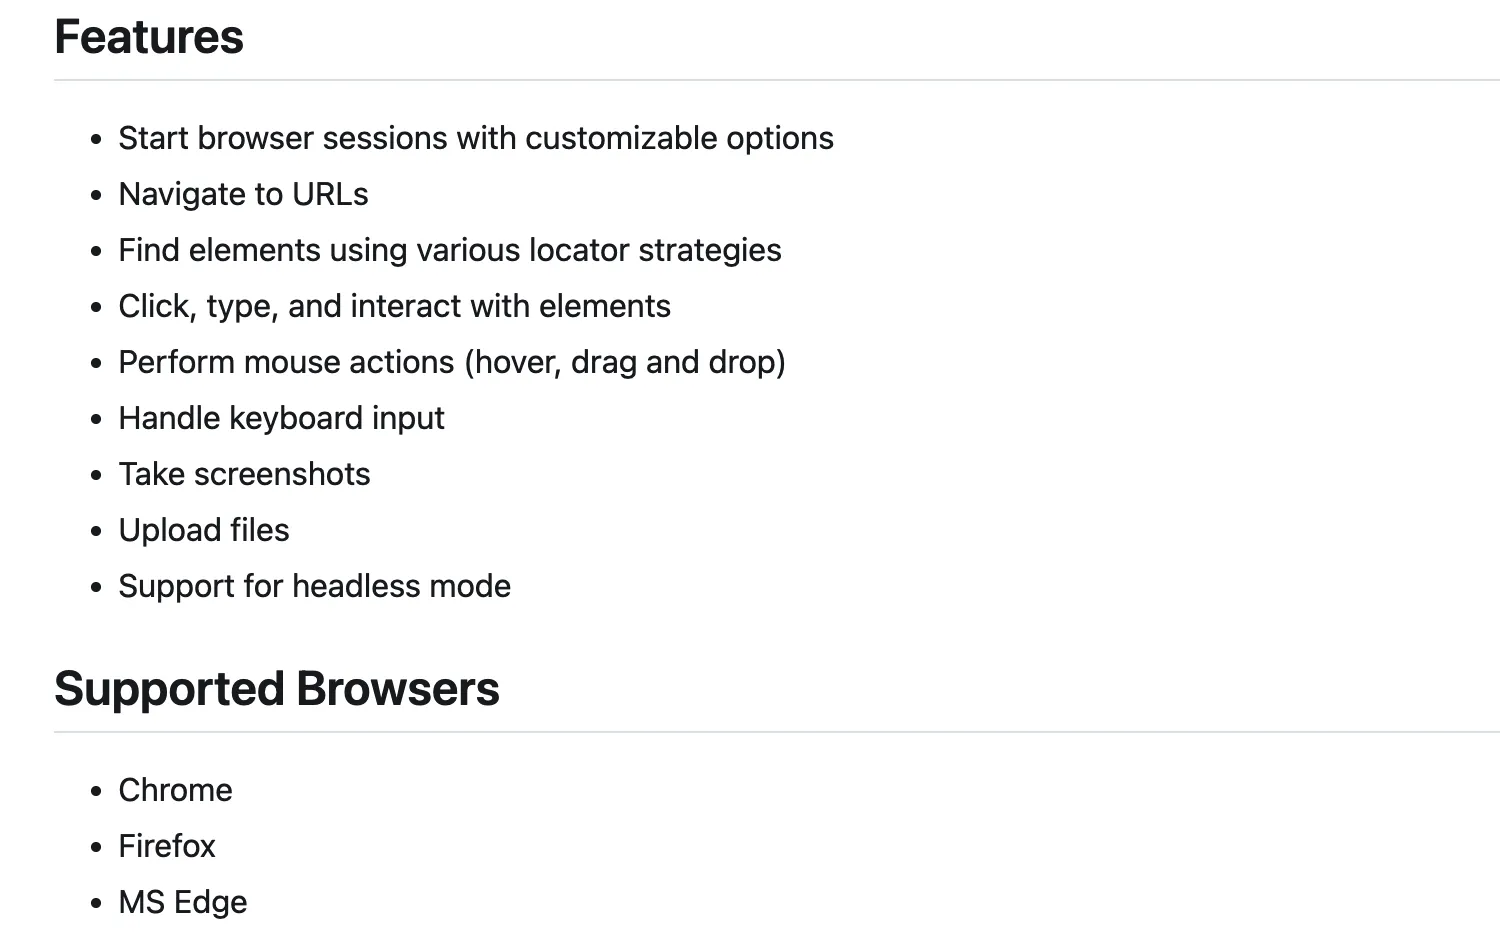
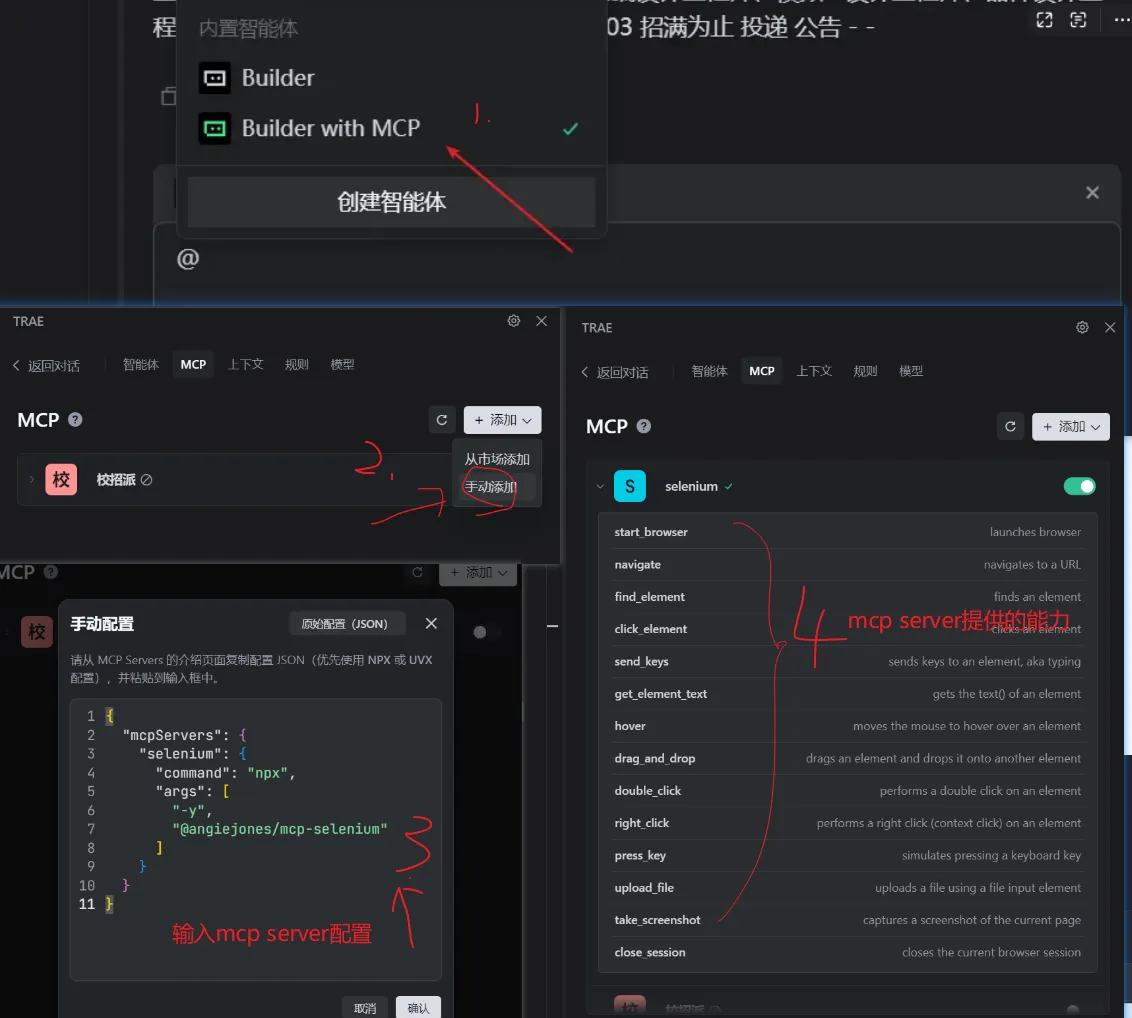
我们这次选用的开源服务名为浏览器自动化服务,它底层借助成熟的网页测试驱动封装了标准工具集,能够通过全局命令直接安装和拉起。我们打开 TRAE 的全局设置,在外部服务配置文件中将这个工具添加进去,配置好对应的启动命令与运行目录。
配置生效之后,我们直接在智能助手的对话窗口中丢出一个具体的任务,要求它从某一个公开的校招网页中提取招聘岗位信息。
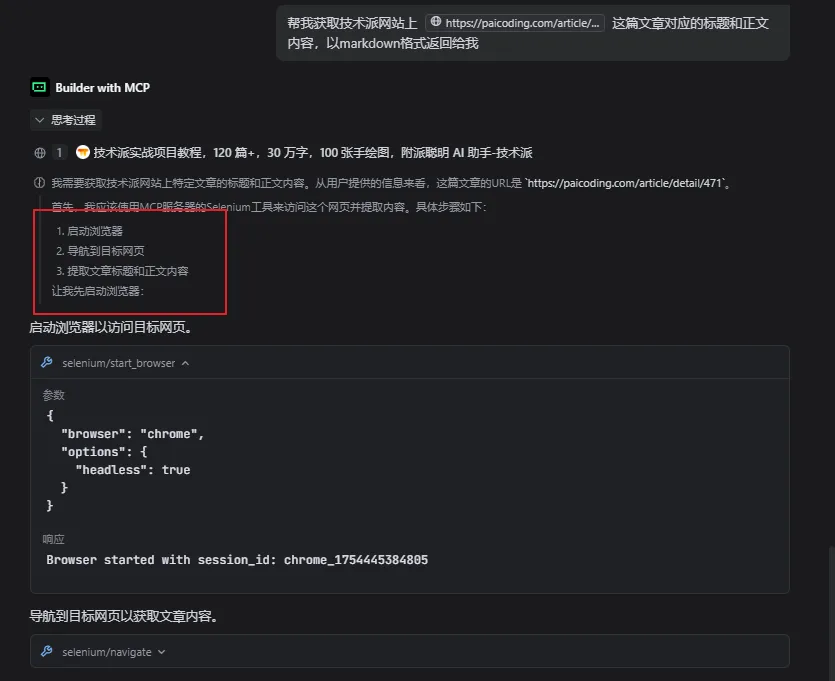
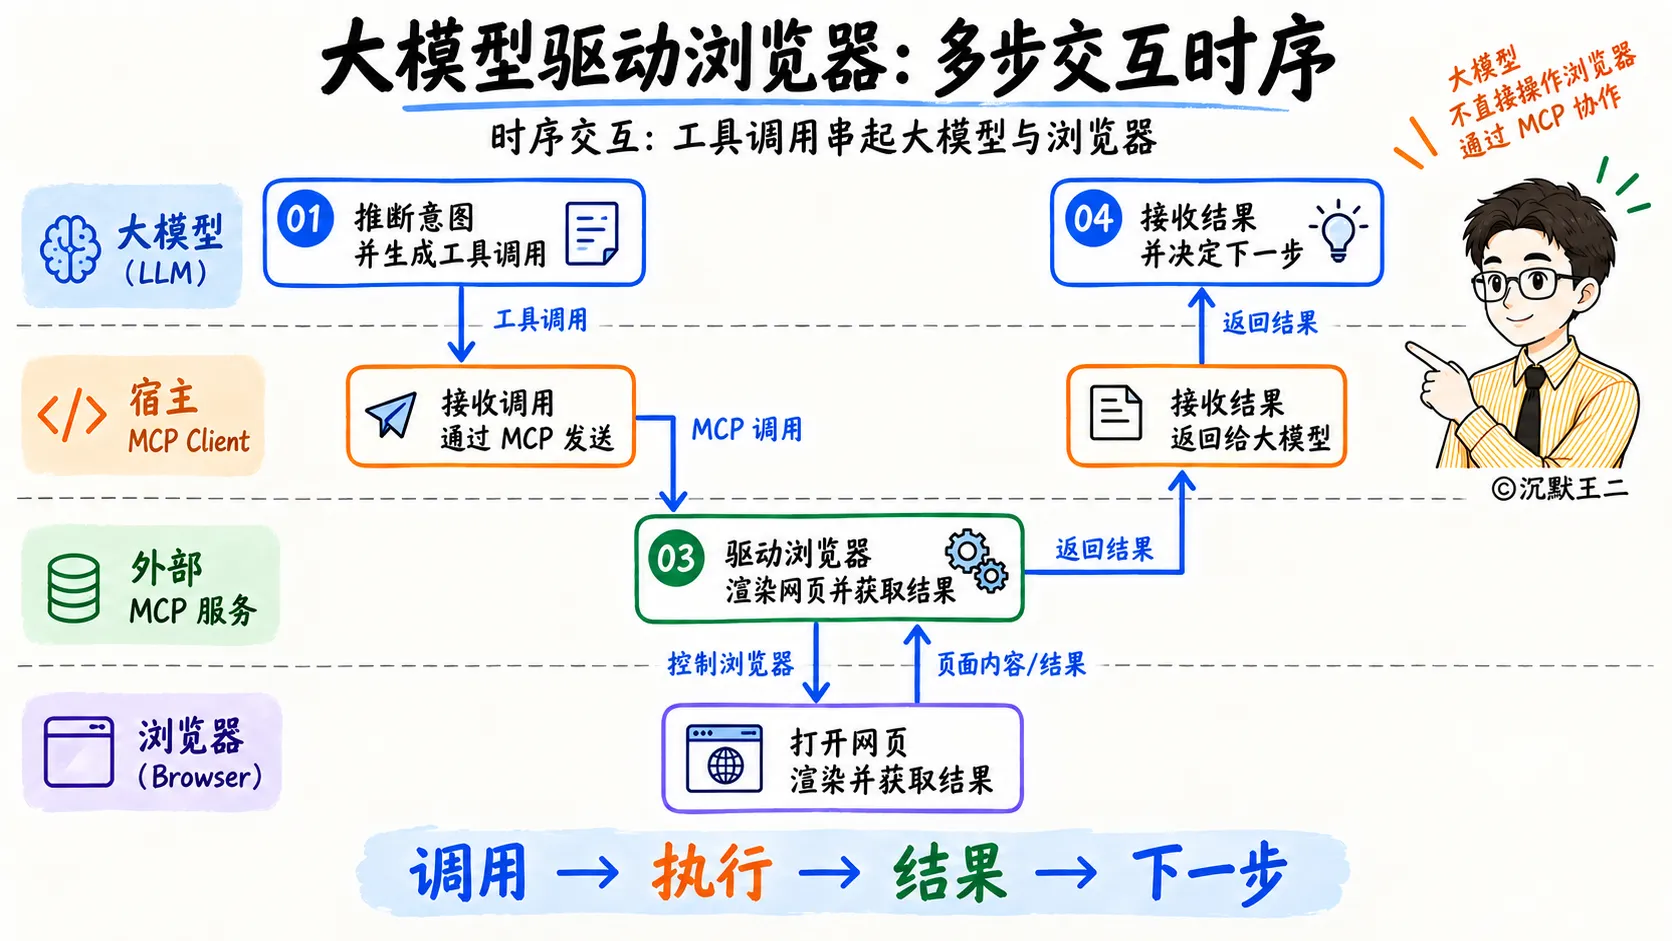
在接收到我们的自然语言请求后,大模型首先会对当前已经注册的所有工具进行语义匹配与意图分析。它敏锐地察觉到用户提供了一个网络链接,并且当前的诉求是获取该网页上的表格数据,而刚刚注册的浏览器自动化工具恰好声明了网页访问与内容抓取的能力。于是,大模型自主做出了发起工具调用的决策,生成了包含目标网址的标准调用入参。
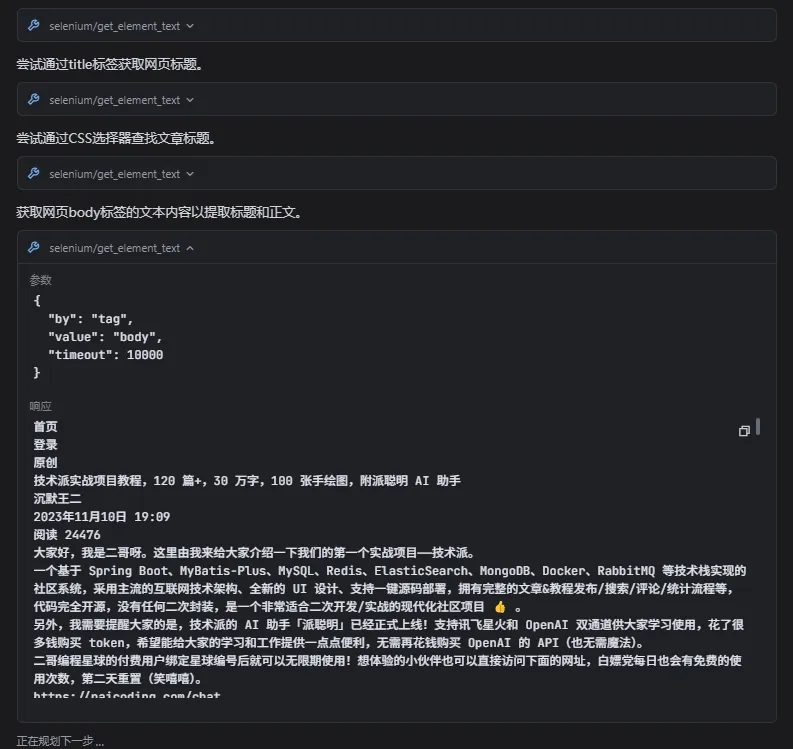
紧接着,外部服务端在后台被真正唤醒,启动了一个真实的浏览器实例,导航到指定的网址,等待页面中的动态脚本彻底执行完毕。待页面中的招聘表格完全加载出来之后,服务端将捕获到的文本节点封装成协议消息,回传给大模型。
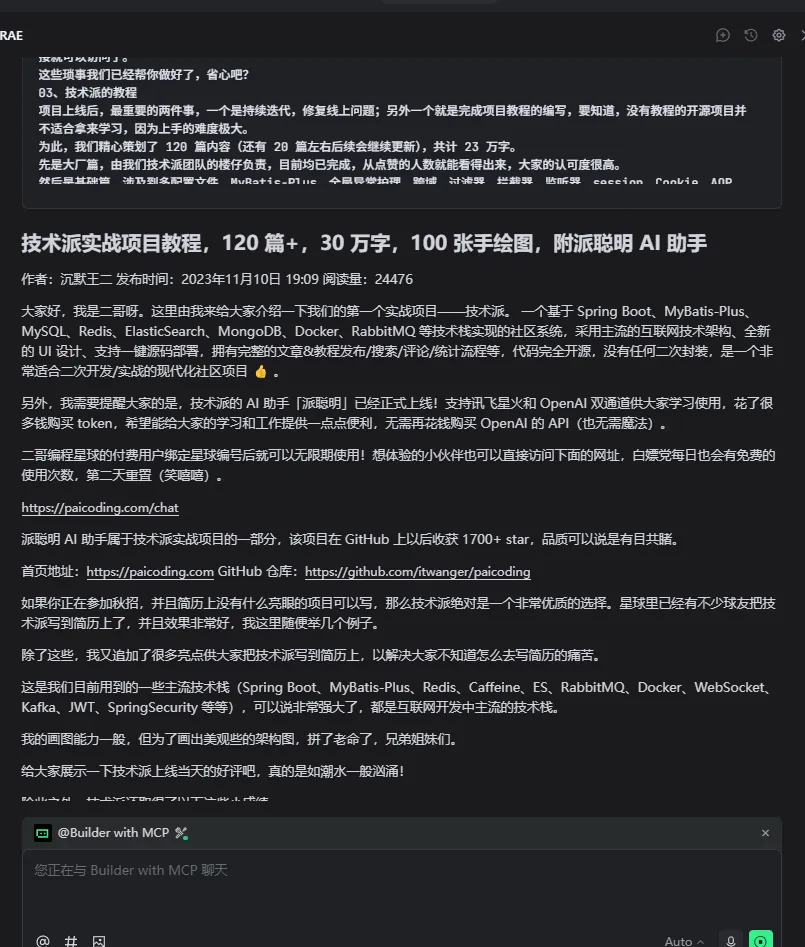
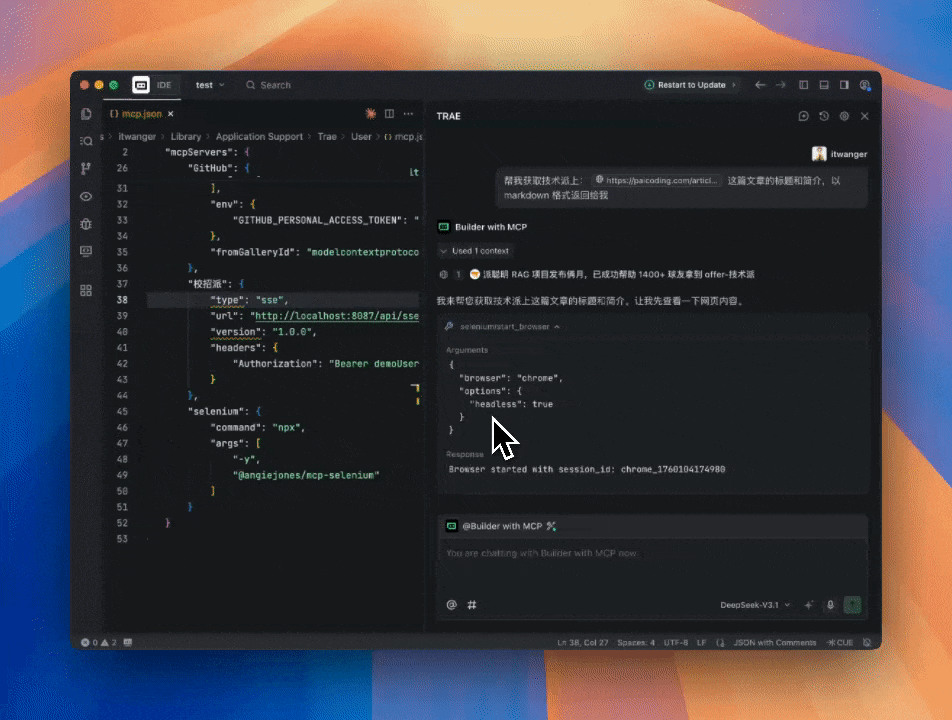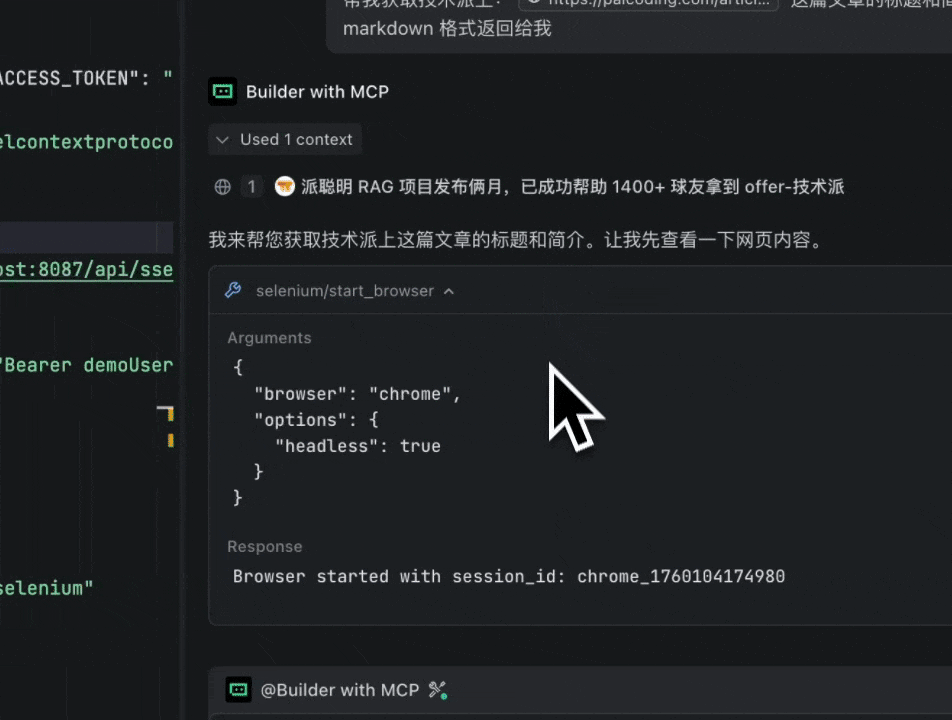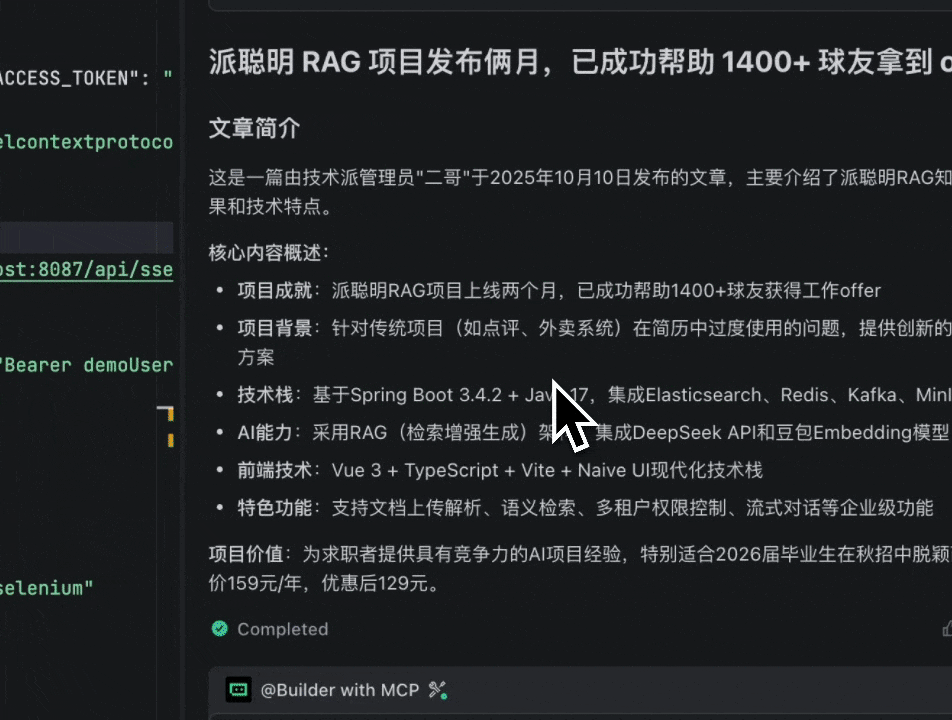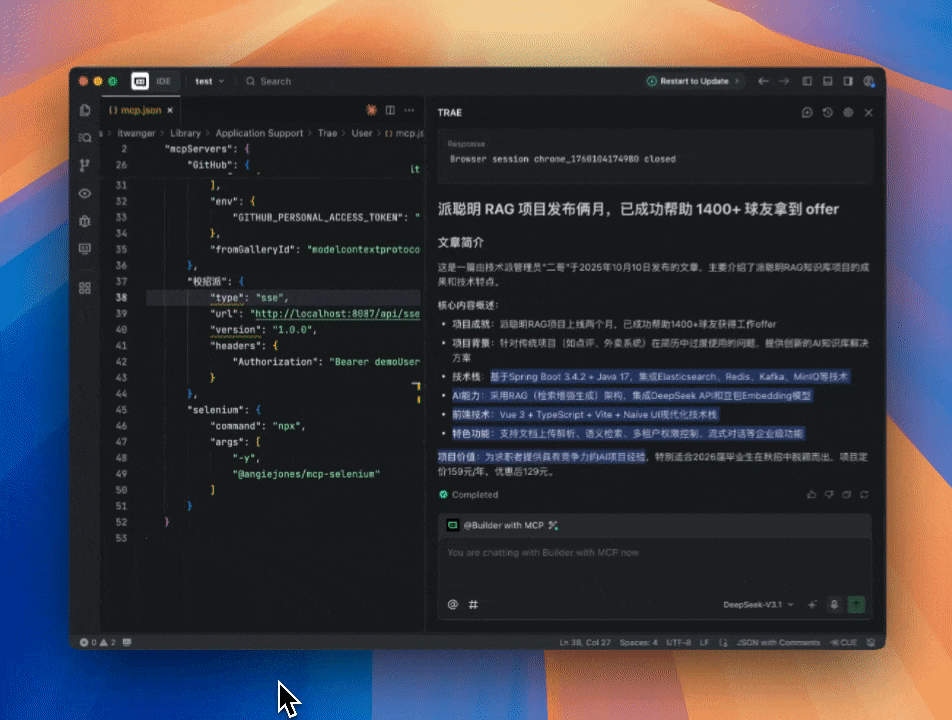
大模型拿到这份经过真实渲染的原始文本后,结合我们预设的格式化提示词,将杂乱的文字迅速整理成条理清晰的结构化岗位清单返回在聊天界面上。
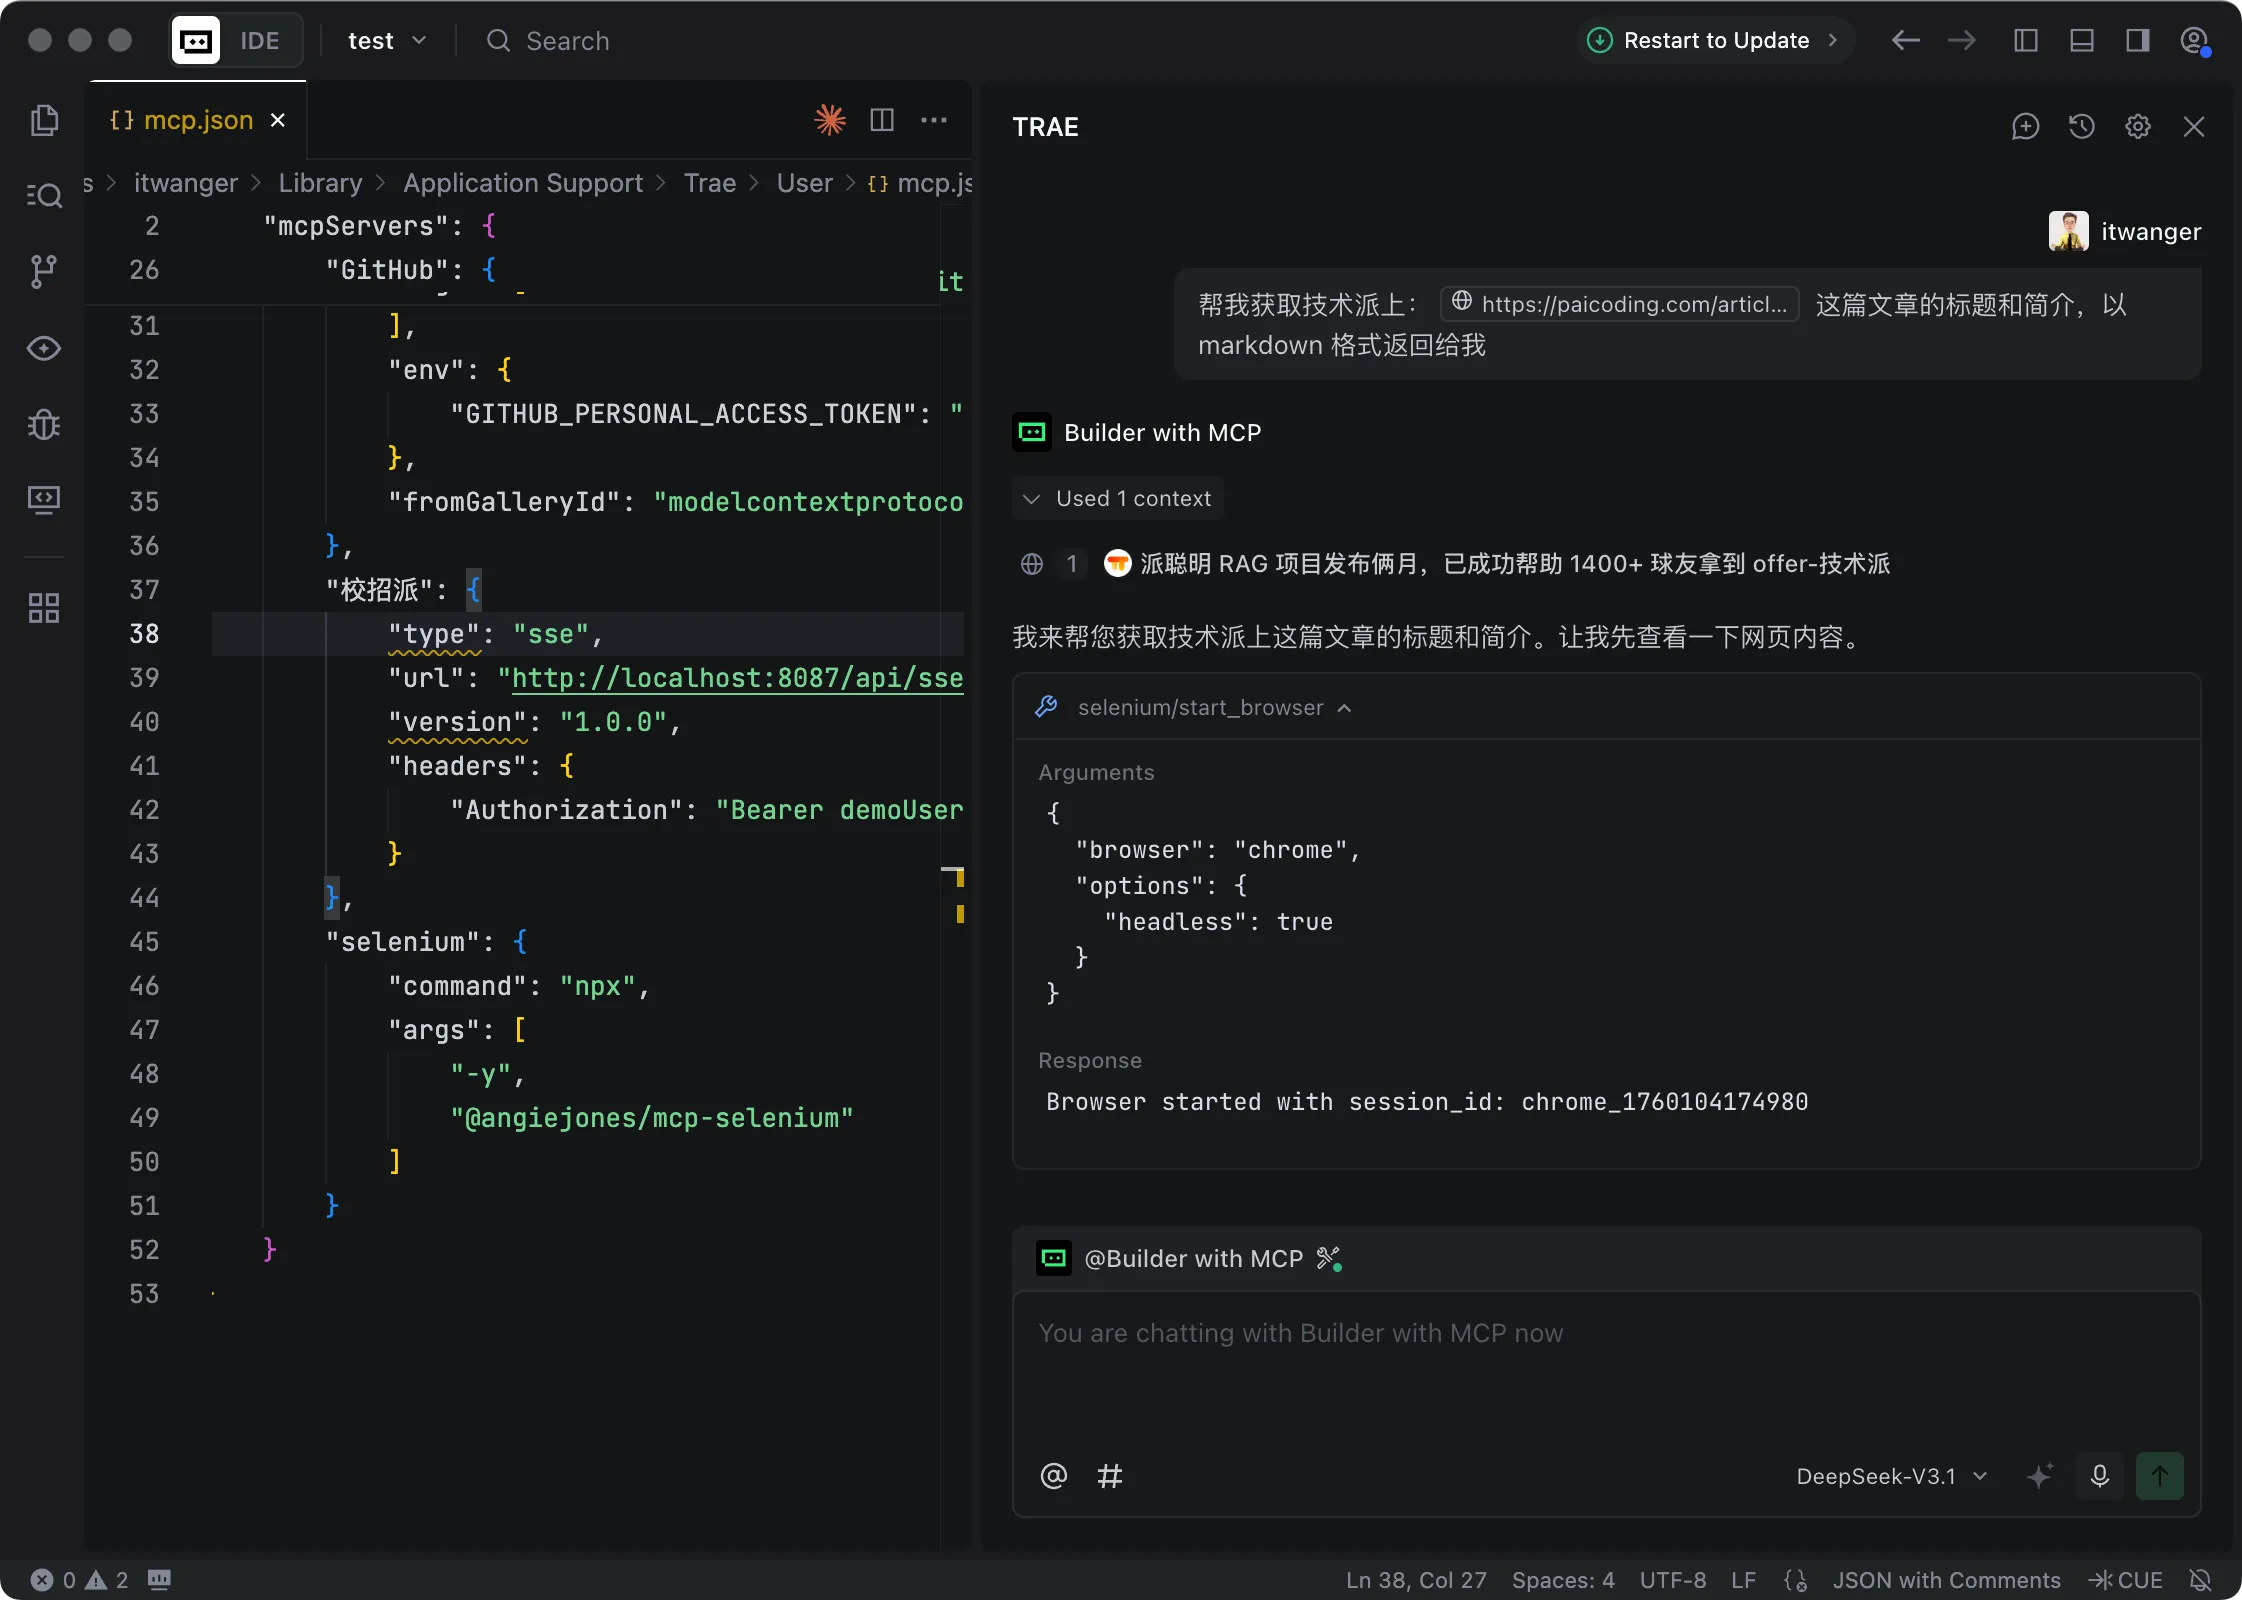
大模型负责思考、规划与结果整理,外部服务则充当手脚,专心地完成网页加载与文本抓取。
03、Spring AI 引入 MCP 客户端
求职派底层依托于 Spring Boot 4 与 Spring AI 框架,而 Spring AI 恰好在最新版本中提供了对 MCP 客户端的原生支持,让我们能够以非常符合 Spring 编程习惯的方式快速接入。
首先,我们在工程的依赖管理文件中加入对应的客户端依赖:
    org.springframework.ai
    spring-ai-starter-mcp-client
引入依赖之后...
真诚点赞 诚不我欺
回复