
求职派 JobClaw 是什么?
大家好,我是二哥呀。
我们星球已经有好几个经典的项目了,派聪明、PaiCLI、PmHub、技术派等等。
随着时间的推移,我们的 JobClaw 也已经重构了三次(一直还没有宣传),主要是现在做项目周期不能长,不然技术过时太快了(我指的是 AI 领域的技术名词)。
3 月份还很火的 OpenClaw,到现在热度已经退下去了,但它的 Gateway + Agent Runtime 架构本身很经典,JobClaw 就是我们在那个时期酝酿的一个项目。
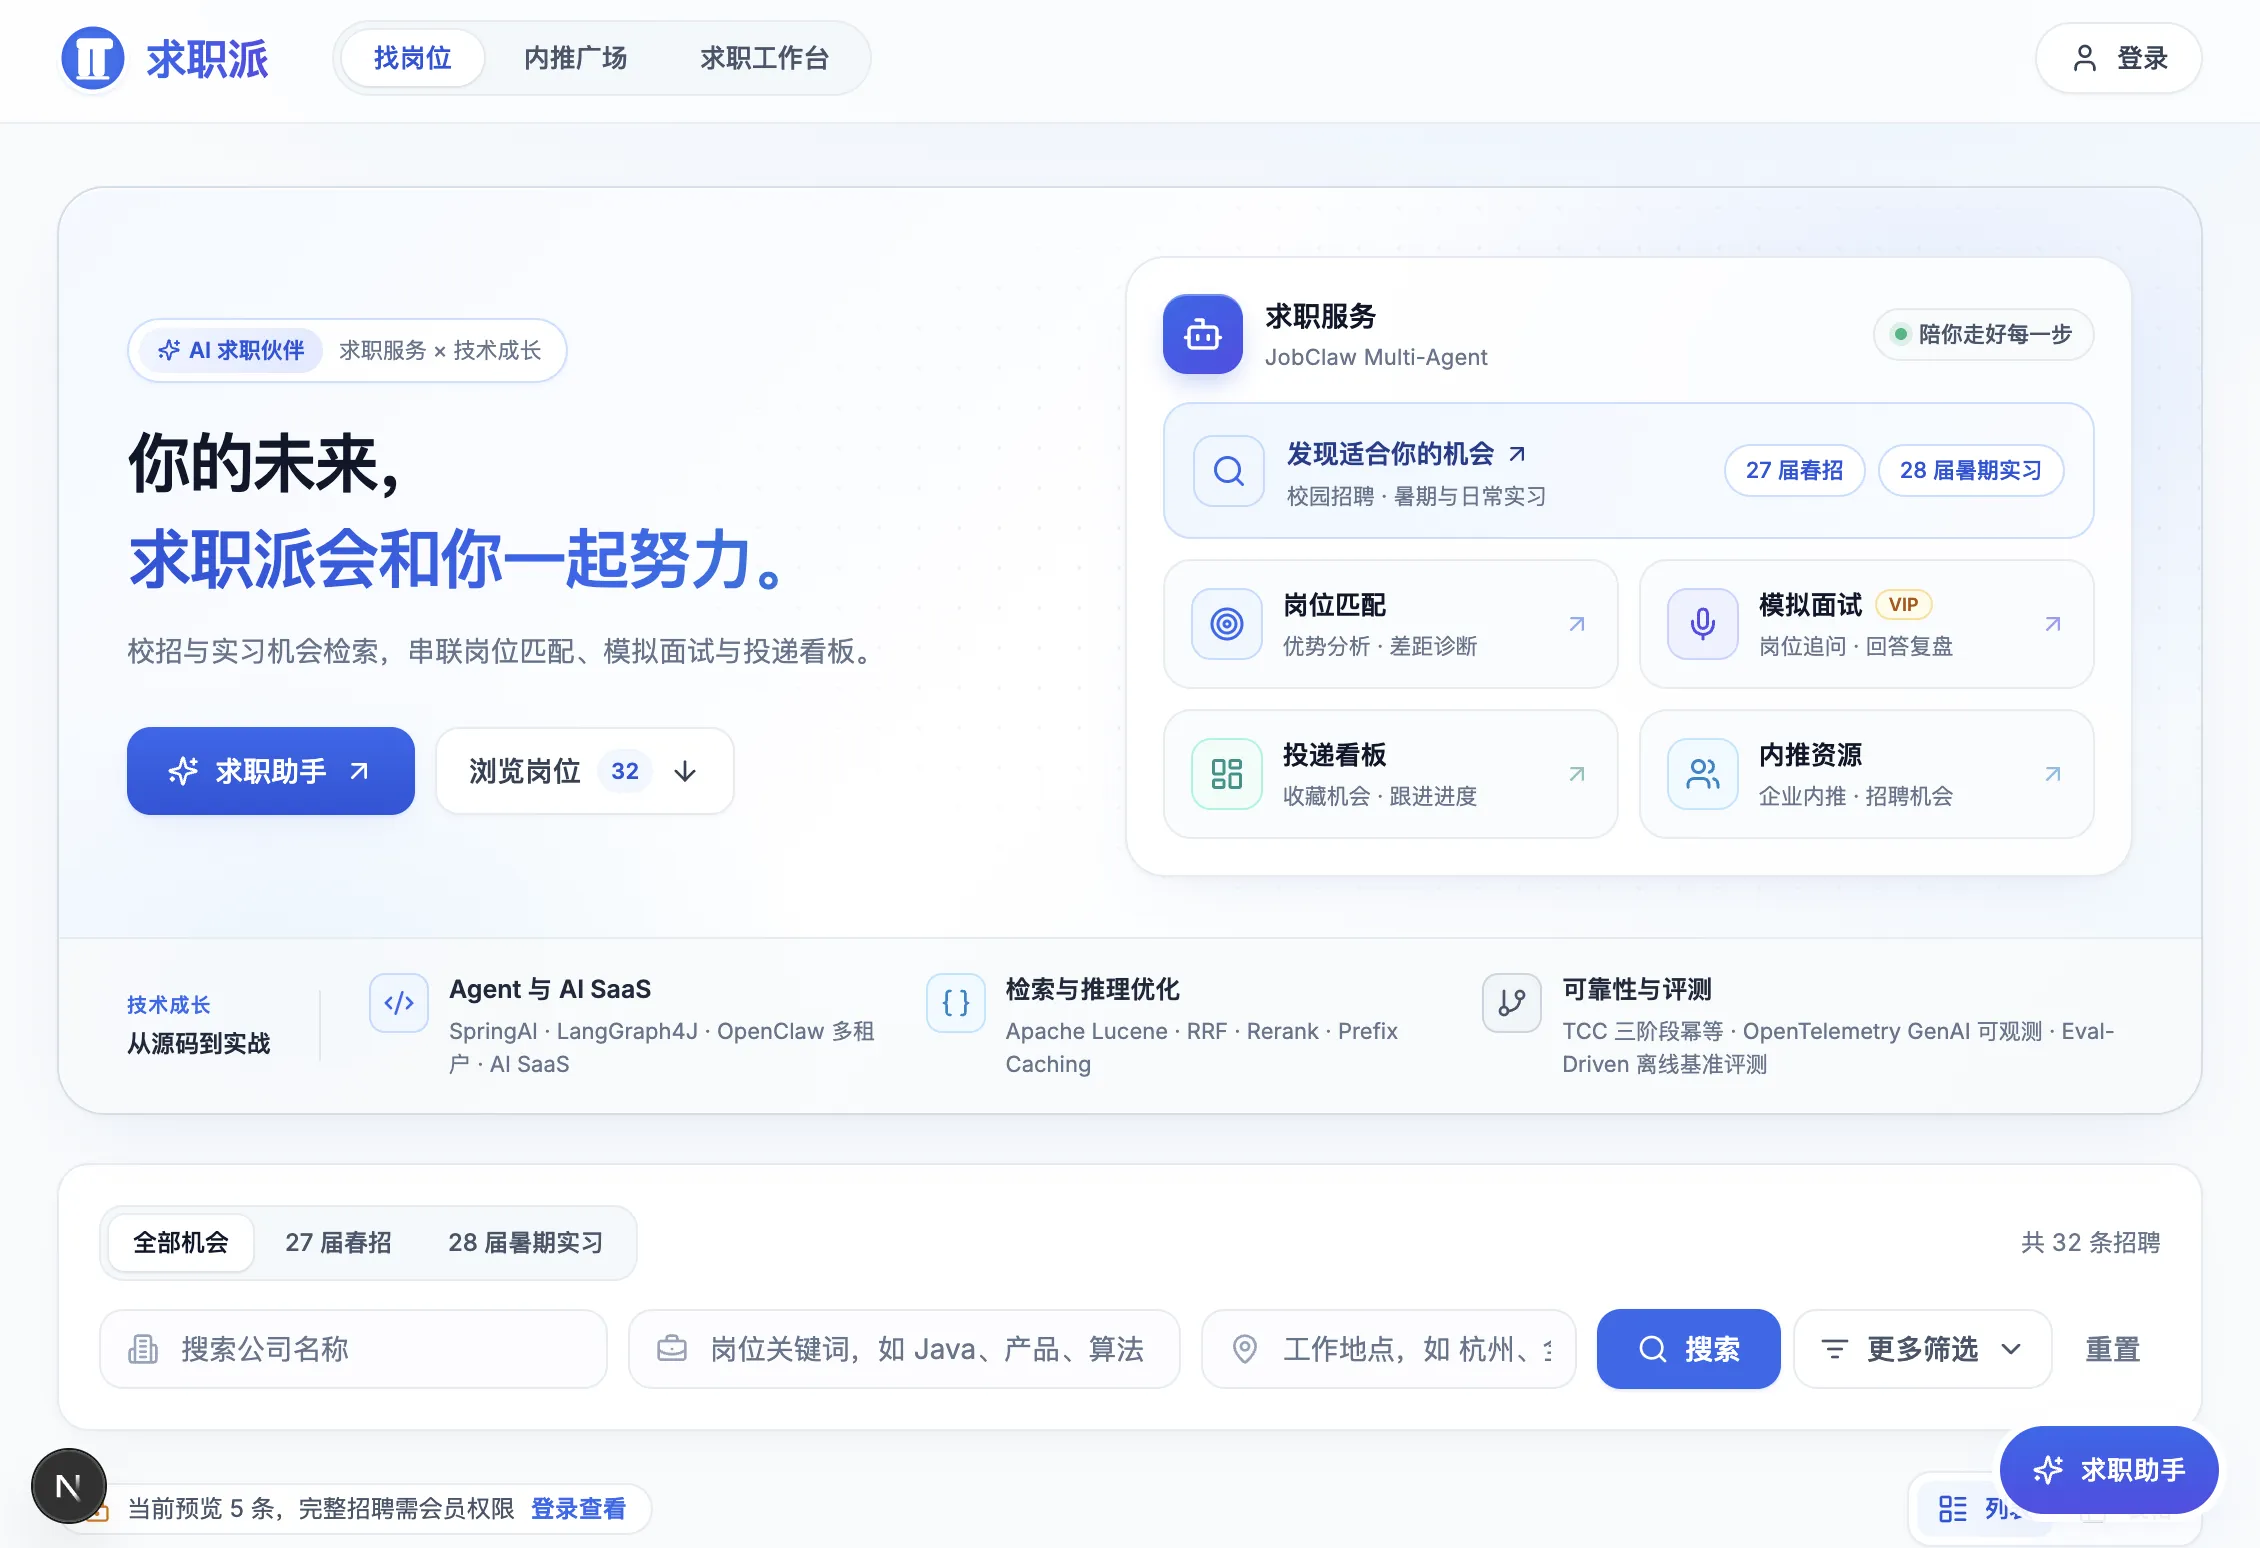
热度会退,架构思想不会过时。而且我可以向大家保证,第三次重构,好处就是可以直接用当下最强的模型,比如说 Opus 5.5、GPT-6.2 Astra、Gemini 4 Neon,代码和架构都能最大程度上呈现给大家最好的一面。
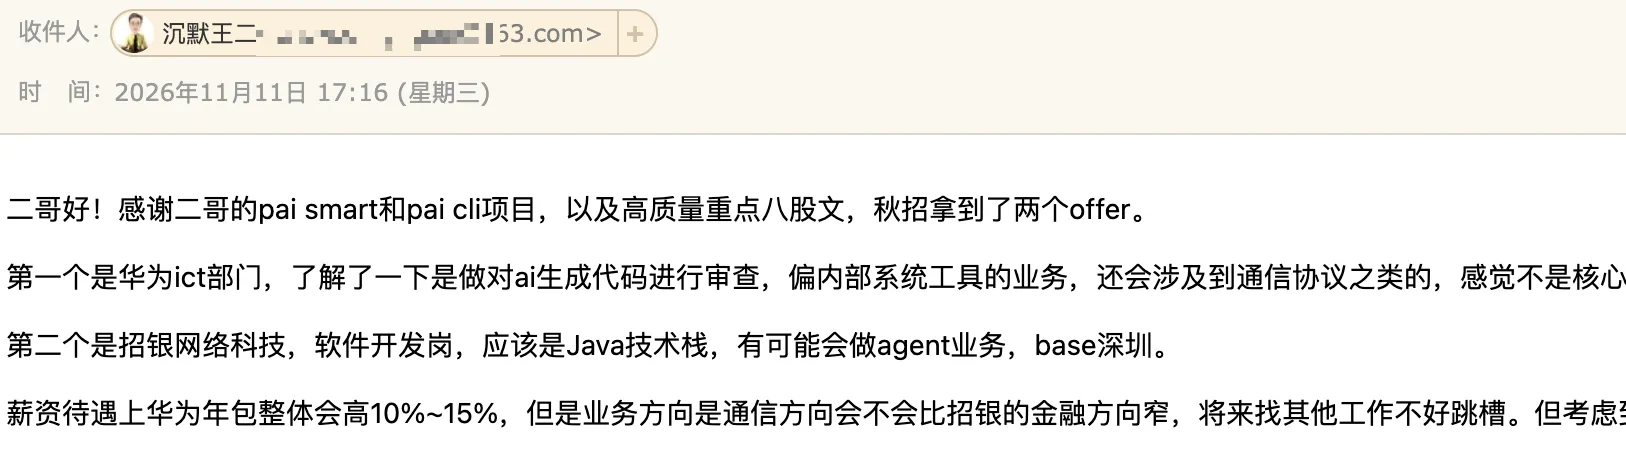
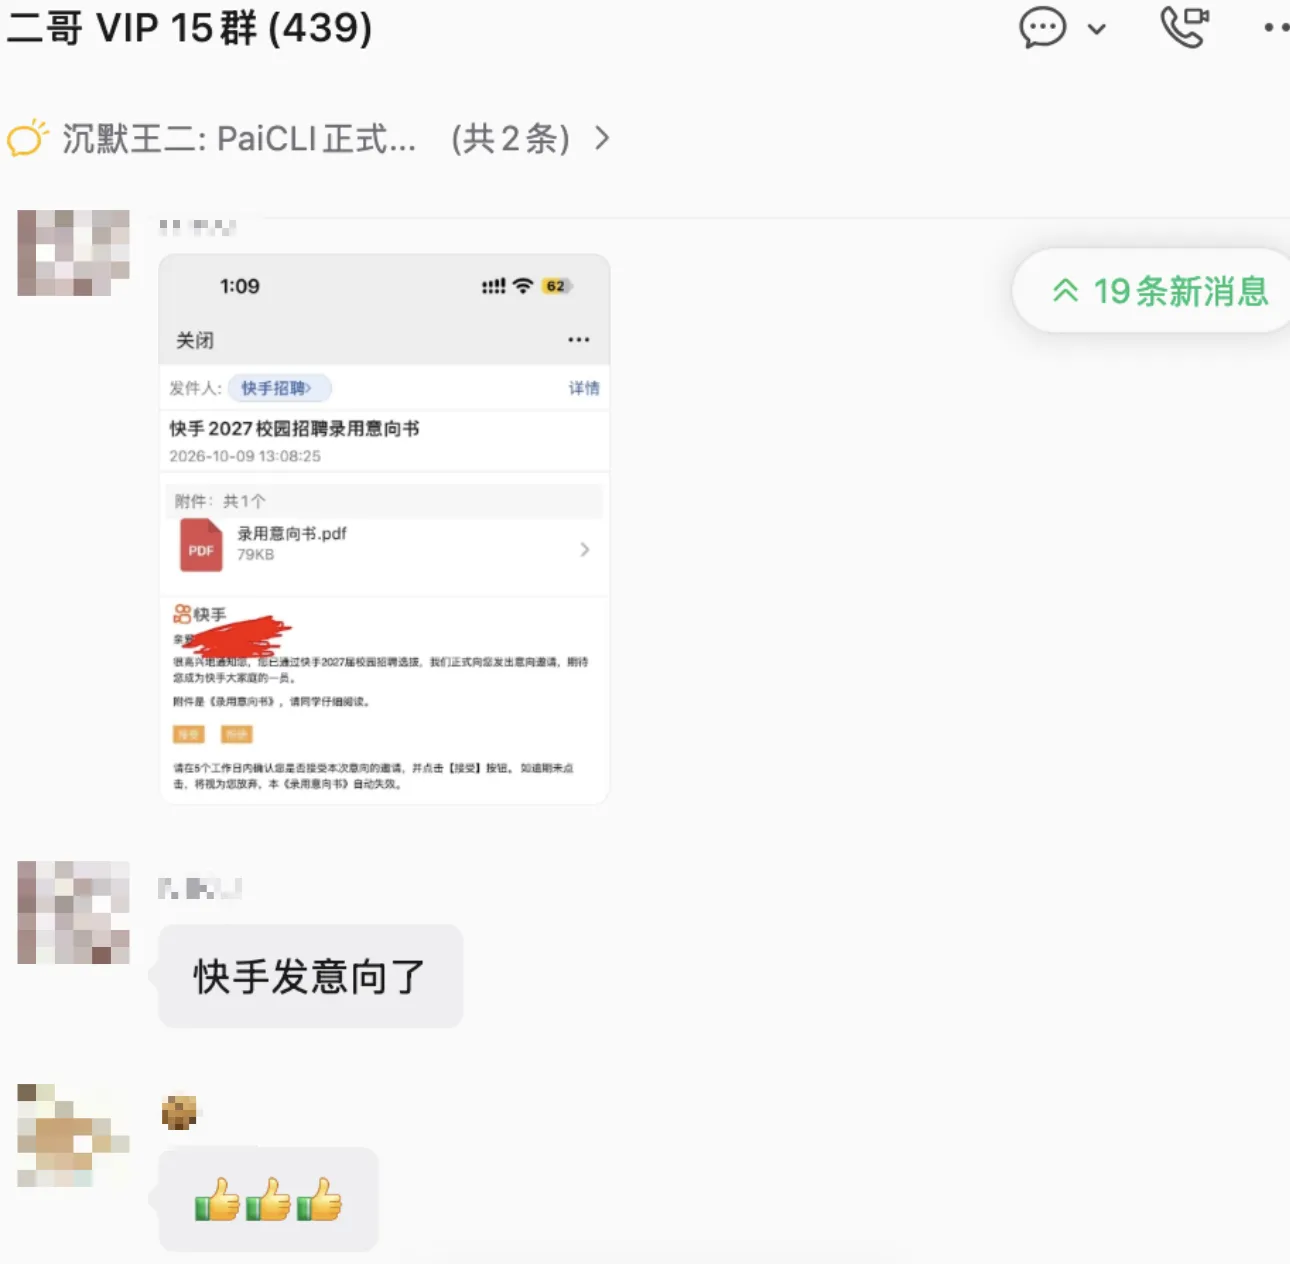
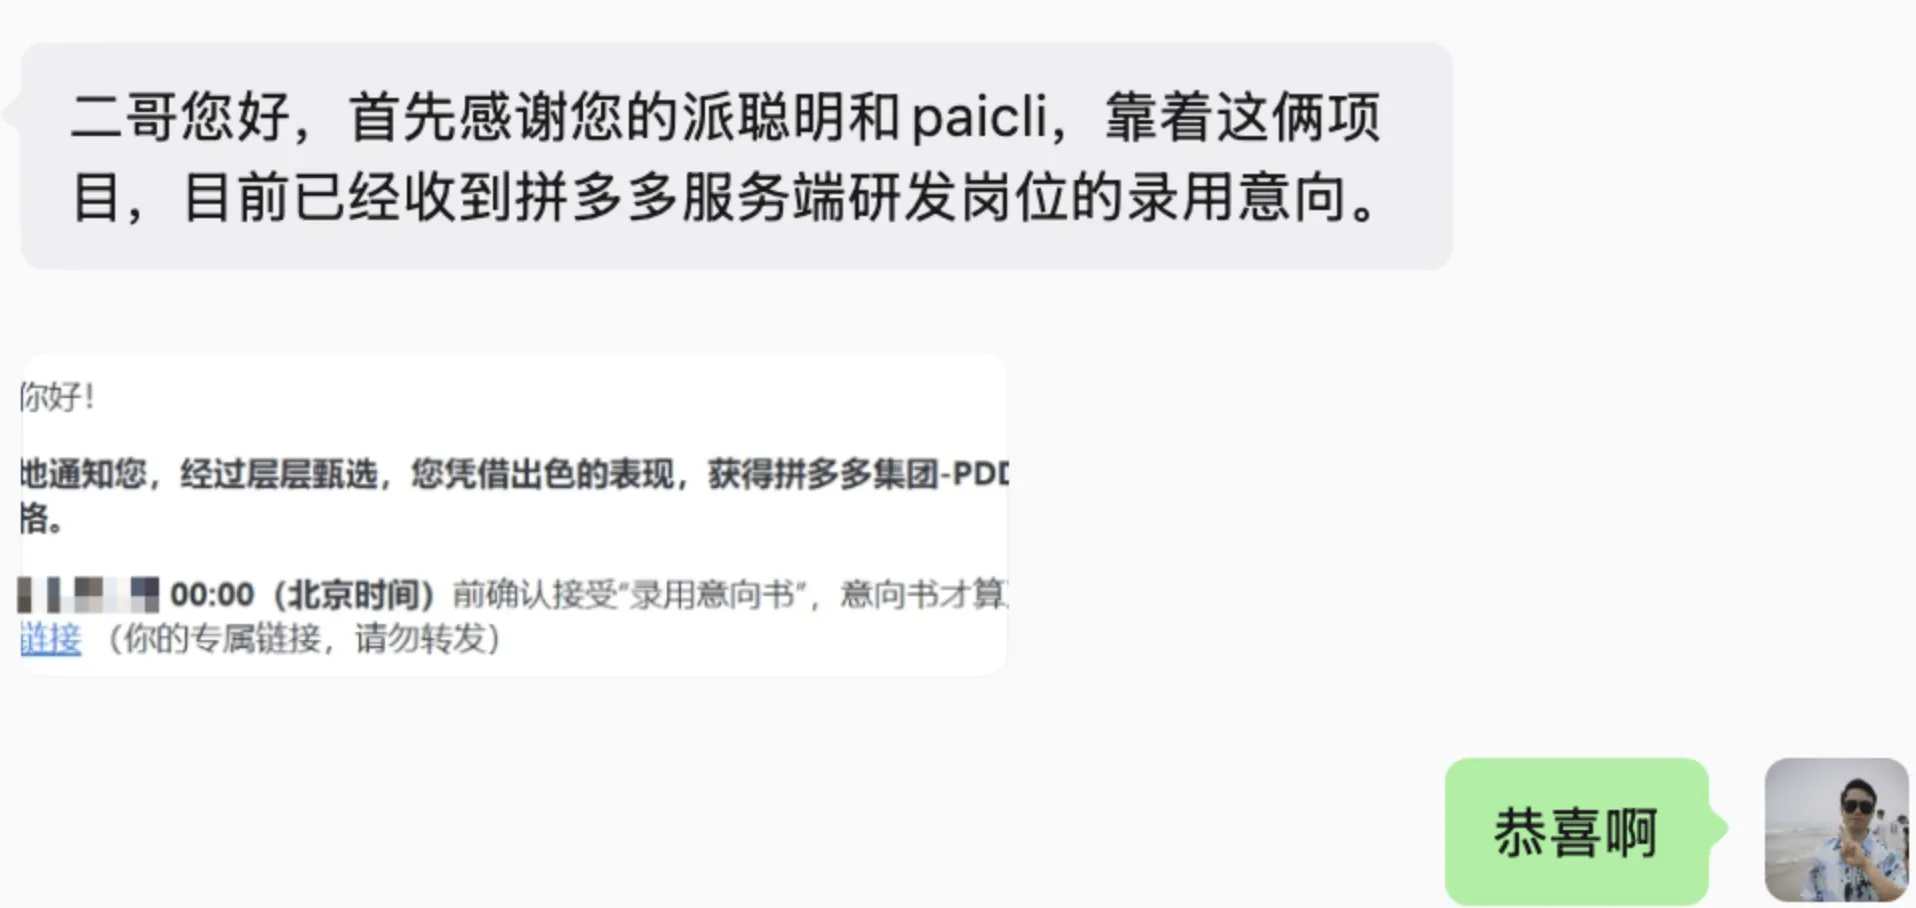
先晒两张球友靠星球实战项目拿下的喜报吧,给大家点信心。
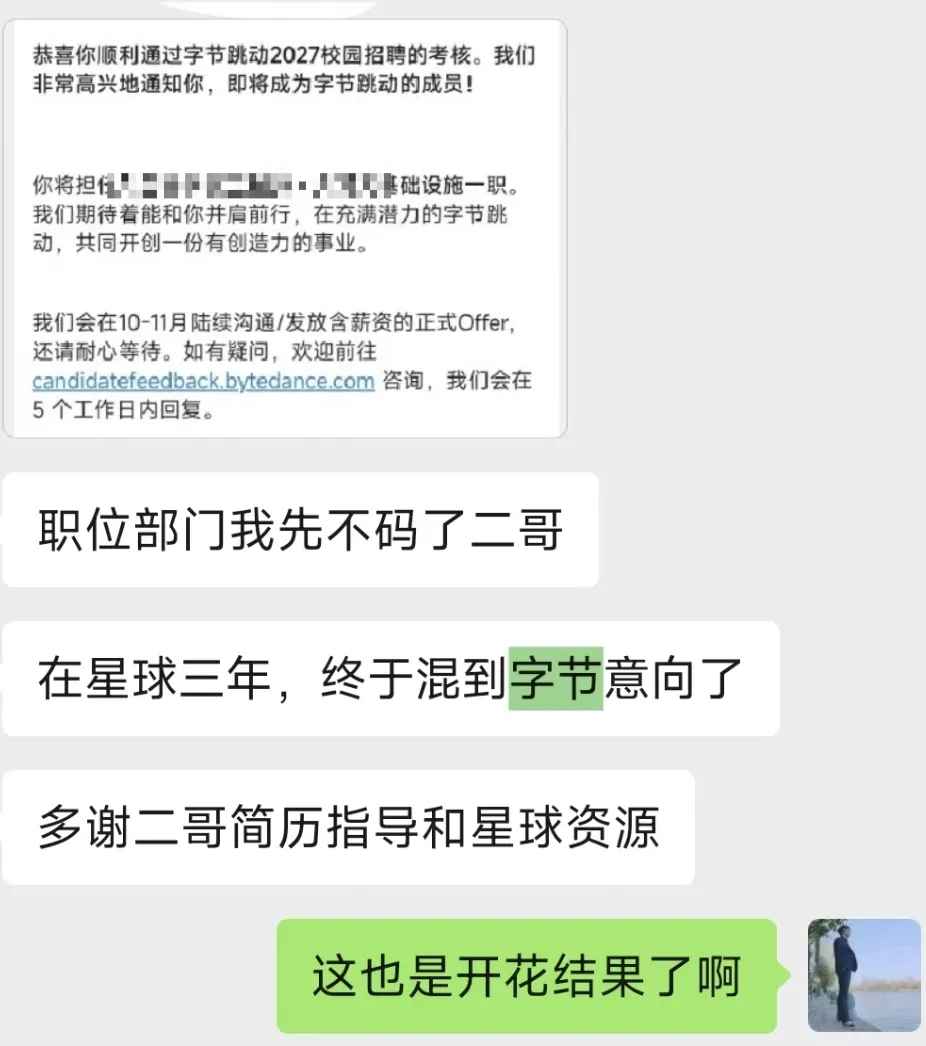
说句真心话,看到这里,如果你想学习项目的话,可以直接冲了。扫下面的优惠券就能解锁求职派源码和配套教程(其他项目也一并解锁),二哥的编程星球目前定价 169 元/年(求职派推完就涨价到 179 元),领券后只要 139 元,每天不到 0.39 元。
对,你没看错,只要 139 元,为什么我不收 399、699、999,不是因为不值,只是我希望尽可能多的去帮助一部分人,我赚再多也不可能成为马斯克,对吧?
当然了,我知道哪怕优惠完只要 139 元,仍然会被非议,但这个世界就是这样,你无法满足所有的人,参差不齐乃幸福本源,伟大的罗素先生就曾托梦告诉过我(读王小波的书了)。
保持清醒,保持热爱,保持对这个世界的一份纯真。赚点钱养家糊口,是我理所应当的职责,也请大家包容。
作为开篇词的第一篇,我带大家先摸清求职派是什么、为什么要做它、有哪些让面试官眼前一亮的技术架构,顺便把“面试时该怎么介绍求职派”的口述模板也一并准备好。
一、求职派的起源
老球友应该还有印象,当初我在写《派聪明 RAG 项目是什么》时留过一句伏笔,下个项目校招派,打算把 MCP 和 Agent 也做进来。
那时候,Agent 还不像现在这么火热,还处在 RAG 的时代。
大家现在看到的求职派(JobClaw),就是从当初的校招派一路进化而来的 Agent 项目。
最早起这个念头,是因为每年秋招和春招一开,各大厂、国企、银行的招聘公告都会发表在公众号、官网和招聘社区里。大家每天光翻公告、筛岗位就要耗掉大半天,好不容易挑出几个岗位,又拿不准自己的简历匹配度如何。
于是我拉上老搭档一灰(熟悉技术派的同学肯定对一灰不陌生),决定做一套既能帮大家找工作、又能写进简历冲大厂的 AI 项目。
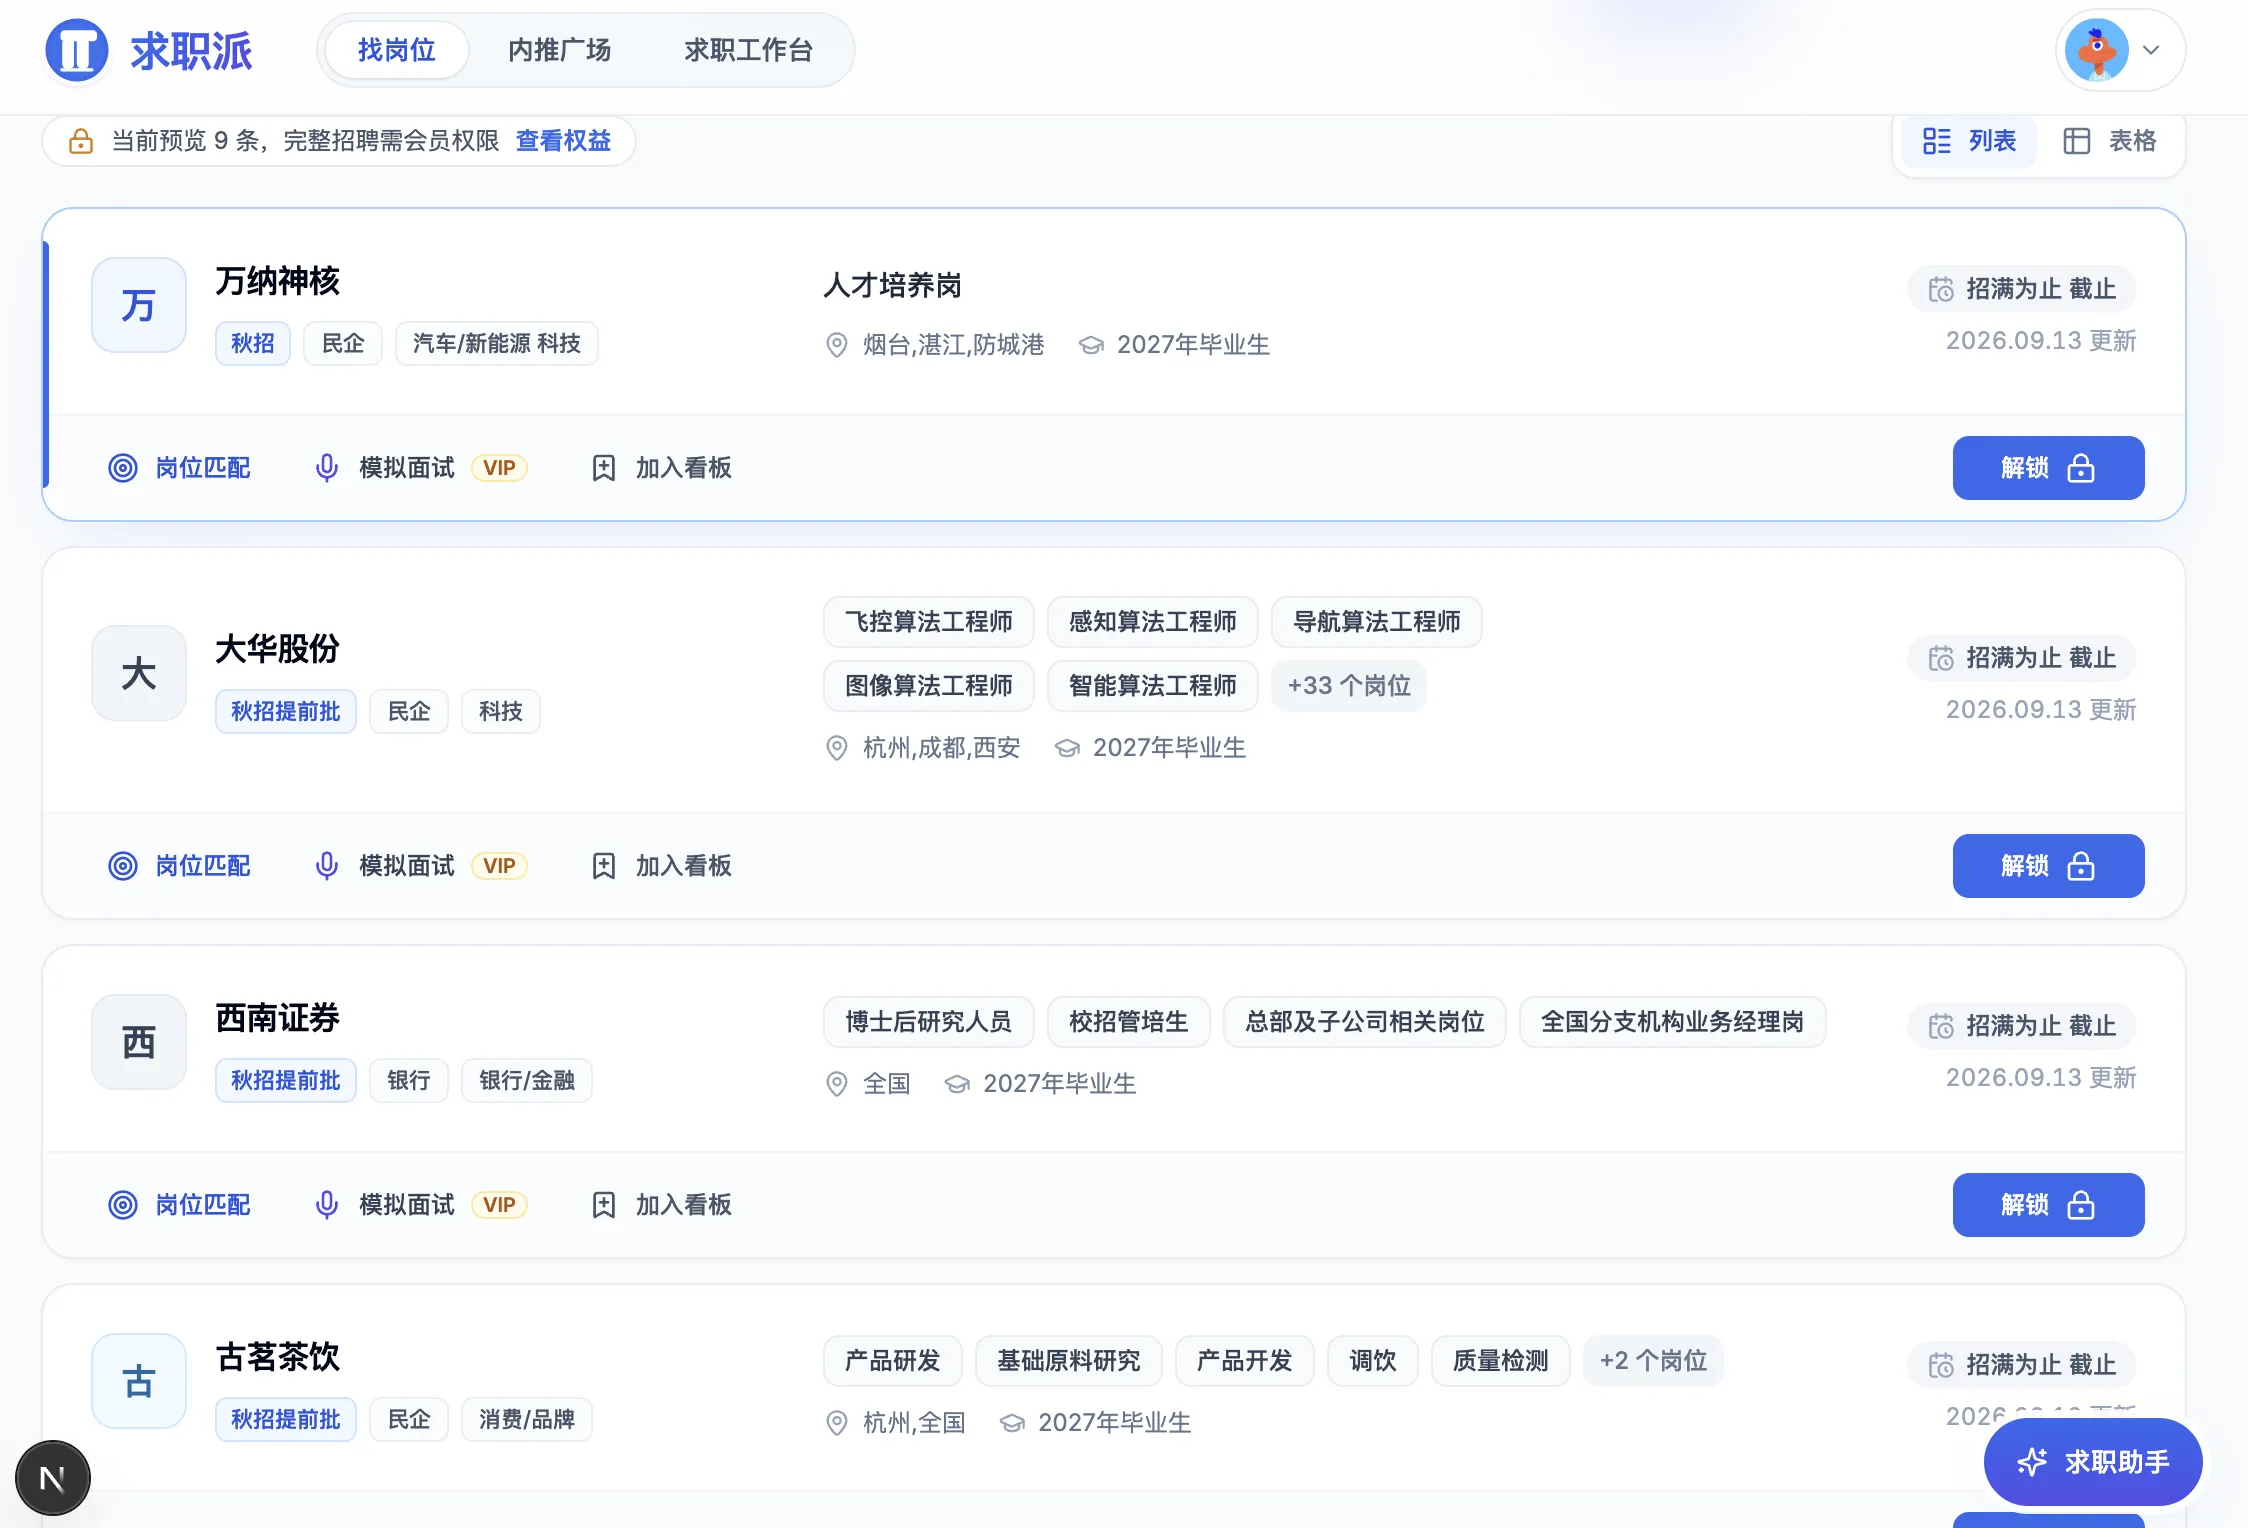
第一版跑通了基础的岗位提取和 MCP。可随着 OpenClaw 这类能通过飞书和钉钉远程下达任务的 Computer Agent 大火,我干脆推倒重构了三次,打磨成了现在的 多租户 SaaS 平台。
星球的项目分工大致是这样子的:
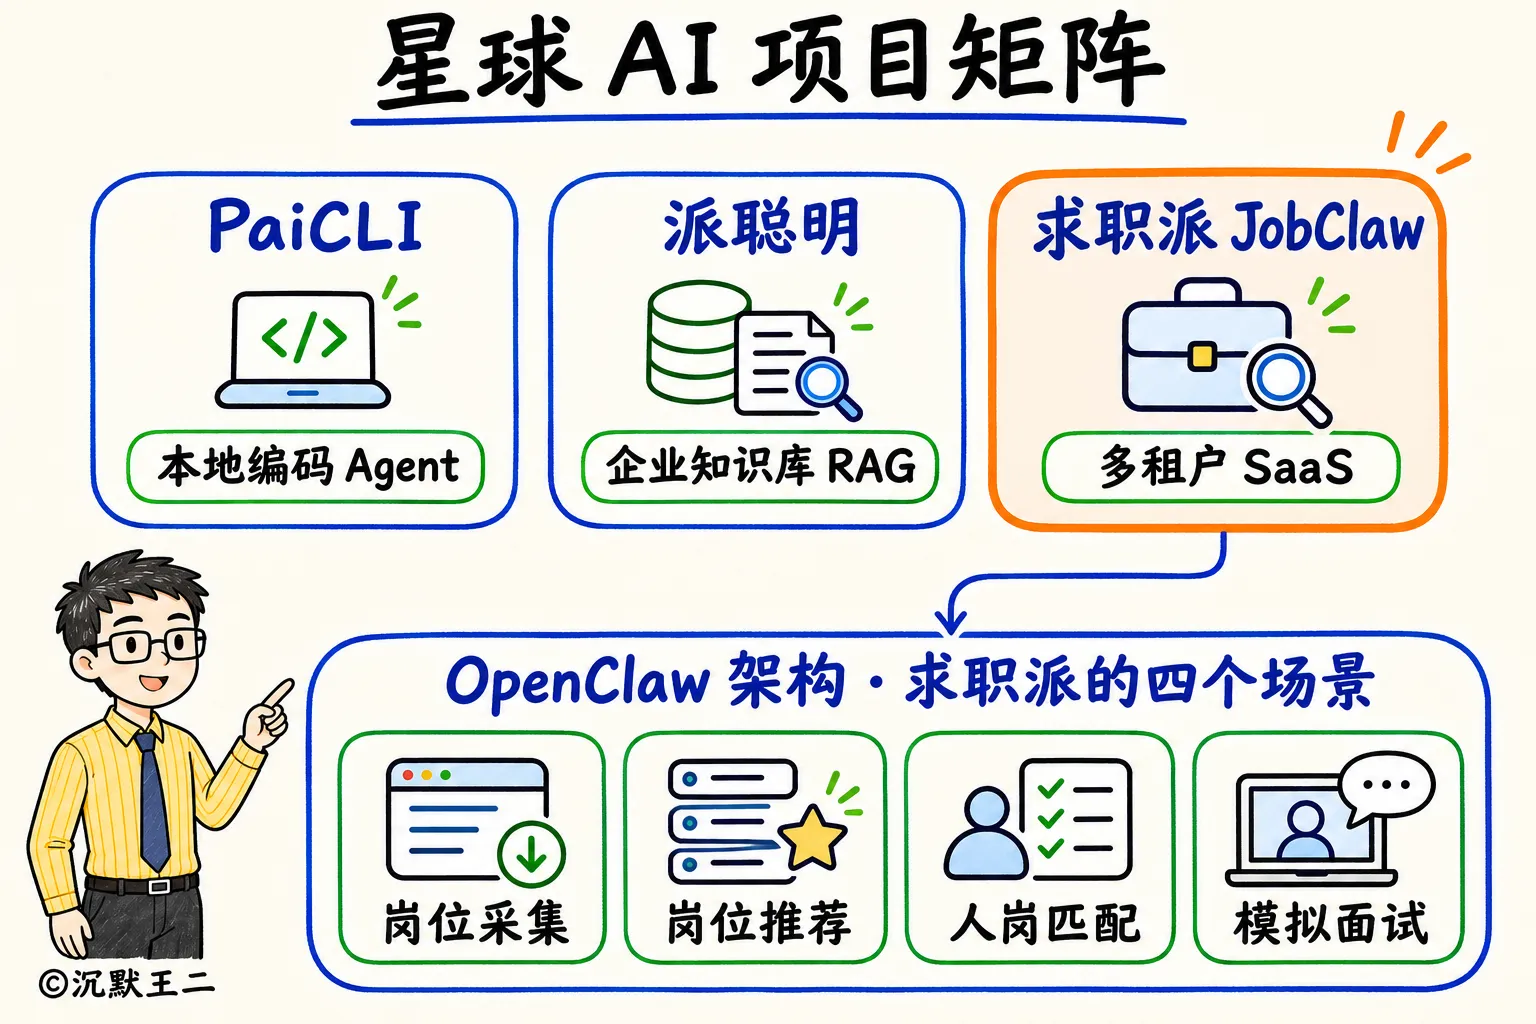
- **PaiCLI:**本地终端 Coding Agent,对标 Claude Code,提供了 ReAct、Multi-Agent、MCP、Memory 和上下文管理机制、Skill、沙箱、Checkpoint、评测集等知识点。
- 派聪明(PaiSmart):企业级 RAG 知识库,侧重 Apache Tika、Kafka、MinIO 与 Elasticsearch,以及混合检索、评测集等。
- 求职派(JobClaw):IM Gateway、多租户 SaaS、意图识别、Harness(Context Engineering、工具裁剪、Agent Loop、安全围栏)、LangGraph4J、Spring AI、Spring Modulith、Apache Lucene、Webhook、GenAI 可观测。
二、求职派的技术栈与模块划分
先看求职派的后端技术栈:
- 语言与核心框架:
Java 21+Spring Boot 4.0.5+ Maven 多模块 - AI 与智能体编排:
Spring AI 2.0.0-M4+LangGraph4J 1.6.0-rc4 - 模块化架构治理:
Spring Modulith 2.0.3+ Jackson 3 - 数据库:
MySQL 8.0+Spring Data JPA+Liquibase - 混合检索:嵌入式持久化
Apache Lucene 9.12.3(自定义二元分词 + 加权 BM25 + HNSW 向量 + RRF 融合 + 双模 Rerank) - 多端 IM Gateway:微信 ClawBot + 钉钉 Stream 长连接 + 飞书机器人 + WebSocket 全双工流式通道
- 工具与采集:MCP Server + MCP Client + Playwright 无头浏览器(含 SSRF 防护)
- 商业计费与并发控制:微信支付 V3 + JPA
@Version乐观锁 + Guava 分段锁 - 调度、可观测与评测:
JobRunr 8.5.1持久化调度 +TransmittableThreadLocal+ Micrometer GenAI 追踪 +100题离线基准评测集
再看一眼后端的多模块结构,一共划分为六大块,职责一目了然。
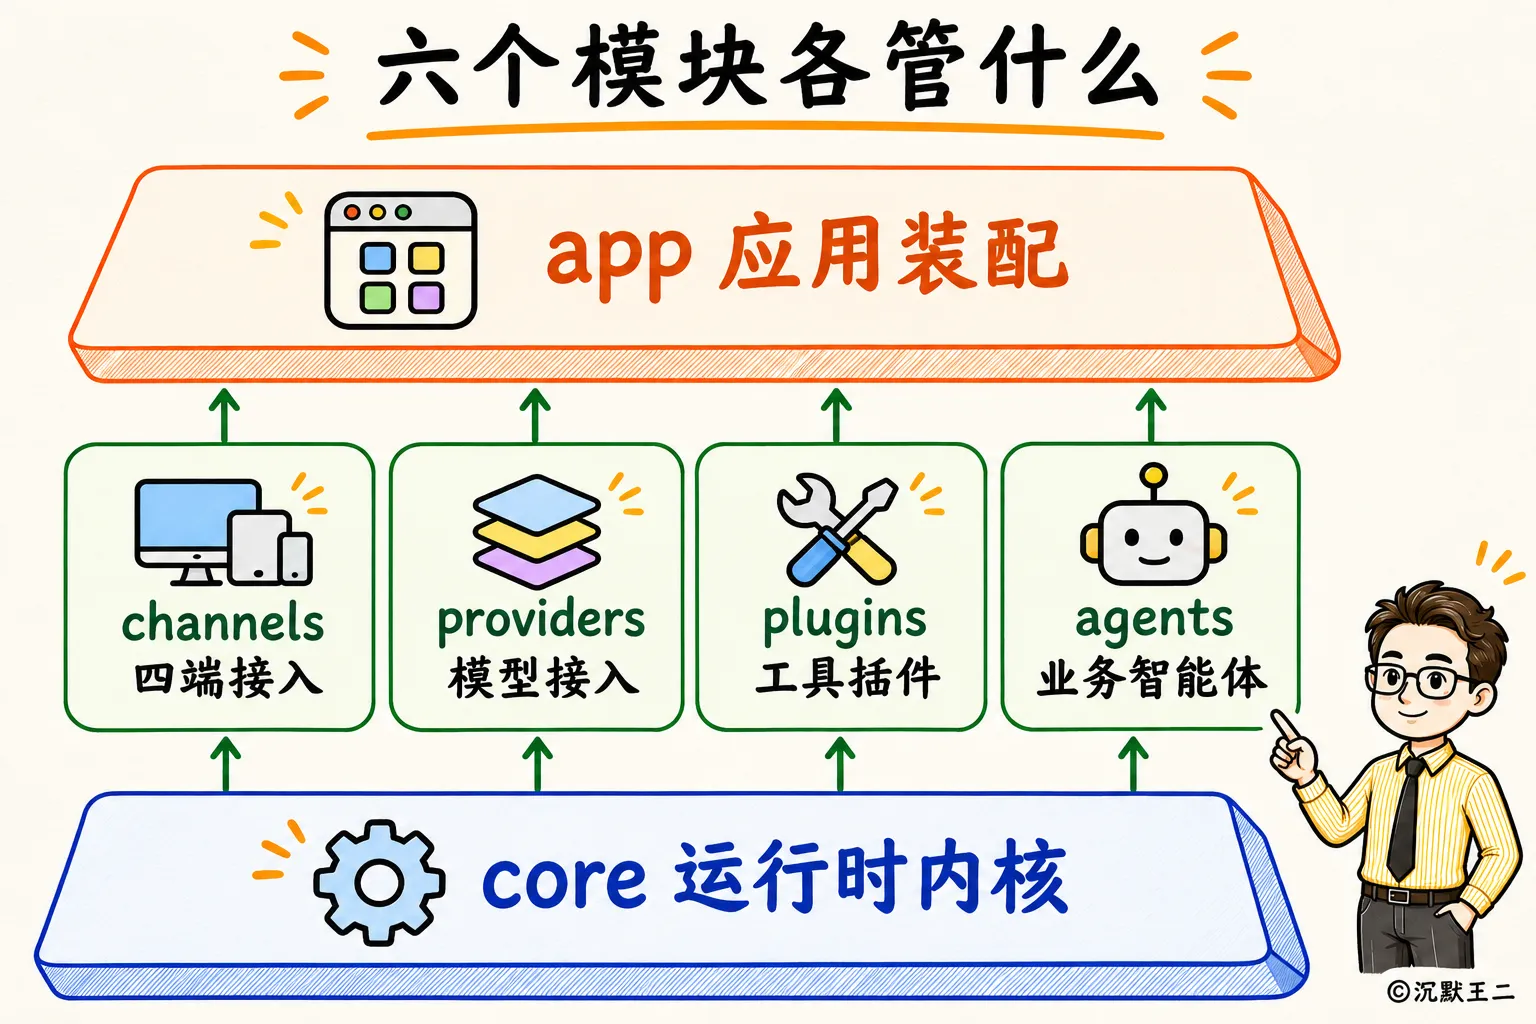
JobClaw/
├── core/                  # 运行时内核即 Harness(通道契约、事件总线、三级意图路由、流式Agent Loop、双层护栏、上下文预算、配额SPI、MCP Client运行时工具配置)
├── channels/              # 多端IM网关层(wechat-clawbot / dingding / feishu / websocket 四个独立子模块)
├── providers/             # 大模型供应层即 Model(OpenAI / Gemini / Anthropic 三类兼容协议,各为独立子模块)
├── plugins/               # 工具插件层(job-library Lucene9混合检索 / playwright并发池 / plan-notebook计划笔记)
├── agents/                # 业务智能体层(identity画像 / job-fetch抓取 / job-recommend推荐 / job-match诊断 / mock-interview面试)
└── app/                   # 商业应用装配层(LangGraph4J断点审批、微信支付V3与配额流水、投递看板、MCP Server+Client主体、100题评测套件)
三、求职派的技术架构
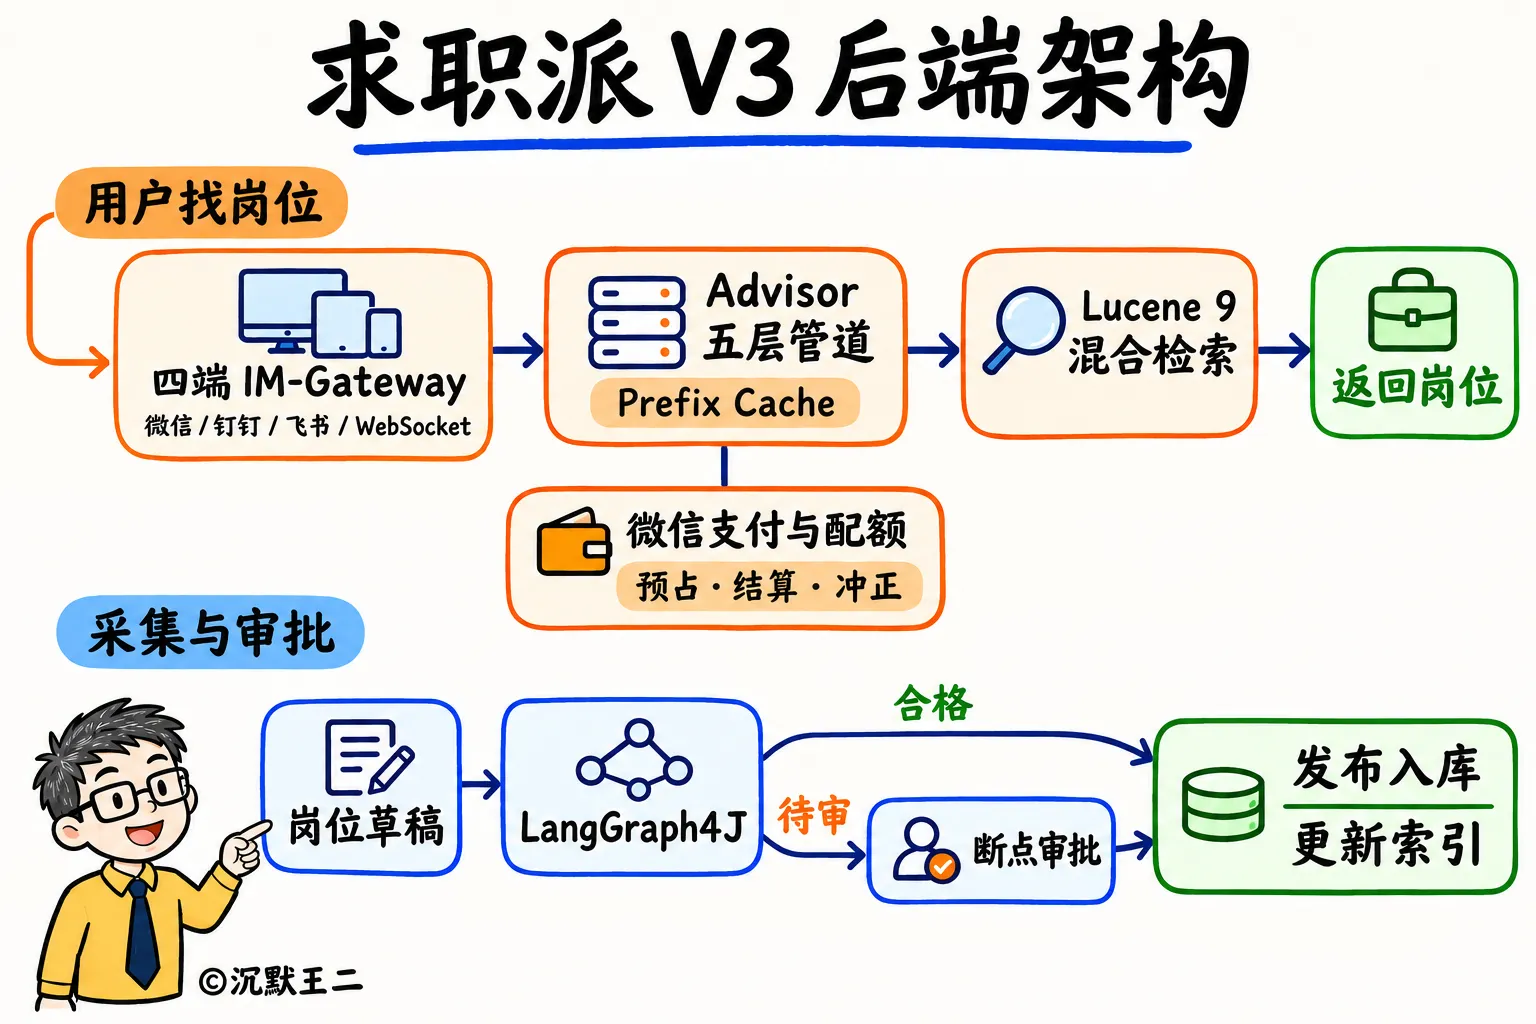
为了方便大家建立起全局视野,我们顺着“用户交互”和“岗位采集审批”两条主线,把后端架构串起来走一遍。
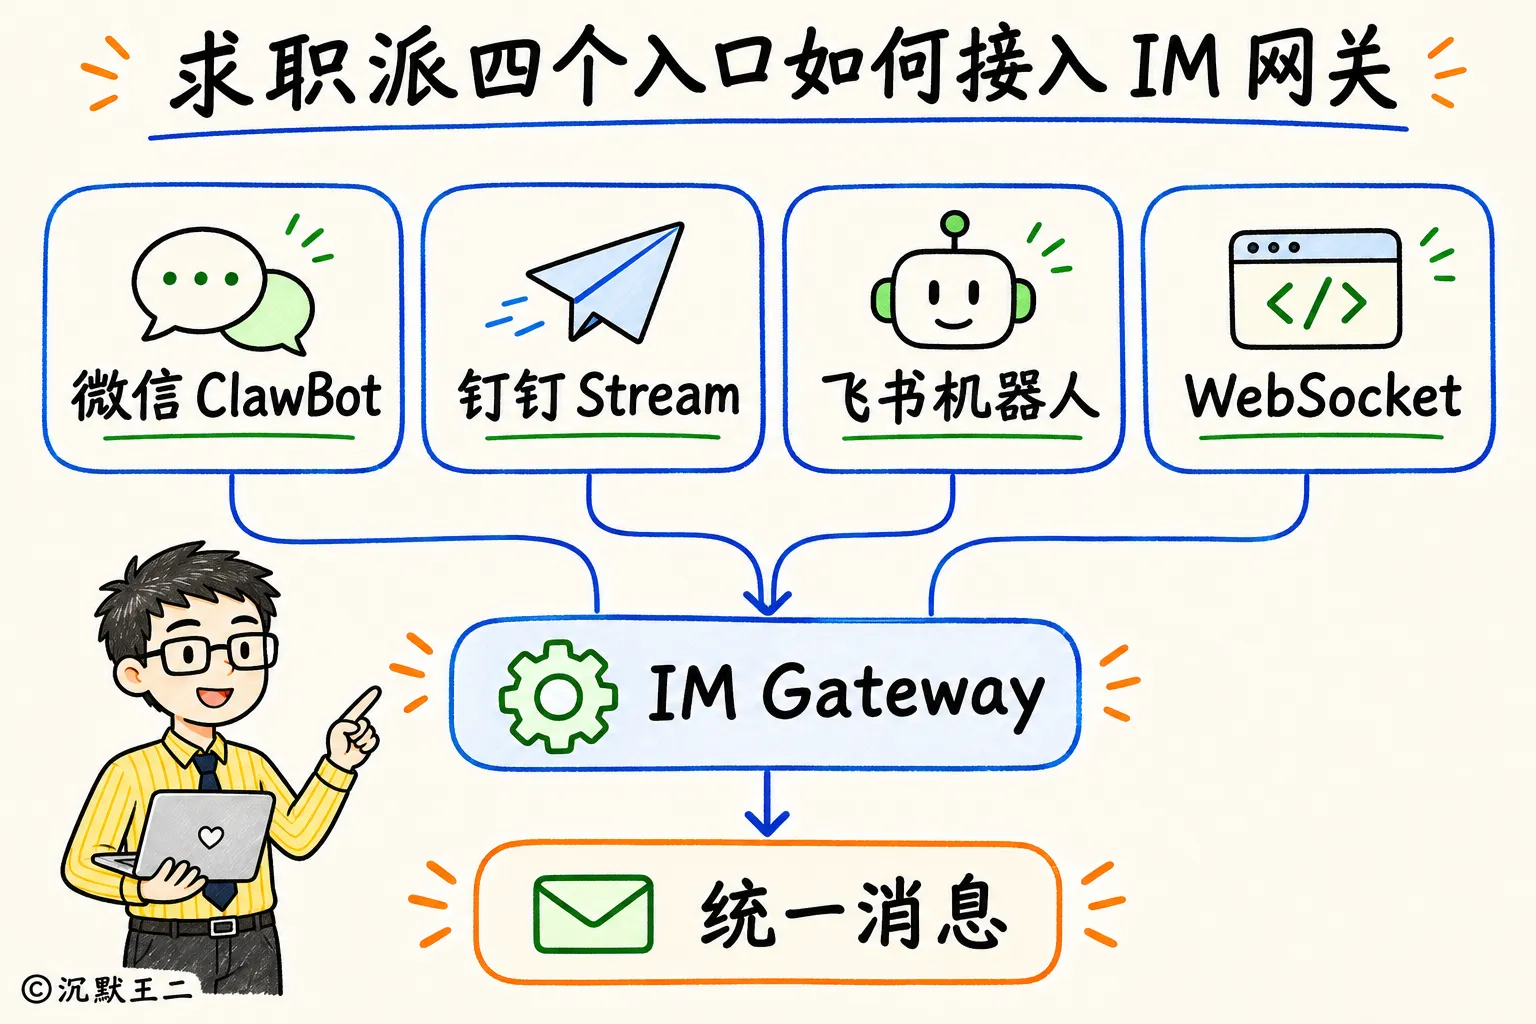
先看用户交互这条线。
当求职者在微信 ClawBot、钉钉、飞书或者 Web 端求职助手下达任务时,请求先进入 IM Gateway 层。
IM 平台在网络抖动时可能会重复推送 Webhook 事件,那我们的通道在入口处就先用基于缓存的 msgId 幂等拦截器拦截掉重复的报文,再转成内部消息投递到事件总线。
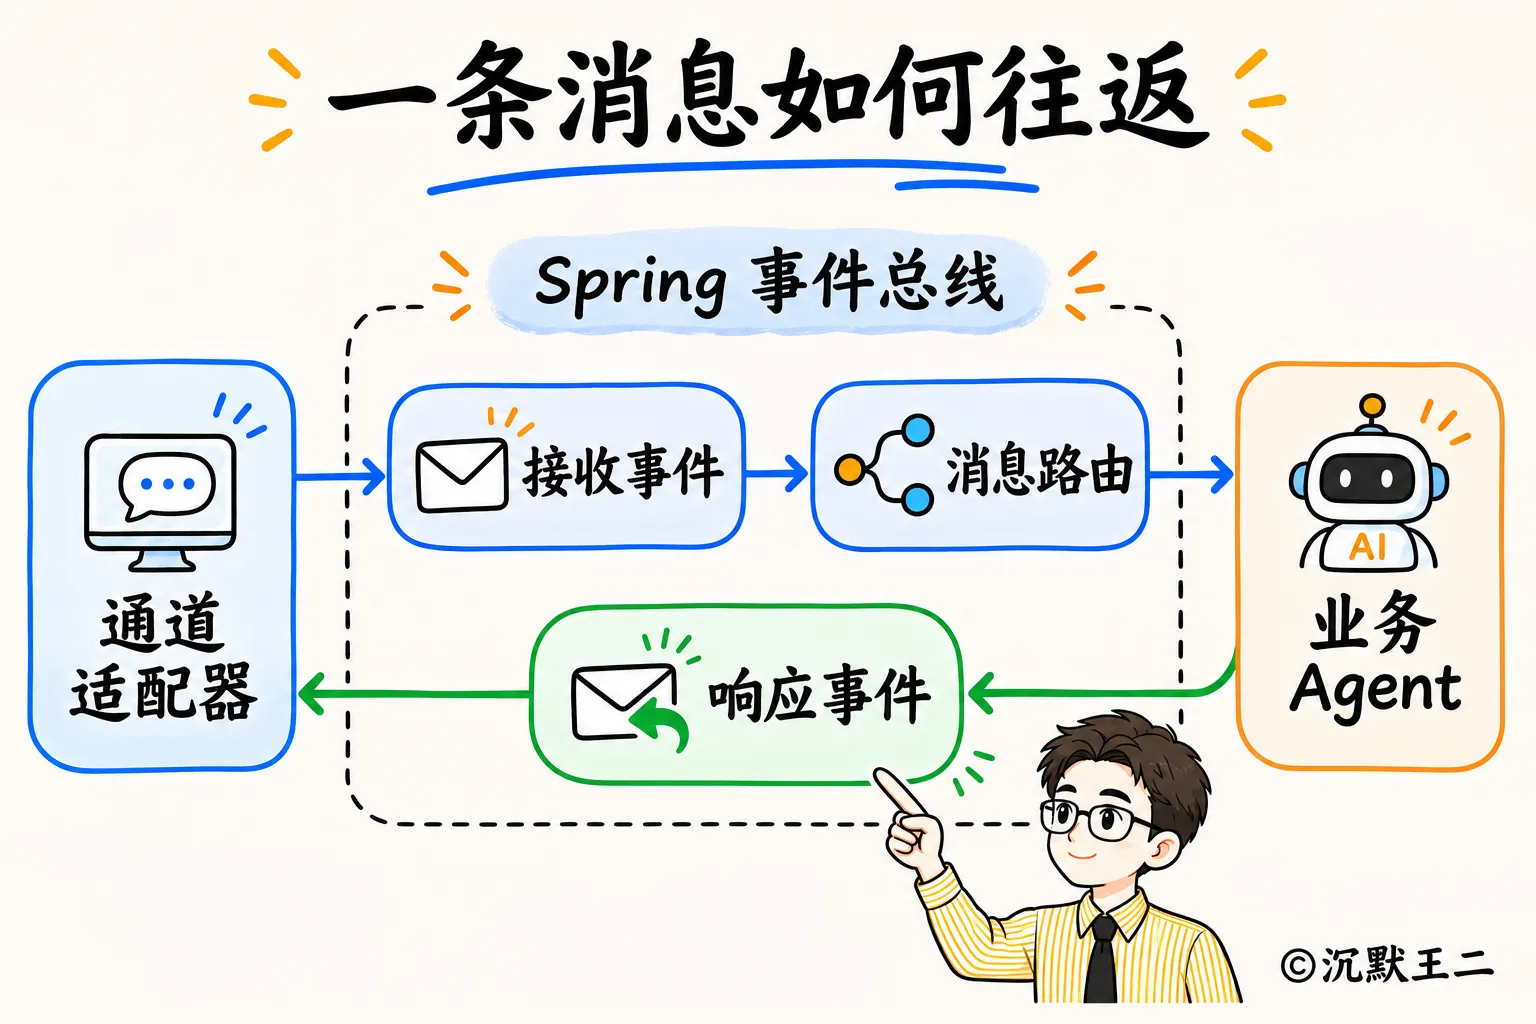
消息路由器拿到任务后,先检查用户的 Soul、Identity、Info 画像是否完整。如果画像缺失,会先唤醒身份采集 Agent 补齐背景。
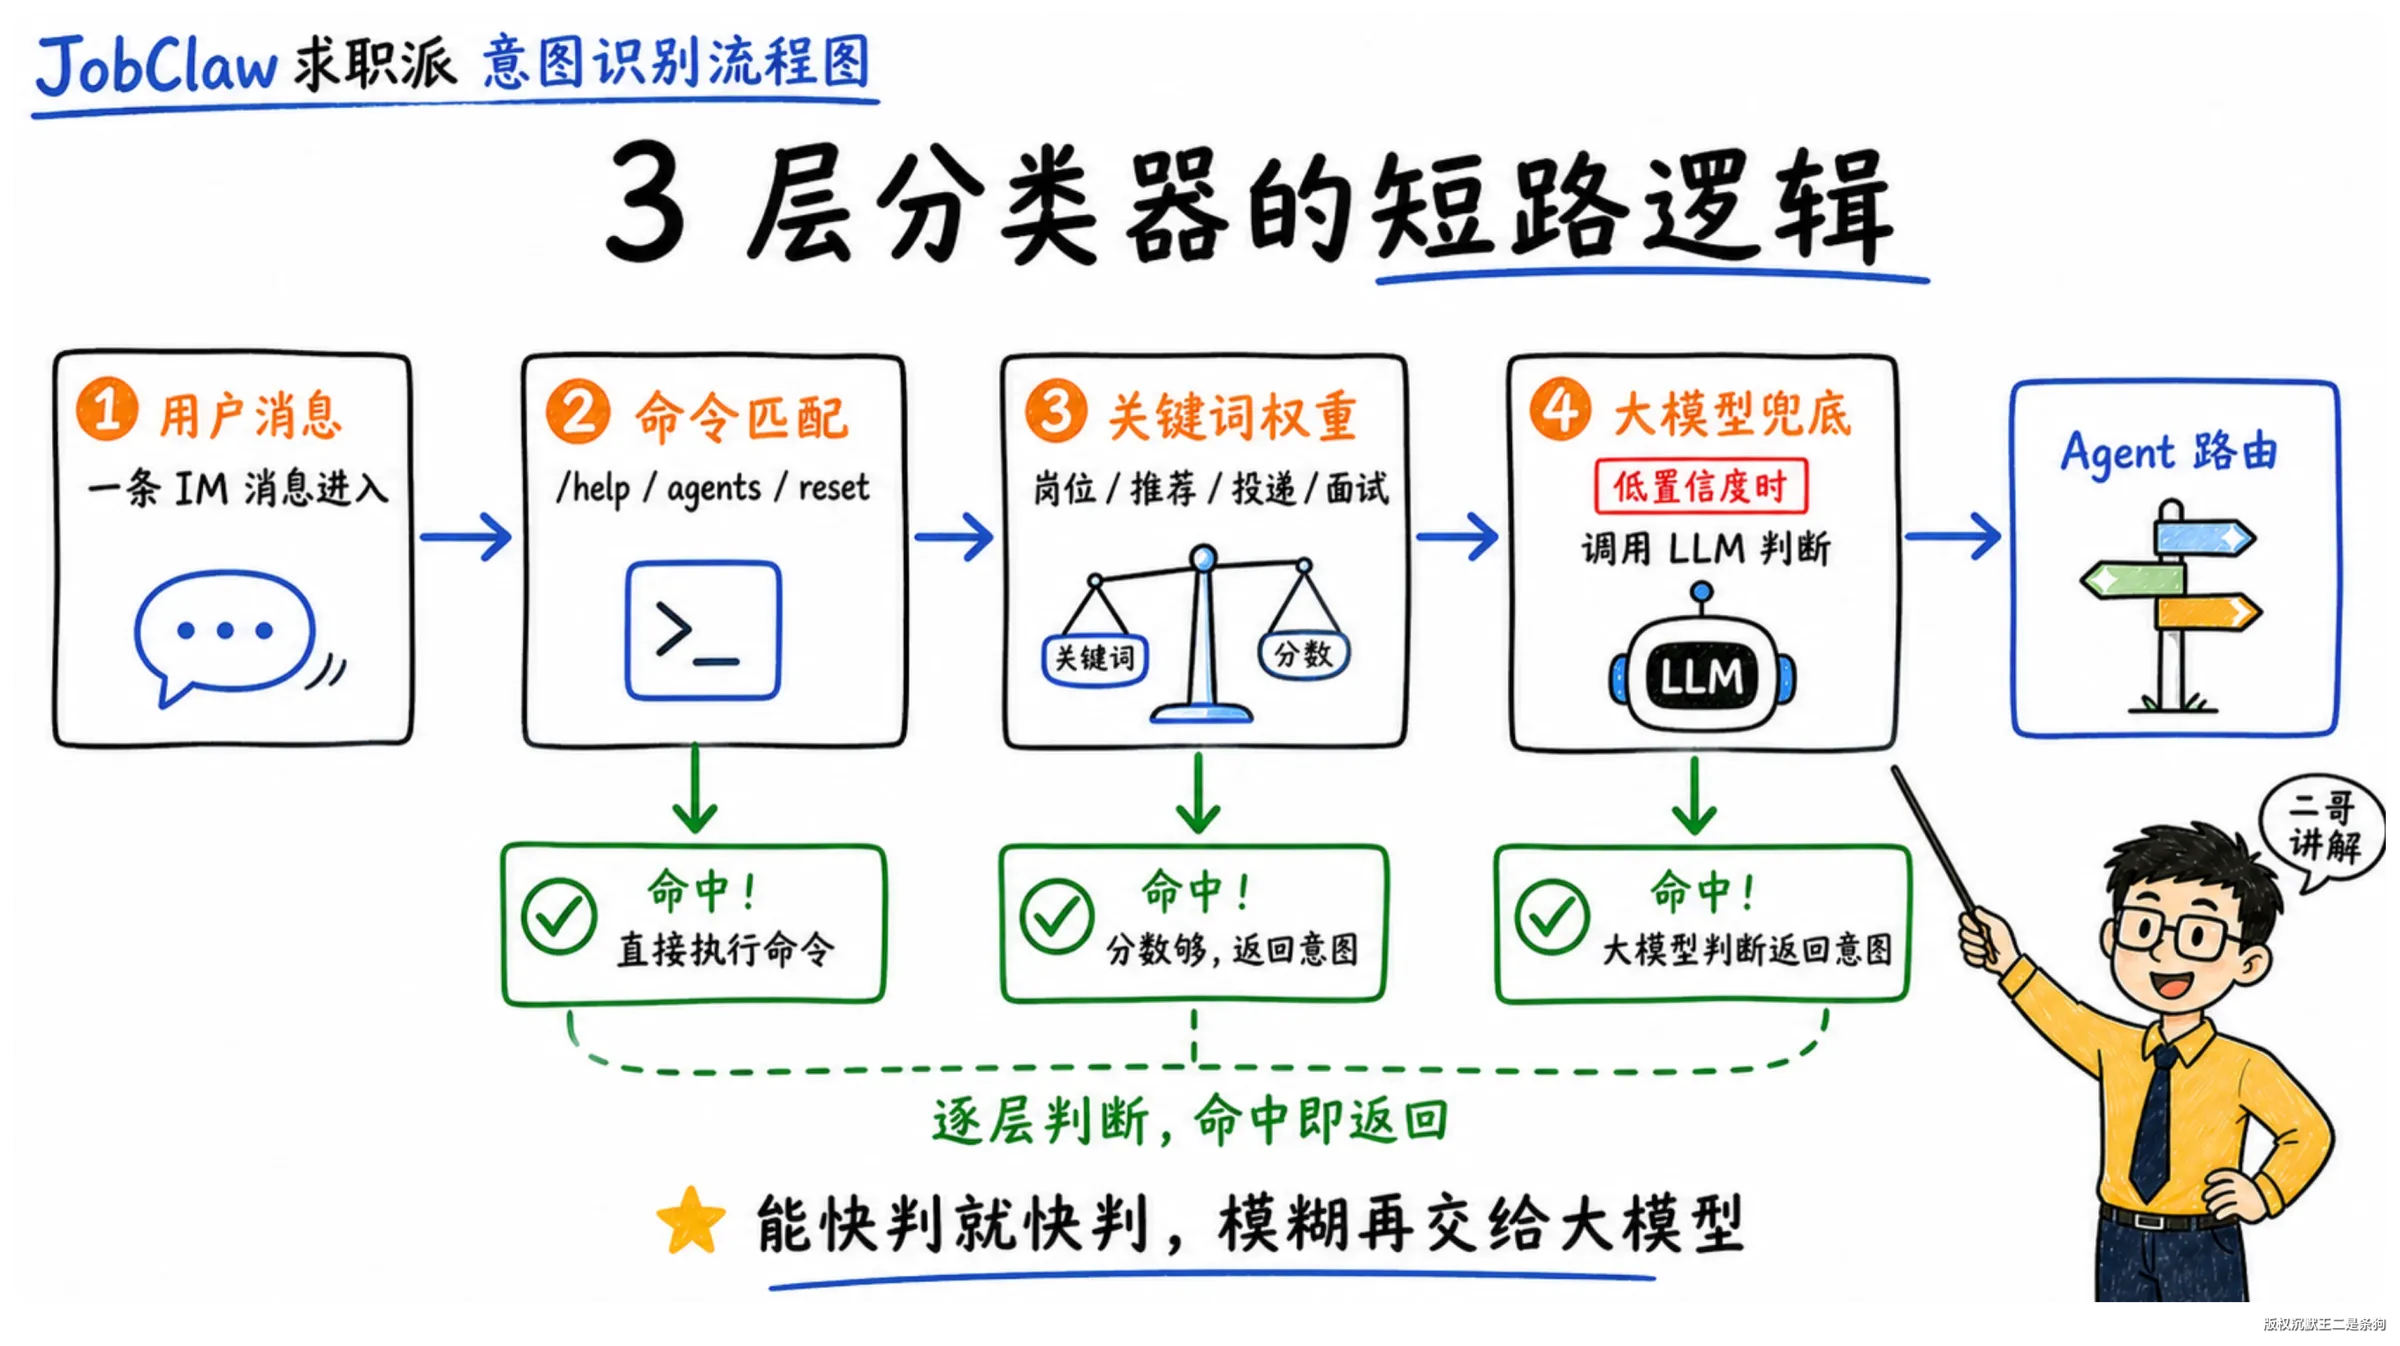
接着请求进入意图分类(系统快捷命令 → 关键词权重 → 大模型兜底),并在路由前校验目标是 VIP 还是管理员权限。
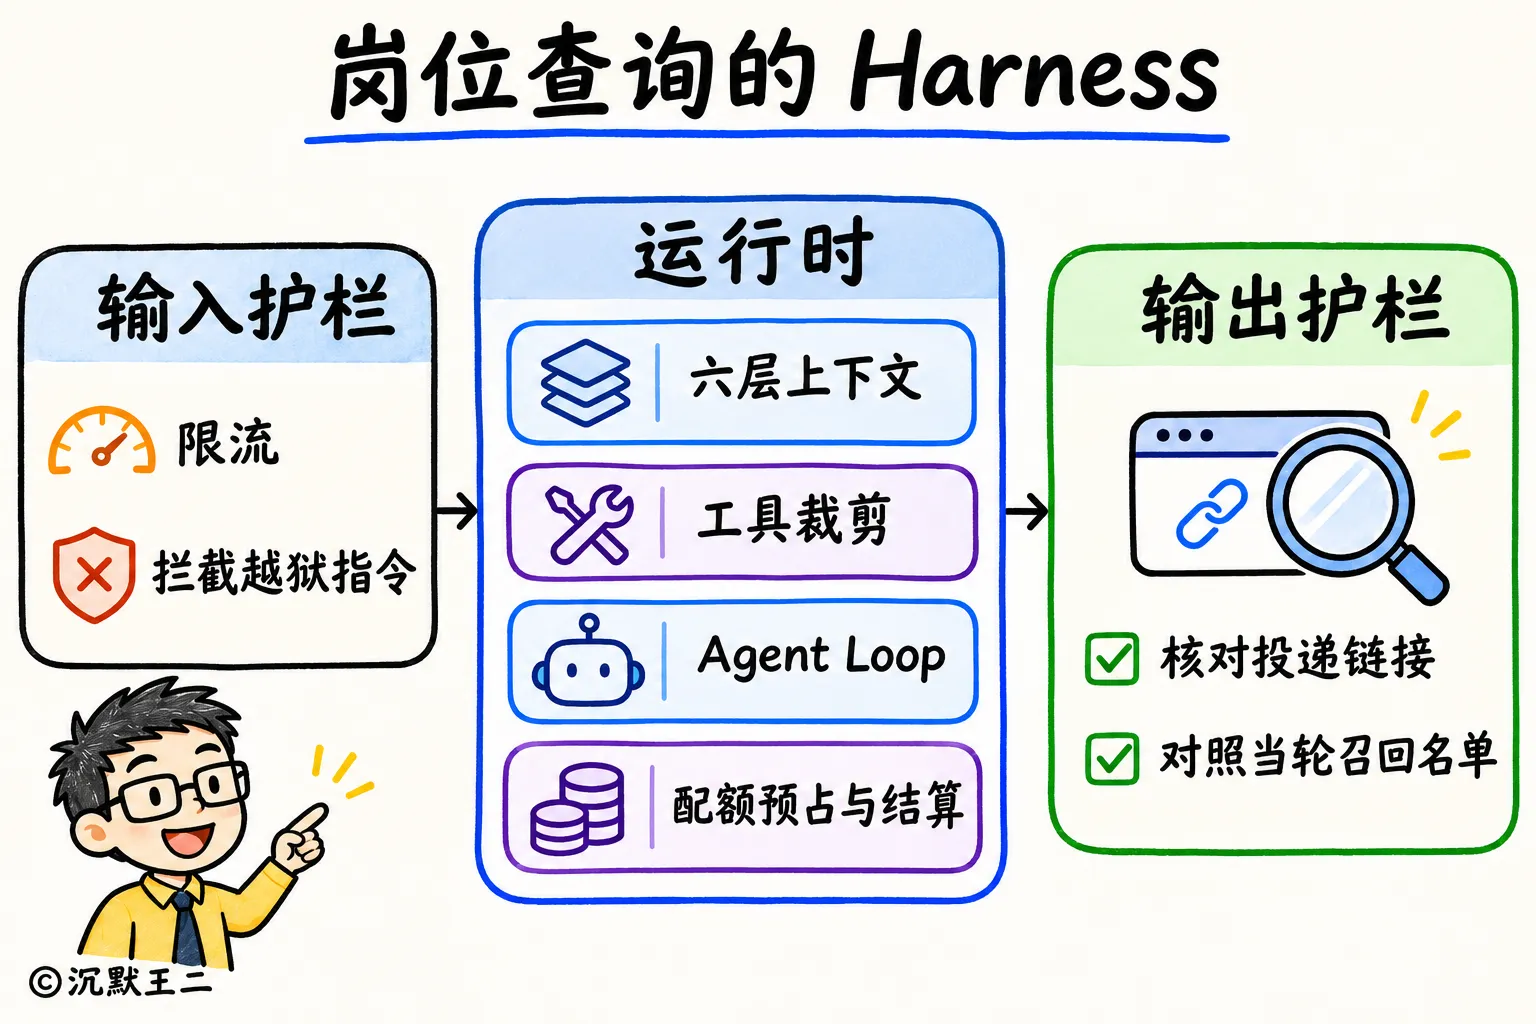
按 Agent = Harness + Model 的说法,模型之外负责组织上下文、调度工具、兜住安全的这一整套运行时都属于 Harness。进入大模型管道后,请求依次要穿过 Harness 的五道核心组件:
- 安全围栏:用户级滑动窗口进行限流、拦截越狱的指令,并用
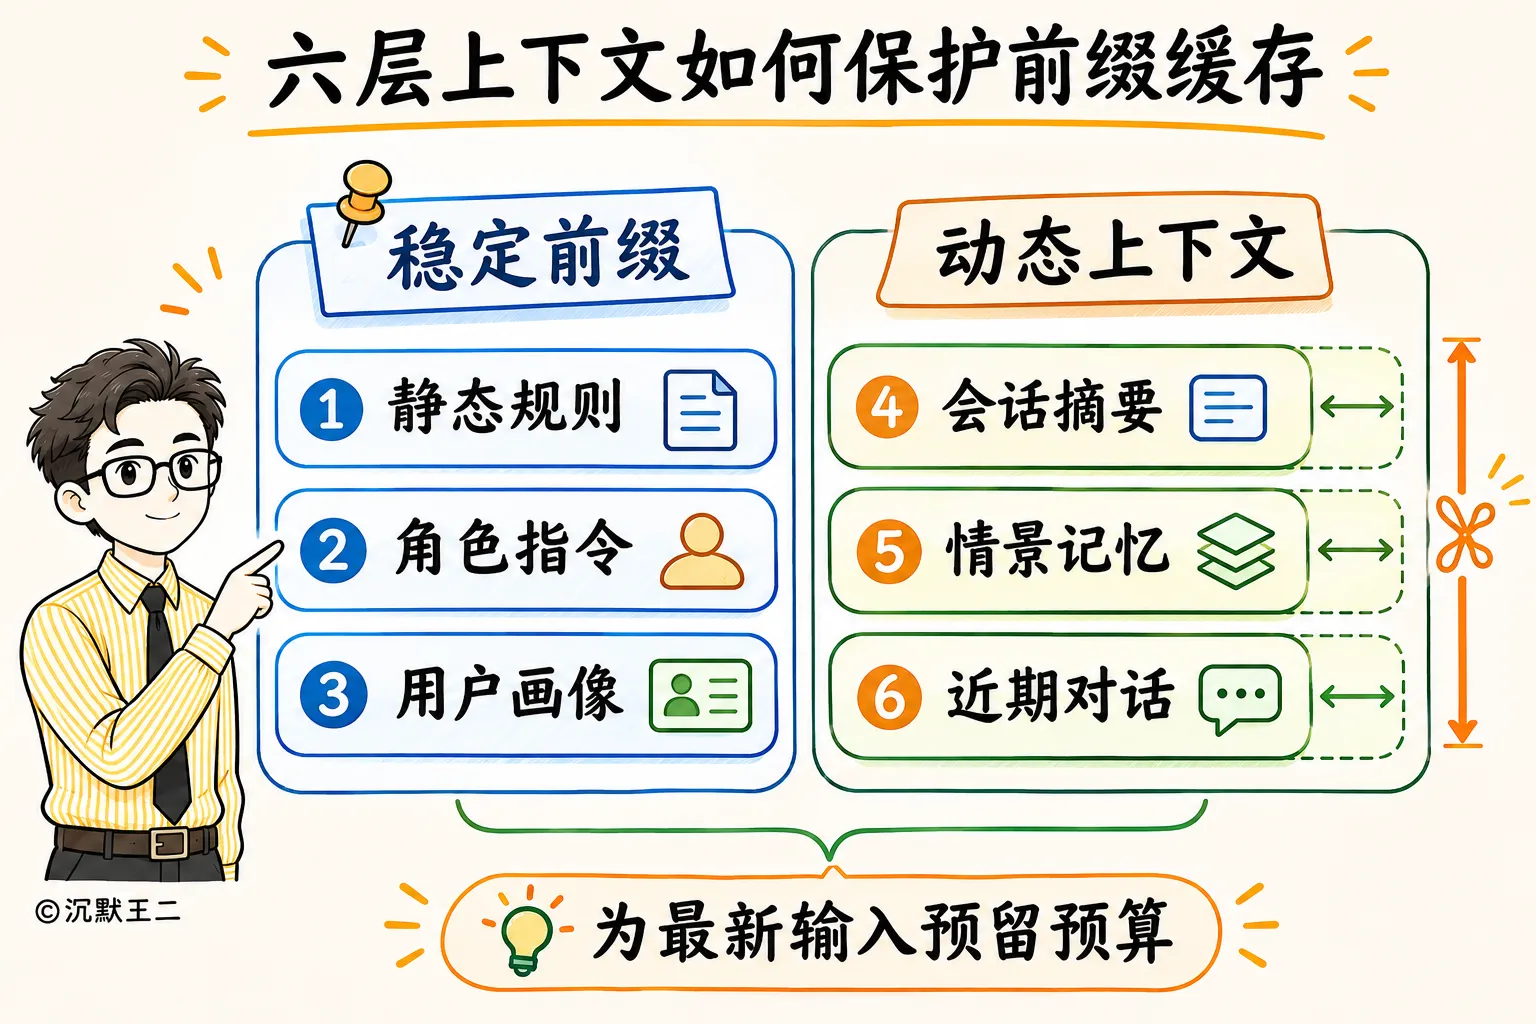
<untrusted_content>标签包裹外部的岗位采集信息防止提示词注入。 - 上下文预算:按稳定度从高到低排列静态规则、角色指令、用户画像(Soul / Identity / Info)、会话摘要、情景记忆与近期对话这六层,保护稳定的前缀缓存。
- Lucene 动态工具裁剪:候选工具超阈值时,按当轮提示词检出最相关的 topK 工具 Schema,帮模型减负省 Token。
- Agent Loop(ReAct)与配额守卫:启动乐观锁预占额度,用
Flux.publish一边流式输出一边缓冲多步工具调用,结束后按实际的消耗多退少补。 - 减少幻觉:拿回复里的投递链接去比对当轮工具里登记在
ToolContext里的真实召回名单,拦截模型编造的假链接。
比如求职者搜岗位时,后端把请求交给 Lucene 9 混合检索引擎,告别数据库模糊查询。看 HybridJobSearchEngine 这段核心代码就能明白。
// plugins/job-library/.../HybridJobSearchEngine.java:318-369
// 1. 稀疏 BM25 召回(叠加城市、薪资区间等硬过滤)
TopDocs bm25TopDocs = searcher.search(sparseBuilder.build(), poolSize);

// 2. 可选 HNSW 稠密向量召回(向量不可用时优雅降级为纯 BM25)
Query knnQuery = hardFilter != null
        ? new KnnFloatVectorQuery(F_EMBEDDING, queryVec, poolSize, hardFilter)
        : new KnnFloatVectorQuery(F_EMBEDDING, queryVec, poolSize);
TopDocs vecTopDocs = searcher.search(knnQuery, poolSize);

// 3. RRF(k=60)无量纲融合 + 双模 Rerank 精排
List<ReciprocalRankFusion.FusedHit> fused = ReciprocalRankFusion.fuse(
        bm25Hits, vectorHits, ReciprocalRankFusion.DEFAULT_K);
List<ScoredJob> reranked = jobReranker.rerank(query, candidates, query.topN());
不用额外部署搜索引擎,单靠 Lucene 索引,就能把条件过滤、BM25 加权、HNSW 向量、RRF 融合和 Rerank 精排全跑通。
再看岗位采集审批。后台用 Playwright 无头浏览器池(无痕上下文隔离、信号量限流)抓取招聘信息,遇到超长内容触发大模型输出截断(finishReason=length)时,会自动拆分重试。
提取完草稿后,任务进入 LangGraph4J 工作流。清洗节点会解析出月薪的上下限、学历和技术标签,并给出 0 到 100 的置信度评分。
80 分及以上且带有效投递链接的批次自动发布入库并增量刷新 Lucene 索引;低于 80 分或缺失链接的草稿,会在审批门禁前通过 MySQL 持久化到 Checkpoint 非阻塞挂起。
等管理员在后台修订批准后,状态图从断点处恢复执行并入库,最后由 JobRunr 增量订阅雷达,跨 IM 通道推送给匹配的求职者。
四、如何给面试官介绍求职派
很多同学学完项目,面试官一句“挑一个你最有代表性的项目讲讲”,上来就容易像报菜名一样背技术栈。这里我先给大家备好一套顺口、有重点的回答模板。
问题:请介绍一下求职派项目?
回答示例:
求职派是一个面向求职场景的多租户 Agent SaaS 平台,整体参考了 OpenClaw 的 Gateway + Agent Runtime 架构。
技术架构上,后端基于 Java 21、Spring Boot 4、Spring AI 2.0 和 LangGraph4J 构建,我们用 Spring Modulith 来治理六大模块,整体按 Agent = Harness + Model 来拆:channels 模块是 IM 的 Gateway,负责接入微信 ClawBot、钉钉 Stream、飞书和 Web 端求职助手的 WebSocket;core 是 Agent Runtime 内核,也就是 Harness,负责意图识别、Context Engineering、工具裁剪、Agent Loop 和安全围栏,同时承担 MCP Client 侧的运行时工具配置;providers 是 Model 层的接入,通过 SPI 接入 OpenAI、Gemini 和 Anthropic 三类兼容协议;plugins 提供 Lucene 9 混合检索和 Playwright 采集;agents 是业务 Agent 层,有画像采集、岗位抓取、模拟面试等;app 负责 LangGraph4J 工作流、微信支付、配额计费,以及 MCP Server 和 Client 的主体装配。
业务视图上,有两条主线。用户侧,求职者在任意 IM 里发一句话,请求经过 Gateway 去重、意图识别后,路由到画像采集、岗位抓取、岗位推荐、匹配度诊断和 VIP 模拟面试五个业务 Agent。admin 侧,通过 Playwright 抓取招聘信息,通过调用大模型 API 清洗出结构化岗位,再通过 LangGraph4J 的 Human-in-the-Loop 审批入库,增量刷新 Lucene 索引,最后由 JobRunr 跨 IM 通道推送给匹配的求职者。
具体解决的问题,有五个。
第一,网关可靠性。IM 平台的 Webhook 可能会重复推送,Gateway 在入口按 msgId 做幂等,再经事件总线解耦;意图识别走「快捷命令 → 关键词权重 → LLM 兜底」三级路由,规则能判断的就不调用模型。多租户的画像和会话文件用分段锁加临时文件原子替换,避免并发写入互相覆盖。
第二,Harness 里的 Context Engineering 和 Prefix Cache 优化。上下文按稳定度分成了六层:静态规则、角色指令、用户画像放在 System Prompt 的前面,会话摘要、情景记忆和近期对话放在后面按 Token 预算裁剪,让前缀尽量命中 Prefix Cache。工具多了以后,再用 Lucene 按当轮问题做动态工具裁剪,只把 topK 个 Tool Schema 交给模型。
第三,Harness 里的安全围栏。外部岗位的数据用 <untrusted_content> 标签隔离,防止提示词注入攻击(Prompt Injection);投递链接要和 ToolContext 里登记的真实召回名单比对,不用额外调用模型就能拦截可能是幻觉的链接;Playwright 采集做了 DNS 校验和 route 钩子,防止 SSRF。
第四,SaaS 计费。一次 Agent Loop 可能跑多轮工具调用,不能长时间占用事务,所以借鉴 TCC 拆成了预占、结算、释放三个阶段,用 JPA 的 @Version 乐观锁加短事务防止额度超扣,并利用唯一索引保证支付回调的幂等性。
第五,GenAI 可观测。一次请求会跨 Servlet、@Async、Reactor 和 JobRunr 四种线程,用 TransmittableThreadLocal 透传 Trace 上下文,并通过 Micrometer 的统一观测组件(ObservationRegistry),按照 OpenTelemetry 的 AI 监控规范(gen_ai.*)采集 LLM 和工具的运行数据。这样不仅能统计 Token 的消耗,还能把 Agent 从接收指令、思考决策到调用工具的每一步串联起来,方便排查。后台监控总览用 JPQL 投影把统计下推到 MySQL 聚合,避免大表进内存导致 OOM。
量化效果上,我们建了一套 100 题的离线评测集,覆盖意图识别、信息抽取、检索和护栏四个维度。混合检索用 BM25 加 HNSW 双路召回、RRF 融合再 Rerank,相比单路关键字检索,Recall@10 从 79.17% 提升到 100%,NDCG@10 从 75.15% 提升到 98.52%。数据侧,清洗置信度 80 分及以上且链接有效的岗位自动入库,其余进入人工审批,保证正式库里没有脏数据。
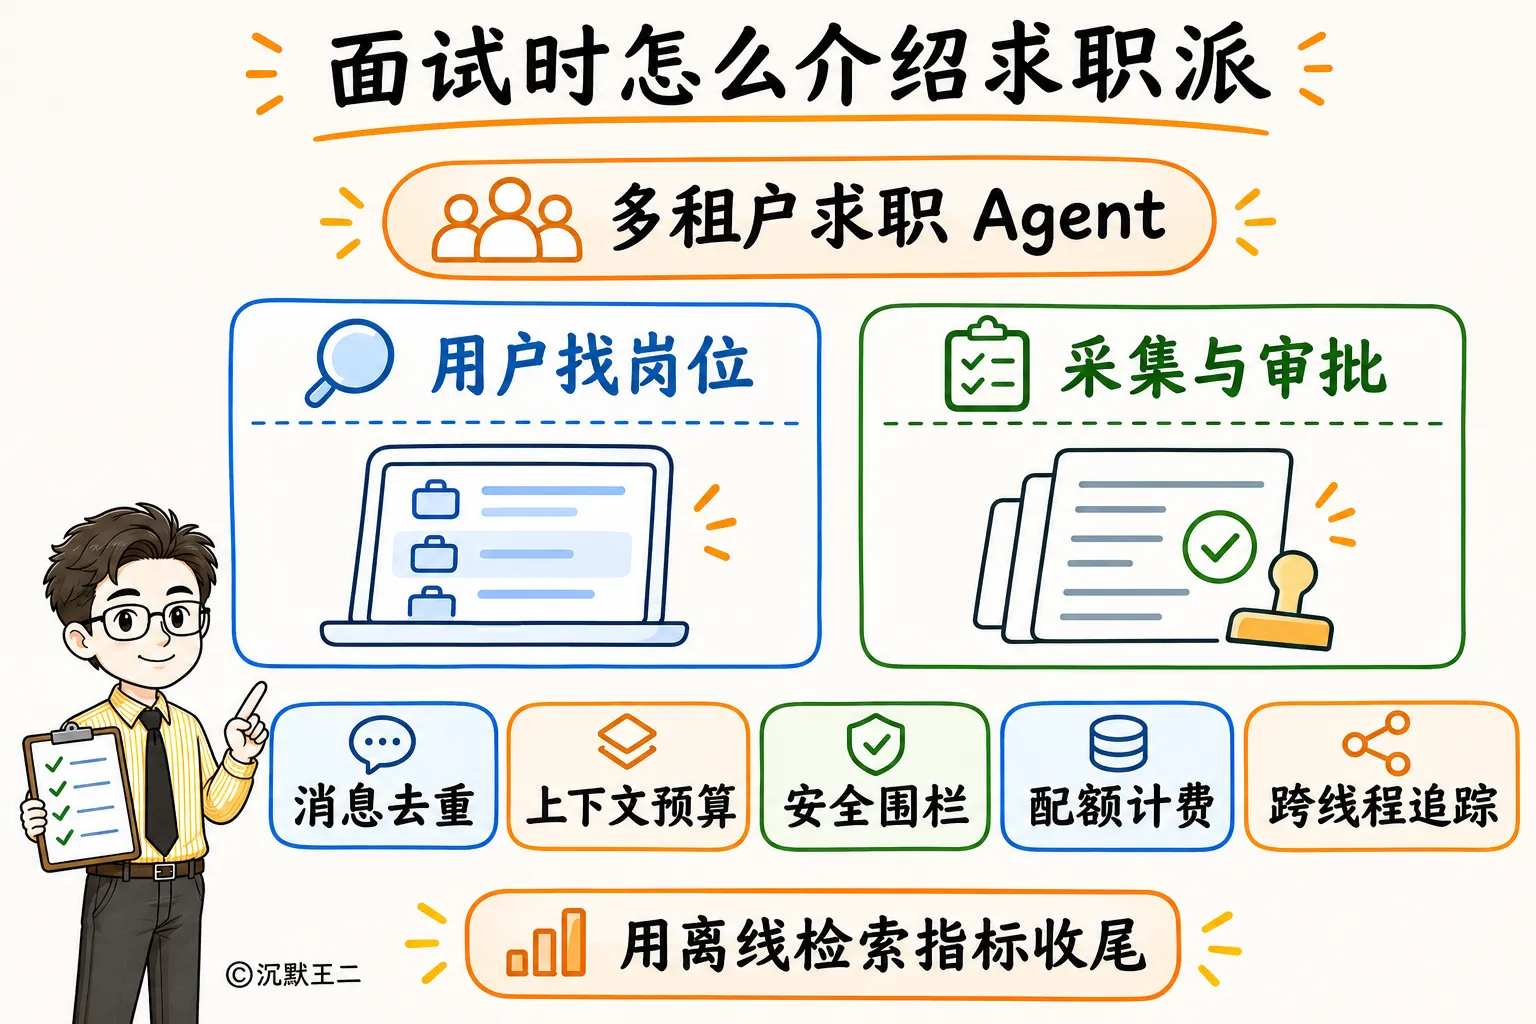
如果面试官对其中某一点感兴趣,接着追问“这块在工程上具体是怎么做的?”,可以顺着下面对应的小节继续深入:01 到 05 对应模板里的五个问题,06 对应量化效果。
01、IM Gateway 幂等与三级意图识别
微信、钉钉、飞书和 Web 的 Webhook 消息在 Gateway 入口按 msgId 幂等去重,再经事件总线解耦。意图识别走「快捷命令 → 关键词权重 → LLM 兜底」三级路由,规则能判断的就不调模型。多租户的用户画像和会话文件采用分段锁配合临时文件原子替换,避免并发写入互相覆盖。
02、Harness:Context Engineering 与 Prefix Cache
上下文预算按稳定度分层组装,静态规则、角色指令和用户画像固定在 System Prompt 前面,减少前缀变动,尽量命中 Prefix Cache;会话摘要、情景记忆和近期对话放在后面,超预算时按比例裁剪并生成摘要。调用模型前还挂载了 Lucene 动态工具裁剪,只带当轮最相关的 topK 个 Tool Schema。
03、Harness:安全围栏
入口先做用户级滑动窗口限流和越狱指令拦截。外部采集的岗位信息用 <untrusted_content> 标签隔离,防止间接 Prompt Injection。模型回复里的投递链接要和当轮工具在 ToolContext 里登记的真实召回名单比对,不额外调用模型就能拦下幻觉链接。Playwright 采集则用入口 DNS 校验加 route("**/*") 请求钩子两道防线防 SSRF。
04、SaaS 配额计费与 TCC 三阶段
多步工具调用的耗时比较长,不能一直占着数据库事务。我们借鉴了 TCC 的思路,把扣费拆分成了预占、结算、释放三个阶段:调用前先预占额度,结束后按实际消耗多退少补,中途出现异常就把预占的额度全部退回。每个阶段都是乐观锁+短事务,并用 (biz_id, phase) 唯一索引保证幂等,支付重复回调时也不会出错。
05、跨线程追踪与 GenAI 可观测
一次 Agent 请求会先后经过 Servlet 线程、@Async 事件线程池、Reactor 响应式线程和 JobRunr 调度线程,普通 ThreadLocal 在切换线程时会丢失上下文,Trace 链路就断了。我们用 TransmittableThreadLocal 在线程池之间透传 Trace 上下文,再用 Micrometer 的 ObservationRegistry 记录 gen_ai.* 指标,让一次请求里的模型调用都挂在同一条链路上。后台监控总览则用 JPQL 投影把统计下推到 MySQL 聚合,只取回结果,避免把大表加载进内存导致 OOM。
06、混合检索与数据治理
搜索这边,不额外部署 Elasticsearch,直接用 Lucene 9 做薪资条件过滤、BM25 与 HNSW 向量双路召回、RRF 融合和 Rerank 精排。评测数据就是上面量化效果里的那组 Recall@10 和 NDCG@10。岗位采集这边,清洗置信度 80 分及以上且带有效链接的岗位自动入库,低于 80 分或缺失链接的草稿通过 LangGraph4J 持久化到 Checkpoint 并挂起,等人工审批通过再入库,防止脏数据污染正式库。
五、为什么要学习求职派
现在不管是秋招、春招还是社招,既懂 Java 后端、又懂 AI Agent 落地的候选人很吃香。
不少球友去面淘天、字节、腾讯、美团回来跟我反馈,面试官看到简历上有 Agent 网关、上下文管理、混合检索和 Token 配额计费,面试就会顺利很多,冷门的八股都少问了一大半。
而且这次我们把求职派的教程浓缩成了 20 篇,砍掉了前端部分,把重心全部放在了后端架构和源码上。每天看一篇,两三周就能吃透。
来看看这 20 篇教程的目录:
| 篇序 | 所属篇章 | 教程标题 | 对标派聪明篇章 |
|---|---|---|---|
| 01 | 01、开篇词 | 求职派是什么 | 对标《派聪明 RAG 项目是什么》 |
| 02 | 01、开篇词 | 求职派的学习路线 | 对标《派聪明的学习路线》 |
| 03 | 01、开篇词 | 求职派如何写简历 | 对标《派聪明如何写简历》 |
| 04 | 02、工程篇 | 获取源码和教程权限 | 对标《获取源码和教程权限》 |
| 05 | 02、工程篇 | 求职派的前置环境安装 | 对标《派聪明的前置环境安装 + API 申请》 |
| 06 | 02、工程篇 | 本地部署求职派 | 对标《本地运行派聪明》 |
| 07 | 02、工程篇 | Docker 部署求职派 | 对标《Docker 部署派聪明》 |
| 08 | 03、大厂篇 | 求职派需求分析 | 对标《派聪明需求分析》 |
| 09 | 03、大厂篇 | 求职派整体设计方案 | 对标《派聪明整体设计方案》 |
| 10 | 03、大厂篇 | 多端 IM Gateway 与意图路由模块设计方案 | 对标《模块设计方案(网关与路由)》 |
| 11 | 03、大厂篇 | Harness、Prefix Cache 与 ReAct 设计方案 | 对标《模块设计方案(运行时与上下文)》 |
| 12 | 03、大厂篇 | Lucene 9 混合检索与求职 Agent 的设计方案 | 对标《知识库检索 + 聊天助手设计方案》 |
| 13 | 03、大厂篇 | 数据采集与 LangGraph4J 的断点审批设计方案 | 对标《文件上传解析设计方案》 |
| 14 | 03、大厂篇 | 配额计费、MCP Client+Server、安全围栏与评测集设计方案 | 对标《用户管理设计方案 + 测评集实战》 |
| 15 | 03、大厂篇 | 求职派库表设计 | 对标《派聪明库表设计》 |
| 16 | 03、大厂篇 | 求职派接口文档 | 对标《接口文档》 |
| 17 | 04、面试篇 | 架构设计、SaaS 与多端 IM Gateway 面试题预测 | 对标《架构设计面试题预测》 |
| 18 | 04、面试篇 | Harness、Prefix Cache 与 Agent Loop 面试题预测 | 对标《聊天助手面试题预测》 |
| 19 | 04、面试篇 | Lucene 9 混合检索与 LangGraph4J 面试题预测 | 对标《RAG 与知识库检索面试题预测》 |
| 20 | 04、面试篇 | 配额计费、GenAI 可观测与离线评测面试题预测 | 对标《用户管理与安全评测面试题预测》 |
看到这套目录想马上上手学习的同学,扫下方优惠券就能解锁全套源码和教程,领券后只要 139 元/年,天地良心。
六、求职派提供了哪些 Agent 开发经验
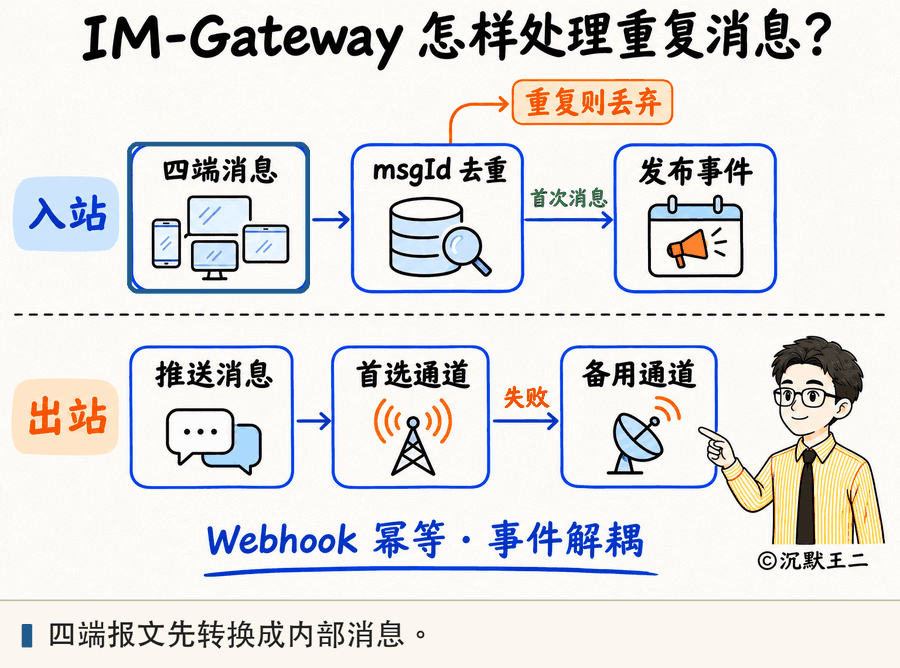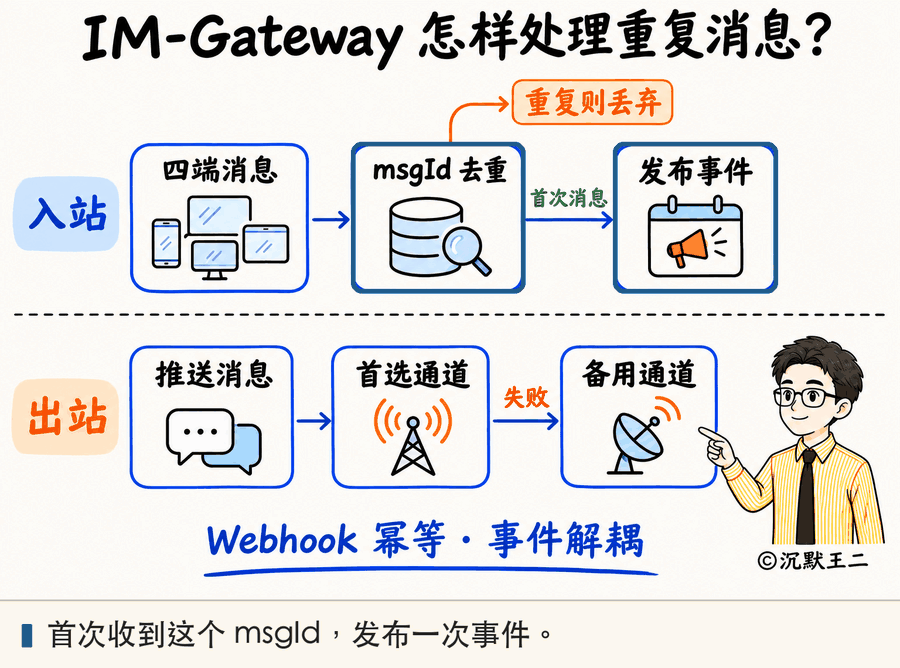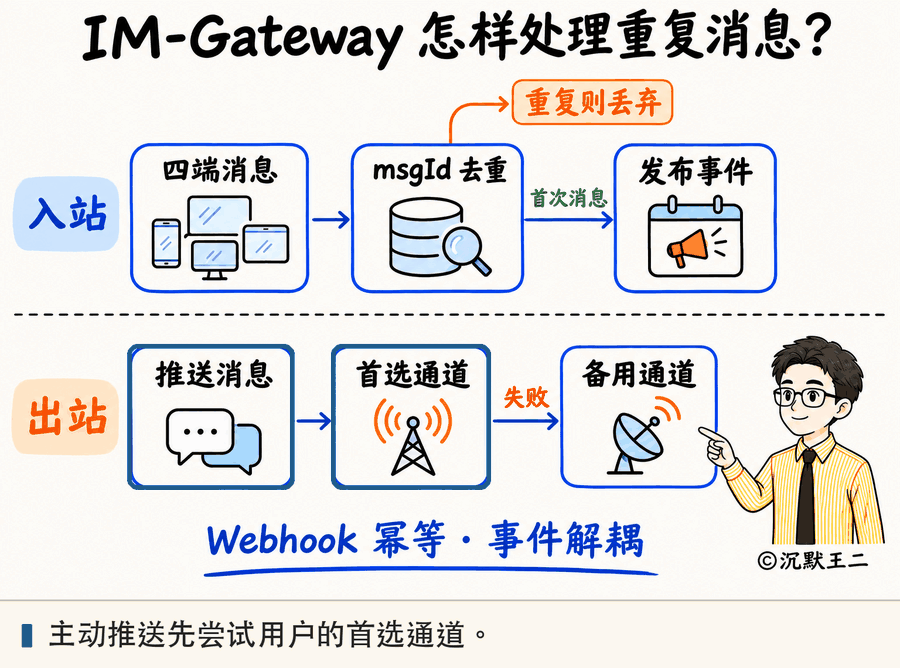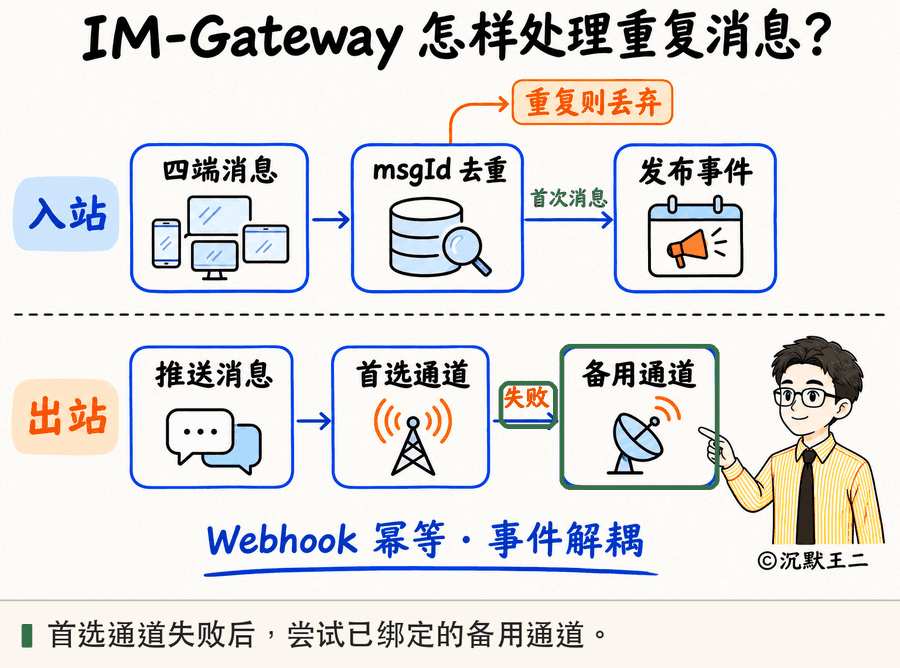
01、IM Gateway 与消息去重
怎么把微信 ClawBot、钉钉、飞书和 WebSocket 封装到同一套代码里,还能在 IM 平台超时重复推送时不重复扣费?
求职派用模板方法把通道的心跳保活、msgId 去重和事件发布统一封装了起来。消息推送失败时,系统还会自动降级到用户绑定的其他 IM 通道。
02、Harness:上下文预算与 Prefix Cache
大模型本身是无状态的。如果把每轮都在变的情景记忆或对话历史随便塞在系统提示词的最前面,从变动位置往后的前缀缓存(Prefix Cache)就会失效,每轮都要重新做一遍 Prefill 计算。
看 ContextBudgetAdvisor 里的组装代码就能明白。
// core/.../ContextBudgetAdvisor.java:170-209
// 组装稳定前缀(Layer 1 -> Layer 2 -> Layer 3)
List<String> systemSections = new ArrayList<>(6);
if (!isBlank(staticRules)) {
    systemSections.add("\n" + staticRules.trim());
}
if (!isBlank(roleInstructions)) {
    systemSections.add("\n" + roleInstructions.trim());
}
if (!trimmedUserProfile.isEmpty()) {
    systemSections.add("\n" + trimmedUserProfile);
}

// 预留最新用户输入预算后,再按比例装配 Layer 4 会话摘要与 Layer 5 情景记忆
int dynamicBudget = Math.max(0, totalBudget - usedTokens - latestUserTokens);
String boundedSummary = trimTextToTokenBudget(sessionSummary, Math.max(64, dynamicBudget / 4));
String boundedEpisodic = trimTextToTokenBudget(episodicContext, Math.max(64, (dynamicBudget * 3) / 10));
静态规则、角色指令和用户画像放在前面,摘要和情景记忆放在后面按需裁剪,让前面稳定的内容尽量命中大模型侧的前缀缓存。
03、Harness:工具裁剪与 Agent Loop
工具越接越多,每次请求把几十个工具的 JSON Schema 全塞给模型,输入 Token 就会暴涨。如果把现成的工具搜索和推理硬凑在一起,还容易出现冲突,也用不了流式输出。
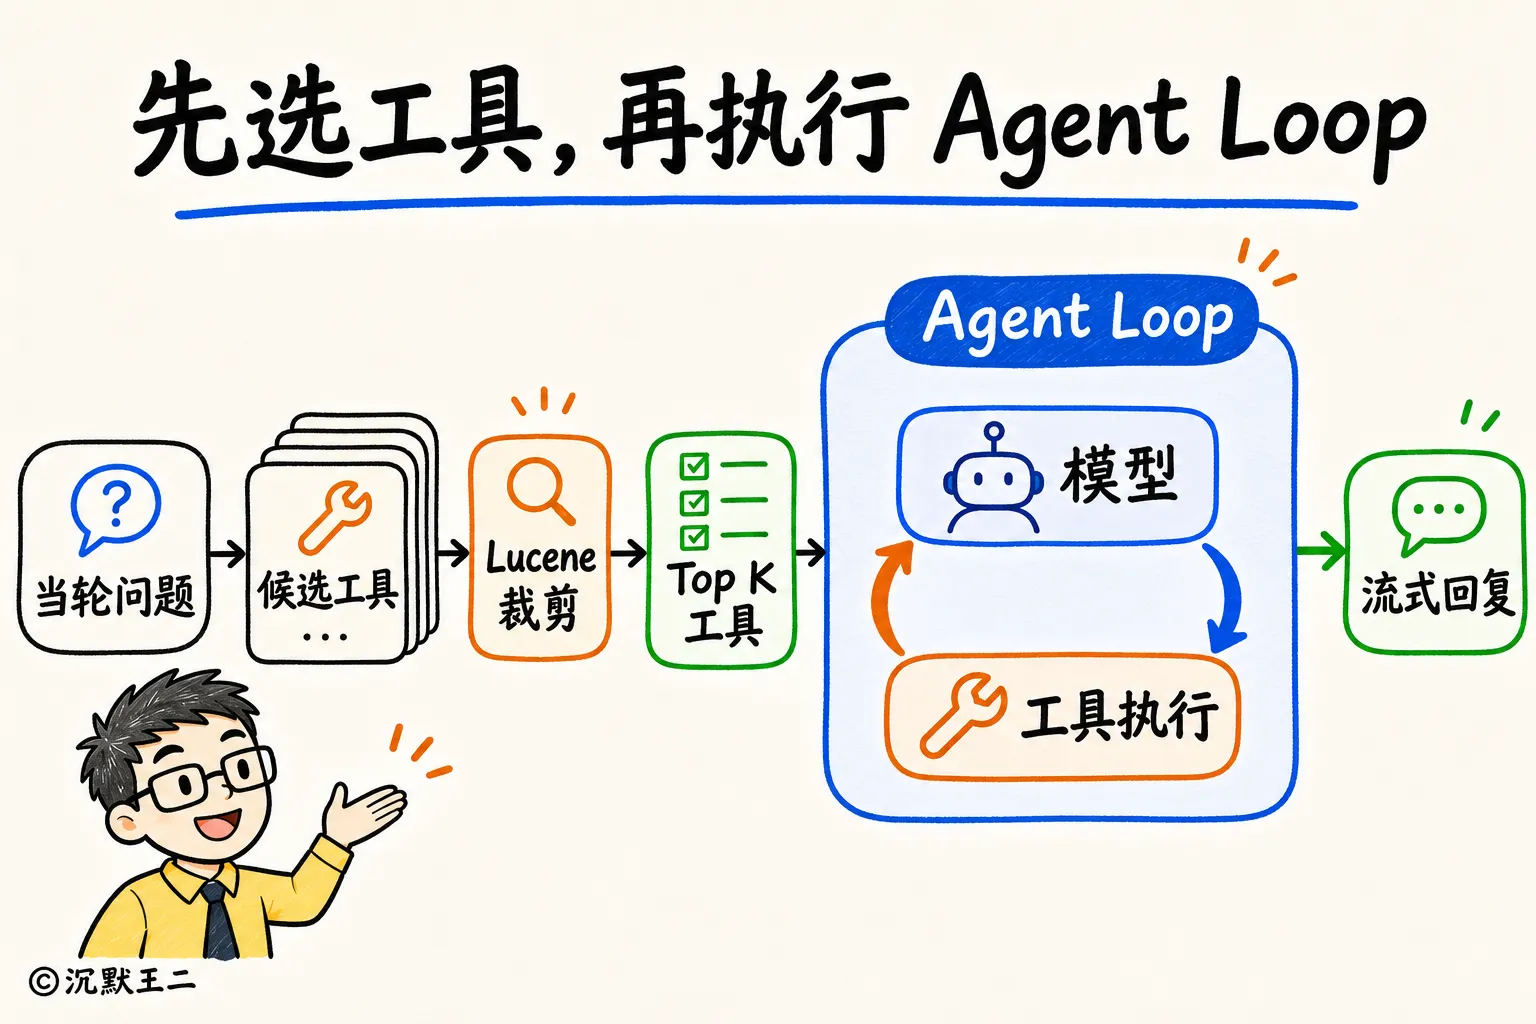
求职派把这两件事拆分开来处理。前面挂一个 Lucene 动态工具的裁剪拦截器,只按当轮提示词筛选出最相关的工具列表,不额外调用模型。决定哪些 Tool Schema 进上下文,本质上也是 Context Engineering 的一部分。
后面再交给 Agent Loop(ReAct 拦截器),用 Reactor 的 Flux.publish 一边逐字流式输出,一边完成多步工具调用。外层还套了免费和 VIP 两级模型路由,遇到上游报错会自动熔断降级。
04、岗位匹配度诊断与 VIP 模拟面试
项目内置了五个业务 Agent。
岗位匹配 Agent(/match)会把你的个人画像和岗位要求逐项比对,结合规则和模型分析,算出 0 到 100 的匹配分,并给出补强建议,最后写入用户的个人投递看板。
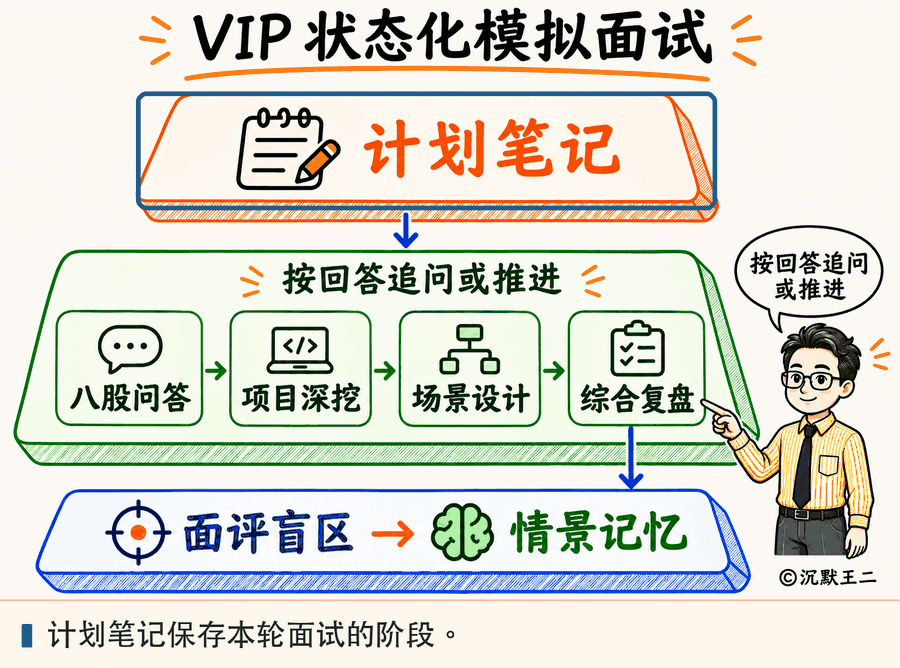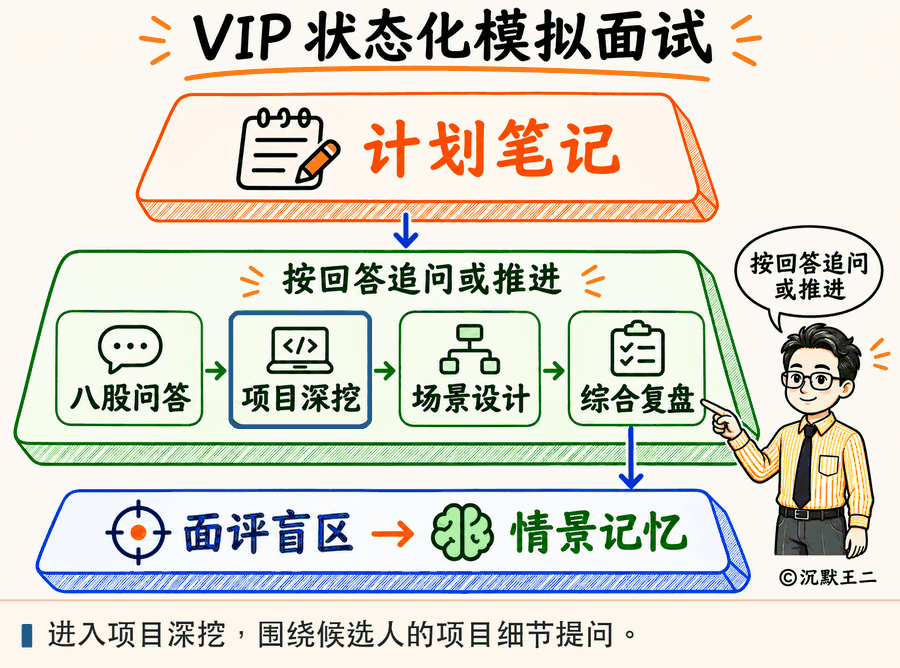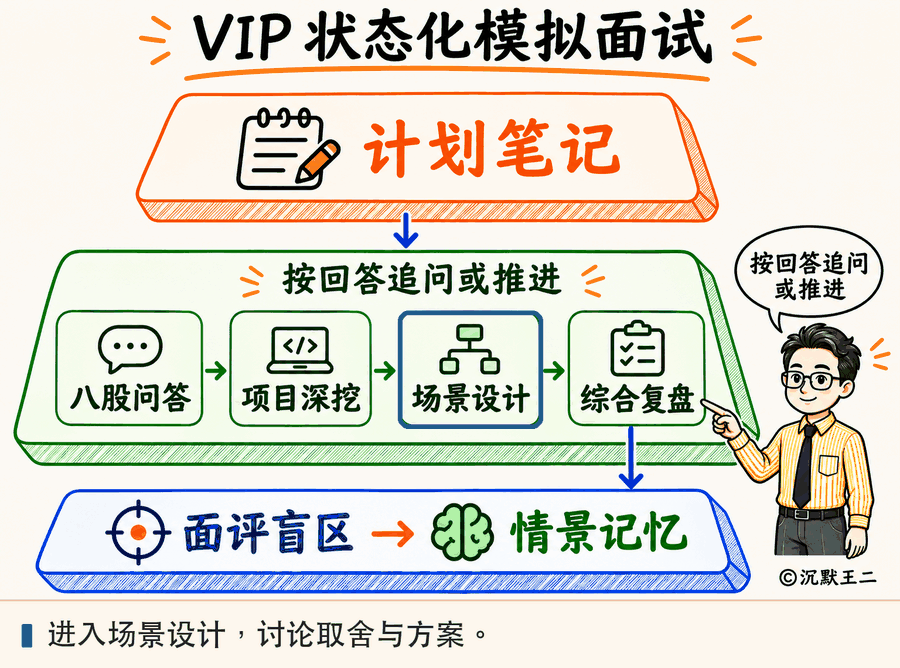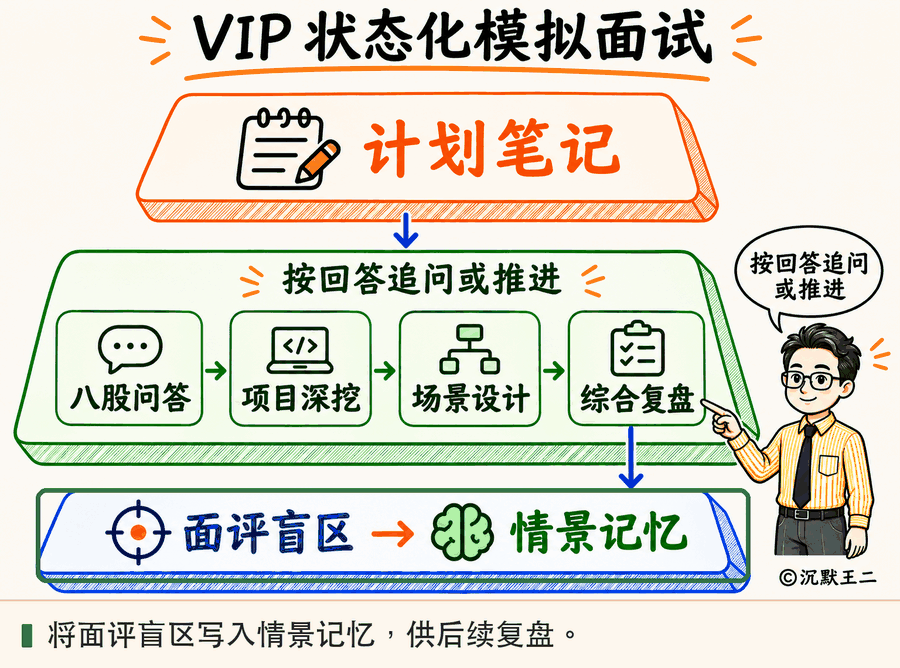
VIP 模拟面试官(/interview)会按计划拆分出八股问答、项目深挖、场景设计和综合复盘四个阶段。面试官会根据你的回答决定是继续追问还是进入下一阶段,结束后把暴露出来的问题记录下来,以便面试完进行复盘总结。
05、LangGraph4J 的 Checkpoint 与人工审批
自动采集最怕两种情况,一是原始招聘信息不全,模型整理出来的岗位草稿缺少投递链接,或者薪资写错了,直接入库会污染正式库;二是采集任务跑时间长了,中途服务突然重启,前面的进度就全丢了。
LangGraph4J 正好能同时解决这两个问题,用 Checkpoint 把每一步的状态持久化下来,重启后可以接着跑;再在入库前设一道人工审批节点,草稿要管理员确认过后才能进入正式库。具体看 AgentExecutor 里的配置:
// app/.../agents/AgentExecutor.java:109-113
CompileConfig compileConfig = CompileConfig.builder()
        .checkpointSaver(this.checkpointSaver)
        .interruptBefore(HitlReviewGateNode.AGENT_NAME)
        .build();
this.compiledGraph = new GraphBuilder().build().compile(compileConfig);
清洗置信度在 80 分及以上且带有效投递链接时自动发布入库。低于 80 分或缺失链接的草稿在审批节点前通过 MySQL 持久化到 Checkpoint 并挂起,等管理员在后台修改批准后,通过 updateState 和 GraphInput.resume() 从断点处恢复执行。
06、安全围栏与 100 道离线评测题目
跑在互联网上的 Agent 有两个绕不开的安全考虑。一是招聘信息里可能藏着恶意指令(间接提示词注入),二是模型搜不到岗位时可能会编造假的投递链接。
针对这两类问题,求职派各有一层对应的防护。先用 <untrusted_content> 标签把招聘信息包起来进行隔离,再拿回复里的链接去比对当轮工具在 ToolContext 里登记的召回名单,不用额外调用模型就能把假的链接拦下来。
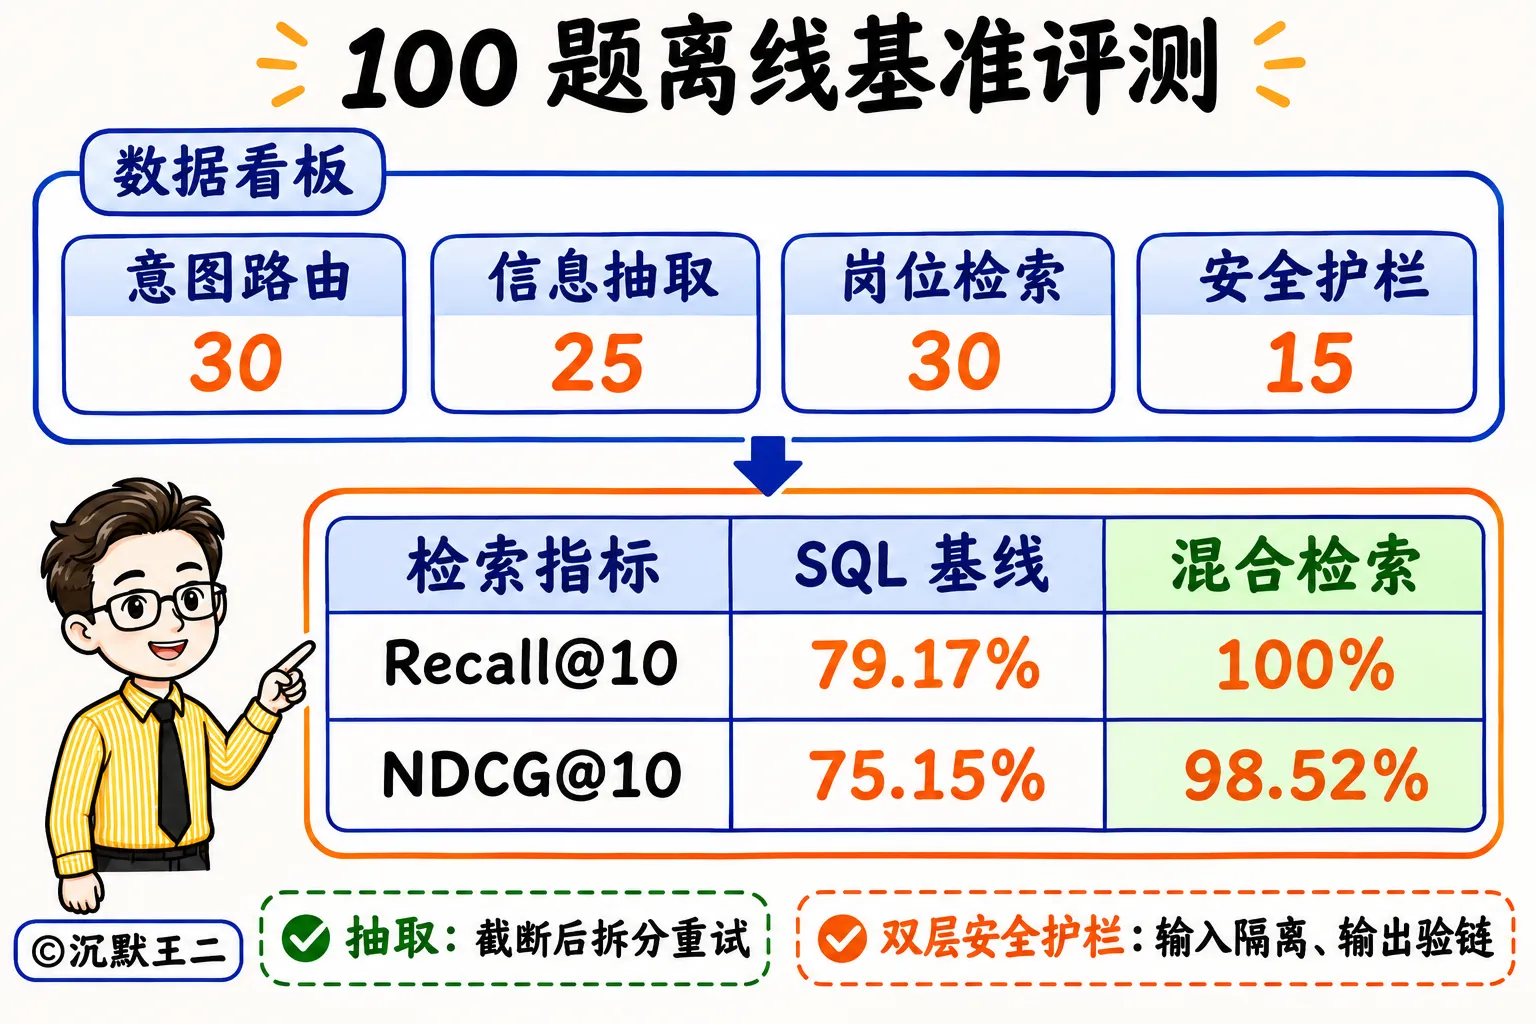
为了验证效果,求职派还准备了 100 道离线评测题,分为意图识别 30 题、信息抽取 25 题、检索 30 题、安全护栏 15 题。在这套评测集上,混合检索相比单路的关键字检索,Recall@10 从 79.17% 提升到 100%,NDCG@10 从 75.15% 提升到 98.52%。之后每次调整权重或更改规则,跑一遍单测就能看到指标的变化。
七、这些技术栈在求职派里怎么落地
01、Java 21 + Spring Boot 4.0.5 + Spring Modulith
这次一步到位用了 Java 21 和 Spring Boot 4.0.5。为了防止多模块越写越乱,还引入了 Spring Modulith 2.0.3 做模块管理。
项目也解决了 Spring Boot 4 升级带来的 Jackson 3(tools.jackson.databind.*)和 Jackson 2 兼容问题,面试聊框架升级也能有很多真细节可以讲。
02、Lucene 9 混合检索
几万条岗位数据,没必要单独搭一套 Elasticsearch 集群增加运维负担。求职派基于 Apache Lucene 9.12.3 实现了一套轻量级的混合检索引擎。
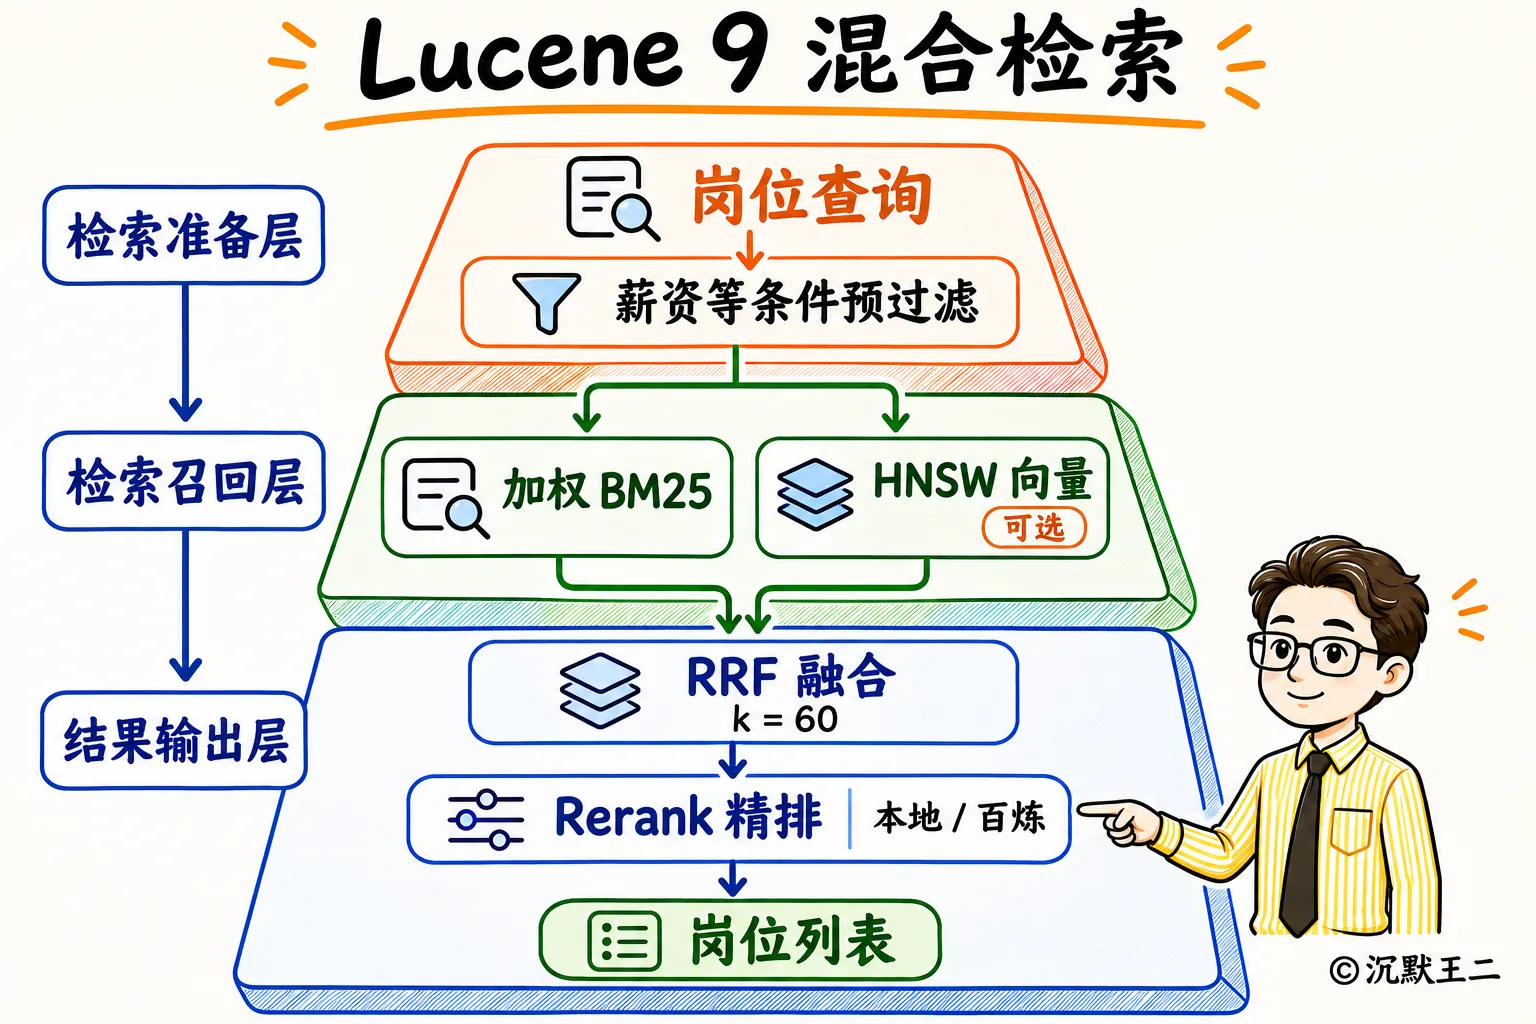
引擎内置了自定义的二元分词器,专门保留 C++、C#、.NET 这类带符号的技术栈。检索时先按薪资区间过滤,再走 BM25 加权、余弦 HNSW 向量、RRF(k=60)融合和双模 Rerank,方便大家从底层索引把混合检索吃透。
03、微信支付 V3 与乐观锁配额
求职派接入了微信支付 V3,用户充值后,额度会进到自己的 Token 配额账户。账户里分三种额度,扣费时按每日免费额度、VIP 周期包、永久加油包的顺序依次扣减,每日免费额度每天自动重置。
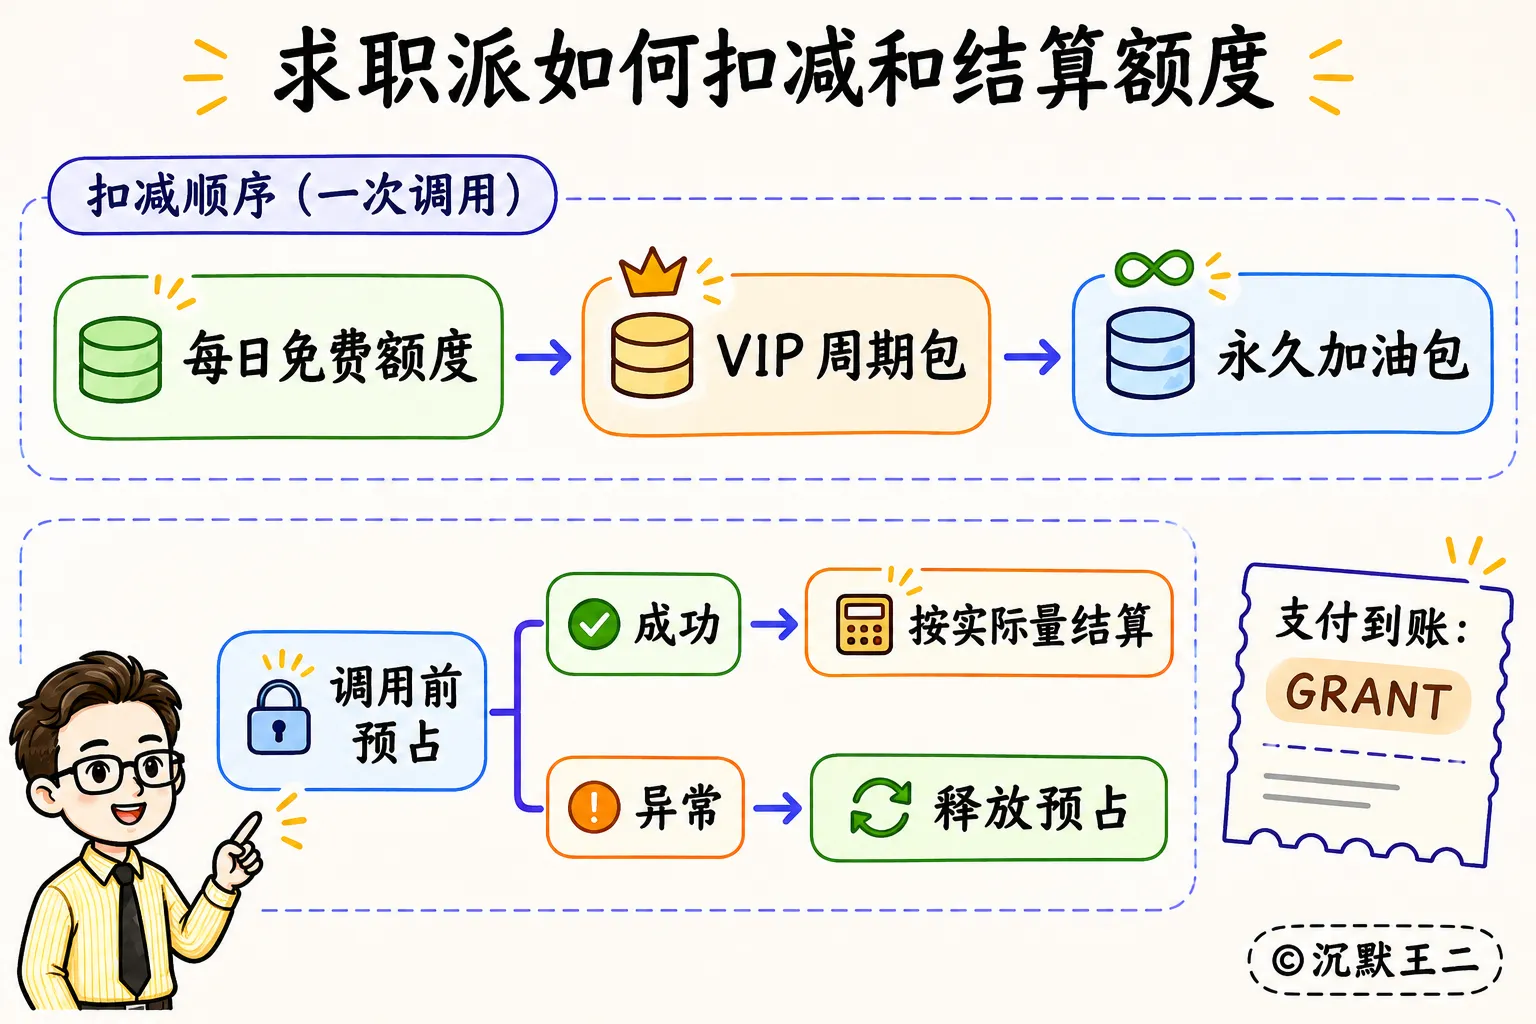
配额流水在前面讲过的 TCC 三阶段,即预占(RESERVE)、结算(SETTLE)、释放(RELEASE)之外,充值到账单独记为发放(GRANT),四类流水共用 (biz_id, phase) 唯一索引,微信支付的同一个回调重复到达也只会处理一次。
04、MySQL 8 + Liquibase 与分段锁
开发、测试、生产统一用 MySQL 8 加 Liquibase 管理库表变更。拉完代码填好 .env 里的账号密码,启动后就能自动建库建表。
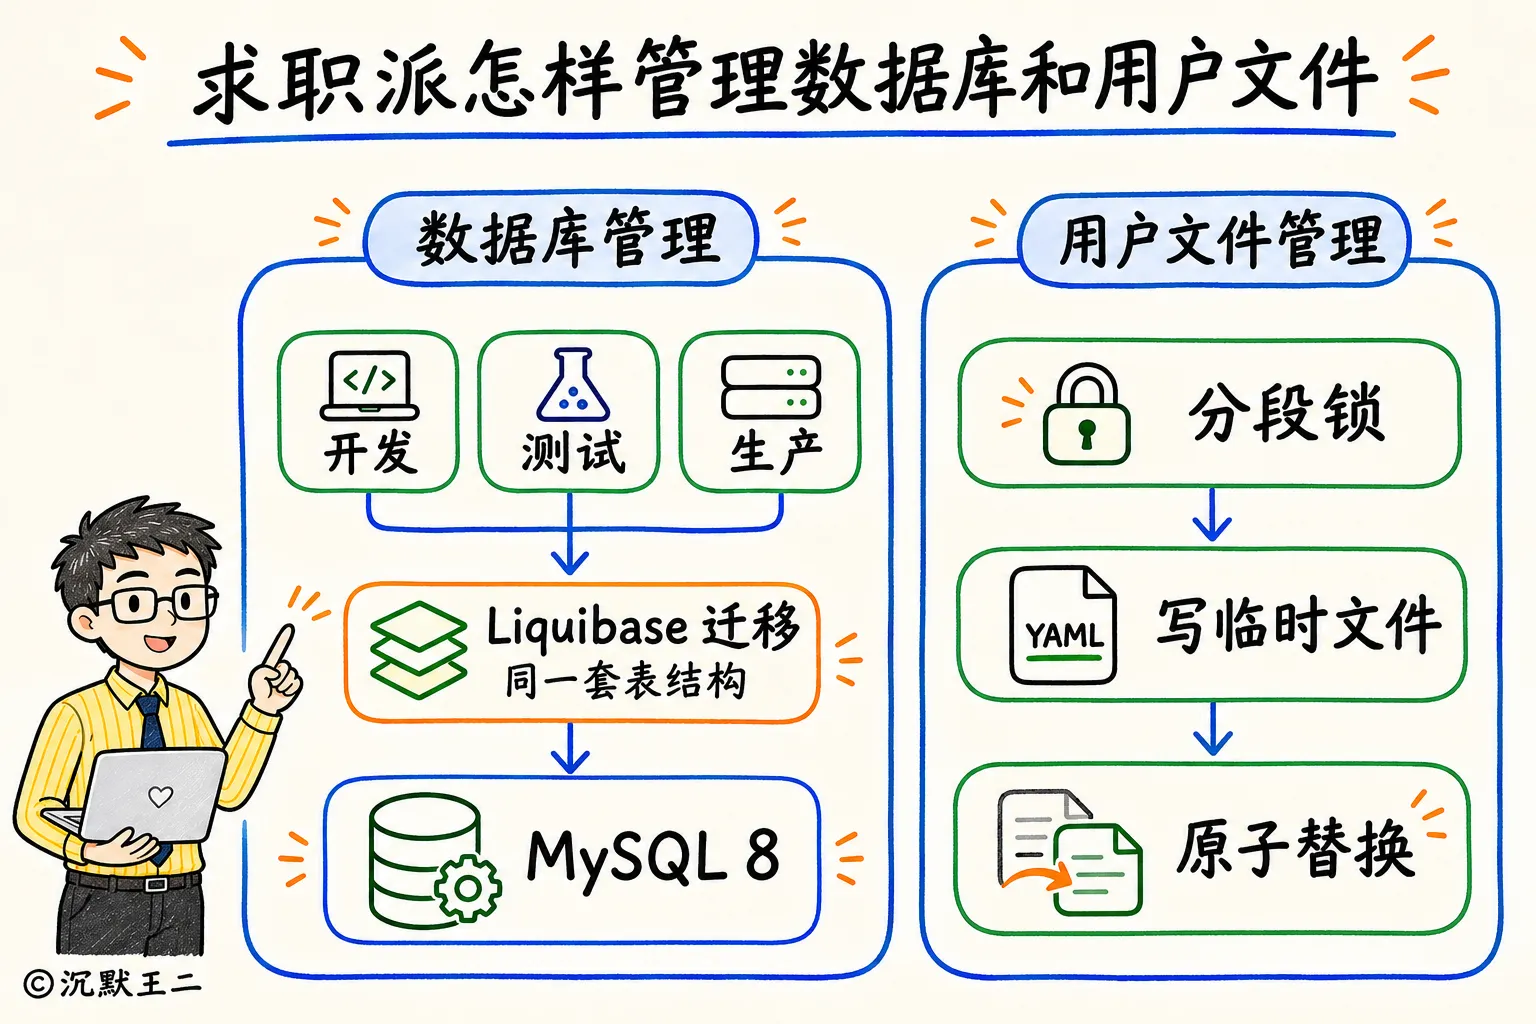
针对多租户并发读写 YAML 文件的场景,引入了 Guava 的分段锁和临时文件 ATOMIC_MOVE 原子替换。MCP Client+Server 的访问令牌在落库时只存 SHA-256 哈希摘要,不留明文。
05、Playwright 采集、SSRF 防护与 JobRunr
采集不再让所有任务排队共用一个浏览器页面,而是开一组相互隔离的无痕浏览器,用信号量控制同时运行的数量。
安全上设了两道防线,入口处先解析域名,指向内网的地址直接拒绝;页面加载过程中,再用 Playwright 的 route("**/*") 钩子检查每一个请求,防止攻击者先给个正常链接,再通过 302 跳转去访问云主机上的数据,也就是 SSRF 攻击。
后台定时提醒和新增岗位的增量扫描交给了 JobRunr 8.5.1 做持久化调度,按 userId:taskName 命名空间隔离不同用户的任务。
06、跨线程 TTL 与 GenAI 可观测
跨四种线程的上下文透传,用的是阿里开源的 TransmittableThreadLocal,接入成本很低,只需要包装一下线程池;gen_ai.* 指标则直接挂在 Micrometer 的 ObservationRegistry 上,和 Spring Boot 4 自带的观测体系共用一套导出配置。
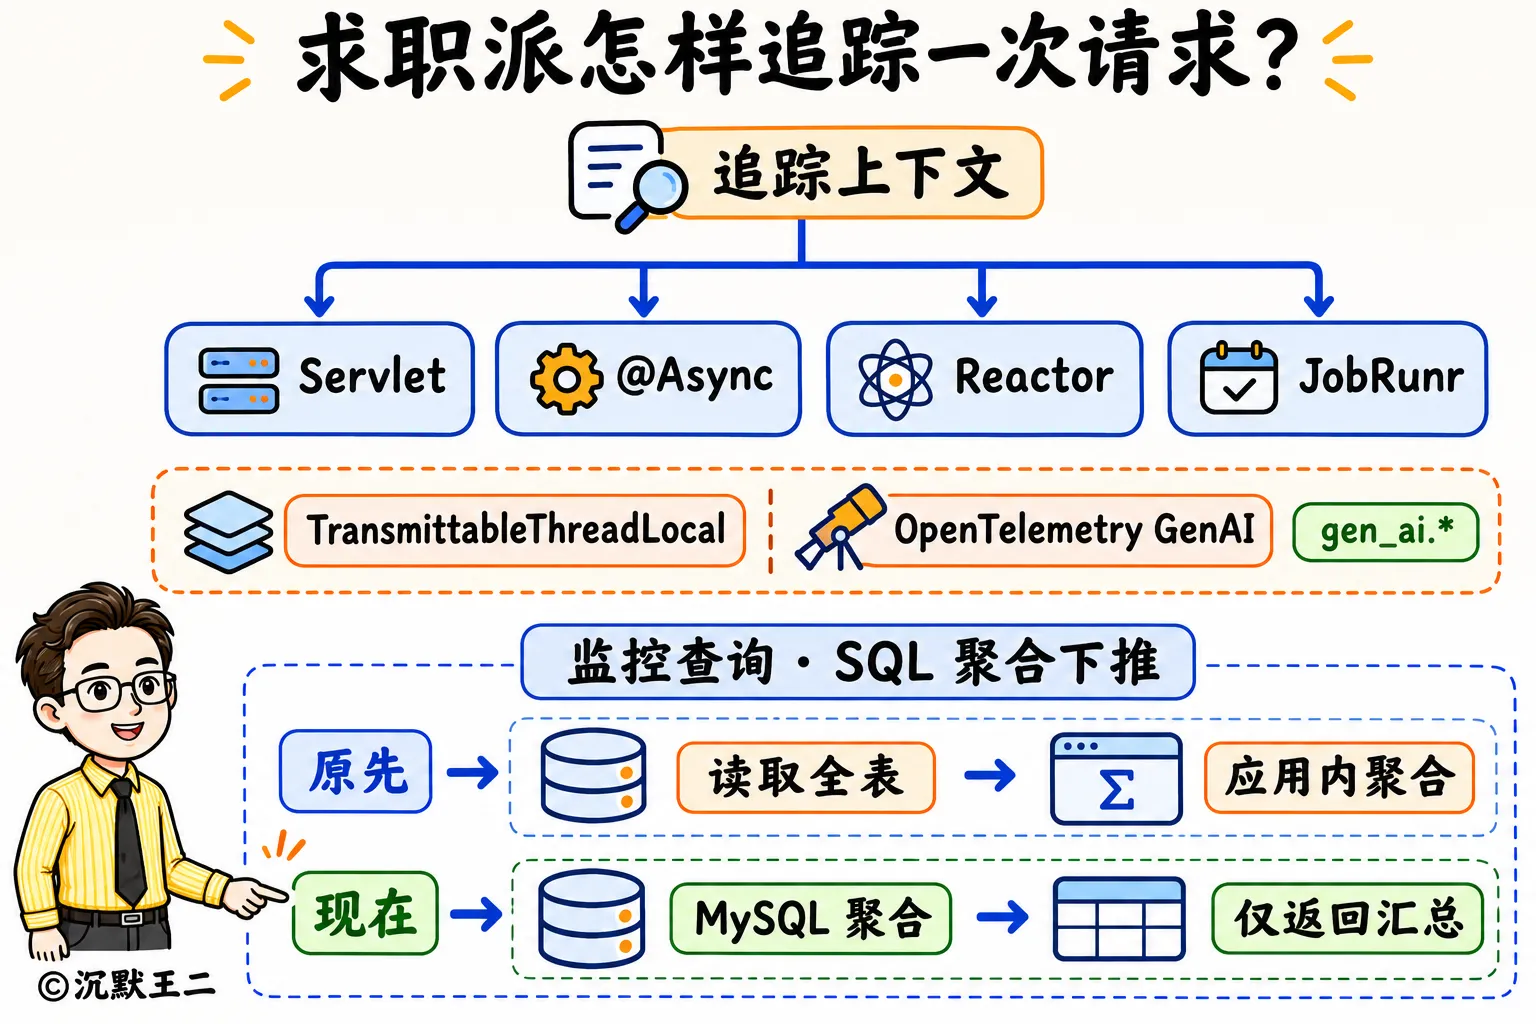
后台监控总览的 SQL 聚合下推,在面试里可以作为“怎么避免 OOM”的追问素材。
八、解锁求职派源码与教程
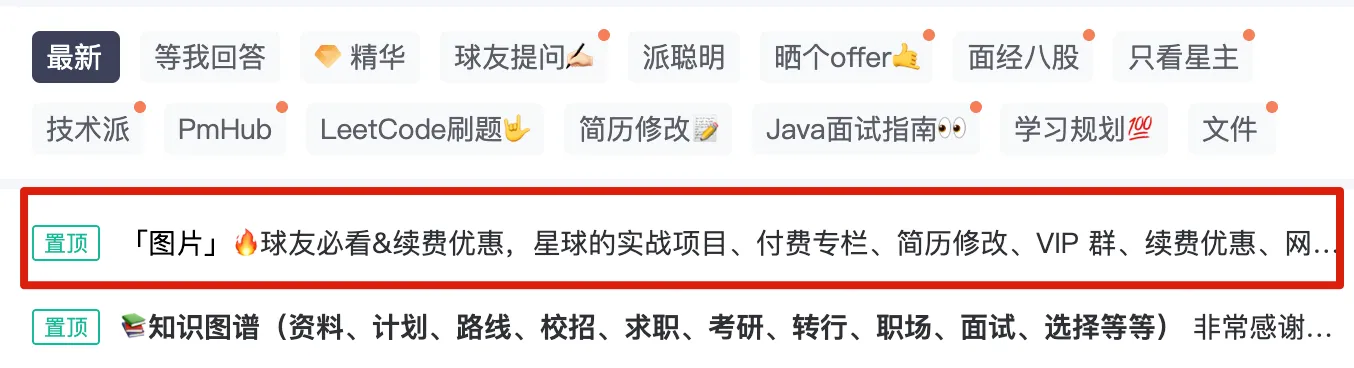
为了保护球友的权益,求职派的代码仓库采用邀请制。加入星球后,在星球第一个置顶帖【球友必看】里找到申请入口,审核通过就能拉取完整源码,教程也会在专栏同步更新。
加入「二哥的编程星球」后,不用再额外付费,可以一并解锁以下服务:
- 全套实战项目源码与教程:解锁求职派(JobClaw)、PaiCLI 终端 Agent、派聪明 RAG Java 版与Go 版、PaiFlow 工作流 Agent、微服务 PmHub、前后端分离技术派、轮子 MYDB 等全部项目的源码和
60万+ 字配套教程。 - 一对一简历修改:提供专属简历修改服务,附赠
5000+份按方向分类好的优质简历模板。 - 专属提问答疑:向二哥和星球嘉宾发起 1v1 提问,覆盖技术排障、学习路线、面试复盘和 Offer 对比。
- 40 万+ 字面试求职攻略:解锁《Java 面试指南》、《王二讲 Agent》面试题库、二哥 LeetCode 刷题笔记和一灰职场进阶专栏。
- 并肩作战的学习氛围:和上万名校招、社招同学一起打卡推进、组队模拟面试、互通内推消息。
截止目前,已经有 14000+ 名同学加入了星球,一批又一批球友靠着星球项目拿下了腾讯、阿里、字节、小红书、快手、美团、京东、华为等大厂 Offer。
微信扫描下方优惠券就能加入,星球原价 169 元/年,限时立减 30 元,到手只要 139 元/年。求职派推完就涨价到 179 元。
- 步骤一:微信扫描上方二维码,点击「加入知识星球」按钮
- 步骤二:打开星球置顶帖球友必看(
https://t.zsxq.com/11rEo9Pdu),获取求职派源码仓库权限和配套专栏教程
星球从最初的 69 元一路走到今天,视频会员包年都要一百七八十元,花 139 元换这么多 AI 实战项目源码、一对一改简历和一整年陪伴答疑,这笔账怎么算都划算。
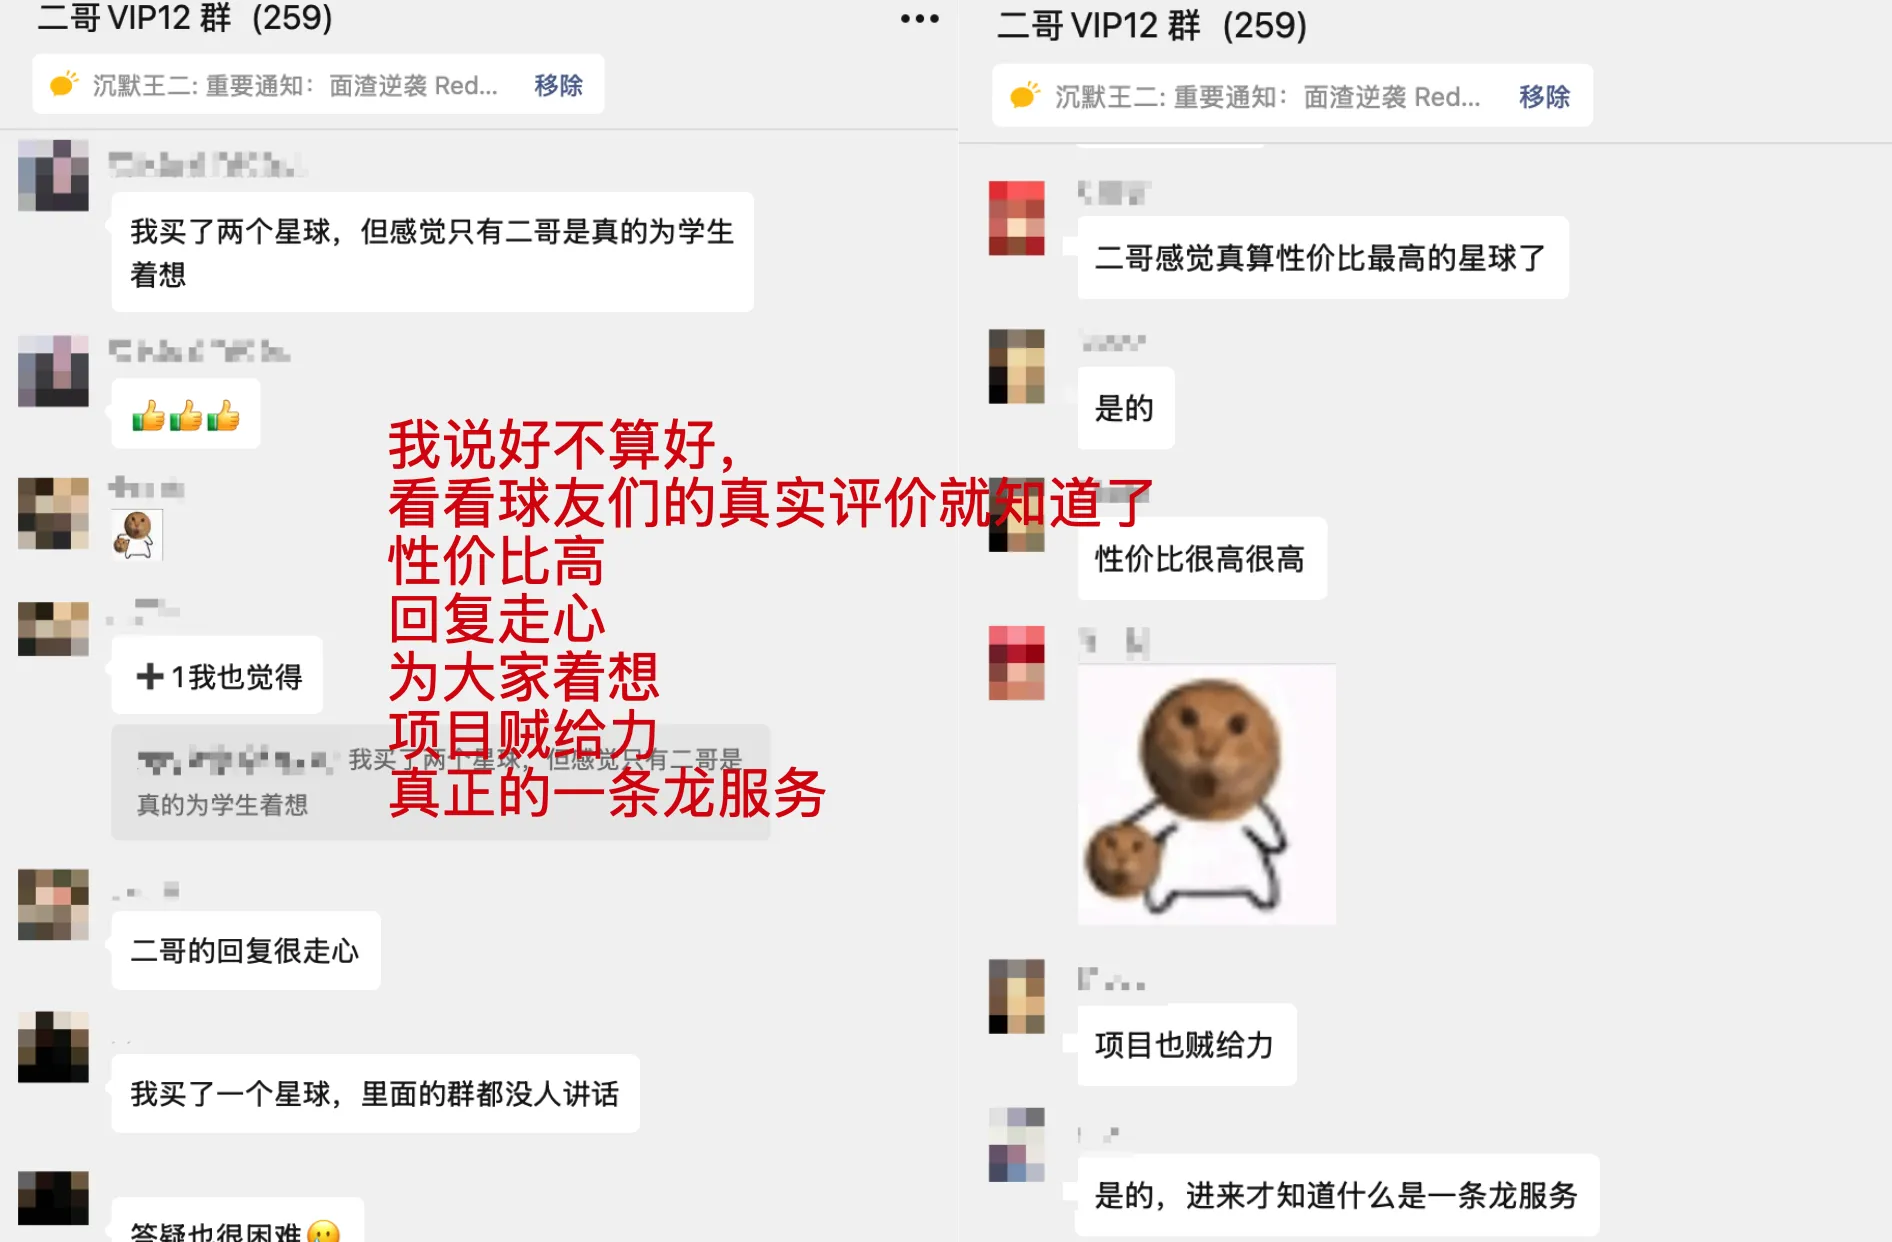
我的原则一直没变,拒绝割韭菜,用心打磨代码和教程,能帮大家多拿一个满意的 Offer 就多帮一个。
无论你正在准备校招、日常实习,还是打算社招往 AI 应用和后端架构方向进阶,认认真真跟完求职派,简历含金量和面试底气都会提升一大截。
冲。
未能定位到原文的划线
真诚点赞 诚不我欺
回复