
求职派的学习路线
大家好,我是二哥呀。
在正式开启求职派(JobClaw)的学习之旅前,我先跟大家说句掏心窝子的话。一旦跨过了语法入门阶段,就不要想着靠视频去学习。
尤其是在 AI 时代啊。视频学习的效率极低,很多时候,习没学,去刷小姐姐了。
更现实的一点是,等你进公司实习或者工作的时候,团队里没人会给你录一套几十集的手把手视频。mentor 把仓库权限开好,给你一份设计文档或者环境手册,过两天就要看你有没有产出。
所以,别再想着找视频学习了。
趁着学求职派的机会,把看文档、翻源码、看注释、跑单测的习惯练到手,以后去哪家公司都能快速站稳脚跟。现在手头还有 Claude Code、Codex 和 Gemini 这类 Agent 工具帮忙梳理,效率比看视频高多了。
这篇教程就给大家整理一套项目实战心法,执行力差的,文末还会给你贴心配上 14 天和 21 天的每日计划表。
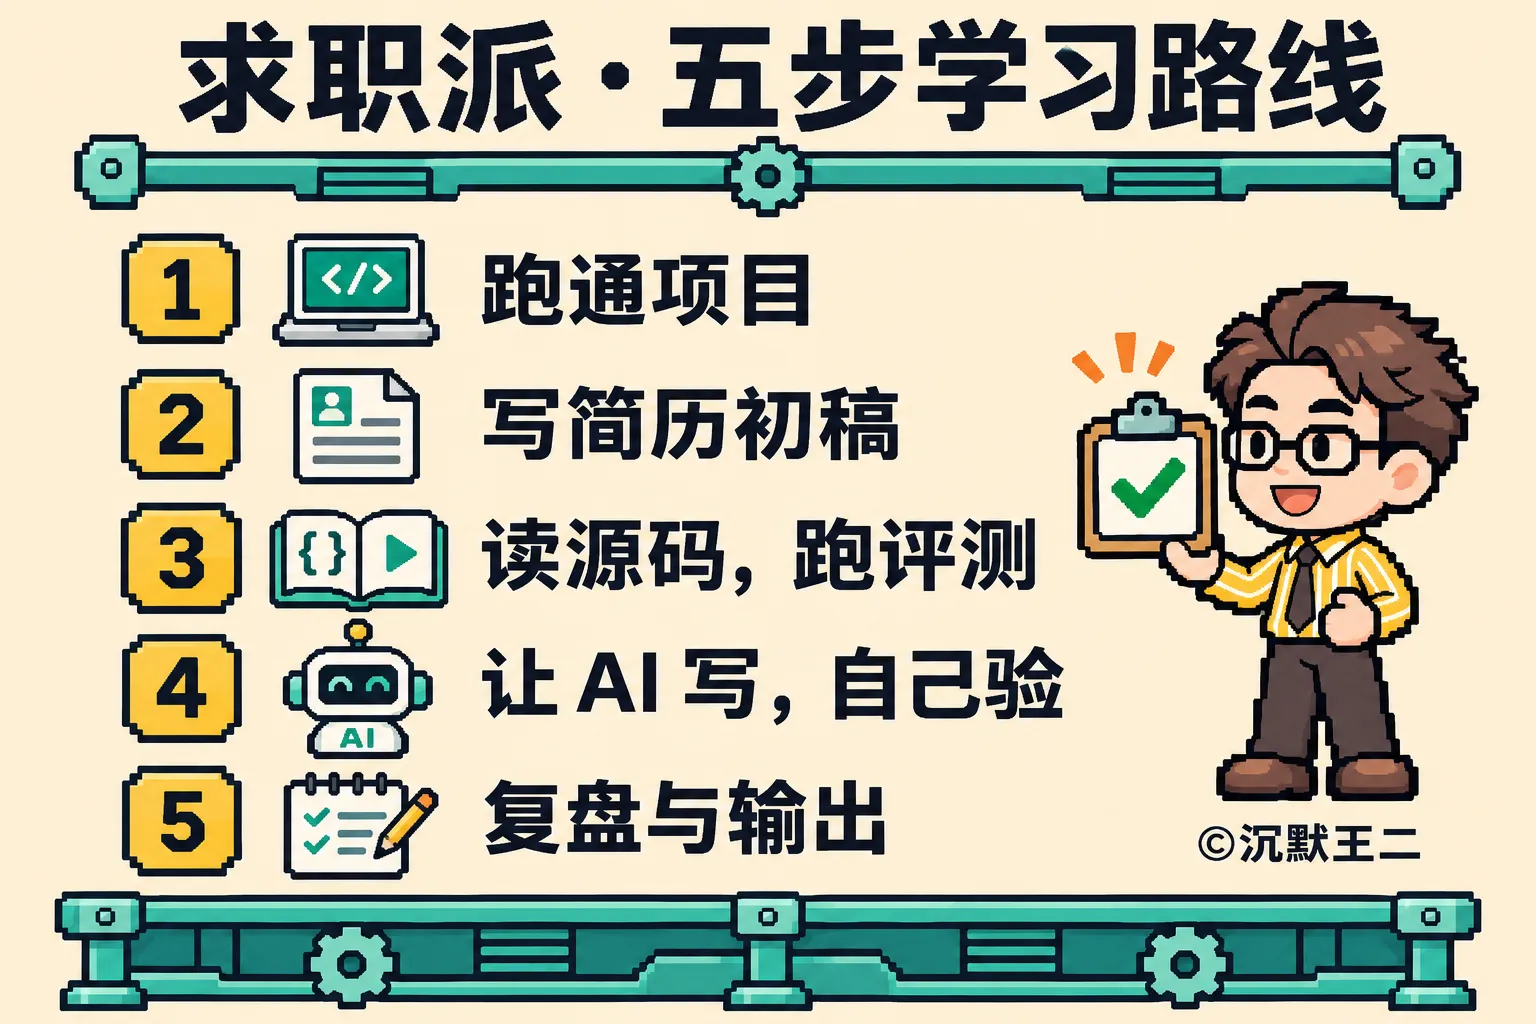
照着做就完事了。
包你能学会。
第一步,先当用户,把求职派跑起来
先让求职派在你自己的电脑上跑起来。
别一上来就扎进底层代码里一行行啃,连页面长什么样、输入提示词后后台干了什么都不知道,看一分钟就会犯困。
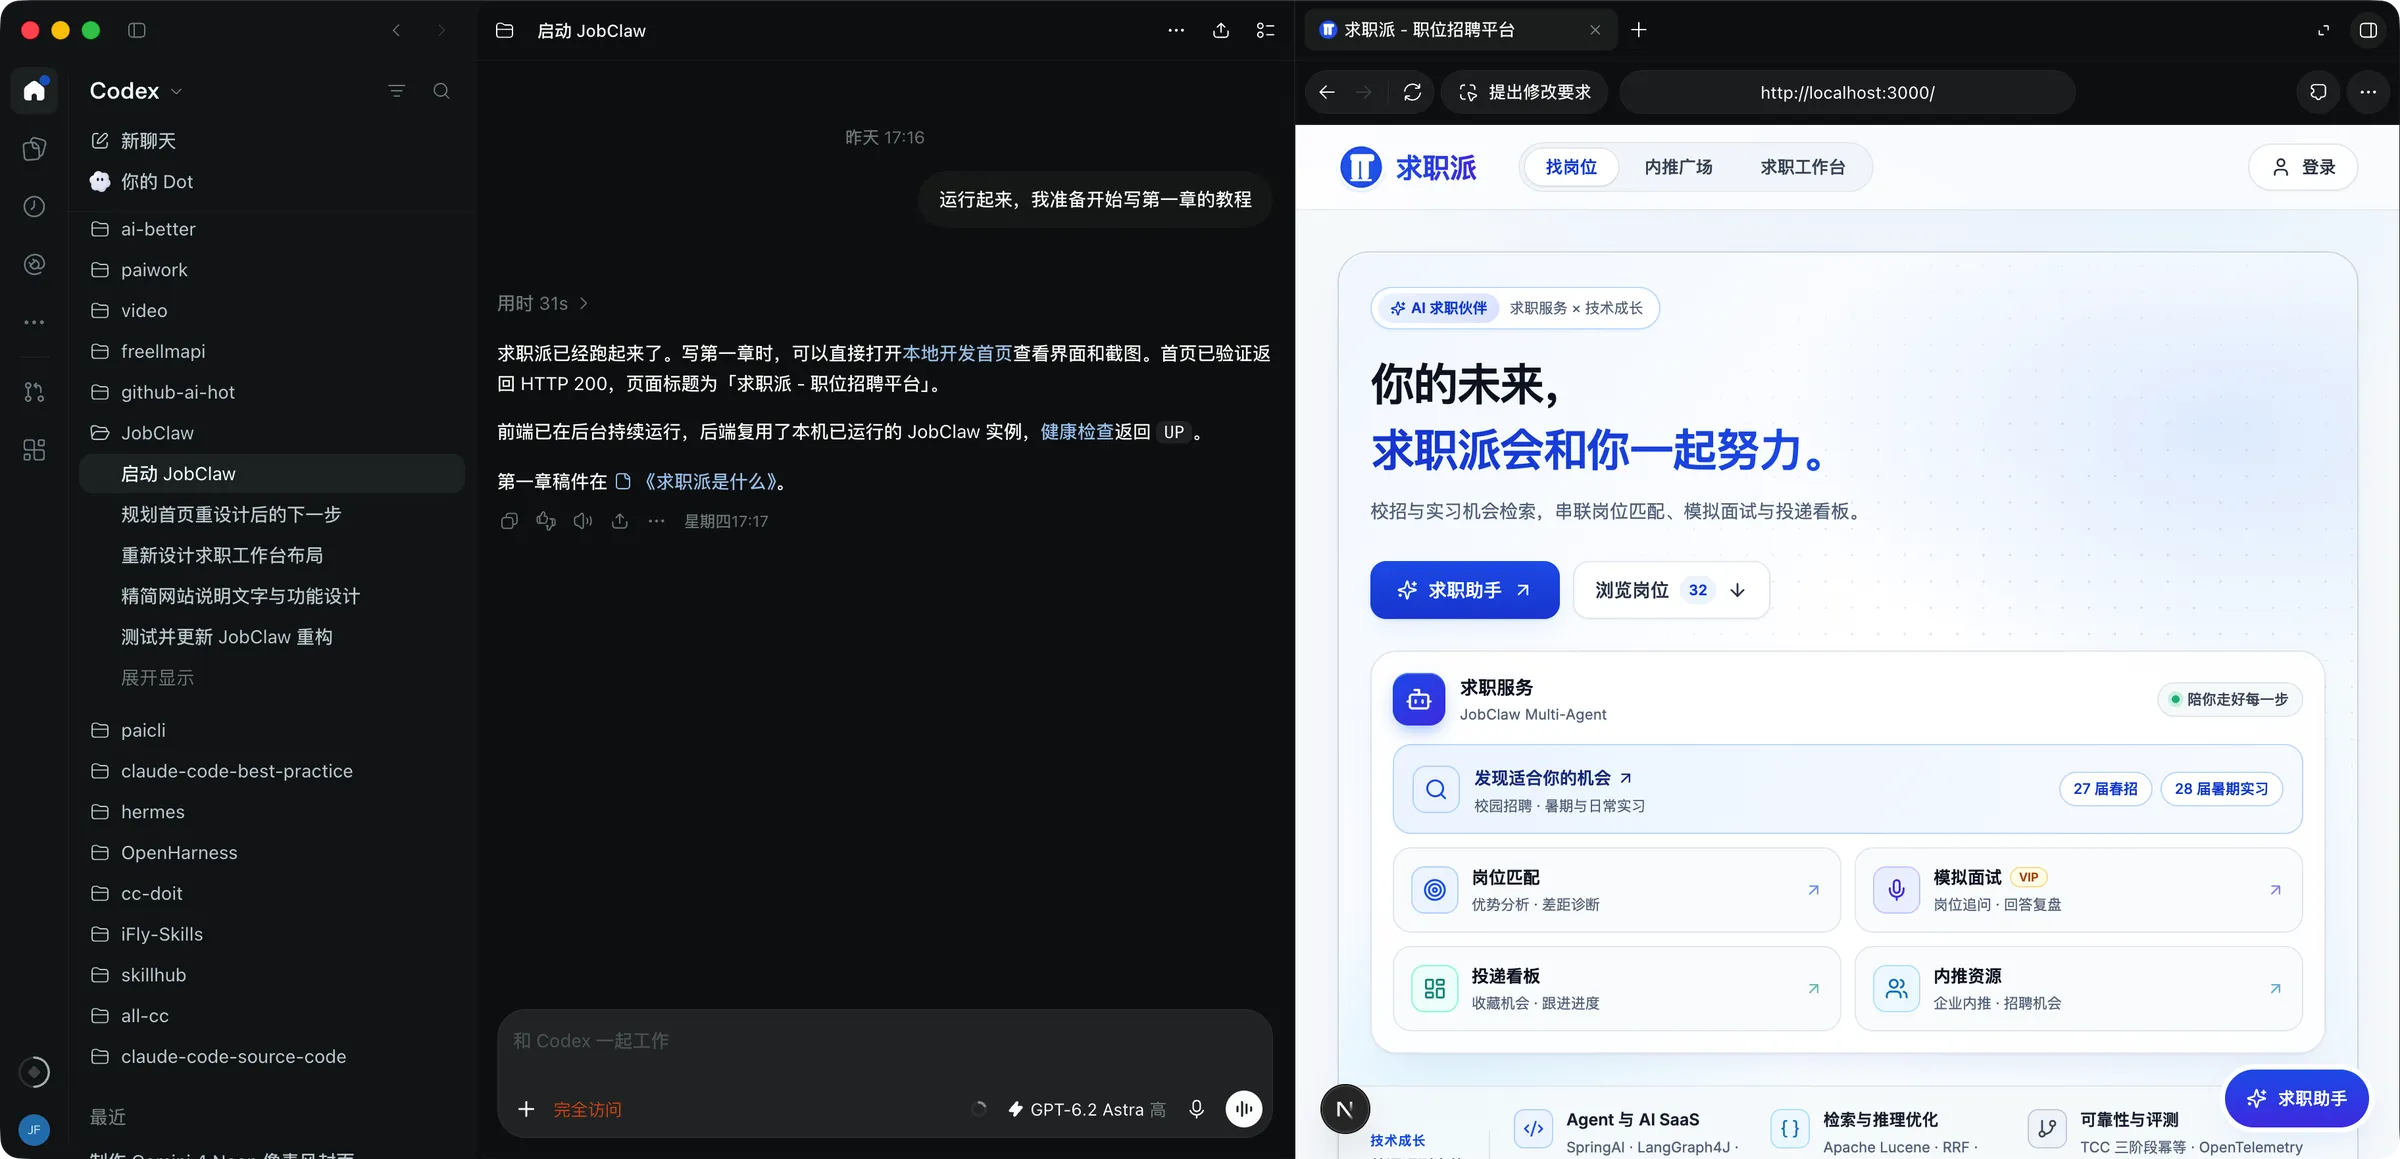
现在是 Agent 时代了,告诉 Codex,帮我把求职派跑起来,它就能帮你跑起来了,DeepSeek Harness 或者 Claude Code 也可以。
以前还需要下面这种方式,现在完全不用了。
cp .env.example .env

# 2. 首次拉取代码,在仓库根目录安装全部本地模块
./mvnw -U -DskipTests install

# 3. 使用默认 dev 配置启动主应用,自动建库并执行 Liquibase 变更集
./mvnw spring-boot:run -pl app

# 4. 新开终端验证健康检查,确认返回 UP
curl http://localhost:8087/actuator/health
当然了,如果 Codex 让你提供 DeepSeek 的 API key 可以告诉它,不要怕泄密,无所谓的,你可以单独给求职派申请一个 API key,项目学完了,删掉拉倒。
当然了,如果后面派词元做完了,我也可以免费给大家提供一些 API key。
求职派跑起来后,先别急着翻代码,花半小时当一回求职用户,把下面四件事亲手试一遍。
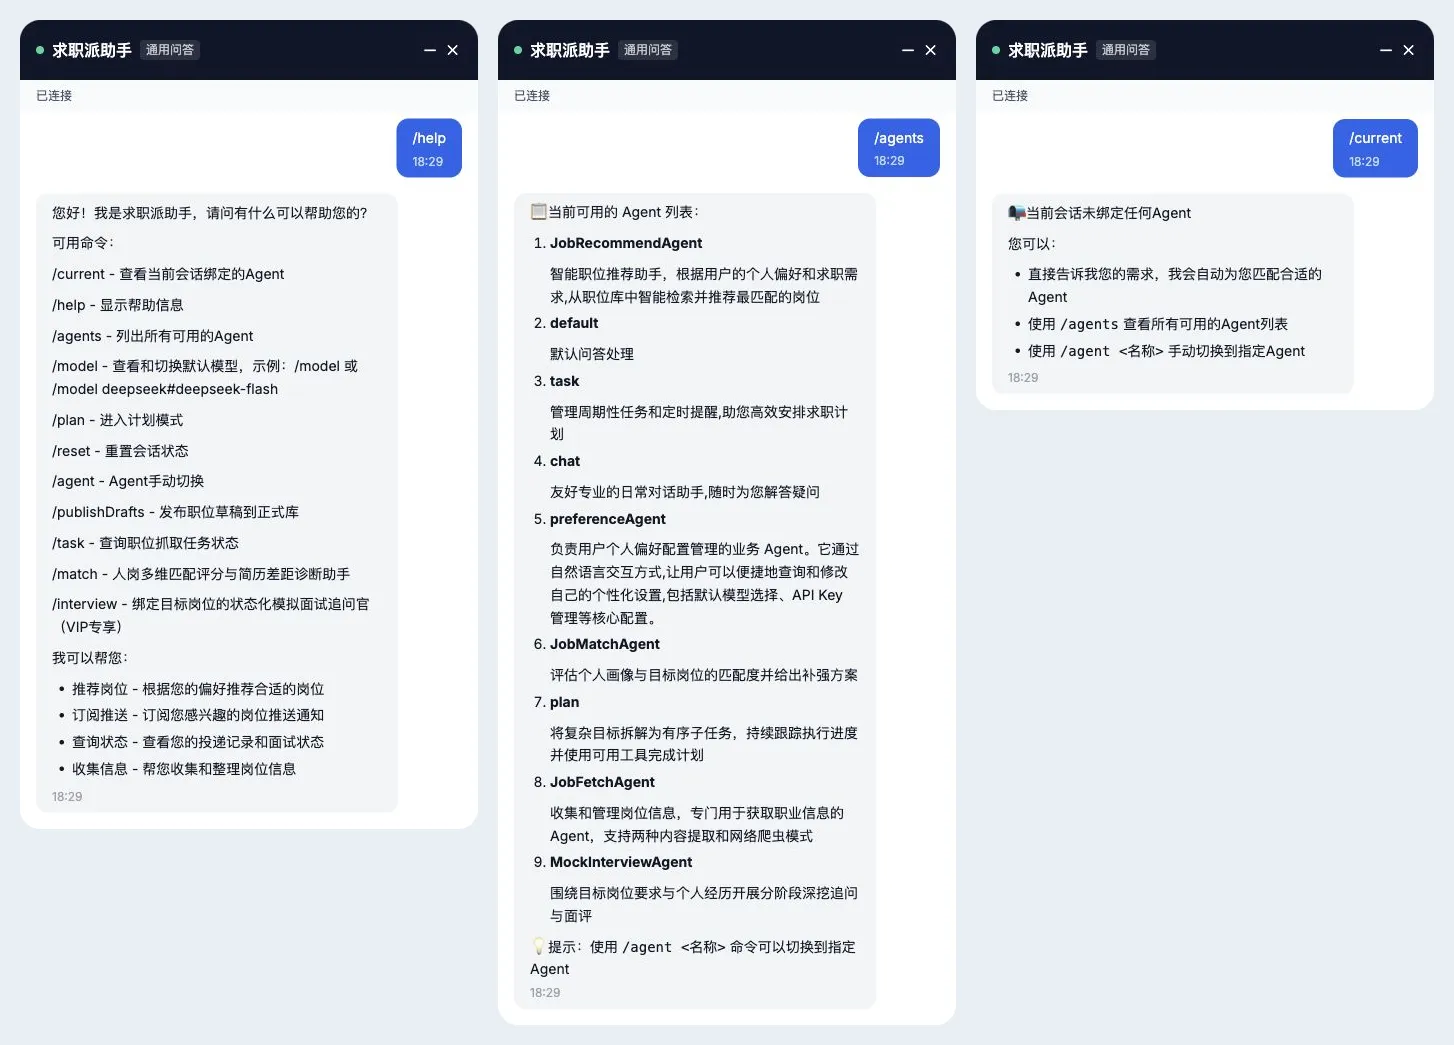
第一,试斜杠命令:在求职派助手依次键入 /help、/agents 和 /current 斜杠命令。
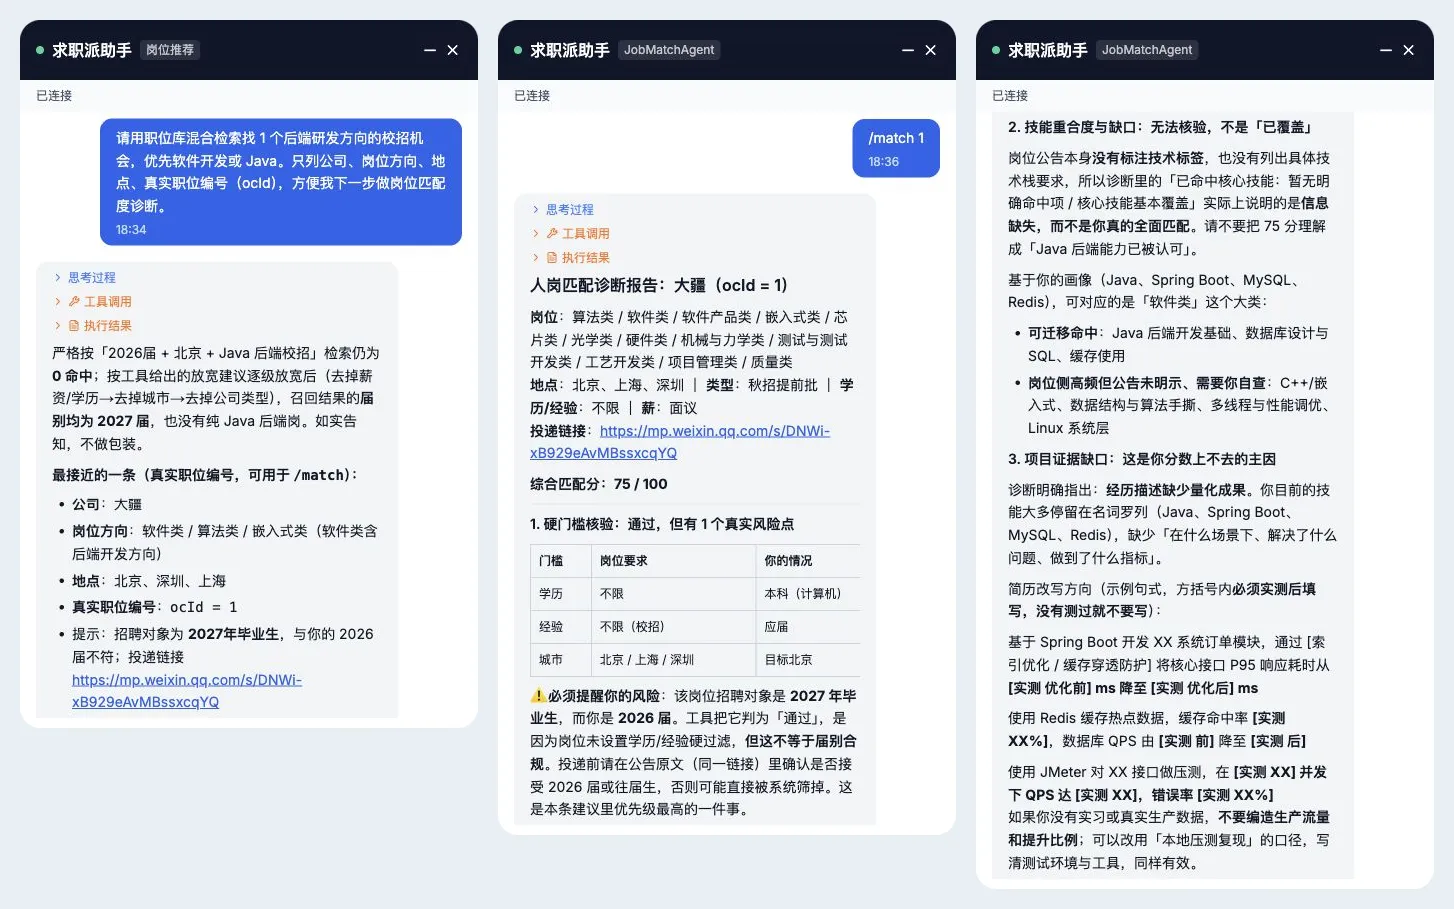
第二,试混合检索和岗位匹配度诊断:让它搜一次目标岗位,拿到职位编号后输入 /match 加职位编号,看看系统怎么结合你的个人画像算出 0 到 100 的匹配分,并给出补强建议。
你甚至可以把这段话发给 Codex 或者 DeepSeek Harness,让它帮你操作。
第三,尝试投递看板和 VIP 模拟面试:把心仪的岗位加进投递看板,再输入 /interview 加职位编号,感受面试官怎么按八股问答、项目深挖、场景设计和综合复盘四个阶段一步步追问。
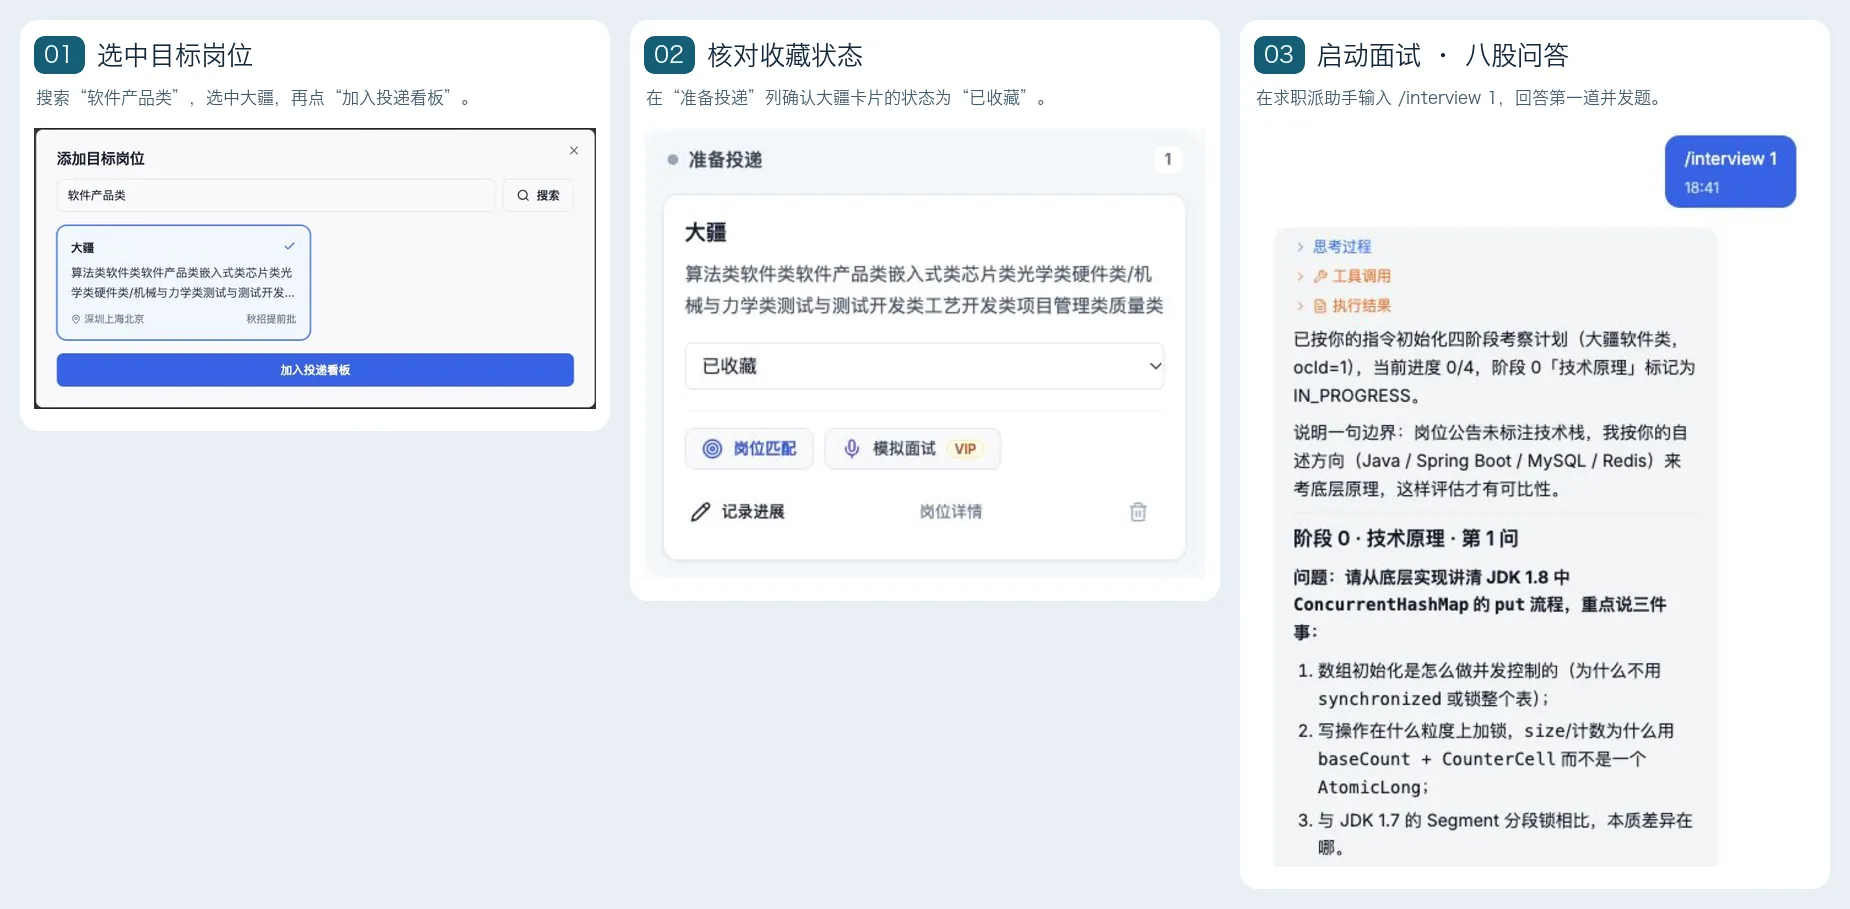
- 进入「求职工作台 → 投递看板 → 添加岗位」,搜索岗位关键词「软件产品类」,选中大疆,点击「加入投递看板」。
- 回到看板,在「准备投递」列确认大疆「已收藏」。
- 打开求职派助手,输入
/interview 1。面试官结合账号已有的 Java 画像,从 JDK 8 ConcurrentHashMap.put 的初始化、锁粒度和并发计数开始追问。
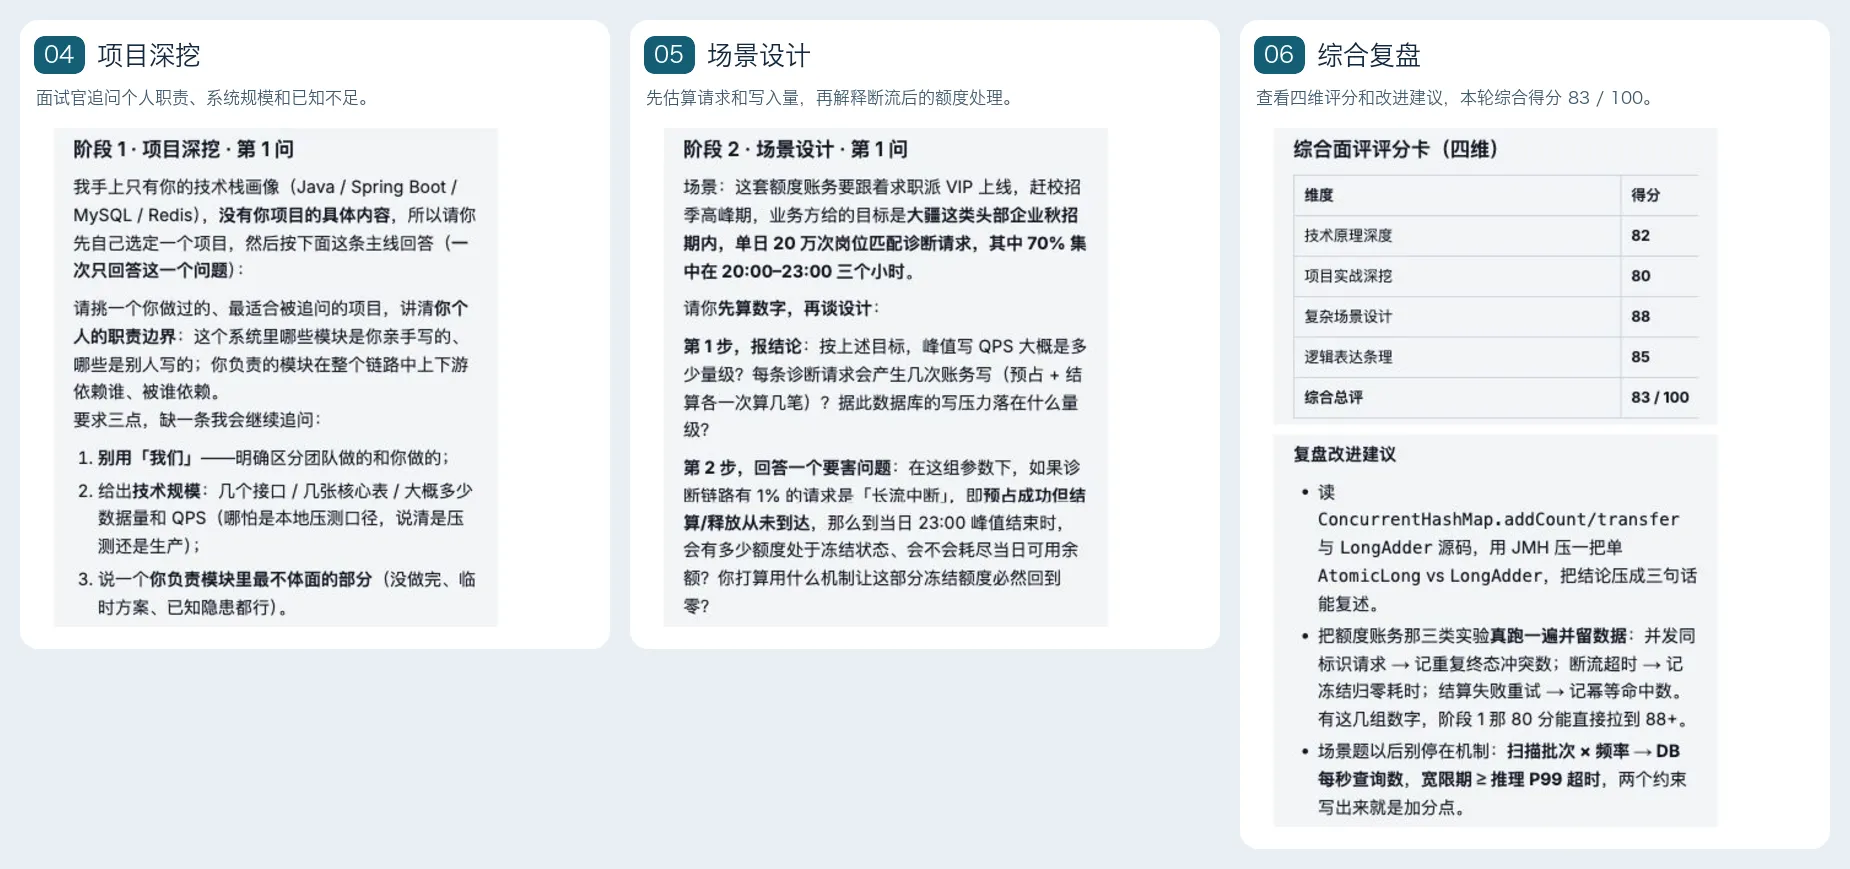
- 项目深挖。面试官要求区分个人职责和已有实现。
- 场景设计。面试官沿着刚才的额度问题继续追问:假设每天有 20 万次诊断,70% 集中在 3 小时内,数据库要承受多少写入?如果 1% 的请求中断,冻结的额度怎么回收?
- 综合复盘。实际评分为技术原理 82、项目深挖 80、场景设计 88、逻辑表达 85。
第四,核对免费 Token 额度:打开个人中心,查看系统每天赠送的 50000 免费额度,对比对话前后的余额变化,感受额度先预扣、再结算的过程。
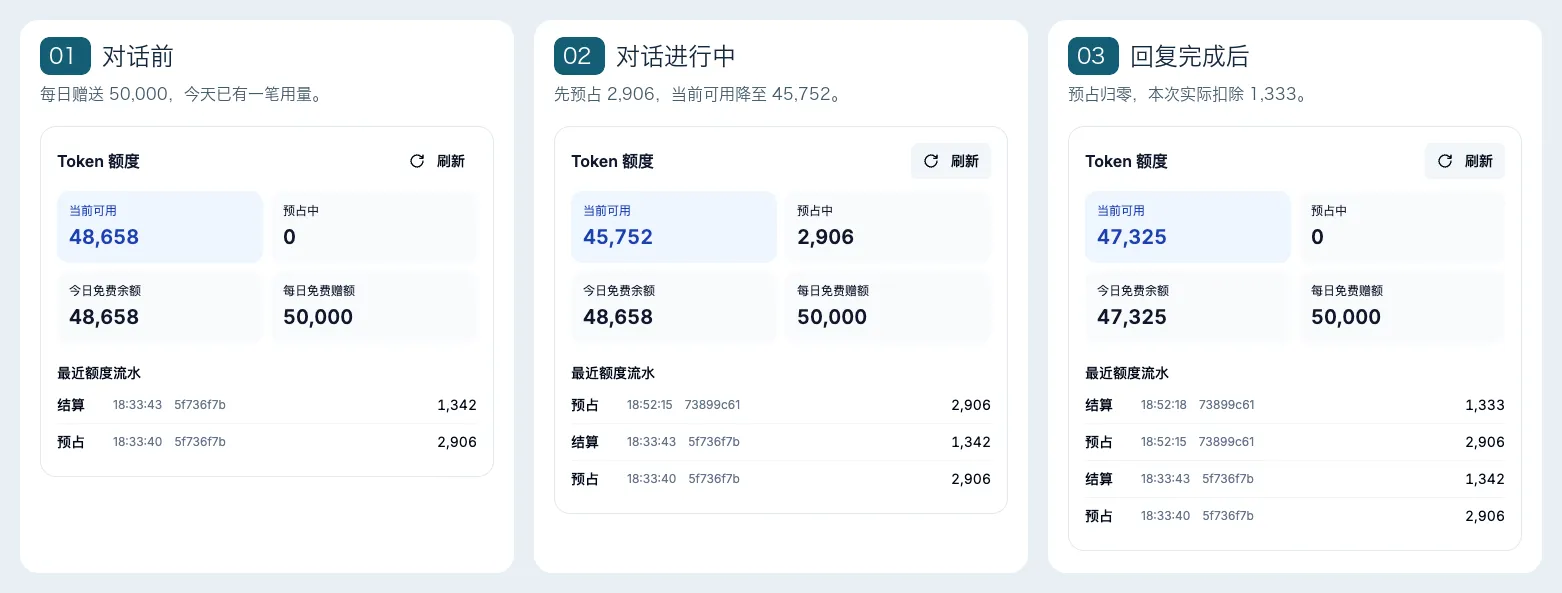
这一圈点下来,每个功能长什么样、输入什么提示词、界面返回什么结果,你心里就全有画面了。
带着这份真实的体验再去看设计文档和源码,抽象的类和接口就能跟页面上的操作对上号了。
第二步,把你喜欢的内容抄到简历上
你没看错,第二步就是先把简历写出来。
很多同学都有一个心理包袱,总觉得要把每个模块的每一行代码都吃透,才敢往简历上写项目。结果啃了一个月还没动笔,秋招春招的黄金投递期就错过了。
换个思路效率会高很多。
打开专栏里的《求职派如何写简历》,挑出你最感兴趣、最贴合目标岗位的 1 到 2 个方向,先抄下来,再改写成自己的简历初稿。后面的源码阅读和面试准备,全部围绕简历上的内容展开,目标一下子就清楚了。
下面三个方向在面试中问得最多,你可以优先从中选一两个当突破口。
- IM Gateway 与多租户消息路由:接入微信、钉钉、飞书和 WebSocket 四个渠道,入口按消息唯一标识去重,再通过事件总线解耦;三级意图路由减少大模型的调用次数;用户文件用分段锁加原子替换,防止并发写入时互相覆盖。
- **Harness 与 Context Engineering:**按内容的稳定程度把系统提示词拆成六层,提高 Prefix Cache 的命中率;用 Lucene 按需筛选工具,只把用得上的工具 Schema 交给模型;流式输出的同时完成多步工具调用。
- Lucene 9 混合检索与数据治理:用 Lucene 9 实现关键词加向量的混合检索,能正确搜到 C++、C#、.NET 这类带符号的技术词,再用 RRF 融合排序;Playwright 并发池采集岗位时防止 SSRF 攻击,质量评分低于 80 分的岗位草稿交给 LangGraph4J 走人工审批。
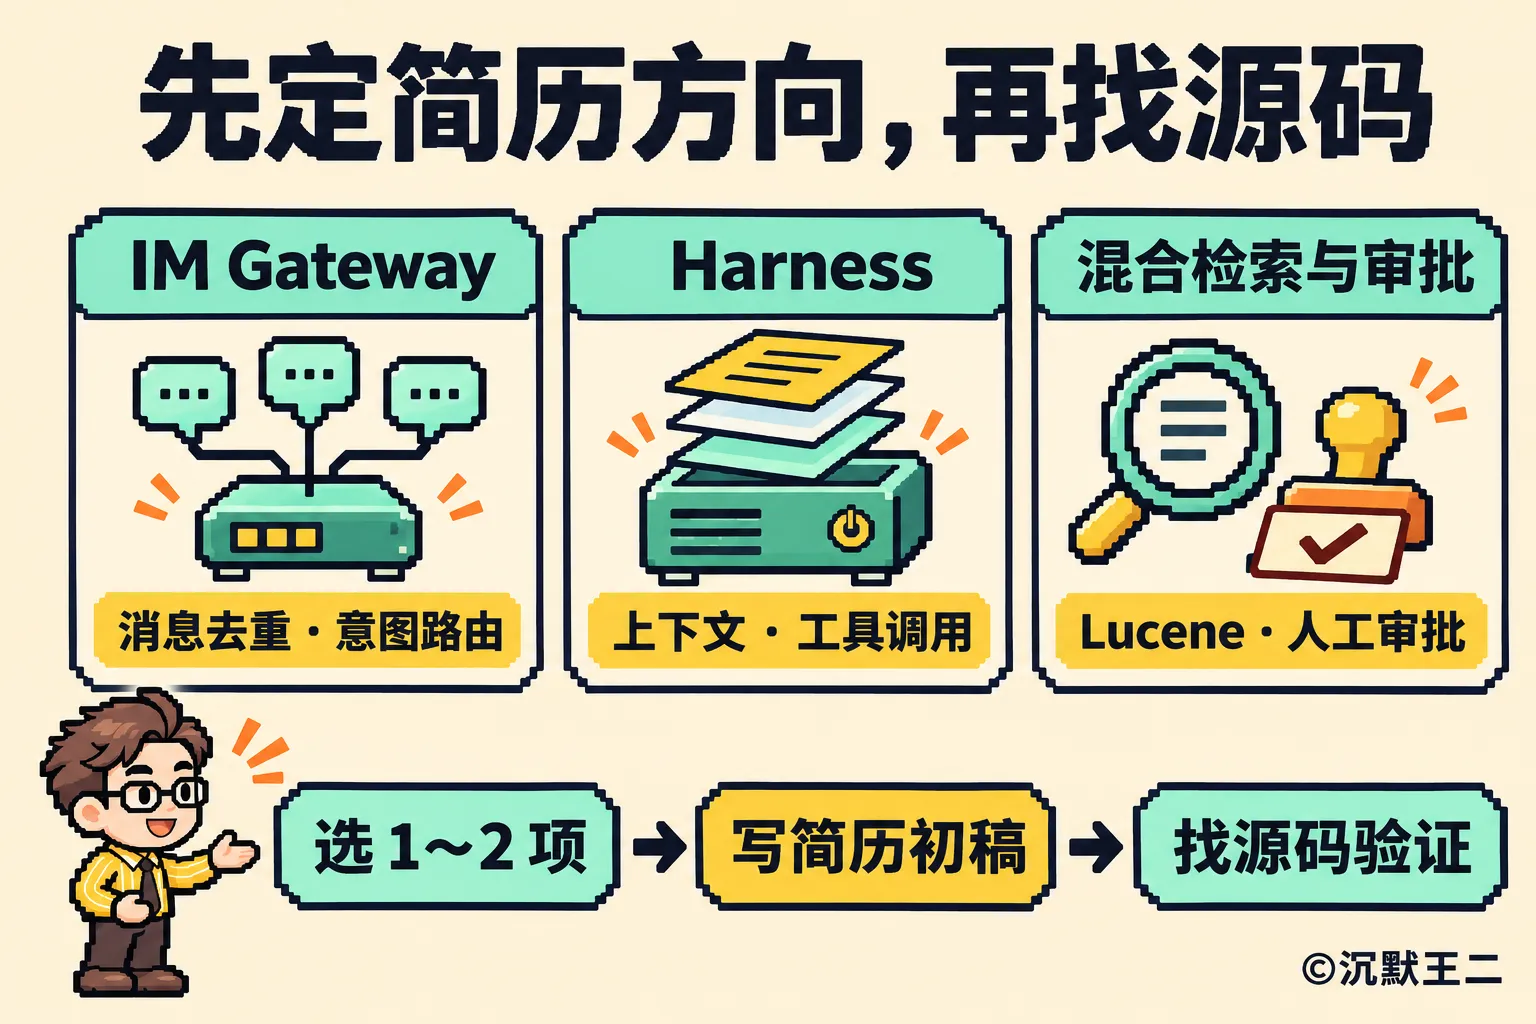
这里强调一条改简历的规矩。
上面的示例里一个内部自定义类名都没写,用的全是业界通用的后端和 Agent 工程术语。面试官没看过求职派的源码,简历上写清楚技术栈、解决了什么问题和可以验证的指标就够了。写完初稿后,可以拿到星球里找我一对一修改。
第三步,针对简历,深入源码和面试题
简历上的突破口定好之后,就进入源码阅读阶段。
先别急着去看业务代码。花一天时间把《求职派需求分析》和《求职派整体设计方案》通读一遍。
求职派用 Spring Modulith 管理模块边界,仓库里专门准备了一条校验模块结构的单元测试,把它跑通,模块之间谁能依赖谁就一清二楚了。
这一步的目的,是把第一篇里讲过的 core、channels、providers、plugins、agents 和 app 六大模块搞清楚边界。
接下来按你在第二步选定的简历方向,对照下面这张表逐块深入。
| 简历主攻方向 | 源码所在模块 | 重点看什么 |
|---|---|---|
| IM Gateway 与意图路由 | channels、core 的路由部分 | 渠道接入、消息去重和意图分流 |
| Harness 与 Agent Loop | core 的记忆、工具和推理循环部分 | 六层提示词组装、工具按需筛选和流式多步调用 |
| Lucene 9 混合检索与求职 Agent | plugins 的职位库、agents | 混合检索打分、岗位匹配诊断和模拟面试 |
| Playwright 采集与断点审批 | plugins 的 Playwright 部分、app 的 Agent 部分 | 网址安全校验、低分草稿挂起和人工审批 |
| 配额计费与离线评测 | core 的配额、app 的用户部分 | 额度预扣与结算和评测用例 |
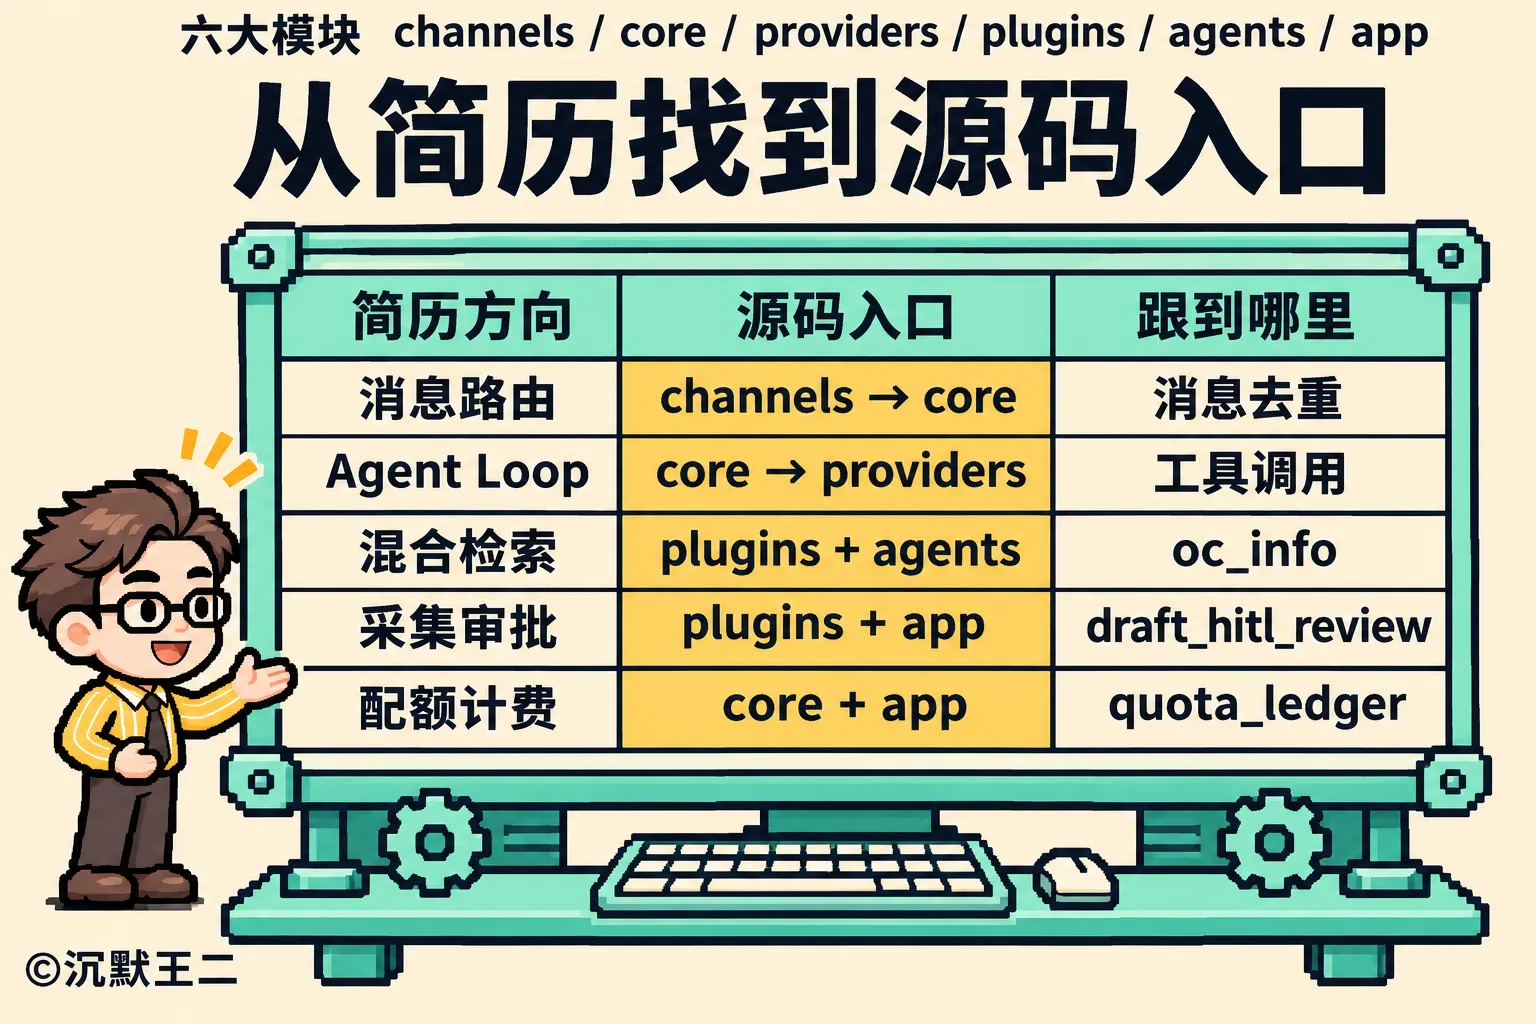
具体怎么啃源码才不走神,我推荐三个方法。
01、删掉重写
不少同学问我要不要把求职派从 0 到 1 手敲一遍。没必要花那么多时间,我更推荐“删掉重写法”。
挑一个你写进简历的核心方法,比如上下文预算的组装逻辑,或者混合检索的融合打分。看懂思路之后,把方法体删掉,不看参考代码自己重新写一遍,能编译通过并让对应的单元测试跑通。
当然了,你也可以让 Codex 这类工具来帮你完成,看看自己的提示词到不到位。
跑完,再让 Codex 帮你跑一遍评测集。
别光看到测试通过就关掉终端。我建议你顺手做个小实验,打开混合检索的代码,把岗位名称字段的权重从 2.5 调到 1.0,再跑一遍评测。
我用同一份评测集跑了两遍。岗位名称的权重从 2.5 调到 1.0 后,Recall@10 两次都是 100%,NDCG@10 从 98.52% 升到了 98.65%,提高了 0.13 个百分点。
另外也要分清离线回归测试和线上真实调用的区别,自己配好真实的模型密钥,抽测十几条复杂的搜索岗位请求,记下真实的耗时和 Token 消耗。
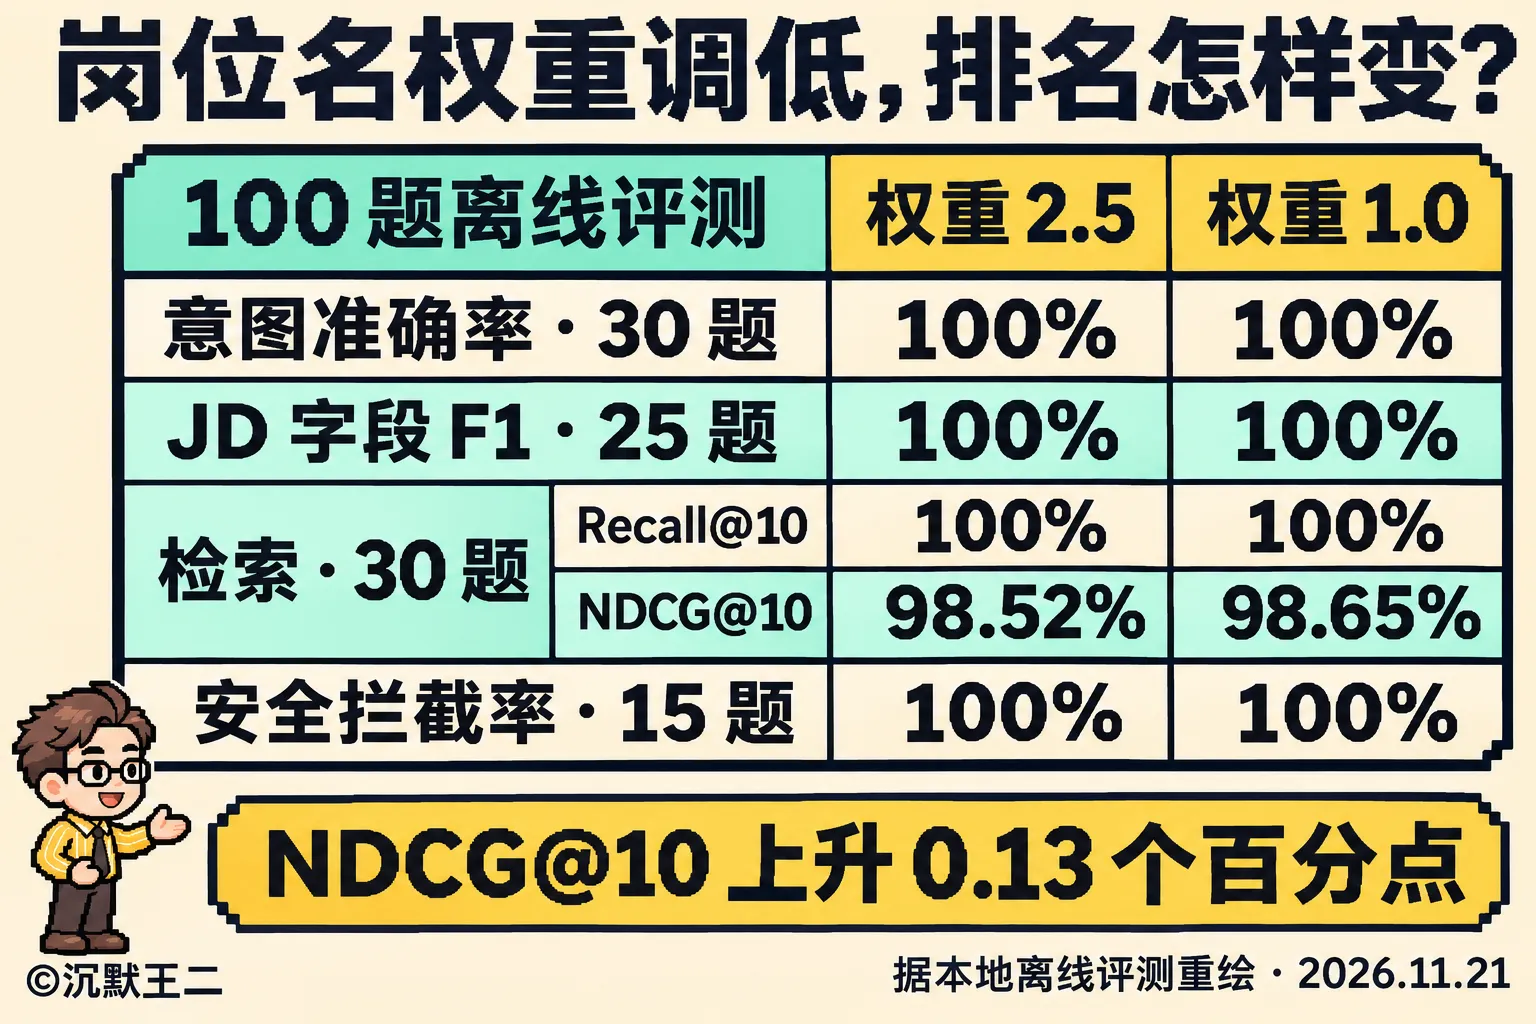
亲手调过参数、看过指标波动,面试官追问“你的量化数据是怎么测出来的”,你才能稳稳接住啊(非 AI 写)。
02、用好 AI 工具和星球
在仓库根目录打开 Claude Code、Codex 或者 Qoder,让它顺着渠道接入到消息路由帮你画出调用顺序,或者让它对照 providers 下的三个子模块,讲清楚升级到 Spring Boot 4 之后 Jackson 3 和 Jackson 2 是怎么隔离的。把 AI 当成随时在线的架构师,能省下大量的时间。
如果在某个环境报错或者设计取舍上卡壳了,别自己死磕,带着报错日志和你排查过的步骤去星球发帖,我和球友们看到都会帮你一把。
03、对照面试篇
源码啃完一块,紧接着去看对应的面试题预测篇。
- 《架构设计、SaaS 与多端 IM Gateway 面试题预测》:重点是四个渠道的 Webhook 幂等处理和分段锁文件隔离。
- 《Harness、Prefix Cache 与 Agent Loop 面试题预测》:重点掌握前缀缓存、工具按需筛选、多步工具调用和跨线程的链路追踪。
- 《Lucene 9 混合检索与 LangGraph4J 面试题预测》:重点看几万条岗位数据为什么选 Lucene 9 而不选 ES 集群、RRF 融合排序,以及低置信度草稿的挂起和恢复,涉及到 Checkpoint。
- 《配额计费、GenAI 可观测与离线评测面试题预测》:重点看 TCC 三阶段(预扣、结算、释放)配合乐观锁的并发控制和评测指标的计算方法。
面试要的是能围绕一两个亮点跟面试官有来有回地聊。
背题不是目的,是让你在脱稿的情况下心里有底,打开手机录音,花三分钟把一个技术选型的取舍完整讲出来,回放听听哪里卡壳了,再回去补。
第四步,让 AI 写代码
以前学项目,绕不开在 IntelliJ IDEA 里打断点,一行行盯着变量走。
到了 Opus 5.5、GPT-6.2 Astra、Gemini 4 Neon 这一代,这套办法已经过时了。说句实话,我现在已经不看代码了,代码交给 Claude Code 和 Codex 去写,我只管说清楚要什么,再检查它做得对不对。
但这不代表工程能力不重要了,而是换了一种方式。以前比的是谁代码敲得快、写的优雅,还记得《代码整洁之道》这本书吗,我已经很信奉;现在比的是谁能把需求讲清楚,让 Agent 做出你想要的预期。
拿求职派来说吧。
①、**先把规矩写给 AI:**在仓库根目录打开 Claude Code 或 Codex,让它通读整个工程,帮你整理一份项目说明,写进 CLAUDE.md 或 AGENTS.md。当然,你们可以看求职派的这俩文件是怎么写的。
或者你也可以用我这句提示词去审查一下求职派,用你的 Agent。
检查一下 CLAUDE.md 和 AGENTS.md,看看这俩文件的内容是否写的符合你的预期,如果你来做求职派这个项目,你会怎么去写这俩文件,从而让你写出更优雅的代码,或者让 Claude Code 和 Codex 或者 Gemini 4 Neon 去写出更好的代码
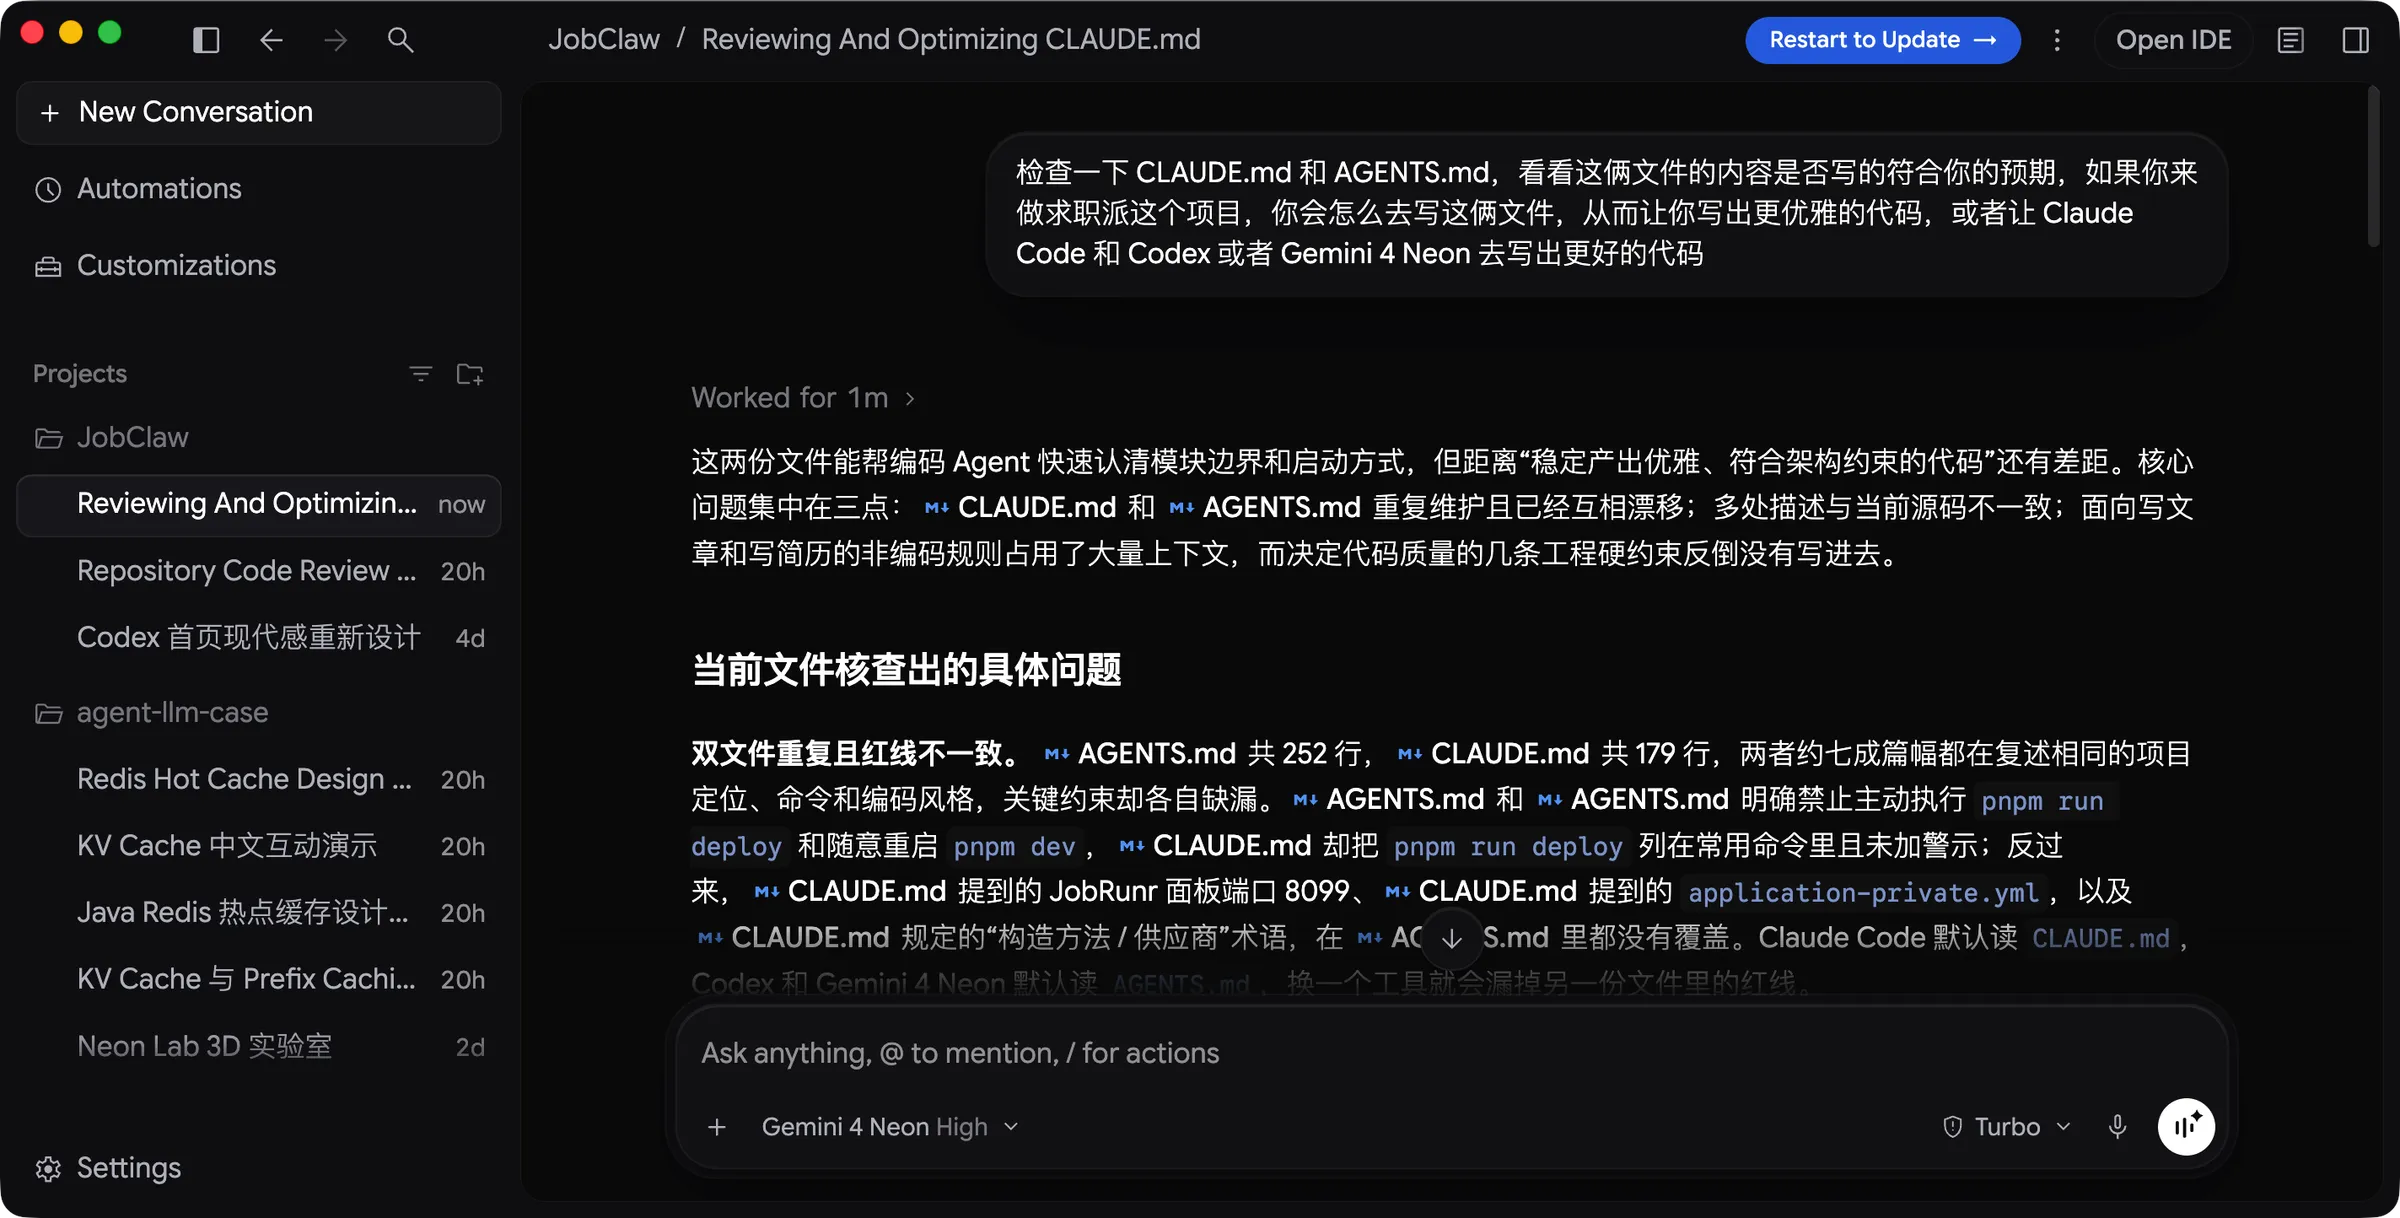
②、让 AI 代替断点:不用再自己打断点,直接给它布置任务,比如“在关键位置加上临时日志,启动服务,通过接口发一句‘帮我找杭州 25K 以上的 Agent 应用开发岗位’,然后按顺序讲清楚这句提示词经过了哪些模块、每一步做了什么”。加日志、跑服务、看输出。
③、自己当甲方,提一个小需求:比如给投递看板加一个筛选条件,或者让岗位匹配诊断多给一条补强建议。先让 AI 只出方案、不改代码(Claude Code 里按 Shift+Tab 切到计划模式)。方案出来后,你重点看三件事,改动哪几个模块,要补哪些测试。方案没问题了(至少你是能看懂,能把控的),再让它动手。
④、验收比写代码更重要:AI 说“已完成”不算数,得你自己确认。或者说,你得学会用多个 Agent 互相验证。
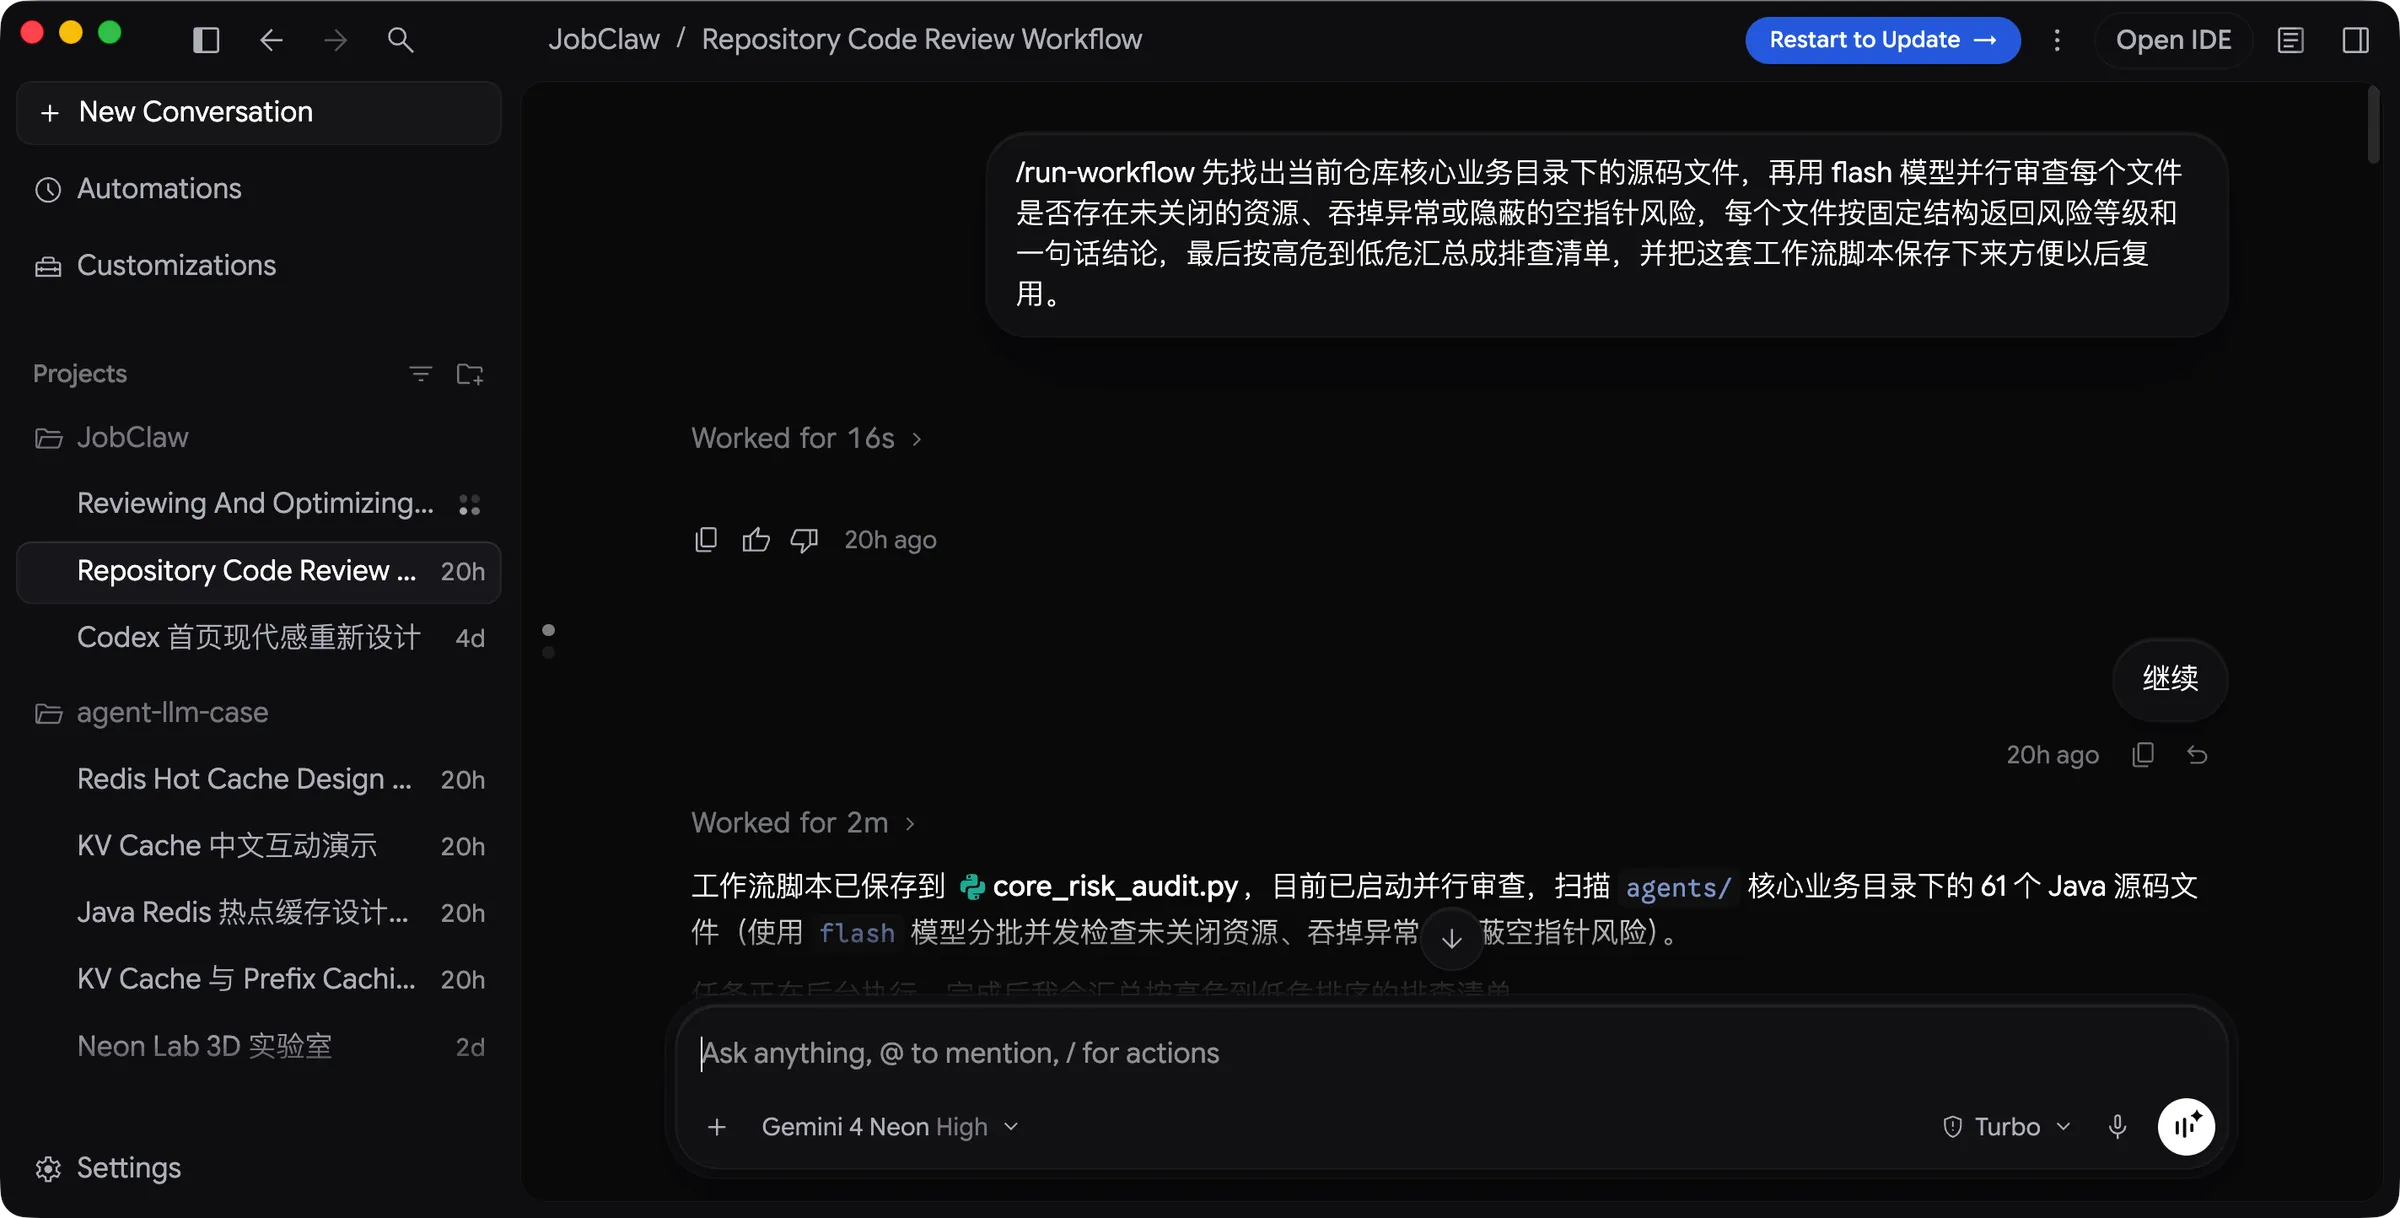
比如说这句提示词。
/run-workflow 先找出当前仓库核心业务目录下的源码文件,再用 flash 模型并行审查每个文件是否存在未关闭的资源、吞掉异常或隐蔽的空指针风险,每个文件按固定结构返回风险等级和一句话结论,最后按高危到低危汇总成排查清单,并把这套工作流脚本保存下来方便以后复用。
能排查出来问题,说明你真的有驾驭了你的 Agent 工具。
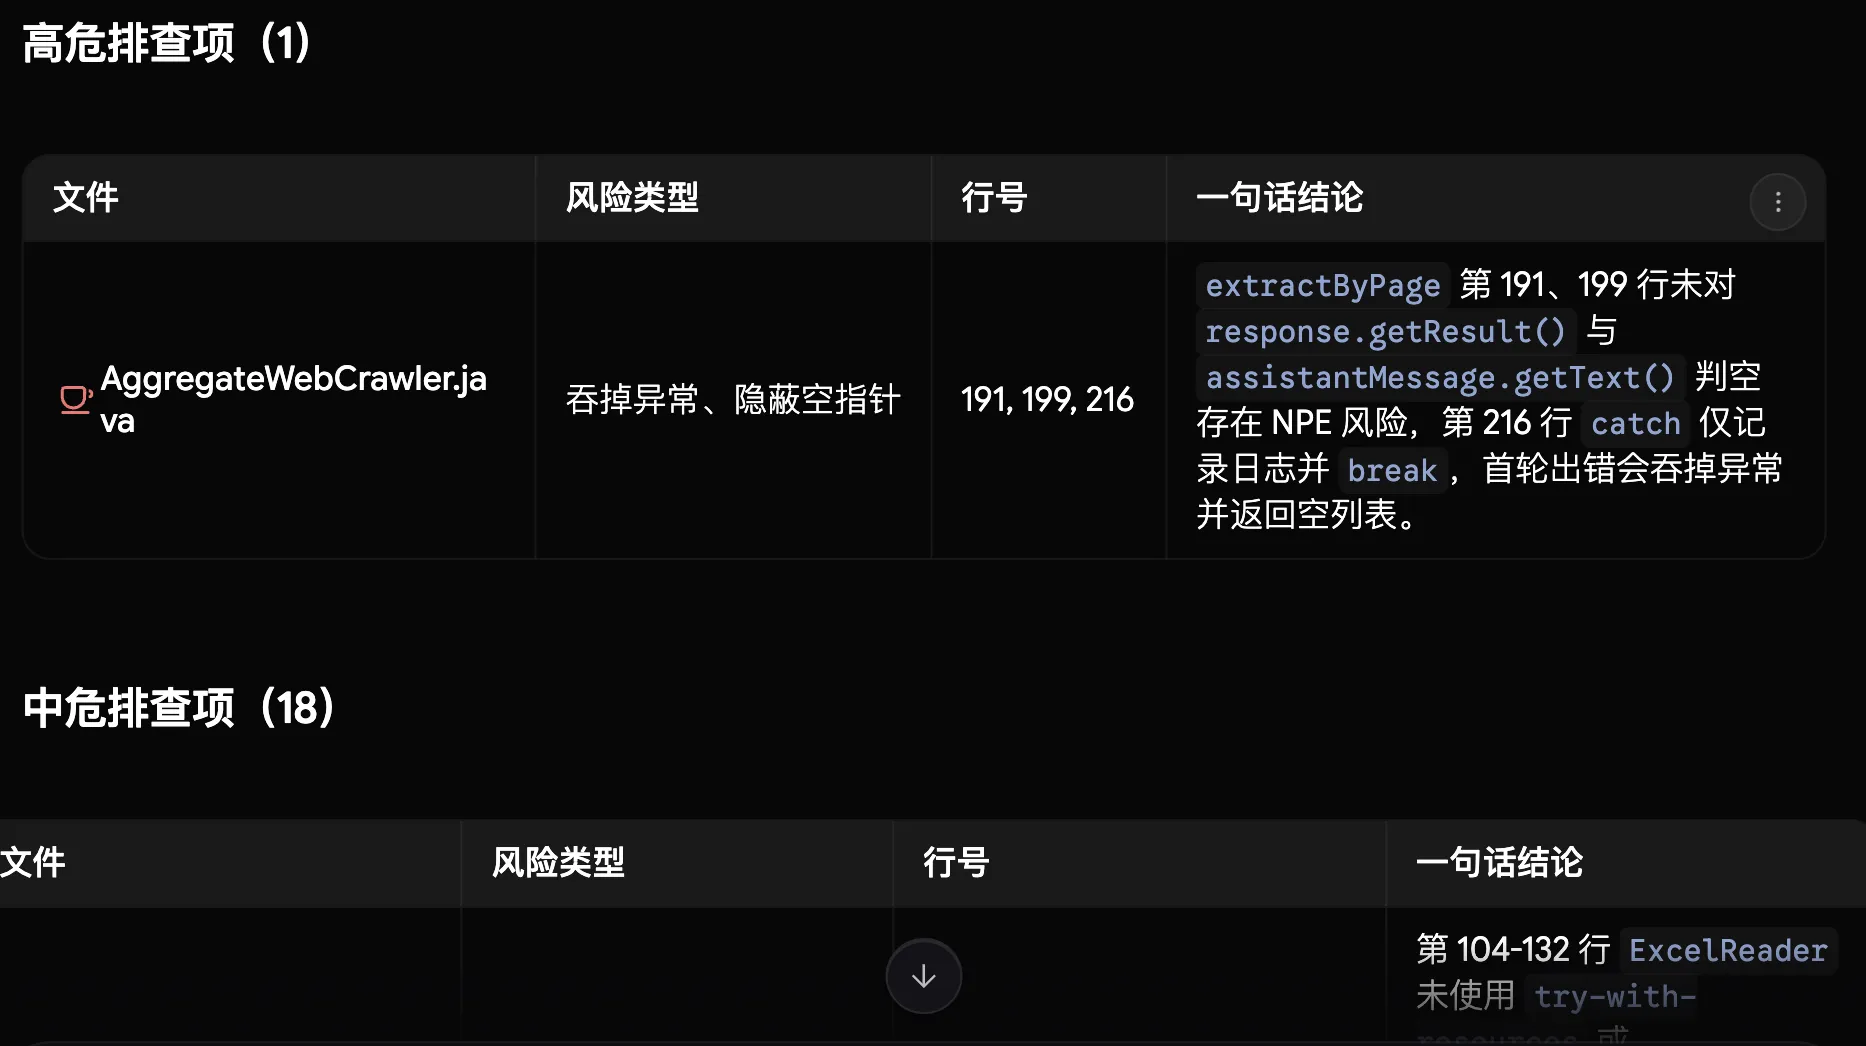
这一路走下来,面试官再问“这个功能你是怎么做的”,你讲的就不只是代码,而是从拆解需求、定方案到验收的完整过程,这恰恰是现在用 AI 写代码最看重的能力。
第五步,总结归纳,输出倒逼输入
学完之后如果不做输出,过两周就会忘掉。
我建议你做三件小事,把学到的东西巩固下来。
第一,自己用 Codex 画一张求职派的架构图,把用户交互和岗位采集审批两条线弄明白;
第二,把你踩过的发到星球打卡,能用大白话给别人讲明白,才说明你自己真的懂了;
第三,打开本地跑起来的求职派,用 /interview 命令让模拟面试官对着你的项目经历连续追问,提前适应面试节奏。
我把教程排成了 14 天和 21 天两份计划表,大家按自己的节奏选一份存下来。
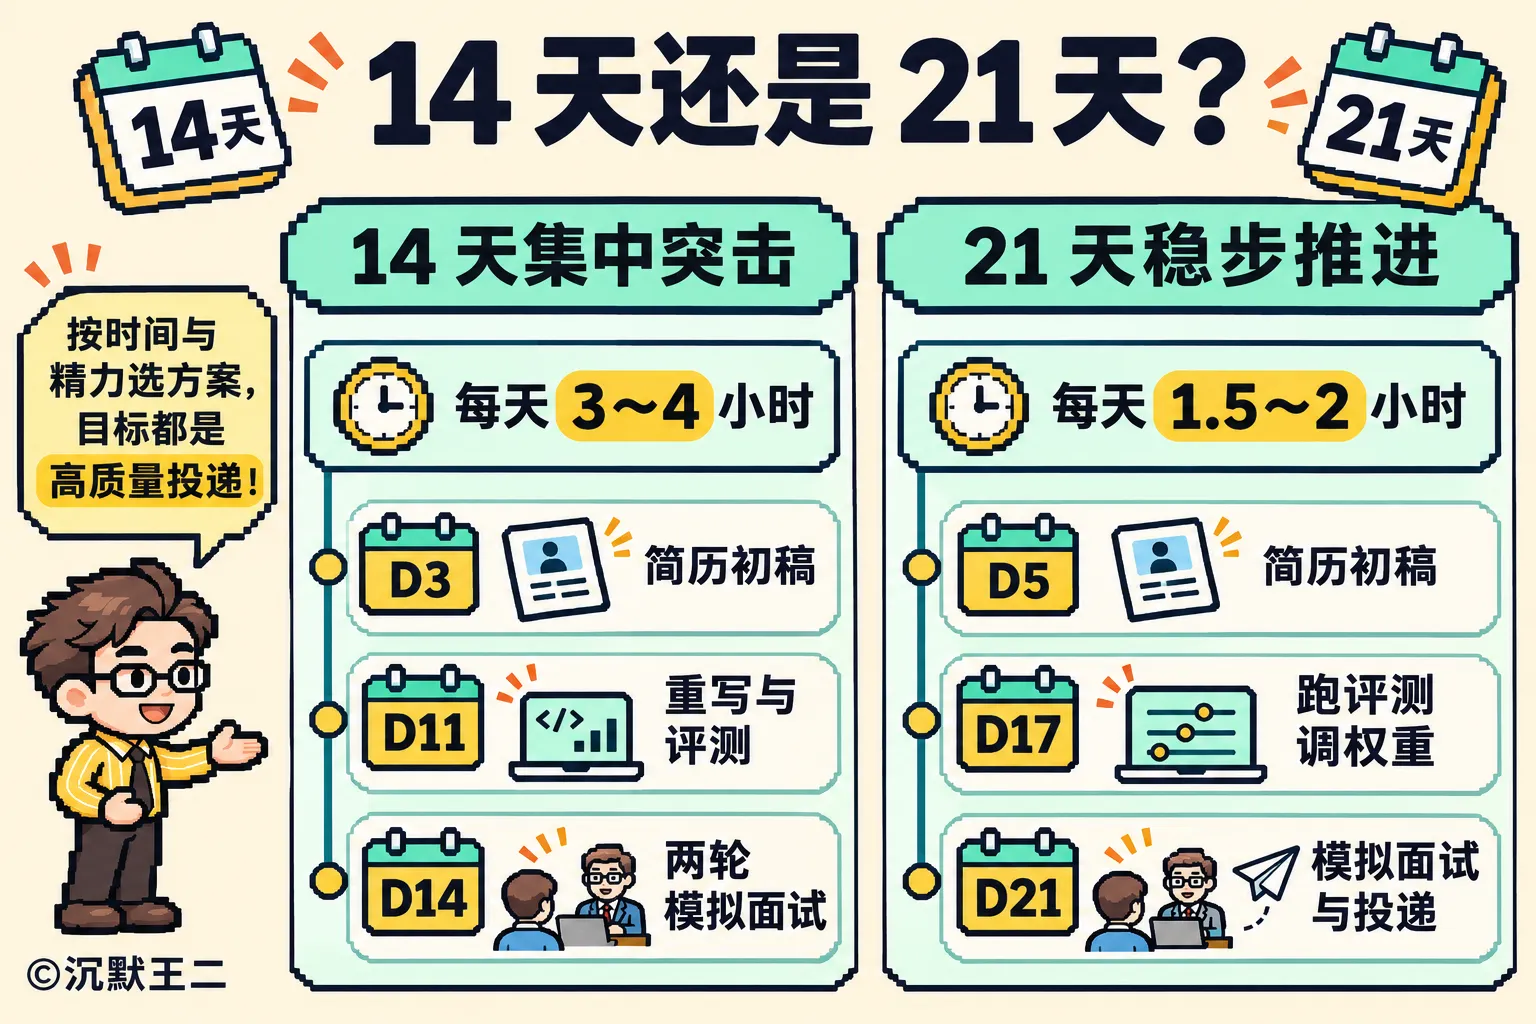
01、14 天集中突击计划(每天 3 到 4 小时)
适合冲刺秋招春招,或者已经拿到面试邀约的同学。
| 天数 | 当天的阅读与动手目标 |
|---|---|
| 第 01 天 | 了解项目定位和学习路线,申请仓库权限并把源码拉到本地 |
| 第 02 天 | 配好 JDK 21、MySQL 8 和环境变量,启动服务,体验斜杠命令和 Docker 部署 |
| 第 03 天 | 选定 1 到 2 个主攻方向,写出求职派简历初稿,明确后面要重点啃的源码 |
| 第 04 天 | 精读需求分析和整体设计,跑通模块结构校验测试,让 AI 整理一份项目说明,手绘模块关系图 |
| 第 05 天 | 跟读四个渠道的 IM Gateway、消息去重和意图路由,让 AI 加日志讲清一条消息的完整链路 |
| 第 06 天 | 跟读六层上下文预算、工具按需筛选和流式 Agent Loop,让 AI 讲清六层提示词是怎么组装的 |
| 第 07 天 | 跟读 Lucene 9 混合检索、匹配诊断和模拟面试 Agent,让 AI 讲清混合检索是怎么打分排序的 |
| 第 08 天 | 跟读 Playwright 并发池、SSRF 防护和 LangGraph4J 检查点人工审批的源码 |
| 第 09 天 | 跟读微信支付 V3、TCC 三阶段配额流水、MCP 客户端与服务端以及安全围栏的源码 |
| 第 10 天 | 对照库表设计和接口文档,发一次请求,核对核心表字段和本地画像文件的变化 |
| 第 11 天 | 做删掉重写练习,让 AI 按方案实现一个小需求,再用 100 道离线评测题验收并调权重观察指标变化 |
| 第 12 天 | 吃透网关架构和 Harness 运行时的面试题,用手机录音完成第一轮脱稿复述 |
| 第 13 天 | 吃透混合检索、LangGraph4J 审批和配额计费评测的面试题,把简历定稿 |
| 第 14 天 | 用本地求职派的 /interview 做两轮模拟面试,把卡壳的问题整理成自己的高频笔记 |
02、21 天稳扎稳打计划(每天 1.5 到 2 小时)
适合在职准备跳槽,或者在校只能挤出晚上时间推进的同学。
| 天数 | 当天的阅读与动手目标 |
|---|---|
| 第 01 天 | 通读开篇全景和五步学习路线,定好自己的学习节奏 |
| 第 02 天 | 开通源码权限,检查本地的 JDK 21 和 MySQL 8.0,准备好模型 API Key |
| 第 03 天 | 配好环境变量,从仓库根目录启动服务,亲手体验搜岗、/match、/interview 和投递看板 |
| 第 04 天 | 演练 Docker 部署流程,熟悉健康检查和常见的启动报错排查 |
| 第 05 天 | 参考简历专篇选定 1 到 2 个核心方向,先写出简历初稿放在手边 |
| 第 06 天 | 精读需求分析,理清用户交互、岗位采集审批和配额计费三大业务边界 |
| 第 07 天 | 精读整体设计方案,对照 pom.xml 跑通模块结构校验测试,让 AI 整理一份项目说明,摸清六大模块 |
| 第 08 天 | 跟读 channels 下的四个渠道子模块,理清消息格式适配、去重和事件总线 |
| 第 09 天 | 跟读意图路由和三层画像的分段锁读写,让 AI 加日志走一遍完整的消息流程 |
| 第 10 天 | 跟读两级模型路由降级和六层前缀缓存的组装逻辑,让 AI 讲清每一层装了什么 |
| 第 11 天 | 跟读工具按需筛选、流式 Agent Loop 和跨线程链路追踪 |
| 第 12 天 | 跟读混合检索里的分词、薪资过滤、BM25 关键词检索、HNSW 向量检索和 RRF 融合排序,让 AI 讲清每一步怎么影响排名 |
| 第 13 天 | 跟读岗位匹配度诊断 Agent、投递看板联动和 VIP 四阶段模拟面试 Agent |
| 第 14 天 | 跟读 Playwright 并发池、双层 SSRF 防护和长文本对半切分防截断的提取逻辑 |
| 第 15 天 | 跟读 LangGraph4J 的数据库检查点、80 分及以上自动入库和人工审批的挂起与恢复 |
| 第 16 天 | 跟读微信支付 V3、三种额度的扣减顺序,以及乐观锁加 TCC 三阶段的配额流水 |
| 第 17 天 | 跟读 MCP 客户端与服务端的令牌鉴权、双层安全围栏,跑通 100 道离线评测题并做调参实验 |
| 第 18 天 | 结合库表设计和接口文档,把请求入口到 MySQL 表和本地 YAML 文件的整条链路串起来 |
| 第 19 天 | 做删掉重写练习,再让 AI 按方案实现一个小需求,用测试和评测集完成验收 |
| 第 20 天 | 精练四篇预测面试题,提交简历做一对一精修 |
| 第 21 天 | 脱稿录音复述项目整体介绍和核心追问,用 /interview 实战演练,然后开始投递 |
路线图和计划表都有了,去把仓库权限申请下来,动手把求职派跑起来吧。
未能定位到原文的划线
真诚点赞 诚不我欺
回复