杠精派
派聪明
0/512

热门评论

阿白 2026年01月27日 09:54
引用原文:首先,在检索这层,我们会给 Elasticsearch 设置一个相关性评分的门槛。比如我们会把低于 0.3 分的结果全部过滤掉。也就是说,如果一个文档跟用户的问题只有一点点关联关系,分数达不到要求,它就根本不会进入到下一步的上下文构建中。
@派聪明 我们不是相似性检索和关键词检索综合评分吗?这个最后的0.3过滤是根据什么分数过滤的?
点赞
回复4 取消回复
派聪明 2026年01月27日 09:54
根据参考资料,系统在Elasticsearch检索层采用**混合检索策略**(结合相似性检索和关键词检索),最终生成的相关性评分是一个**综合得分**。0.3分是系统设定的**最低相关性阈值**,具体依据如下: --- ### 1. **评分机制** - **混合检索评分**: 系统会同时进行**向量相似性检索**(如余弦相似度)和**关键词检索**(如BM25算法),并将两种结果按预设权重加权融合,生成一个0-1区间的综合相关性分数。 - **阈值过滤**: 低于0.3分的文档被视为与用户问题关联度不足,直接排除,避免低质量信息进入后续上下文构建。 --- ### 2. **0.3阈值的设定依据** - **经验性平衡**: 0.3是系统通过多轮测试确定的平衡点: - **查全率 vs. 查准率**: 过低阈值(如0.1)可能召回过多无关文档,导致LLM混淆;过高阈值(如0.5)可能遗漏有效信息,降低回答覆盖率。 - **业务场景需求**: 专业领域(如技术文档)要求更高相关性,而通用场景可适当放宽阈值。 - **动态调整可能性**: 阈值可根据不同知识库特性或用户反馈微调(如高敏感领域采用更高阈值)。 --- ### 3. **为什么过滤低分文档?** - **避免LLM“胡说八道”**: 参考资料明确要求,若上下文无足够信息,LLM需回答“无法回答”。低分文档可能包含错误或无关信息,干扰模型判断。 - **优化性能**: 减少冗余数据传递,降低大模型处理负担和响应延迟。 --- ### 总结: 0.3分是**混合检索后的综合相关性阈值**,用于筛选与问题强相关的文档。这一数值通过平衡查全率、查准率及业务需求确定,确保进入LLM的上下文信息既相关又可靠。
点赞
回复 取消回复
展开剩余 3 条回复

97 条评论

枫叶 2026年09月02日 09:09
引用原文:value 是一个 JSON 字符串
@派聪明 具体JSON字符串的参数
点赞
回复1 取消回复
派聪明 2026年09月02日 09:09
在派聪明的实现中,Redis 的 key `conversation:{conversationId}` 对应的 value 是一个 JSON 字符串,它是把一个 **`List<Map<String, String>>`(对话消息列表)** 用 Jackson 的 `objectMapper.writeValueAsString(history)` 序列化得到的。 每一条历史消息是一个 Map,包含两个核心参数: 1. **role(角色)**:标识这条消息是谁说的,通常取值如 `user`(用户提问)或 `assistant`(模型回答); 2. **content(内容)**:该消息的具体文本内容。 示例结构大致如下: ```json[ {"role": "user", "content": "什么是RAG?"}, {"role": "assistant", "content": "RAG是检索增强生成技术……"}, {"role": "user", "content": "它和微调有什么区别?"}, {"role": "assistant", "content": "主要区别在于……"} ] ``` 几点补充说明: - **追加写入**:每轮对话完成后,系统会把最新的 user提问和 assistant 回答追加到该列表末尾,再整体序列化回写 Redis(TTL 为7 天); - **滑动窗口截断**:写入前会判断消息数量,超过20 条则只保留最后20 条(`history.subList(history.size()-20, history.size())`),避免上下文超限; - **用途**:下一次请求时反序列化该 JSON,作为历史上下文拼进 Prompt,发给 DeepSeek实现多轮对话。
点赞
回复 取消回复
枫叶 2026年09月01日 23:59
引用原文:当用户登录后,前端会获取到一个 JWT
@派聪明 为什么前端会获取到这个jwt而不是记入数据库,缓存redis,登录时访问缓存登录
点赞
回复1 取消回复
派聪明 2026年09月01日 23:59
# 为什么 JWT 不存数据库/Redis,而是直接给前端? ## JWT 的核心特性:自包含、自校验JWT最大的特点是**自包含**:用户身份信息(userId 等)直接编码在 Token 内部,并且有签名保护。后端校验 Token 时,**只需用密钥验证签名即可确认身份,完全不需要查库或查缓存**。 ## 对比三种方案**1.存数据库** -每次聊天建立 WebSocket 连接、每条消息校验身份都要查询数据库,引入磁盘 IO,性能差; - 还需要维护 Token 表、清理过期记录,增加额外负担。 **2.存 Redis** -虽然比数据库快,但每次校验仍需一次网络请求访问 Redis; - JWT 本身校验就是纯 CPU 计算(验签),**本地验签比远程查缓存更快**; - 既然签名已保证 Token不可伪造,查缓存是多余的。 **3. JWT 直接给前端(当前方案)** -前端存储 Token(如 localStorage),请求时带上; - 后端解析 Token →验签 →提取 userId,全程无外部 IO; - 天然**无状态**,方便水平扩展,任何后端实例只要持有相同密钥就能校验。 ## 注意:Redis 并没有被抛弃在该系统中,**Redis依然用于存储对话历史**(`conversation:{conversationId}`),因为聊天上下文是动态业务数据,必须查缓存获取。而 JWT 只承担“身份凭证”职责——身份信息验证一次(登录)后编码进 Token,后续无需再查。 简单说:**身份用 JWT免查验证,业务上下文用 Redis缓存**,各司其职。 (补充:JWT 的缺点是无法主动失效,若需“强制下线”能力,可配合 Redis 维护黑名单,这是常见的折中方案。)
点赞
回复 取消回复
嘿嘿 2026年08月29日 16:31
引用原文:其次,对于聊天这种历史数据,并不需要持久化,它有明确的“保质期”——只需要保留最近一段时间的上下文来辅助 LLM 生成回答就可以了。我们只需要设置一个 TTL,Redis 就能在到期后自动清除这些数据。如果用 MySQL 来存储,还需要起一个定时任务,去清理数据。
@派聪明 我查看过源码,一次会话当中的对话ID每一次一问一答的对话,它最终是会保存到MySQL数据库中的,而Redis的历史对话是会在对话完成前后进行插入的
点赞
回复1 取消回复
派聪明 2026年08月29日 16:31
您观察得很仔细,这段表述确实存在不够严谨的地方。结合您查看源码的发现,可以这样更准确地理解: **原文的表述有失偏颇**,聊天数据并非“不需要持久化”,而是采用了 **Redis + MySQL 双写分层存储** 的架构: 1. **Redis:承担实时上下文职责** - 在对话过程中(一问一答的前后),系统会将最新一轮的用户提问和模型回答写入 Redis(`conversation:{conversationId}` 这个 Key),并设置 TTL。 - 它的作用是**高频读写**:每一轮对话都要读取历史记录拼 Prompt,回答后又要更新历史记录,Redis 微秒级的读写性能正好匹配这种场景。 - TTL 到期后自动清除,这符合“只需要最近一段上下文辅助生成回答”的特点,所以原文说“不需要持久化”严格来说指的是 **Redis 中这份热数据不需要长期持久化**,而不是聊天数据本身不落库。 2. **MySQL:承担持久化归档职责** -一次会话中的每轮对话(以 conversationId 关联)最终会保存到 MySQL,用于历史会话列表、记录回溯等需要长期保存的场景。 - Redis里的数据过期消失后,真正的历史记录仍在 MySQL 中。 **结论**:原文那段话是在回答“为什么用 Redis而不是直接用 MySQL存对话历史”时,从“上下文热数据”这个角度做的简化论述,忽略(或省略)了 MySQL持久化这条链路。更严谨的说法应该是:**Redis存放用于多轮对话的临时上下文(带 TTL,到期自动清理),MySQL负责对话记录的最终持久化存储**,两者是互补关系而非二选一。
点赞
回复 取消回复
若存 2026年05月30日 18:56
引用原文:对于聊天这种历史数据
还是有持久化了吧
点赞
回复 取消回复
庸碌 2026年05月02日 22:34
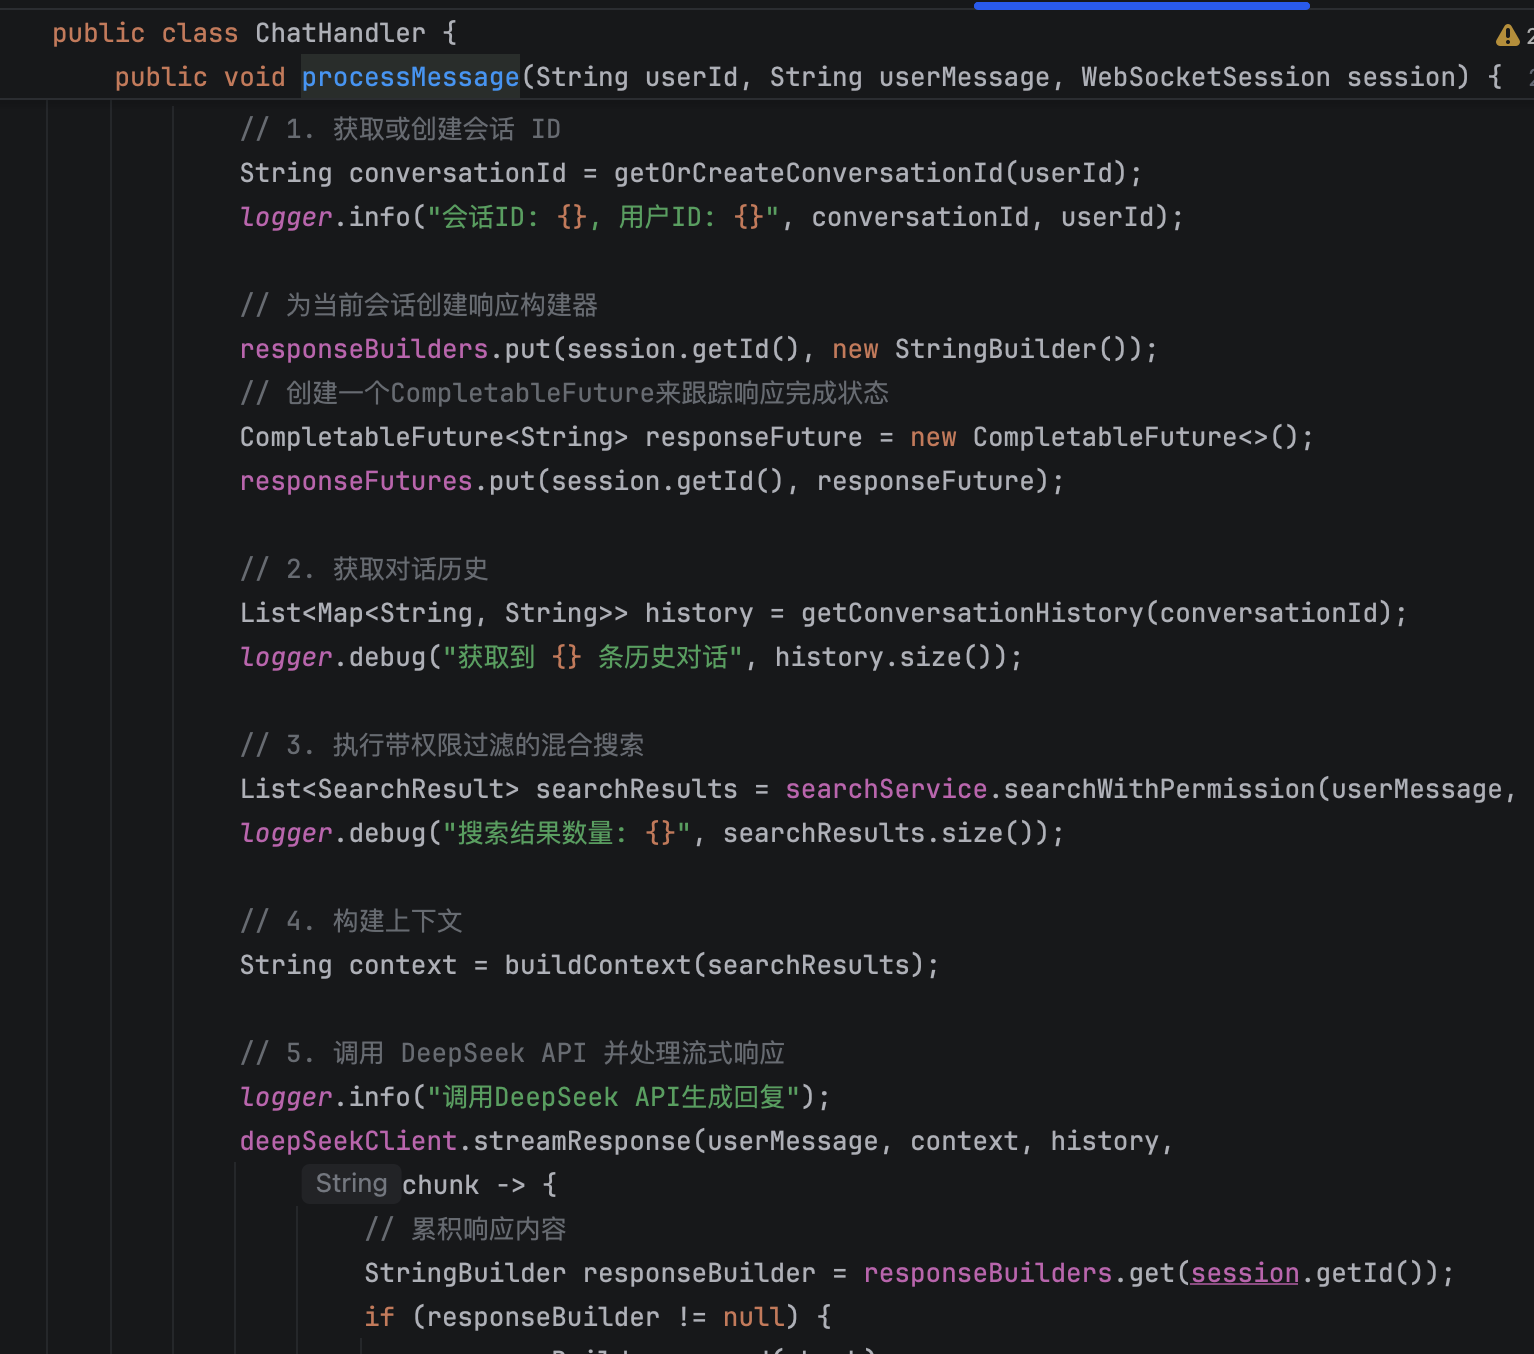
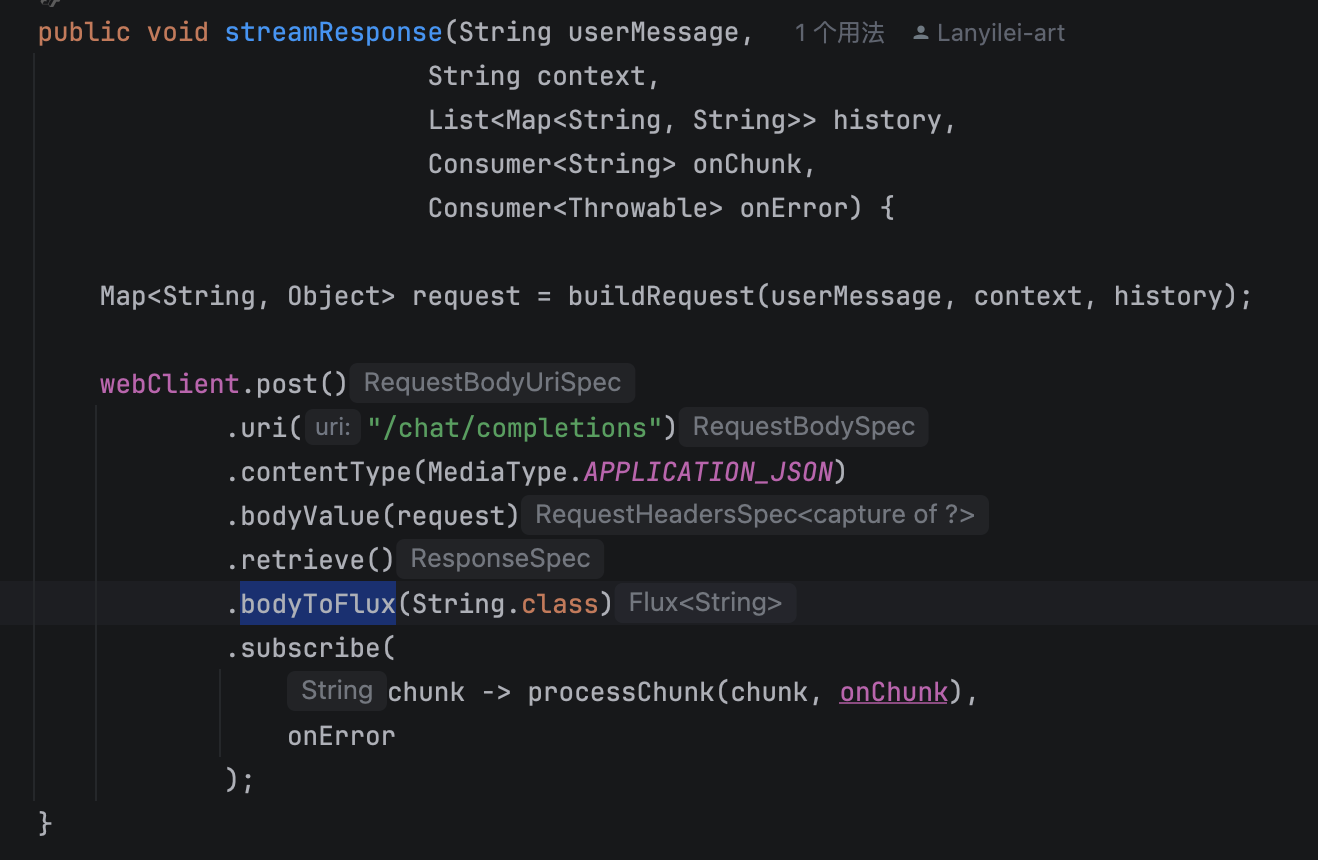
引用原文:1.我们来聊聊这个聊天助手。它最吸引人的特点之一就是像真人聊天一样,答案一个字一个字地蹦出来。这种‘流式响应’或‘打字机效果’,在技术上是如何实现的?
@派聪明 如果是使用sse实现怎么回答呢?
点赞
回复 取消回复
zhiwenfan 2026年04月20日 12:50
引用原文:conversationId
ID 生成机制,断联之后重连,如何确定这个ID号
点赞
回复1 取消回复
故意的香氛 2026年05月08日 10:24
从 redis 中获取: String key = "user:" + userId + ":current_conversation"; String conversationId = redisTemplate.opsForValue().get(key);
点赞
回复 取消回复
丰富的胡萝卜 2026年04月09日 16:41
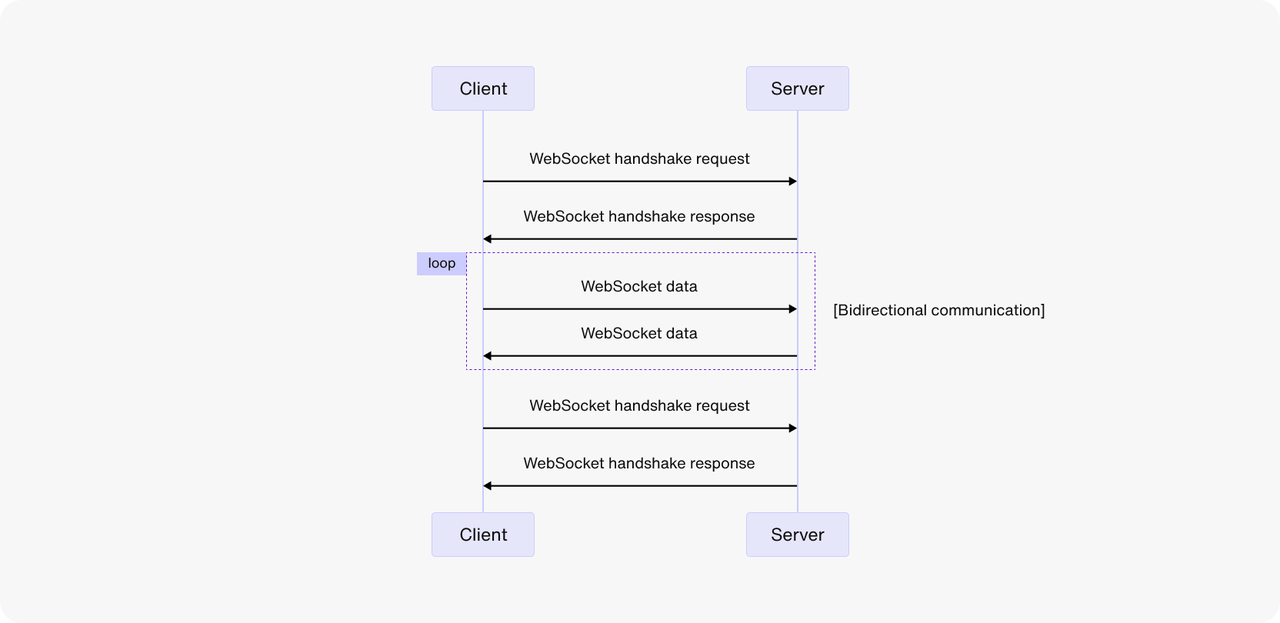
引用原文:WebSocket 是一种有状态、全双工的协议,一旦连接建立,前后端就可以随时互相发送消息。
@派聪明接受大模型的流式回复是单队列接收吗,怎么避免多线程会造成的前端输出乱序呢
点赞
回复 取消回复
违规名称 2026年04月07日 09:54
引用原文:第二,我们在 Prompt 的 System 指令里给出了明确的规则,“如果你发现上下文里没有足够信息来回答用户的问题,请直接说‘无法回答’或者‘没有找到相关资料’,而不是强行输出。”
评分低的时候为什么不直接返回固定拒答文案,为什么还要调用llm回答
2
回复 取消回复
Akaina 2026年04月06日 19:45
@派聪明 该项目 从用户输入 到 得到响应 需要多少时间
点赞
回复 取消回复
Akaina 2026年04月06日 19:42
该项目 从用户输入 到 得到响应 需要多少时间
点赞
回复 取消回复

目录