
面试结束后,我反问:“就面个实习至于上这么大强度吗?”面试官:“你对 RAG、Agent、MCP、Skill 理解得很到位,所以要求高一点。”
滴滴一面,派聪明RAG面经
但讲老实话,这次面试确实顶,顶到肺了快。😄
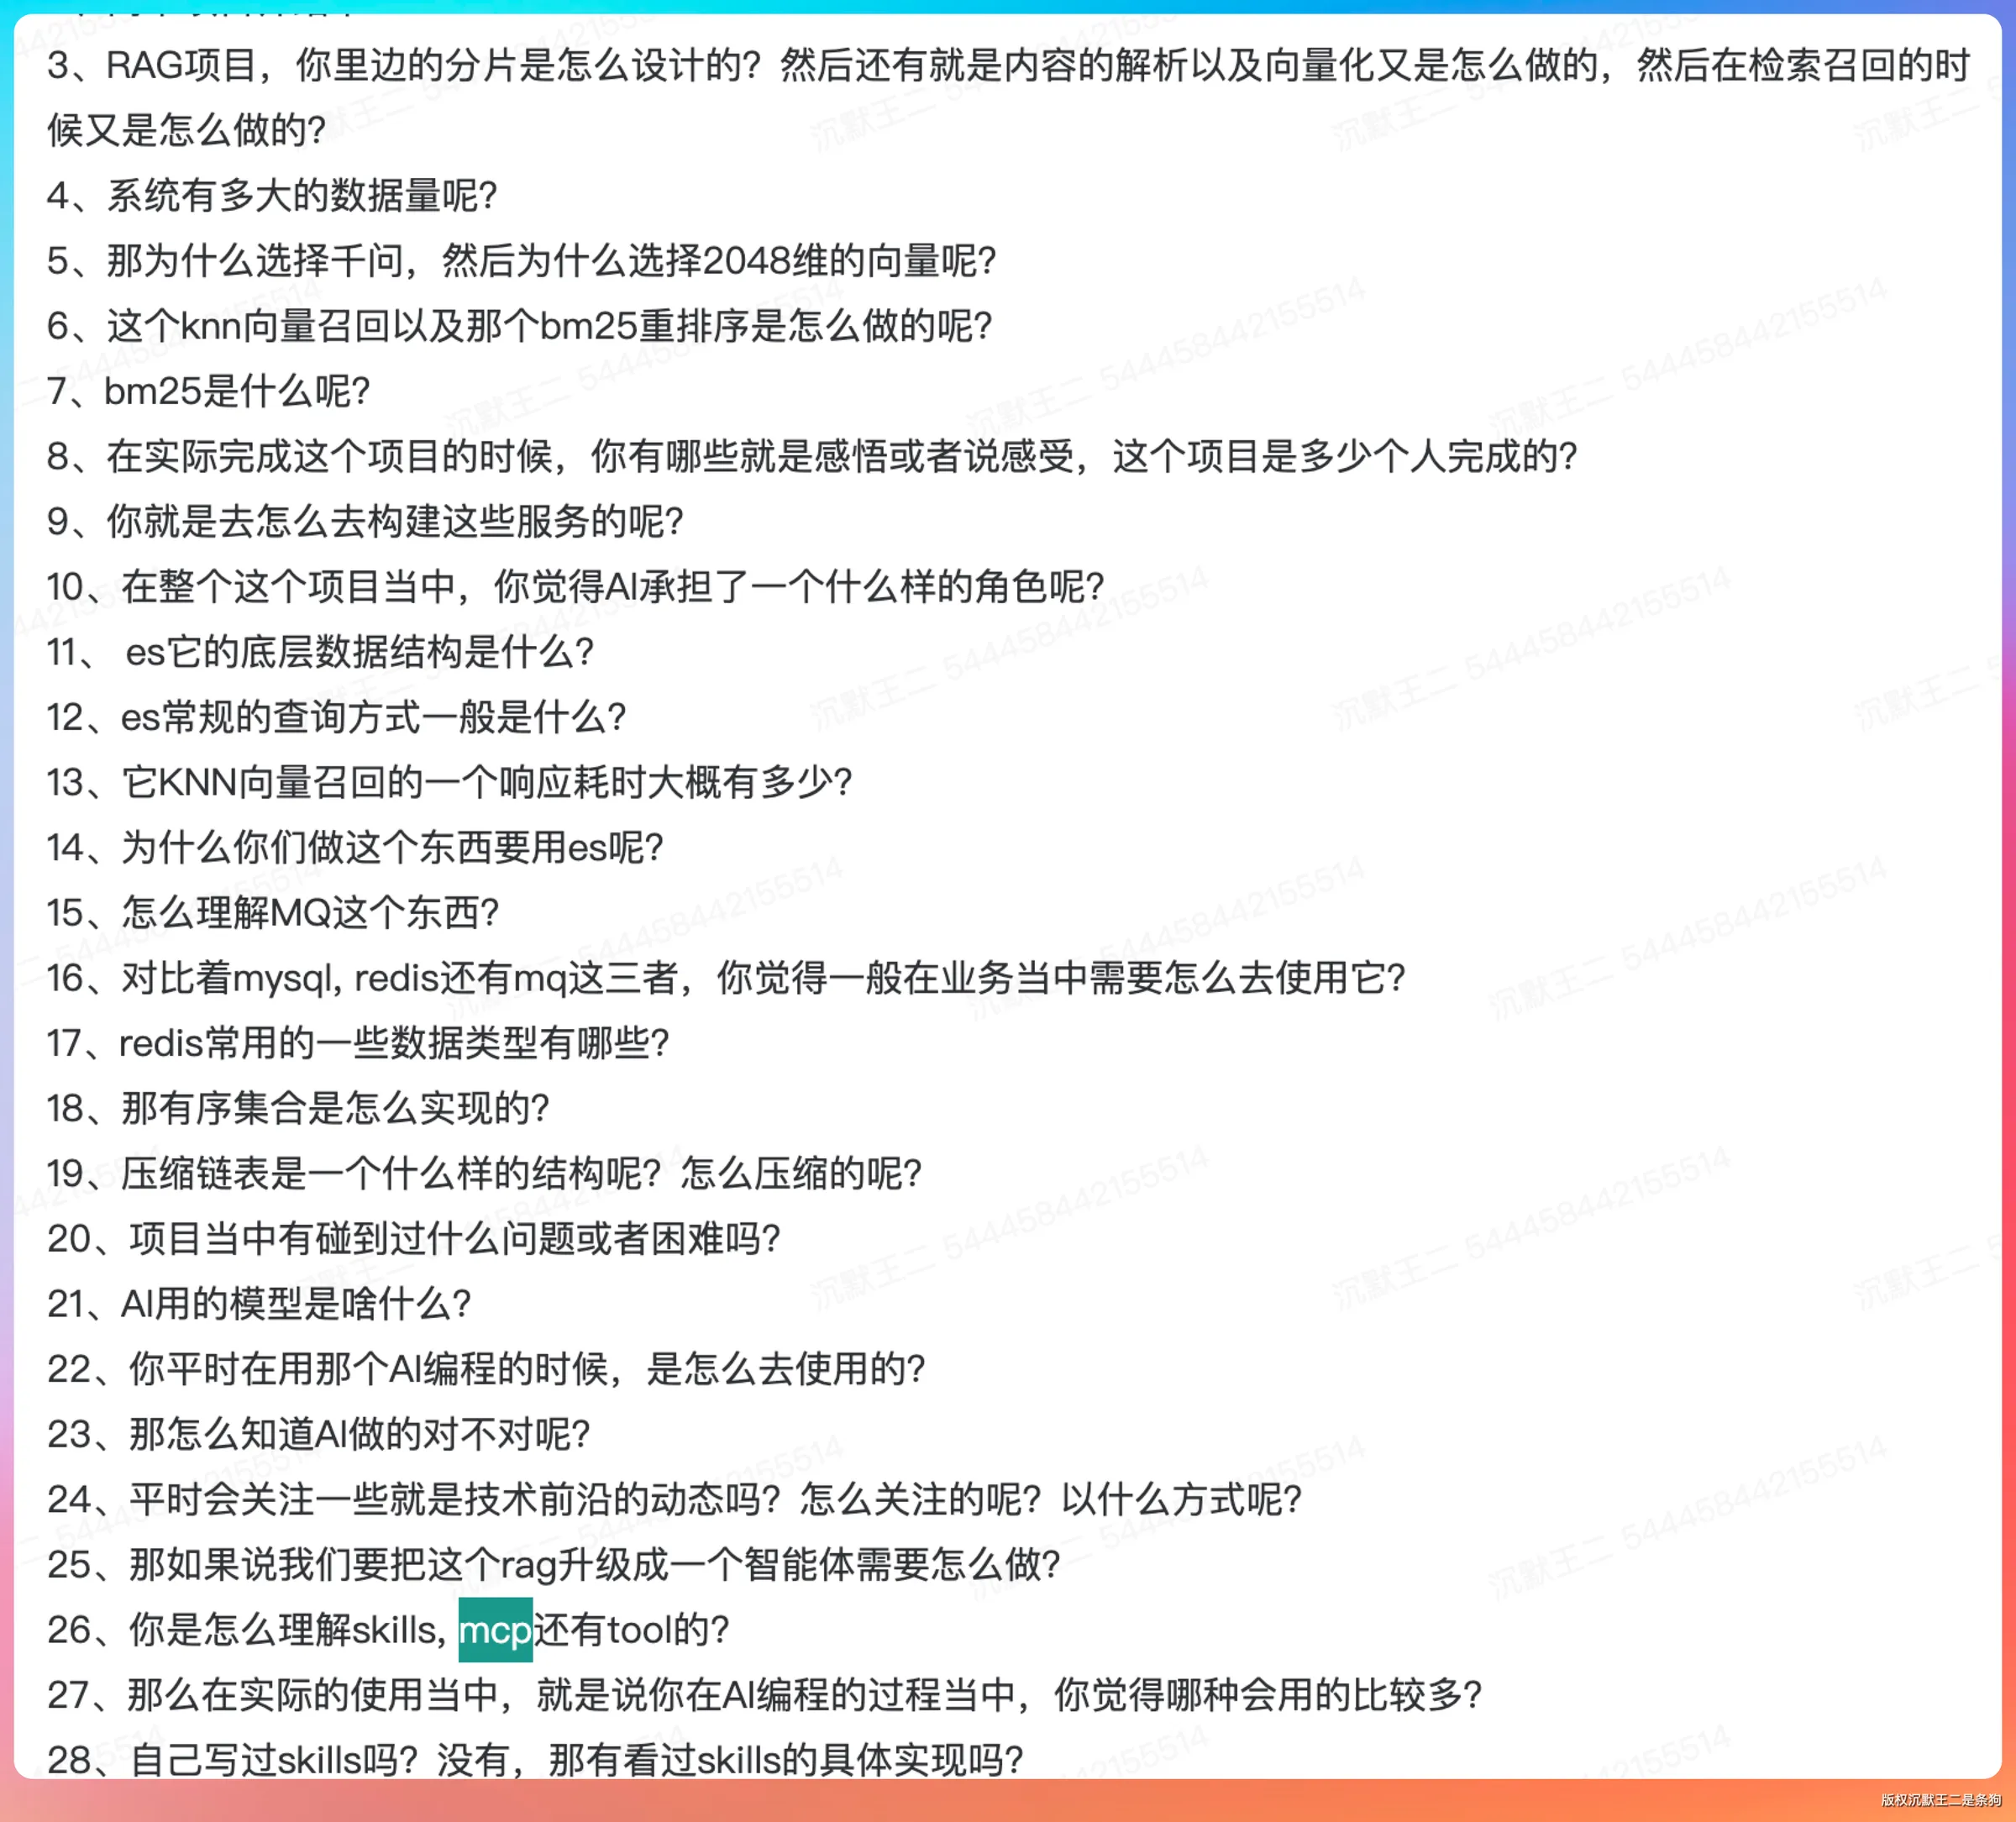
兄弟姐妹们可以先看看这些题目,真的,不是一般人,扛不住啊。
系好安全带,咱们粗粗粗粗发~~
content
01、RAG 项目,你里边的分片是怎么设计的?然后还有就是内容的解析以及向量化又是怎么做的,然后在检索召回的时候又是怎么做的?
我说:「我分四块儿来讲,分片、解析、向量化、召回。」
老王点点头,往椅子上一靠,看样子是准备听我的长篇大论了。
分片这一块,派聪明用的是多层级语义分片,按段落 → 句子 → 词 → 字符这种递进的方式来切。分片大小默认设的是 512 字节,没有用 overlap。
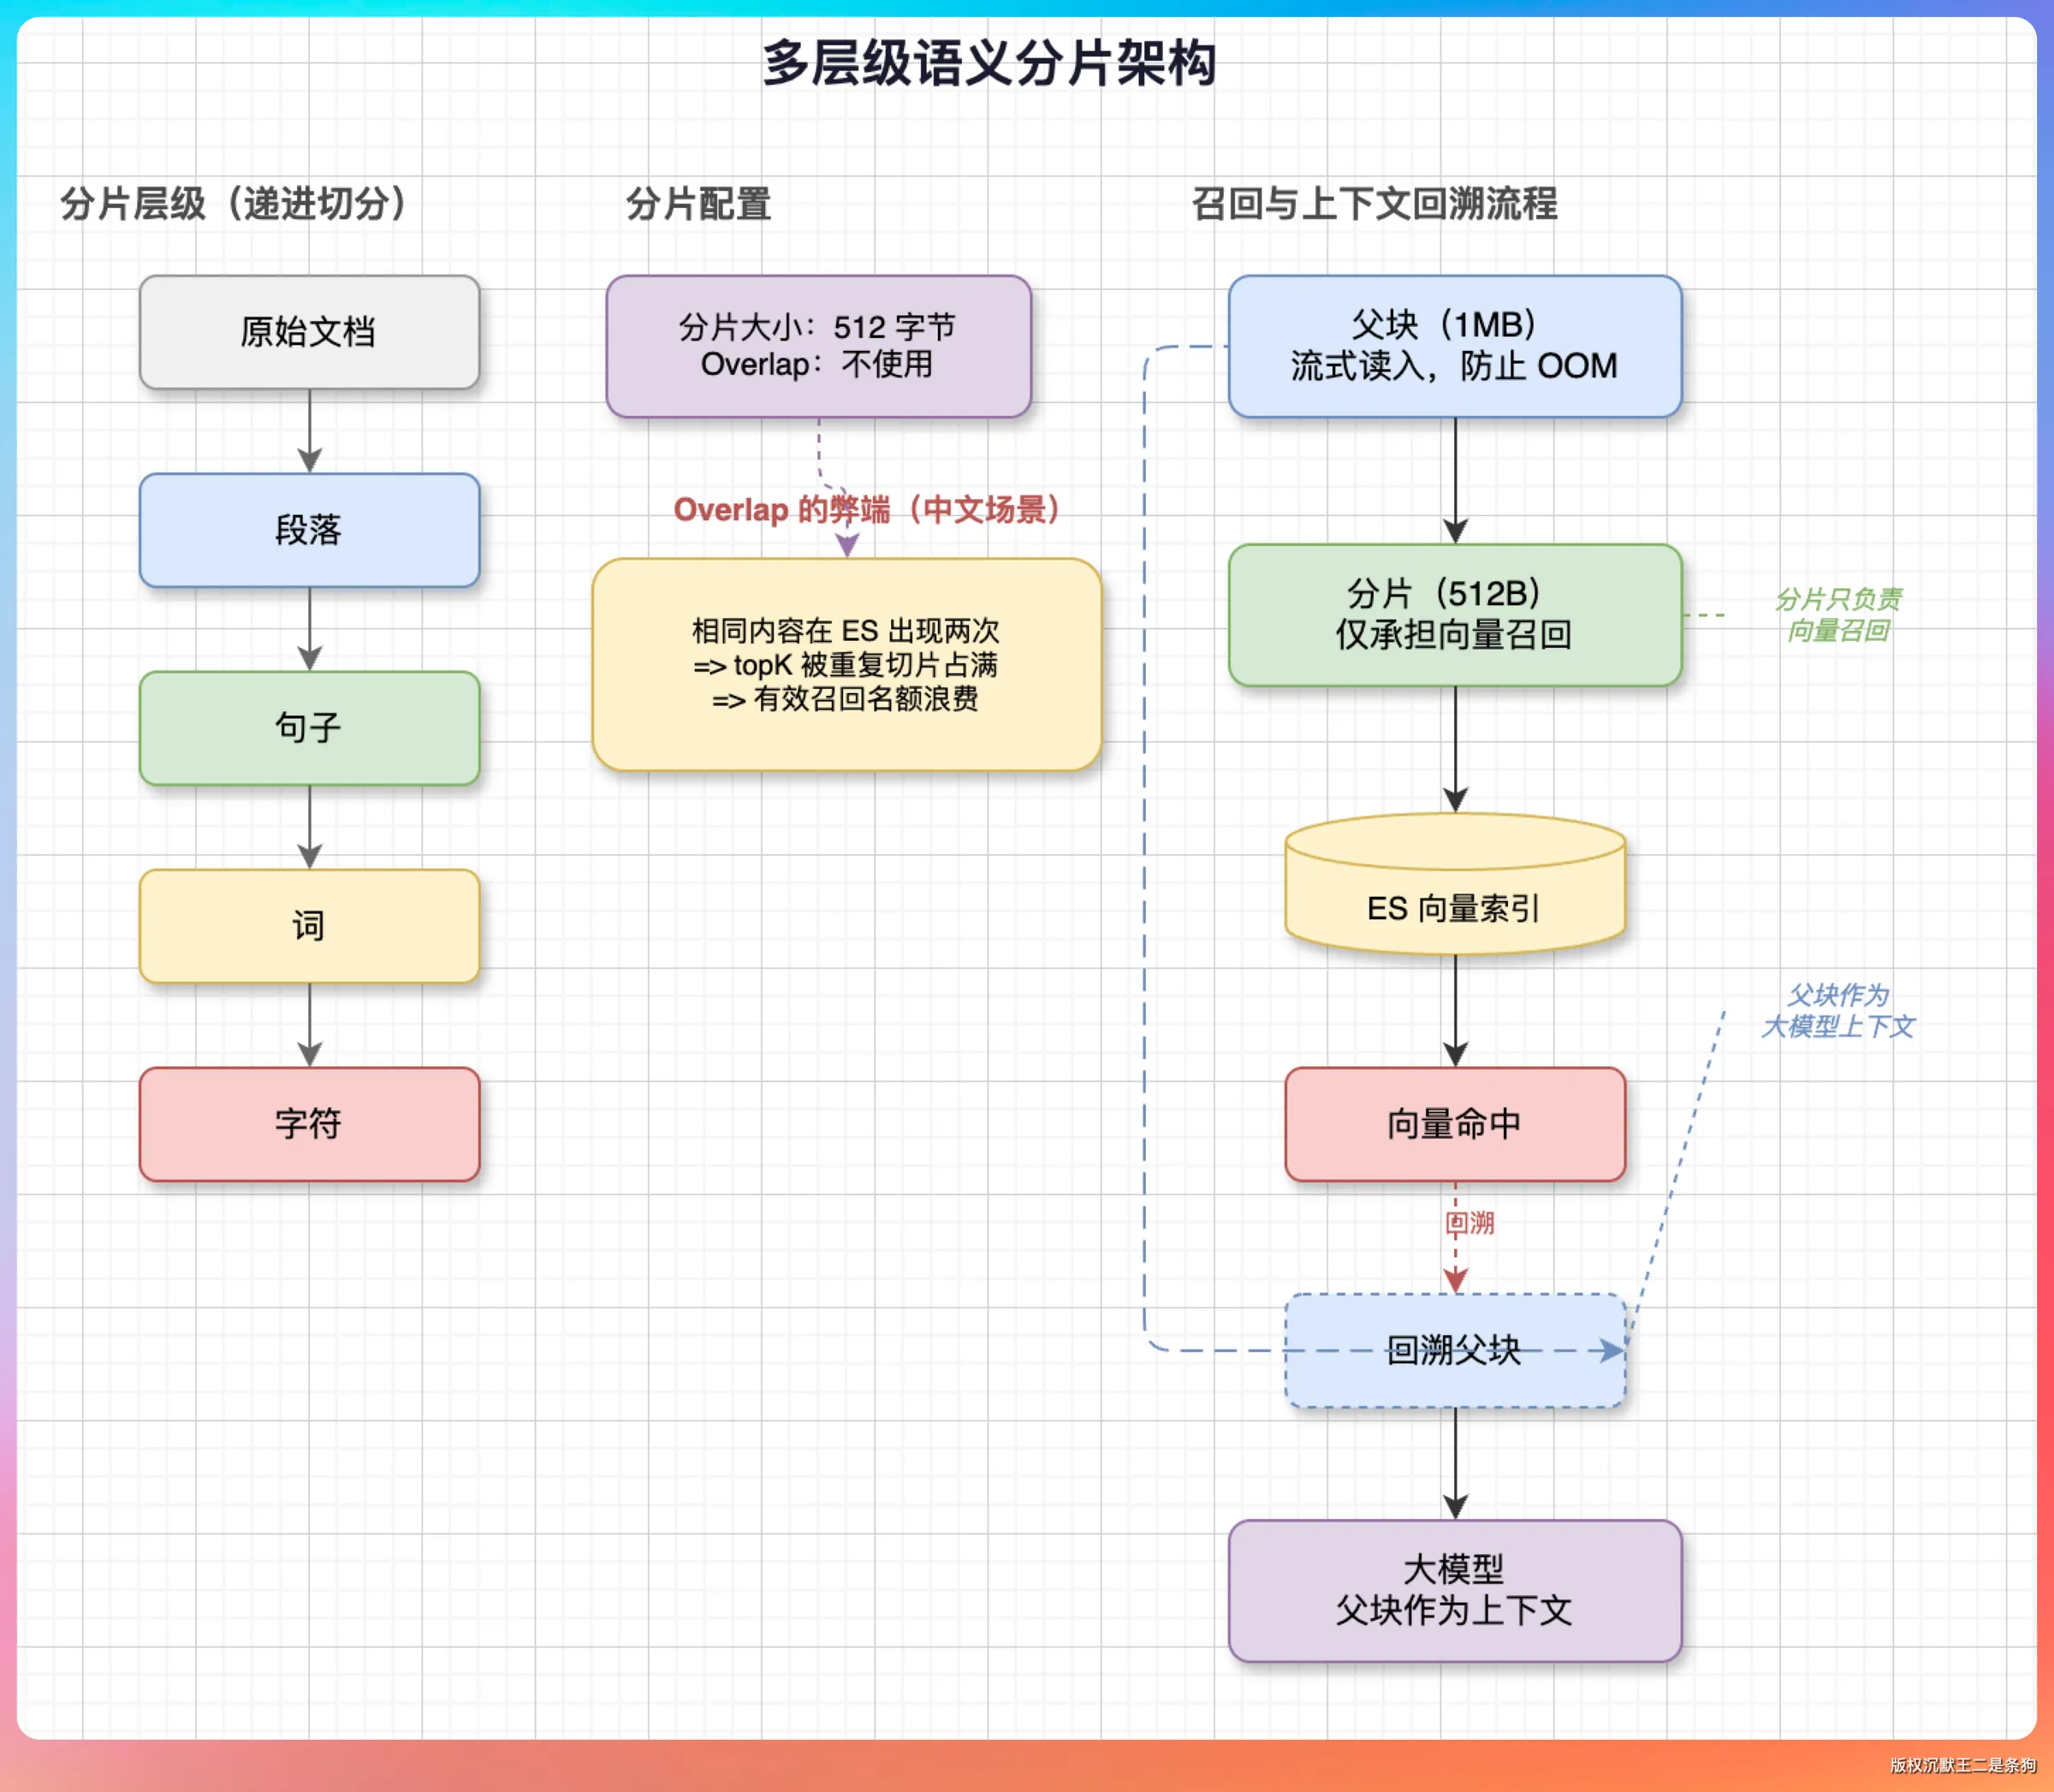
老王这时候插了一句:「不用 overlap 不怕语义割裂吗?」
我说:「这个问题我们也想过。后来发现 overlap 在中文场景下效果一般,反而会让相同内容在 ES 里出现两次,召回的时候排在前面的几条都是同一段落的不同切片,相当于浪费 topK 名额。我们的做法是,分片之外维护一个 1MB 的父块,流式读进来防止 OOM,分片只承担向量召回,命中之后回溯到父块给大模型作为上下文。」
老王眼睛亮了一下,没说话,示意我继续。
解析这一块,用的是 Apache Tika 2.9.1,自动识别格式,支持 PDF、Word、Excel、PPT、Markdown、HTML 这几大类。PDF 我们是用 PDFBox 单独处理的,按页码切片,同时把页眉页脚这些重复出现的字符给剔除掉。中文长句切词用的 HanLP 的 StandardTokenizer。
向量化走的是阿里千问的 text-embedding-v4,维度 2048,通过兼容 OpenAI 协议的 API 调,单次最多 batch 10 条。
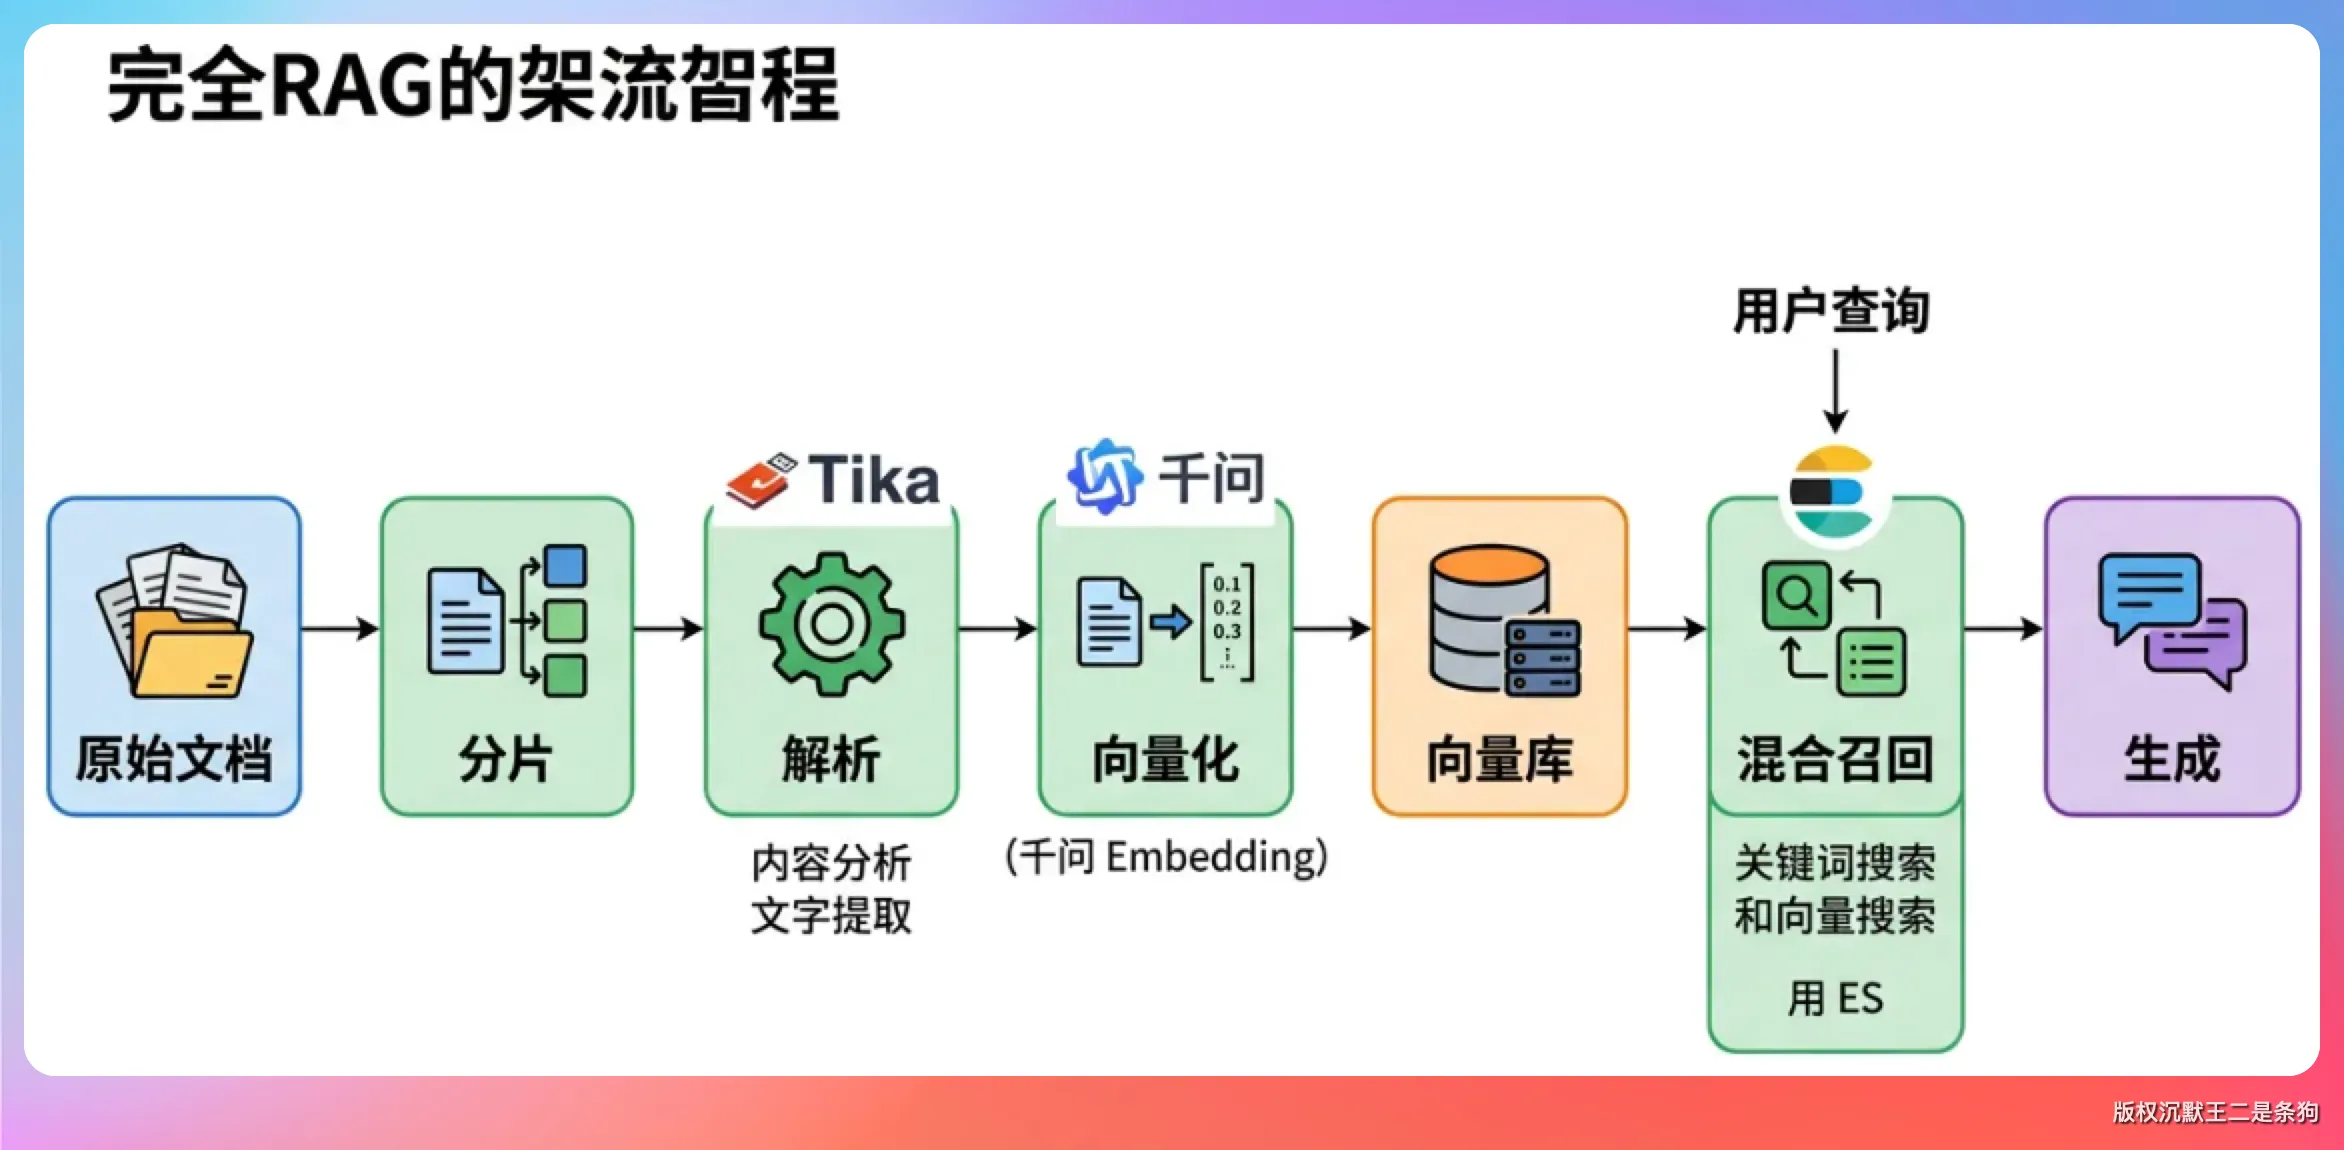
召回这一块是重头戏。我们使用ElasticSearch来完成的,索引名为 knowledge_base,向量字段用的 dense_vector,相似度 cosine。我们做了一个 KNN + BM25 的混合召回,KNN 先粗召回 topK × 30 条,然后 BM25 在这个窗口里 rescore,最终返回 topK。
老王听完说:「行,整体讲清楚了,不错。」
这句话虽然简单,却给了我很大鼓励,说实话。
02、为什么选择千问,然后为什么选择 2048 维的向量呢?
我说:「这个问题我还真研究过。」
千问 v4 这个 embedding 模型,中文场景下的表现非常不错,尤其是技术文档这种带着代码、英文、中文解释的混合内容。
我们之前对比过,同样一份 Spring Boot 教程,千问的召回准确率能比另外一家向量模型高出十几个百分点。
老王追问:「那 2048 维呢?千问 v4 不是支持 1024、1536、2048 三档吗?为什么选最大的?」
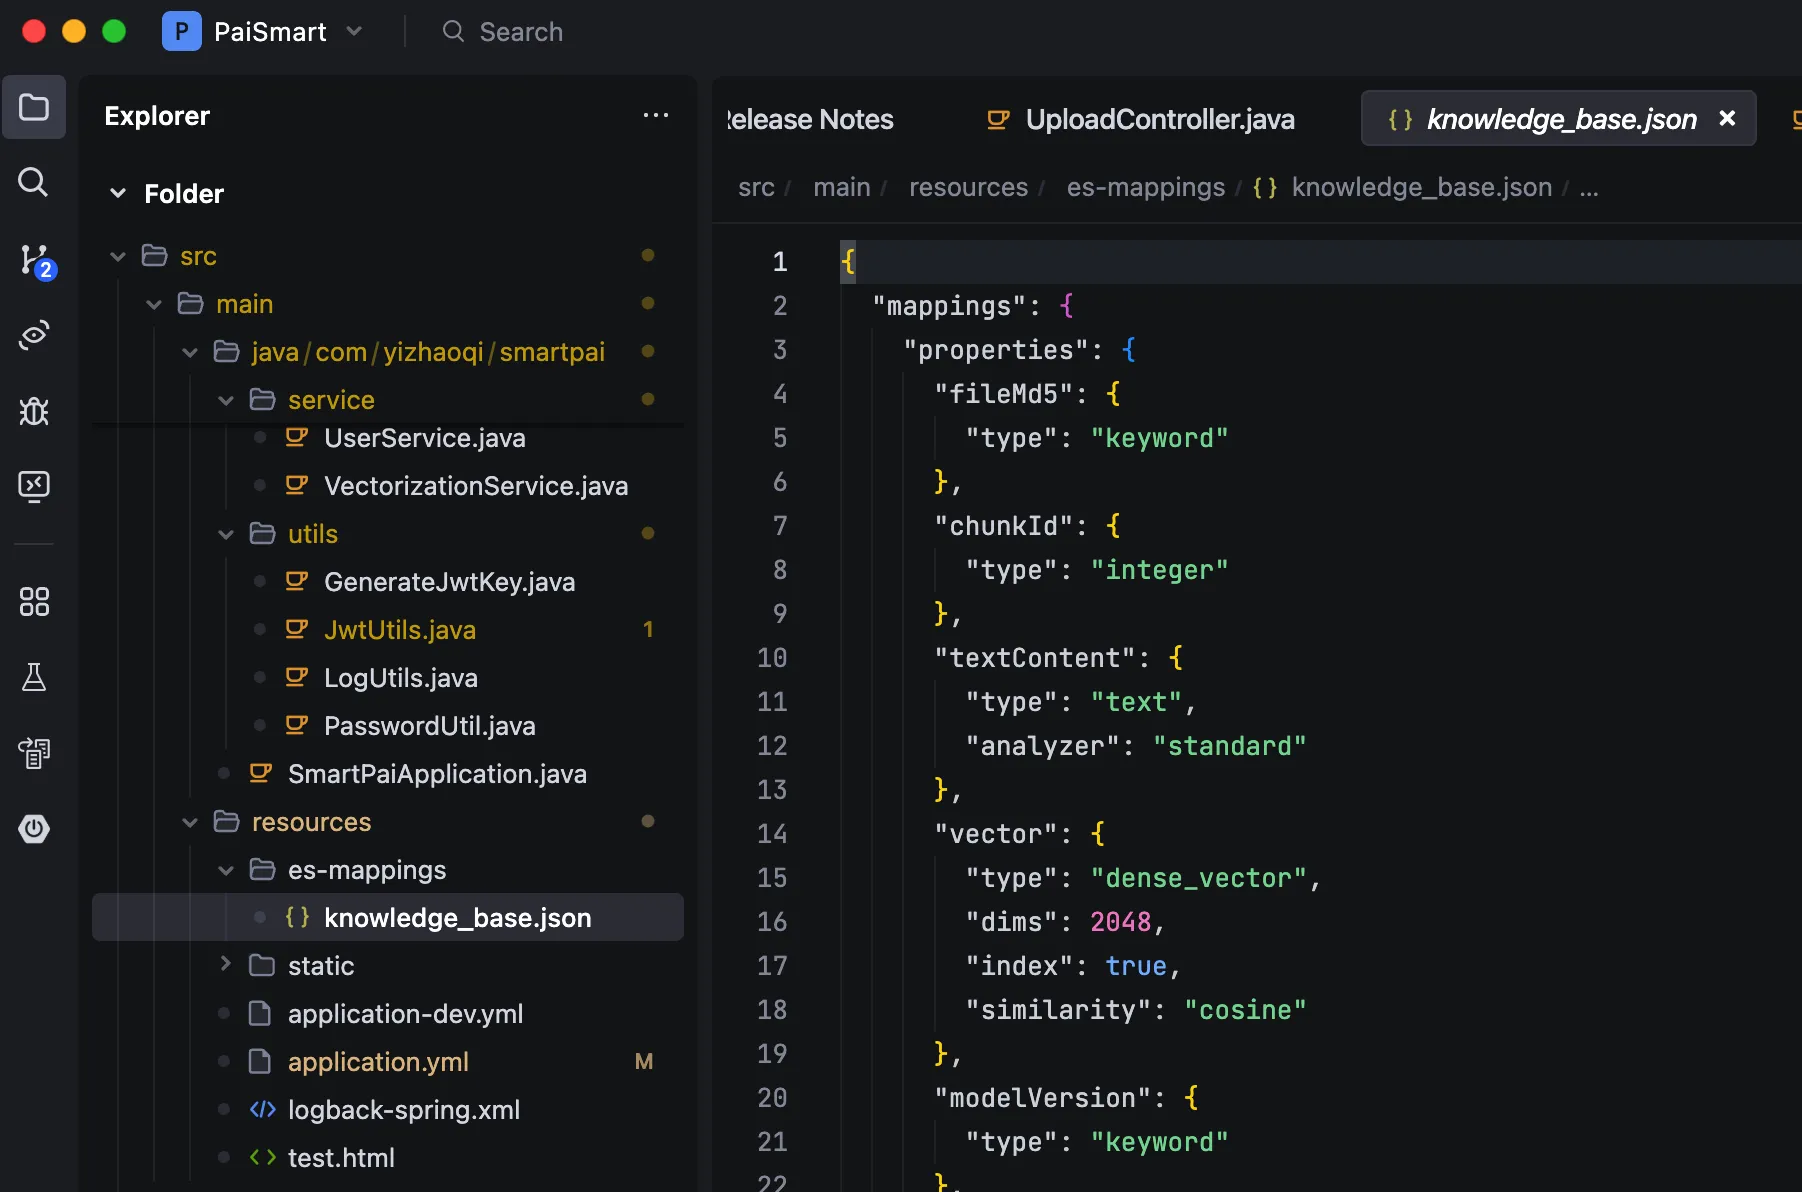
主要是两个原因。
一是精度,维度越高,向量空间表达能力越强,对长文本和专业术语的区分度越好。
二是 ES 这边的存储和计算成本我们做过测算,2048 维相比 1024 维,单条向量大概多了 8KB,knowledge_base 索引里目前有几十万条数据,多出来的存储压力可以接受。
检索这块儿因为有 BM25 兜底重排,KNN 的耗时增加在能接受的范围...
企业级Agent工作流编排项目PaiFlow
Vibe Coding版本的PaiAgent
派聪明RAG AI知识库Java版本+Go版本
微服务 PmHub、技术派、MYDB
求职派JobClaw(OpenClaw/Hermes架构
PaiCLI(类似Claude Code的Agent
派简历(代码已完成)
等实战项目。
1. 微信扫右侧的优惠券加入知识星球
2. 解锁星球的实战项目教程和源码: 项目源码+教程获取
7人已点赞



热门评论
8 条评论
回复