
派聪明 RAG 真实面经参考,已累计 27 家,700 道题目(不断更新中)
1.快手快 star
描述一下上传文件,提问到显示答案整个数据流以及涉及到的模块/技术栈
后端服务是基于 Spring Boot 3 构建的,文件上传时会用到 MinIO 和 Kafka,MinIO 用来存储文件,Kafka 用来做文件异步解析。
消费者会从 MinIO 中拉取文件,然后使用 Tika 解析分块后调用 embedding 模型生成向量,并且文本、向量存入到 ElasticSearch 中。

用户提问后会先对问题向量,然后在 ElasticSearch 中执行混合检索,一方面做向量的相似度检索、语义召回,另一方面结合 BM25 做关键词检索。
然后将检索到的上下文拼接到 prompt 一并发给大模型生成答案。后端通过 webflux 的 SSE 进行流式返回,前端实时进行渲染。
怎么 chunk 的,为什么这么做?
我采用了基于语义边界的递归切分策略。具体做法是先按照段落进行切分,如果某一块超过了设计的分块大小,就用降级的句号进行拆分,直到每个 chunk 都控制在规定的范围内,通常在 500 个字内。

同时我还引入了 overlap,设置为 10%,这样相邻的 chunk 会有一小段内容重叠,避免关键语义被切断。
这么做主要有三个原因,embedding 模型本身有输入长度限制,分块是向量化的前提;语义集中的 chunk 在混合检索时也会更容易被精准召回;重叠的 overlap 能提供更好的上下文信息。
用的什么模型,有对比过吗
向量这块一开始用的豆包,但后来不向下兼容 2048 维,于是就切换到阿里的 embedding 模型。
LLM 这块一直用的 DeepSeek。
检索结果不符合预期怎么办
先搞清楚问题发生在哪个阶段:
- 相关内容有没有被召回,如果没有,多半是分块或者向量时的问题;
- 如果召回了但排序靠后,那就是混合检索时排序的问题了。

第一步,调整 chunk_size 和 overlap,强化语义边界的递归切分;
第二步,更换 embedding 模型,看看其他模型是否会更好。
第三步,调整 BM25 与向量检索的权重,把最相关的 3 到 5 条上下文喂给 LLM。
第四步,用 MRR 这类指标做对比验证。
ES 里怎么存的
ElasticSearch 的索引名为 knowledge_base,会存三个字段:内容、向量、权限。

首先是内容字段,我们定义为 textContent,它的类型是 text,底层配的是 ik 中文分词器。这个字段用来支持关键词检索的,像 BM25、match 查询都是作用在这个字段上。
然后是向量字段,名叫 vector,我们定义为 dense_vector 类型,维度是 2048,这个维度要和 embedding 模型匹配。这个字段用来做语义检索。当用户发起查询时,我们会把查询的内容转成向量,再用 KNN 算法去比相似度。
接着是权限相关的字段,在做 B 端多租户场景时要非常重视的一块。主要有三个字段:userId、orgTag 和 isPublic。
- userId 标记这个文档片段属于哪个用户,用于实现私有文档的权限隔离;
- orgTag 表示文档所属的组织标签,用来控制组织内的授权访问;
- isPublic 标记文档是否对所有人公开。
分片上传是怎么做的?断点续传?你这个场景有意义吗?
对于大文件,派聪明采用的是‘分片上传 + 断点续传’的方式。我们会在前端先把大文件切成小的分片,比如 5MB 一块,然后并发地上传到后端。后端每收到一个分片,就存到 MinIO 中,同时会用 Redis 的 bitmap 去记录哪些分片已经上传成功。这样的好处就是,即使上传过程中断了,前端可以根据 Redis 状态判断哪些分片已经上传,不用从头开始,用户体验会比较好。
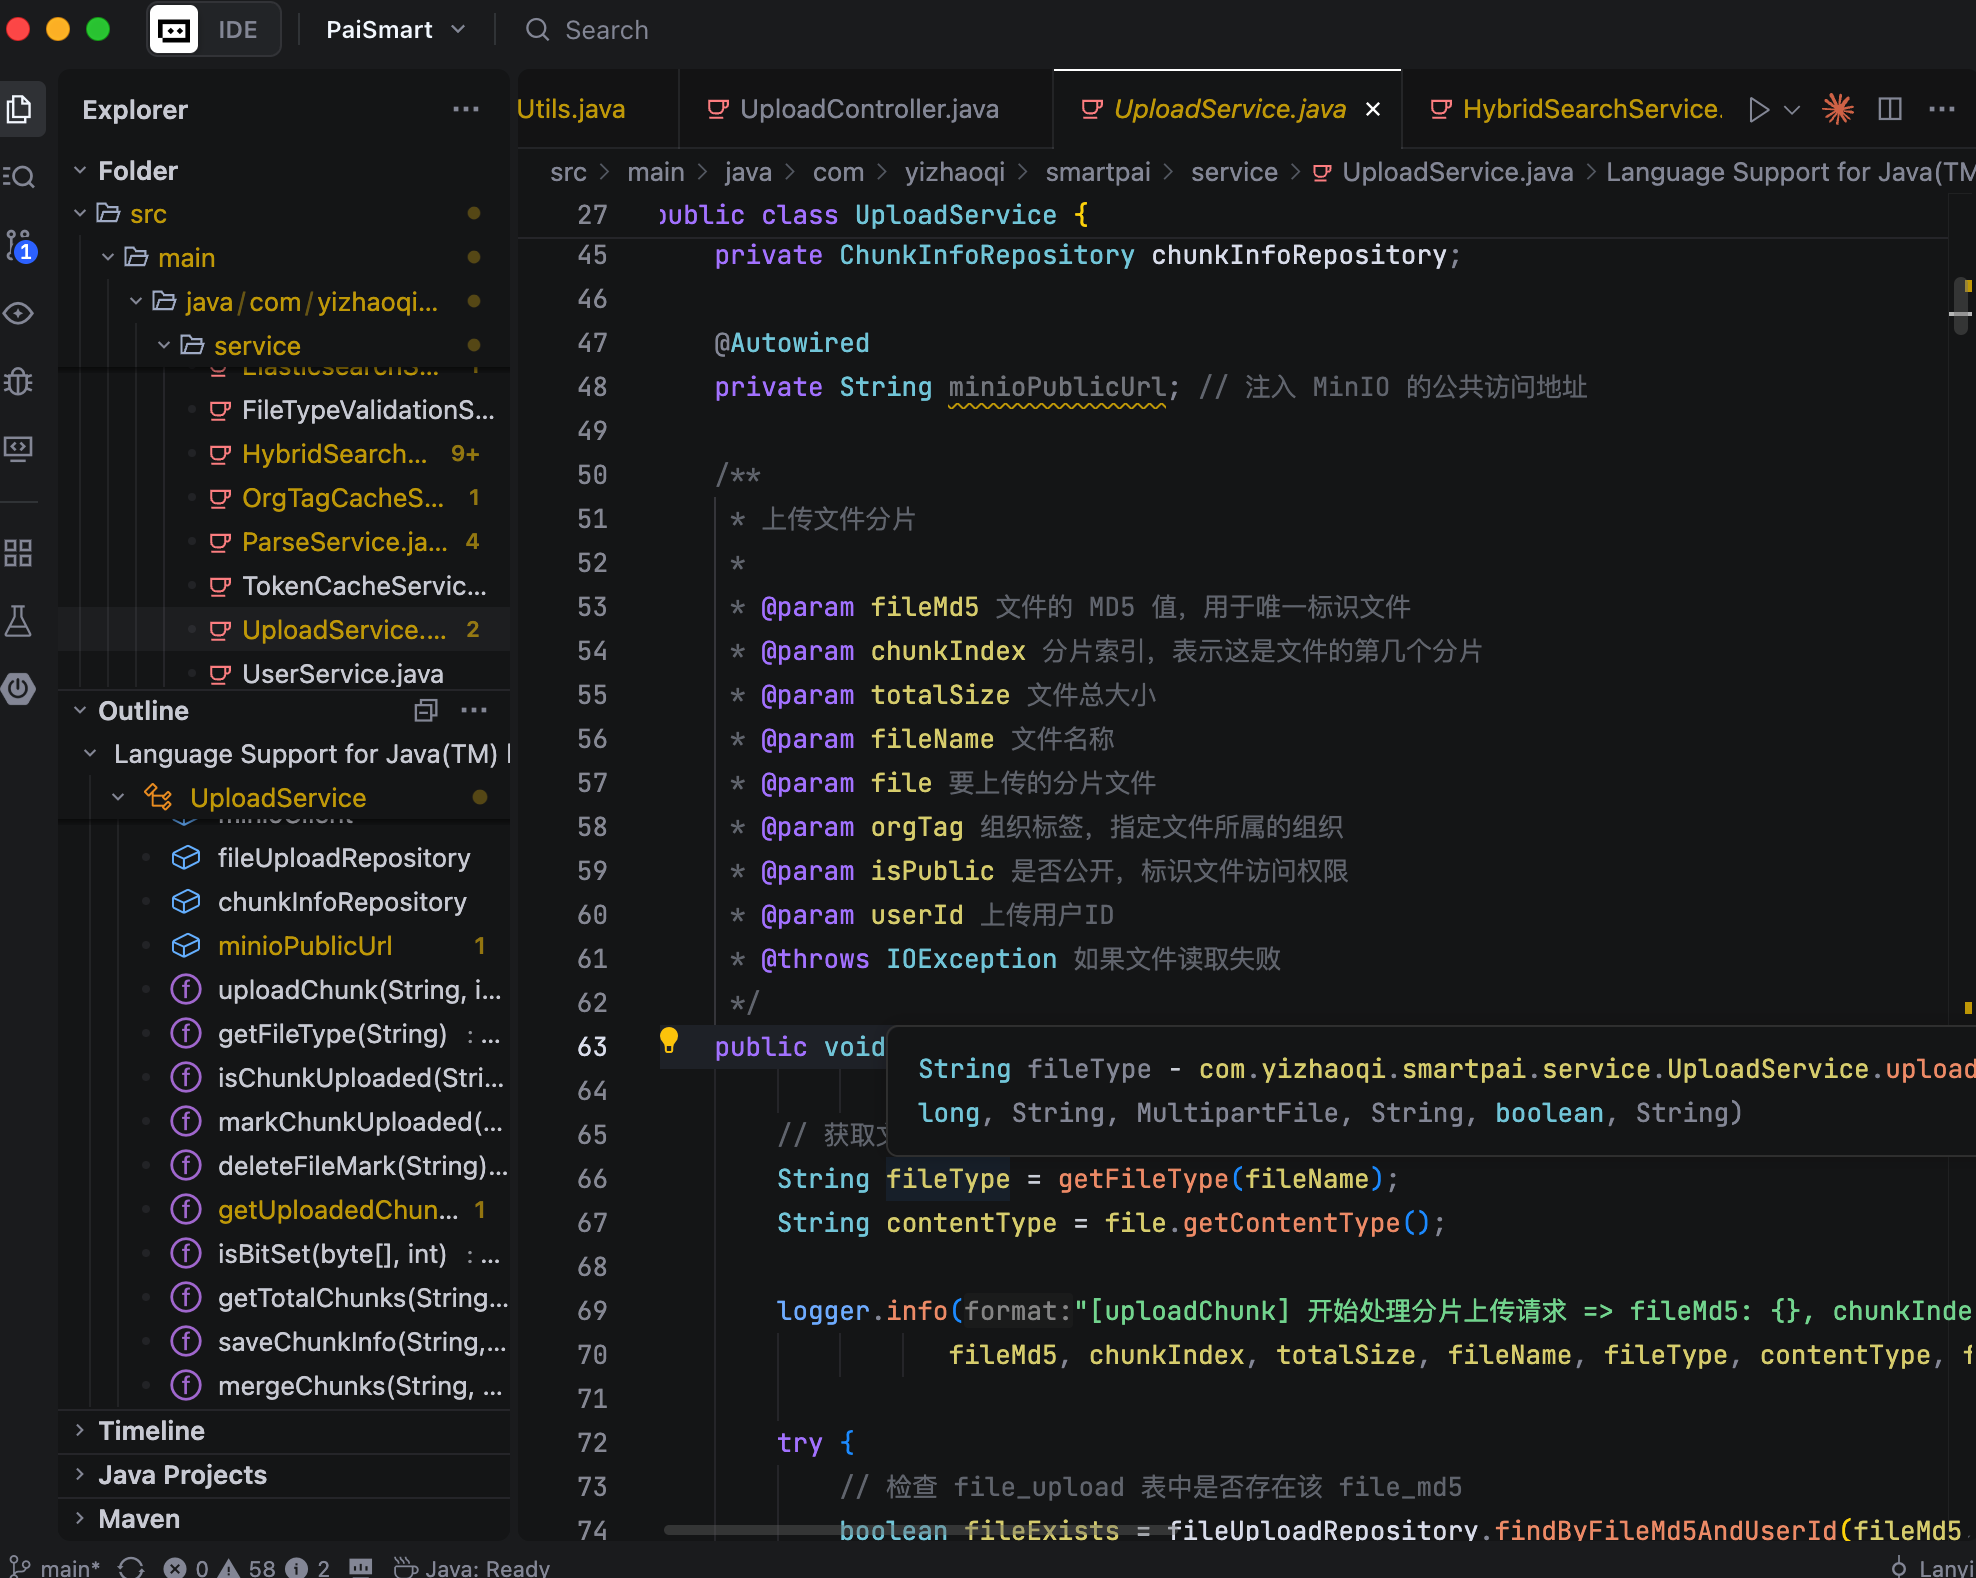
当所有分片上传完成后,前端会调用后端的合并接口。这里我们用的是 MinIO 提供的 composeObject 功能,直接在存储端完成分片的合并,合并完成后,系统会把文件状态在 MySQL 里更新为‘已完成’,并且清理掉对应的分片文件和 Redis 记录。
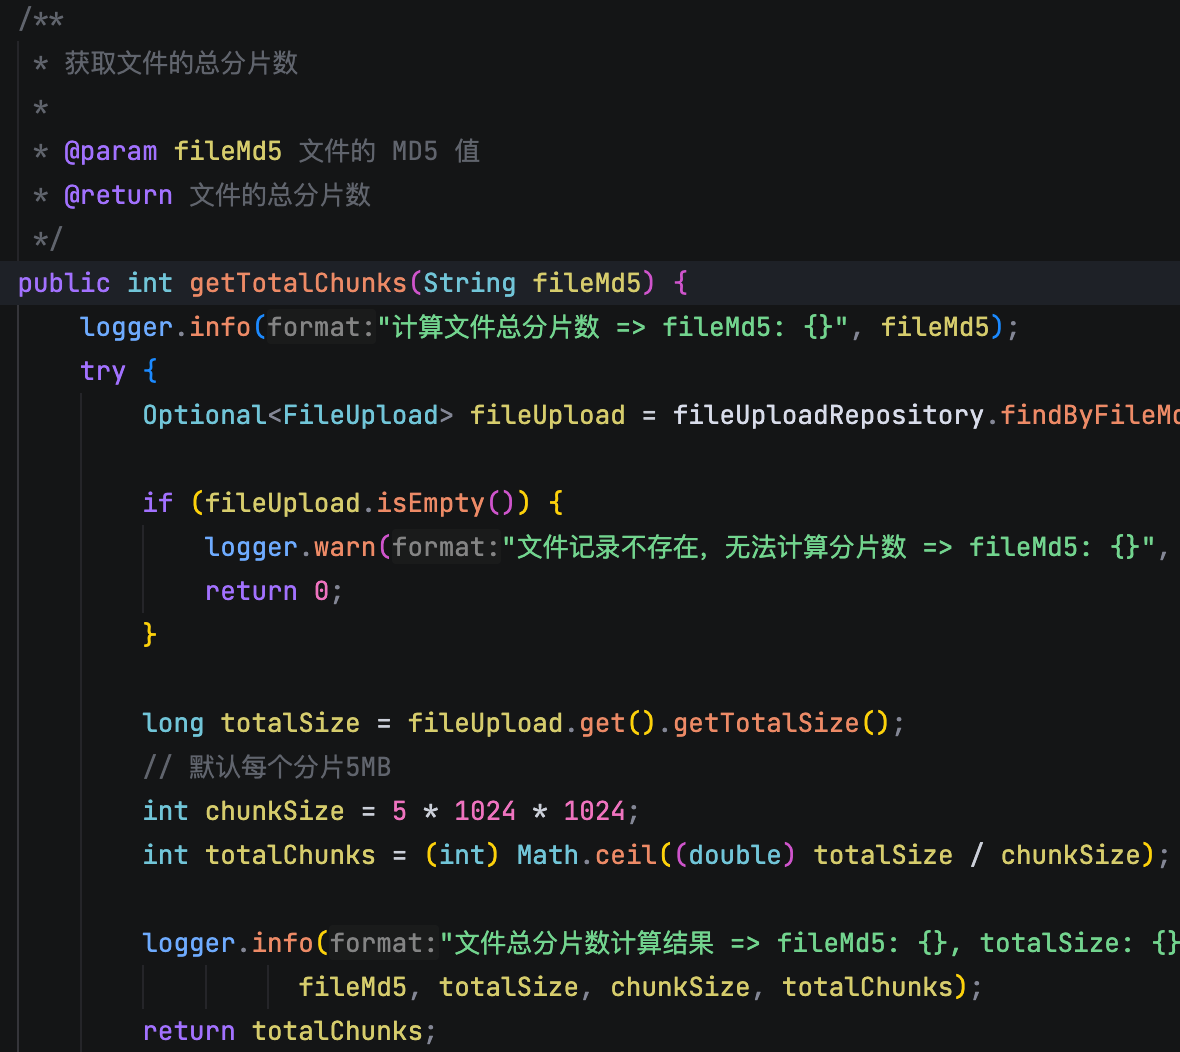
非常有意义,等到网络恢复后,前端会带着这个文件的 MD5 去后端的 Redis 里查所有分片的状态,前端拿到分片状态后,在重新上传的时候,就会跳过那些已经上传成功的分片,只上传那些还没传的。这样就避免了重复上传。
2.小红书一面
AI & RAG 相关
- RAG 怎么解决 LLM 上下文窗口有限的问题?
- RAG 里的“重要性重排序”是怎么判断哪个内容更“重要”的?
- 流式对话支持多轮吗?怎么实现的?
- 提示词做了哪些优化?如果多轮对话关联性不强,怎么抓住新问题的重点?
- OpenAI 协议里,上下文的角色有哪几种?
- system, user, assistant 这几个角色在使用上有什么区别?
Java 基础 & 并发
- 讲讲 Java 不同更新版本的区别,特别是关键版本。
- 为什么 Spring Boot 3.x 要用 Java 17+的版本?项目里用了哪些新特性?
- Lambda 表达式和 Stream API,跟传统的 for 循环比,优缺点是什么?
- parallelStream()为什么性能好?底层是什么实现的?
- 如果不用 parallelStream,用传统 for 循环自己写并发提交任务,代码大概分几块?
- 都说 Java 线程“重”,Go 协程“轻”,这个“重”具体体现在哪?
- 为什么 Java 线程实际只用很少的栈,但 JVM 却要给它分配那么大的栈空间?
- 协程到底是个什么东西?
- Java 里写 for 循环有几种方式(比如用索引 i,用迭代器),它们有什么区别?
算法手撕
- 实现一个函数,找出字符串里所有长度大于 1 的子回文串。
3.某对标亚信公司一面
- 面了一家听说对标亚信的公司,面试官口头和我说过了,下一轮 boss 面让我瞎聊就行
- java 基础和集合查缺补漏面经:
- embedding 用什么模型?
- 混合检索?怎么评估准确性?
- 大模型的选择
- 上下文管理?
- redis 的击穿, 雪崩,穿透
- AOP
- MySQL binlog 监听通过主从复制原理
- ThreadLocal
- 消息队列,消息如何不丢失?
要我现场paopao派聪明,没跑起来。。。很悲催,我没改前端也不怎么熟悉流程。
4.未知公司
面经:
- 1、介绍项目从数据上传到最后存入数据库的流程、RAG 流程
- 2、切块的步骤、如何评价优化前后的 RAG 的好坏
- 3、针对用户不同的提问:提问语句长短不同,分别怎么检索?
- 4、向量化的数据有做处理吗?
5.tengxun二面
- 1.派聪明技术选型,如为什么用 minio 做文件存储、选择 es 等
- 2.rag 的准确率如何优化
- 3.语块如何分片
- 4.es 相关
- 5.大文件也可以断点续传为什么要分片?
- 6.从用户体验上来说,一个文档也没有很大,分片上传的提升并不大,这里如何考虑的?
6.合合信息一二面
一面面经
拷打项目
- 讲一下自己的 rag 这一套流程的理解
- 在里面采取了哪些技术
- 对接大模型用的什么
- 文件拆分是怎么分割的
- 用户提交问题后的流程
- 中间过程纯手工编的吗?(我答的没用 langchain4j 或者 Spring ai)
- 如果有充足时间优化 会优化哪些点
- 怎么解决检索过程中的权重误差?
- 如何优化检索来提高回答准确性?
- 了解过 agent 和 mcp 吗?
- 可以把整个流程让大模型自动弄吗?
- 如果用 agent 代替,你会怎么设计呢?
- 多人会话历史的窗口怎么设计的?
- 考虑过怎么优化吗?(我提到可以压缩历史上下文然后拼接) 压缩如何实现呢?
- 大文件上传优化是一开始就这样考虑的吗?还是遇到了什么问题才这样设计的?
- 文件完整性怎么保证的? 项目上线了吗?
聊 mydb 项目 是自己做的吗?(go 改的) 最大收获是...
企业级Agent工作流编排项目PaiFlow
Vibe Coding版本的PaiAgent
派聪明RAG AI知识库Java版本+Go版本
微服务 PmHub、技术派、MYDB
求职派JobClaw(OpenClaw/Hermes架构
PaiCLI(类似Claude Code的Agent
派简历(代码已完成)
等实战项目。
1. 微信扫右侧的优惠券加入知识星球
2. 解锁星球的实战项目教程和源码: 项目源码+教程获取
28人已点赞




热门评论
325 条评论
回复