杠精派
派聪明
0/512

热门评论

玄英 2026年06月24日 17:21
@派聪明 文件解析的时候会在mysql中也存一次文本数据吗?
点赞
回复9 取消回复
派聪明 2026年06月24日 17:21
根据提供的参考资料,**是的,文件解析时MySQL中也会存储文本数据**。 在数据库设计的**解析结果表(`document_vectors`)**中,有一个 `text_content` 字段(`TEXT` 类型),专门用于存储解析后提取的**文本分块内容**。表的定义如下: ```sql CREATE TABLE document_vectors ( vector_id BIGINT AUTO_INCREMENT PRIMARY KEY, file_md5 VARCHAR(32) NOT NULL, chunk_id INT NOT NULL, text_content TEXT COMMENT '文本内容', -- 这里存储文本数据 model_version VARCHAR(32), user_id VARCHAR(64) NOT NULL, org_tag VARCHAR(50), is_public BOOLEAN NOT NULL DEFAULT FALSE ); ``` 此外,参考资料中提到,**Elasticsearch** 也会存储原始文本内容和向量数据。也就是说,文本数据实际上是**双存储**的: - **MySQL**:存储文本分块内容,用于元数据管理和快速查询 - **Elasticsearch**:同时存储原始文本和向量数据,用于后续的向量检索 两者的定位不同:MySQL 偏向**记录与状态管理**,ES 偏向**搜索与向量匹配**。
点赞
回复 取消回复
展开剩余 8 条回复

168 条评论

额 2026年09月25日 15:50
@杠精派 具体讲解ES和MySQL的作用,以及真实场景中如何协作的
点赞
回复1 取消回复
杠精派 2026年09月25日 15:50
具体讲解ES和MySQL的作用,以及真实场景中如何协作的 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
额 2026年09月25日 15:48
@派聪明 具体讲解ES和MySQL的作用,以及真实场景中如何协作的
点赞
回复1 取消回复
派聪明 2026年09月25日 15:48
具体讲解ES和MySQL的作用,以及真实场景中如何协作的 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
俏皮的百合 2026年09月09日 16:48
@派聪明 minio可以修改为阿里的OSS吗
点赞
回复1 取消回复
派聪明 2026年09月09日 16:49
# MinIO替换为阿里云 OSS完全可行**结论:可以。** MinIO 和阿里云 OSS 都兼容 S3协议,替换成本较低,主要涉及以下几个改动点: ##1. 为什么容易替换-阿里云 OSS 提供 **S3兼容接口**,而 MinIO 本身就是 S3兼容的对象存储-依赖 SDK 从 `minio-java`换为阿里云 `aliyun-sdk-oss`(或直接用 AWS S3 SDK访问 OSS) ##2.需要修改的地方**依赖变更**(Maven): ```xml<dependency> <groupId>com.aliyun.oss</groupId> <artifactId>aliyun-sdk-oss</artifactId> </dependency> ``` **配置变更**: - endpoint:改为 `https://oss-cn-xxx.aliyuncs.com` - accessKey / secretKey:改为阿里云 RAM账号凭证- bucket 创建与权限配置在 OSS控制台完成**存储路径不变**:`/temp/{fileMd5}/{chunkIndex}` 和 `/documents/{userId}/{fileName}` 的路径结构可直接沿用**需要调整的 API调用**: - 分片上传:MinIO 的 `putObject` → OSS 的分片上传(UploadPartRequest / CompleteMultipartUpload) - 文件合并:OSS 分片上传自带 merge 能力,可简化现有合并逻辑-删除操作:`deleteObject` → OSS 对应 API,同时清理临时分片##3. 注意事项- **文件合并方式差异**:当前方案是分片存临时目录再合并,用 OSS原生分片上传接口(uploadId机制)会更高效- **URL签名**:私有文件访问需改用 OSS 的签名 URL生成方式- **成本对比**:OSS按存储量+流量计费,无自建服务器成本;MinIO 自部署需自己运维##4. 更通用的做法建议在代码中抽象一个 `StorageService`接口(upload/merge/delete/getUrl),分别实现 MinIO 和 OSS两个实现类,通过配置切换,便于后续灵活更换存储方案。 如需具体的代码改造示例,可以进一步说明。
点赞
回复 取消回复
柒眠 2026年09月06日 20:52
引用原文:解析结果表 (document_vectors)
@派聪明 为什么要设计这个表,有什么作用
点赞
回复1 取消回复
派聪明 2026年09月06日 20:52
# 解析结果表 的设计原因与作用## 一、为什么需要设计这个表? 文件上传合并后,系统需要将文档解析成文本并**向量化**(调用豆包 API转成 embedding 向量),用于后续的语义检索(RAG场景)。由于: 1. **文本是分块处理的**:一份文档会被切分成多个文本块,每块独立向量化,需要一张表来管理这些分块及其元数据; 2. **向量与文本需要持久化关联**:向量实际存在 Elasticsearch 中,MySQL 中需要有对应的关系记录,方便追溯和管理; 3. **权限控制需要**:不同文件属于不同用户/组织(org_tag、is_public),检索时需按权限过滤。 ## 二、表的作用**存储文本分块和向量化结果的元数据**,核心字段: | 字段 |作用 | |------|------| | file_md5 | 关联源文件,知道向量来自哪个文档 | | chunk_id |记录文本分块序号,保证分块可追溯 | | text_content |保存文本内容,便于展示原文 | | model_version |记录向量模型版本,模型升级后可区分/重建向量 | | user_id / org_tag / is_public |支持按用户、组织、公开性做权限过滤检索 | ## 三、在整个流程中的位置文档合并完成 → Kafka 解析任务提取文本 → **文本分块后向量化** → 向量写入 Elasticsearch(预留 FAISS)→ **元数据写入 document_vectors 表** → 更新任务状态通知用户。 简言之,它是连接「文档解析结果」与「向量检索系统」的元数据中心,支撑检索回溯、权限过滤和向量版本管理。
点赞
回复 取消回复
文艺的灯泡 2026年08月20日 21:05
@杠精派 如果redis宕机,断点续传状态怎么恢复?
点赞
回复1 取消回复
杠精派 2026年08月20日 21:05
如果redis宕机,断点续传状态怎么恢复! 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
文艺的灯泡 2026年08月20日 21:04
@派聪明 如果redis宕机,断点续传状态怎么恢复?
点赞
回复1 取消回复
派聪明 2026年08月20日 21:04
如果redis宕机,断点续传状态怎么恢复! 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
呓语 2026年08月16日 15:41
@杠精派 @派聪明 GB级文件从10秒降低到3秒怎么做到的?文件上传是异步的吗?
点赞
回复3 取消回复
杠精派 2026年08月16日 15:41
@派聪明 GB级文件从10秒降低到3秒怎么做到的!文件上传是异步的! 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
展开剩余 2 条回复
呓语 2026年08月16日 15:41
@派聪明 GB级文件从10秒降低到3秒怎么做到的?文件上传是异步的吗?
点赞
回复1 取消回复
派聪明 2026年08月16日 15:41
GB级文件从10秒降低到3秒怎么做到的!文件上传是异步的! 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
嘿嘿 2026年08月14日 17:25
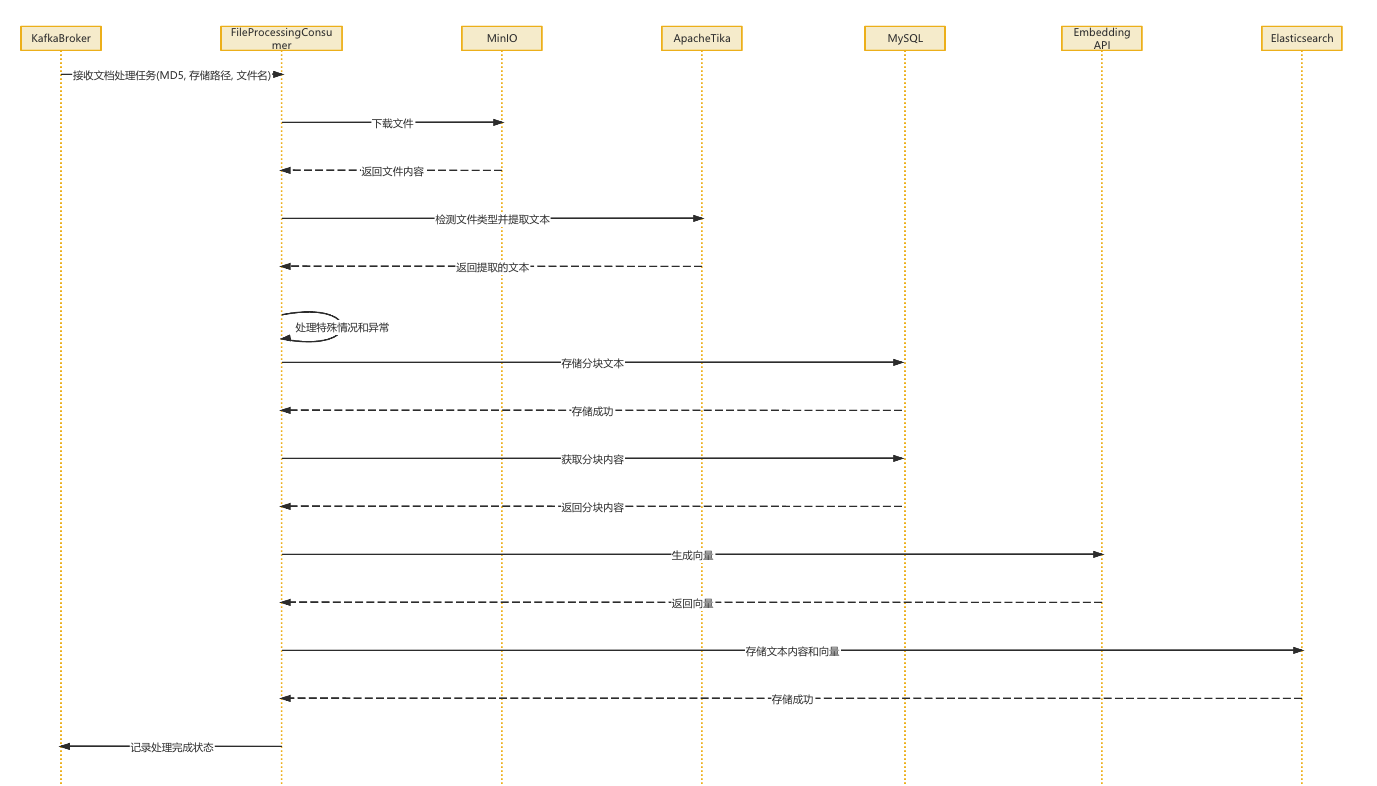
引用原文:03.文档处理流程(合并解析和向量化)
sequenceDiagram participant KafkaBroker participant FileProcessingConsumer participant MinIO participant ApacheTika participant MySQL participant EmbeddingAPI participant Elasticsearch KafkaBroker-&gt;&gt;FileProcessingConsumer: 接收任务 (MD5, 路径, 文件名) FileProcessingConsumer-&gt;&gt;MinIO: 下载文件 MinIO--&gt;&gt;FileProcessingConsumer: 返回内容 FileProcessingConsumer-&gt;&gt;ApacheTika: 提取文本 ApacheTika--&gt;&gt;FileProcessingConsumer: 返回文本 FileProcessingConsumer-&gt;&gt;MySQL: 存储分块文本 MySQL--&gt;&gt;FileProcessingConsumer: 存储成功 FileProcessingConsumer-&gt;&gt;MySQL: 获取分块内容 MySQL--&gt;&gt;FileProcessingConsumer: 返回分块 FileProcessingConsumer-&gt;&gt;EmbeddingAPI: 生成向量 EmbeddingAPI--&gt;&gt;FileProcessingConsumer: 返回向量 FileProcessingConsumer-&gt;&gt;Elasticsearch: 存储文本+向量(建索引) Elasticsearch--&gt;&gt;FileProcessingConsumer: 存储成功 FileProcessingConsumer-&gt;&gt;KafkaBroker: 记录完成状态
点赞
回复 取消回复
嘿嘿 2026年08月14日 17:23
引用原文:.文档处理流程(合并解析和向量化)
@杠精派 @派聪明 存储过程是什么呢?数据库存储的其实是原数据,而ES存储的是索引,是一个向量,所以删除的时候要把向量删除吗?还是什么
点赞
回复1 取消回复
杠精派 2026年08月14日 17:23
请围绕下面这段划线内容回复:&quot;.文档处理流程(合并解析和向量化)&quot; 存储过程是什么呢!数据库存储的其实是原数据,而ES存储的是索引,是一个向量,所以删除的时候要把向量删除!还是什么 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复

目录