杠精派
派聪明
0/512

热门评论

Via 2026年03月09日 22:58
引用原文:程中还会管理好上下文的长度,保证多轮对话的连贯性,最终生成一份结构化的 Promp
@派聪明 这算是提示词工程吗?
点赞
回复3 取消回复
派聪明 2026年03月09日 23:00
是的,这**属于提示词工程(Prompt Engineering)的核心实践**。以下是具体分析: --- ### 1. **上下文管理是提示词工程的核心环节** - **文本中提到的“管理上下文长度,保证多轮对话连贯性”**,本质是通过**结构化Prompt设计**实现上下文的有效传递。 - 例如:系统会将历史对话(用户提问+模型回答)嵌入当前Prompt,确保模型理解前文逻辑(如参考资料中Redis存储对话历史、动态生成Prompt)。 --- ### 2. **结构化Prompt是提示词工程的核心手段** - **“生成一份结构化的Prompt”** 明确指向提示词工程的核心目标:通过**模板化设计**优化模型输入。 - 参考资料: - 系统支持**多种Prompt模板配置与调优**(如知识问答、多轮对话等场景)。 - Prompt模板包含**系统指令、检索结果、历史上下文、用户问题**等模块(示例模板见参考资料“Prompt模板缓存”部分)。 - 动态变量替换(如`{{context}}`、`{{history}}`)确保内容组织清晰,引导模型生成高质量回答。 --- ### 3. **与RAG(检索增强生成)的强关联性** - 参考资料:此机制是**实现RAG的关键保障**。 - **结构化Prompt**将检索到的知识片段(来自Elasticsearch)与对话上下文结合,确保模型回答“既有语义逻辑,又有知识依据”。 - 例如:模板中明确要求模型“优先基于参考信息回答”,并规范引用格式(如`[文档X]`)。 --- ### 结论 该文本描述的**上下文管理+结构化Prompt生成**,是提示词工程在**多轮对话场景下的典型应用**,尤其服务于RAG系统。其核心是通过**模板化、动态化、结构化**的Prompt设计,优化模型输入,提升回答的连贯性、准确性和可信度。
点赞
回复 取消回复
展开剩余 2 条回复

50 条评论

んuyunlong💋 2026年10月08日 15:53
引用原文:系统的第一步是由客户端主动发起一个 WebSocket 连接请求
@杠精派 @派聪明 为什么要使用websocket连接,sse接口明明更加简单通用
点赞
回复1 取消回复
杠精派 2026年10月08日 15:53
请围绕下面这段划线内容回复:"系统的第一步是由客户端主动发起一个 WebSocket 连接请求" 为什么要使用websocket连接,sse接口明明更加简单通用 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
んuyunlong💋 2026年10月08日 15:53
引用原文:系统的第一步是由客户端主动发起一个 WebSocket 连接请求
@派聪明 为什么要使用websocket连接,sse接口明明更加简单通用
点赞
回复1 取消回复
派聪明 2026年10月08日 15:53
这是我从文章中选择的一段文本:"系统的第一步是由客户端主动发起一个 WebSocket 连接请求" 为什么要使用websocket连接,sse接口明明更加简单通用 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
QAQ 2026年09月29日 11:34
引用原文:服务端收到请求后,会先验证用户的身份和权限,确认无误后,就会和客户端建立一个稳定的 WebSocket 长连接,用于后续的实时对话。
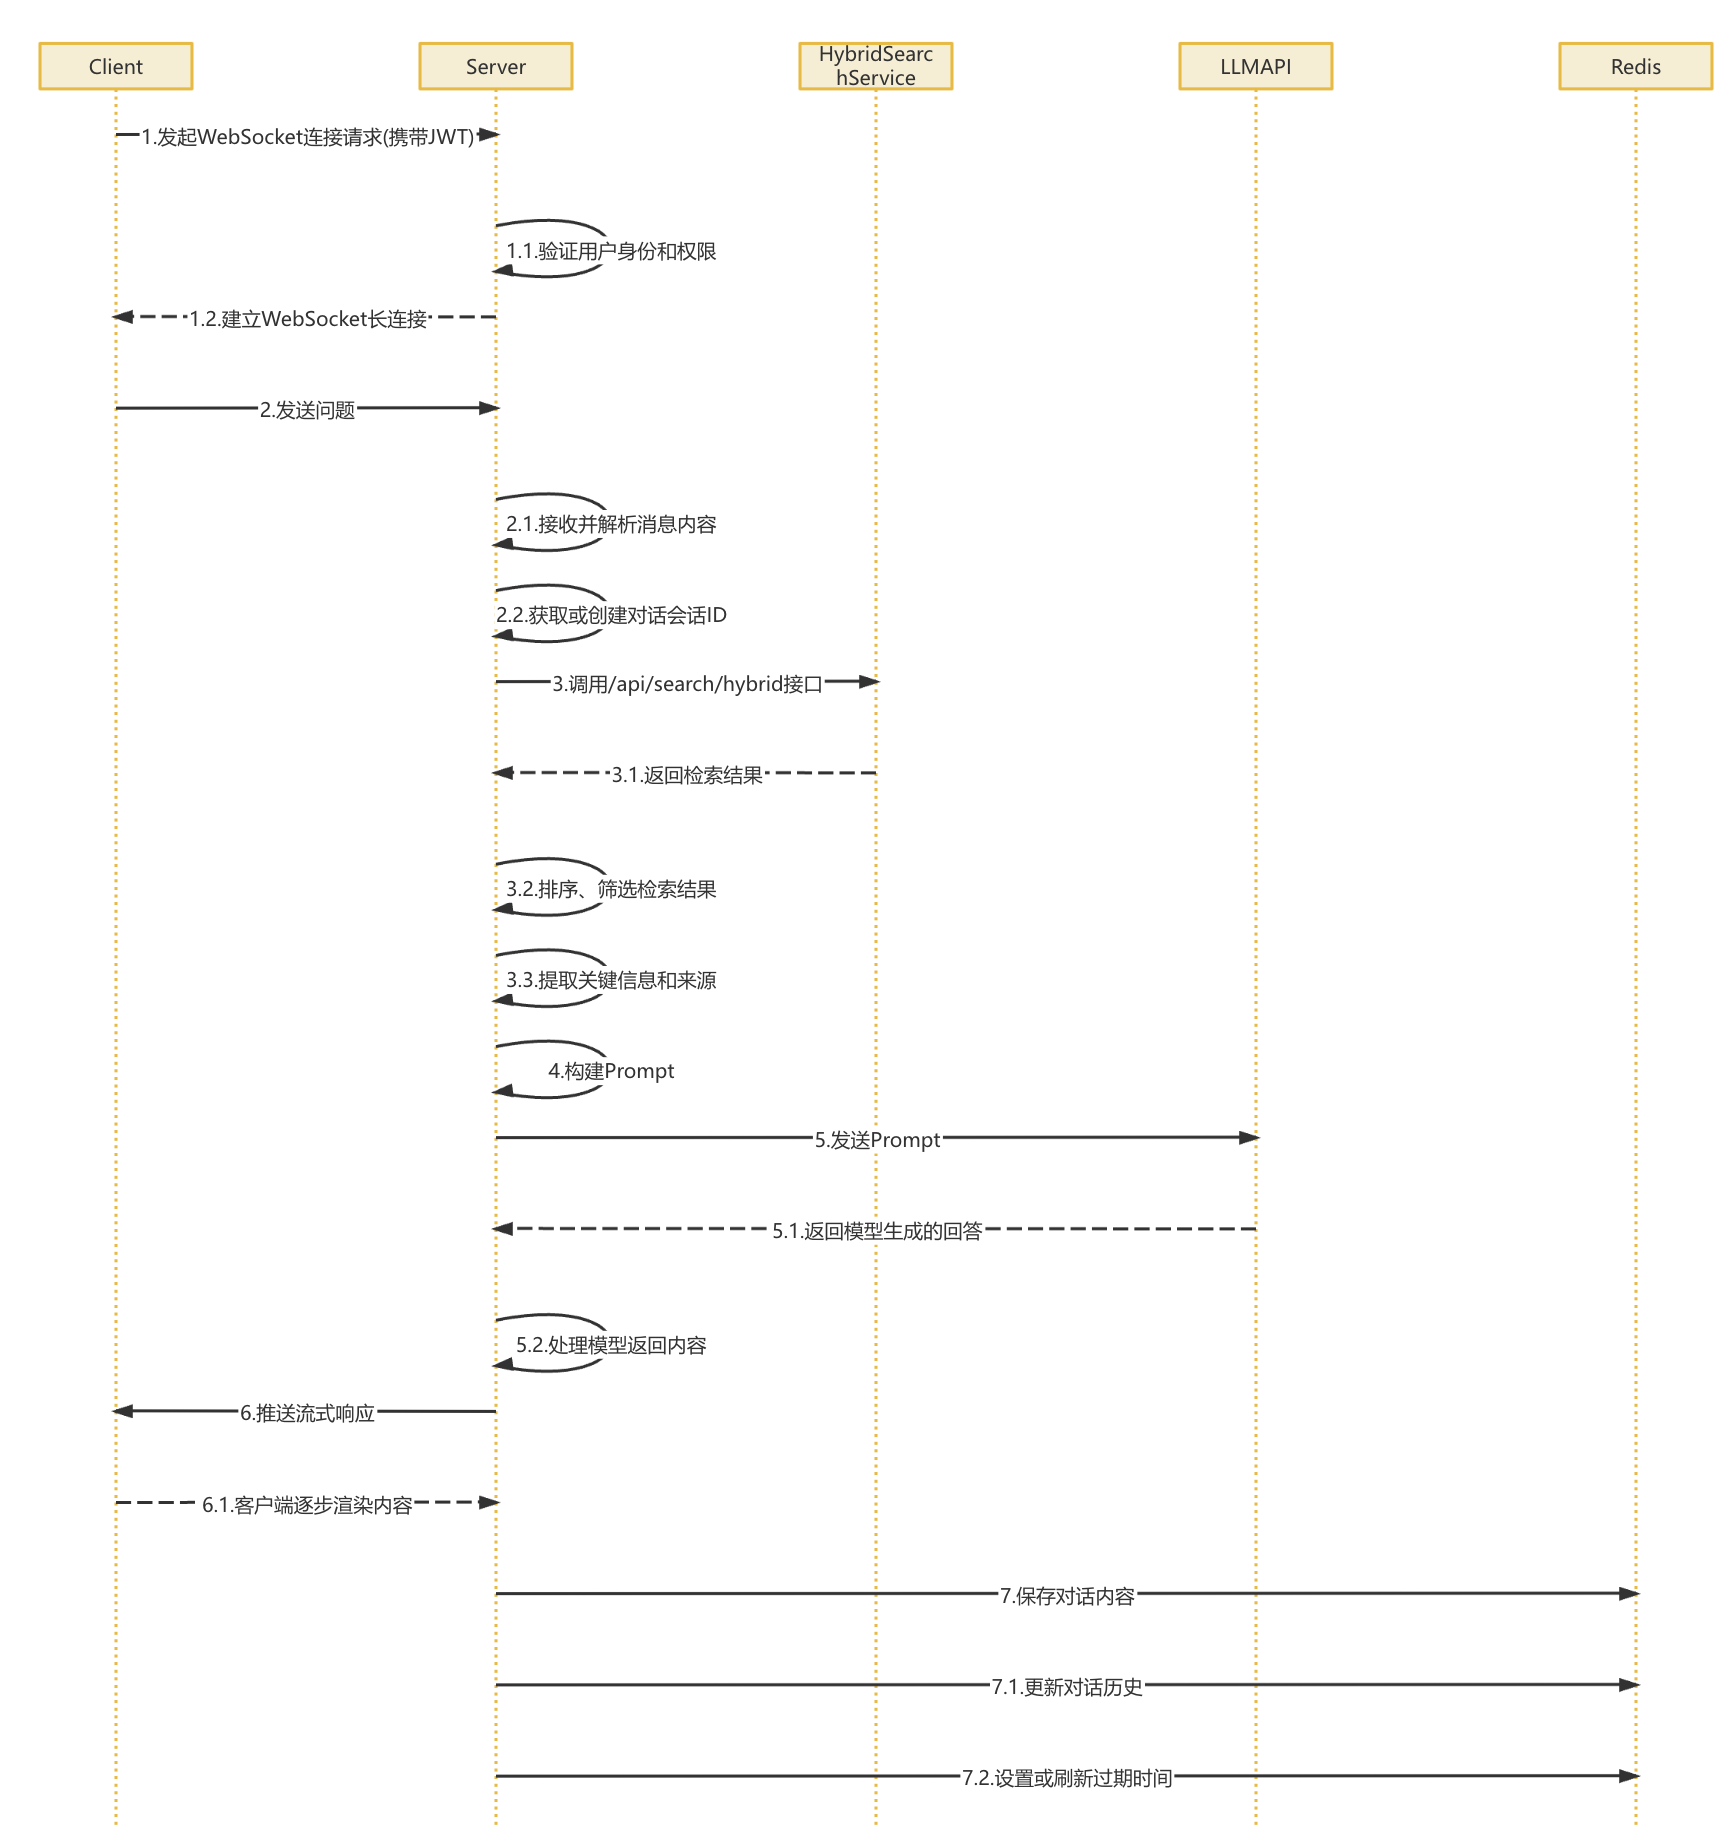
@派聪明 为什么要使用websocket连接,sse接口明明更加简单通用
点赞
回复1 取消回复
派聪明 2026年09月29日 11:34
这是我从文章中选择的一段文本:"服务端收到请求后,会先验证用户的身份和权限,确认无误后,就会和客户端建立一个稳定的 WebSocket 长连接,用于后续的实时对话。" 为什么要使用websocket连接,sse接口明明更加简单通用 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
etovo 2026年07月20日 15:55
@派聪明 派聪明中上下文过长是如何处理的?只保留最近20轮对话?
点赞
回复1 取消回复
派聪明 2026年07月20日 15:55
根据参考资料中的 **Redis 结构设计** 部分,派聪明系统确实对对话历史记录进行了长度限制——**最多保存 20 条消息**,超出部分会被自动截断,只保留最近的 20 条。 具体说明如下: 1. **限制机制**:对话历史 Key 为 `conversation:{conversationId}`,存储的 JSON 数组中的 `messages` 字段限制最多保存 20 条消息(包含用户提问和系统回答),超出时旧消息会被移除。 2. **实现示意**:从参考资料中的 `getConversationHistory` 方法可以看出,系统从 Redis 中读取整个历史记录数组,然后交由后续的 Prompt 构建流程处理,而 Redis 存储时就已经做了条数限制。 3. **目的**:这种设计主要是为了**控制 Prompt 的输入长度**,避免因多轮对话积累过多上下文导致超出大语言模型(如 DeepSeek)的 Token 限制,同时也能保证对话的连贯性和响应速度。 因此,你的理解基本正确——系统会限制最多保留最近 20 条消息(约 10 轮完整对话),超出部分自动丢弃,确保每次请求的上下文长度在可控范围内。
点赞
回复 取消回复
zsxq_03359 2026年07月09日 11:00
@派聪明 只在redis保存会话,没往db里边持久化会话吗?
点赞
回复1 取消回复
派聪明 2026年07月09日 11:00
根据参考资料中的设计,目前派聪明的**聊天助手模块确实只在 Redis 中保存会话和对话历史,没有往数据库(如 MySQL)中进行持久化**。 从 Redis 结构设计可以看出: | Redis Key | 用途 | TTL | |-----------|------|-----| | `user:{userId}:current_conversation` | 用户当前会话 ID 映射 | 7 天 | | `conversation:{conversationId}` | 对话历史记录(最多 20 条消息) | 7 天 | | `user:{userId}:conversations` | 用户的历史会话 ID 列表 | 7 天 | | `prompt_templates:{templateName}` | Prompt 模板缓存 | 无/较长时间 | 所有的历史记录查询接口(如 `/api/v1/users/conversation` 和 `/api/v1/admin/conversation`)也都是直接从 Redis 中读取数据,没有涉及数据库持久化。 ### 补充说明 这种设计属于**缓存即存储**模式,优点是读写性能高、开发简单,但存在以下局限: 1. **数据有丢失风险**:TTL 过期(7 天)后数据自动清理,无法长期保留历史会话。 2. **不支持复杂查询**:Redis 对按时间范围、关键词等条件检索的支持有限。 3. **内存成本**:随着会话量增长,Redis 内存消耗会持续上升。 如果后续需要**长期归档对话数据**、**支持更复杂的检索/分析**或**满足合规审计要求**,将历史会话持久化到数据库(如 MySQL/PostgreSQL/ES)是一个合理的演进方向。不过当前版本的设计更侧重于**高性能实时对话体验**,所以选择了纯 Redis 的方案。
点赞
回复 取消回复
A.Mars(水准) 2026年07月02日 13:46
引用原文:支持多种 Prompt 模板配置与调优
这部分是怎么实现的?@派聪明
点赞
回复1 取消回复
派聪明 2026年07月02日 13:46
根据参考资料,**“支持多种 Prompt 模板配置与调优”** 主要是通过一套**自研模板引擎** + **Redis 缓存** + **动态变量替换**机制实现的。具体来说,分为以下几个层面: ### 1. 模板定义与管理 系统将 Prompt 模板作为结构化数据存储,每个模板包含以下核心字段(以 Redis 缓存为例): ```json { "name": "knowledge_qa", "template": "你是派聪明...\n参考信息:{{context}}\n对话历史:{{history}}\n用户问题:{{query}}", "variables": ["context", "history", "query"], "max_tokens": 4000 } ``` - **Redis Key**:`prompt_templates:{templateName}` - **支持多个模板**:可根据不同场景(如知识问答、日常闲聊、业务咨询)配置不同的模板名称。 ### 2. 动态变量替换(核心实现) 系统通过自研模板引擎完成以下步骤: 1. **根据问题类型选择合适的模板**(例如知识类问题选中 `knowledge_qa` 模板)。 2. **填充变量**:将检索到的知识片段(`{{context}}`)、对话历史(`{{history}}`)、用户问题(`{{query}}`)等动态注入模板。 3. **上下文长度管理**:自动截断或压缩过长的历史记录,确保不超出模型的最大 Token 限制。 4. **系统指令拼接**:在模板中嵌入预设的规则(如“优先基于参考信息回答”、“引用来源使用[文档X]格式”等)。 ### 3. 调优支持 - **模板可配置**:通过修改 Redis 中的模板内容即可调整模型的行为风格(如严谨/活泼、详细/简洁)。 - **变量可扩展**:可根据业务需求新增变量(如 `{{user_name}}`、`{{language}}`),模板引擎自动适配。 - **参数可调**:每个模板可独立设置 `max_tokens` 等生成参数,针对不同场景精细化控制。 ### 总结 这套机制的本质是:**将 Prompt 视为可配置的模板资源**,通过**模板引擎**动态拼接检索结果+上下文+系统指令,再配合 **Redis 缓存**实现模板的快速读取和灵活调整。这就实现了你提到的“支持多种 Prompt 模板配置与调优”,也是派聪明实现 RAG(检索增强生成)的关键保障。
点赞
回复 取消回复
Paopao 2026年05月04日 12:06
引用原文:系统这边则以流式的方式逐段接收内容
@派聪明 怎么实现的
点赞
回复 取消回复
Qi. 2026年04月26日 16:07
引用原文:解析内容
@派聪明 具体解析方法步骤是什么
点赞
回复 取消回复
漲达赚 2026年04月08日 21:21
引用原文:huihui
1
点赞
回复 取消回复
呃呃呃 2026年03月23日 15:19
引用原文:Prompt 模板缓存
@派聪明 系统中有哪些模板
点赞
回复 取消回复

目录