
✅派聪明RAG项目如何写到简历上?(附 20 道精选 AI 面试题)
重要提示,这部分内容有一些是我修改的球友简历,放上来是为了方便大家参考,请不要相互传播,引起误会,大家参考学习就好了,后期有遇到不错的内容我也会更新上来,互帮互助,才能更进一步。
- 如果有引发误会,我就只能保留前三个,其他都会删掉,望周知。
- 项目的写法有很多,往后面翻一翻。
- 教程和源码的获取方式:https://t.zsxq.com/XBc0a
- 派聪明的学习路线:https://paicoding.com/article/detail/2530200055836673
:::
xxxx数智有限公司|研发部|Java 后端 / AI 开发实习生 2026.05 - 2026.06
项目名称:政务热线工单平台|RAG 智能政务问答助手
项目简介:面向政务热线与政策知识查询场景,参与建设支持多格式文档解析、混合检索、引用溯源及多租户权限控制的 RAG 问答系统,解决政策名称、事项编号等精确查询场景下纯向量检索效果不足的问题,支撑 13 个租户、8.32 万份知识文档的管理与检索。
技术栈:Java、RAG、Milvus、Elasticsearch、BM25、BGE Reranker、JWT、RBAC、MySQL
核心职责:
• 负责 RAG 检索策略优化,针对政策名称、业务事项及政策编号等专业词汇难以通过语义向量准确召回的问题,将原有单路向量检索升级为 BM25 + Dense Vector 双路召回,并通过 Reranker 精排候选片段;在 500 条固定测试集上,Recall@5 由 82.3% 提升至 91.6%,提高 9.3 个百分点。
• 设计混合检索与引用溯源机制,通过 Milvus 获取 Top-20 语义候选,结合 Elasticsearch BM25 关键词结果进行合并去重,再使用 bge-reranker-v2-m3 选取最终 Top-5;统一维护 Document、Chunk 及 Source Metadata,使模型回答能够引用对应政策文档及原始内容。
• 参与多租户知识库权限与会话管理开发,基于 JWT + RBAC + TenantContext 管理用户身份及租户权限,并在 Milvus、Elasticsearch 检索阶段注入 Tenant / ACL 过滤条件,避免其他租户的知识片段进入模型上下文;同时实现会话消息持久化、近期记忆与历史摘要管理,支持多轮政务咨询。
派聪明(企业级 RAG 知识库问答 Agent)
项目简介:基于 Elasticsearch 8 混合检索与 ReAct 工具调用的企业级知识库问答系统,支持大文件分片上传、异步流式解析、多级权限隔离检索、多轮复合意图问答与事后引用核验,检索与回答质量由 50 题离线评测集持续验证。
技术栈:Spring Boot 3 + Elasticsearch 8 + 阿里百炼 text-embedding-v4 / gte-rerank-v2 + DeepSeek + Kafka + Redis + MySQL + MinIO
【截图:派聪明简历核心技术栈与指标看板;风格:data-board;截图目标:展示派聪明简历包装中的关键架构组件与真实评测提升数据;关键词:Recall@5 76.1%、120 秒请求预算、三级阈值截断】
核心职责:
- 实现 ReAct 问答与工具调度机制,注册知识库检索、文档摘要、反馈记录、统计查询 4 类工具,通过第 1 轮强制挂载工具与 5 类跳过检索白名单解决模型盲目自信不查询知识库的问题,支持单轮多工具调用与最多 4 轮、8 次调用的分步推理,多次检索自动顺延引用编号并由 120 秒请求级截止时间保障超时可控
- 构建混合检索与三级防噪截断流程,BM25 与 2048 维向量 KNN 双路并行召回并经 RRF(k=60)融合,接入 gte-rerank-v2 对前 50 条候选精排,分别在精排(0.1)、RRF 兜底(0.028)和纯文本降级(0.3)设置分数阈值拦截低分噪声,分块级 Recall@5 达 76.1%、文档级召回率达 100%
- 设计父子分块扩展与多阶段防幻觉机制,检索命中 512 字符子块后自动拉取前后相邻分块合并为最多 1500 字符的父块补全上下文,生成侧采用 0.3 低温采样与局部拒答约束,生成后在独立线程池提取带引用编号的句子与父块原文逐句核验,自动标记可疑引用
- 搭建用户负向反馈修正与问题定位机制,提供反馈接口与对话工具将评价写入 Redis,后续对话自动注入该用户最新 5 条反馈实时修正回答偏好,同时将点踩记录关联原始提问、回答与分块引用映射定位检索或生成阶段问题,回流扩充离线评测集
- 落地 50 道题的 7 类场景离线评测与人工校准体系,统计分块级 Recall@5、MRR、NDCG@5 与评委打分,对检索未命中但评委判对的异常样本强制人工复核,模型评委与人工复核一致率达 80%(Cohen's kappa 0.61)
xxx|国家重点实验室|Agent 开发实习生 2026.05 – 至今
项目名称:内网 RAG 知识检索与智能研判系统
项目简介:面向涉密内网技术资料检索与趋势研判场景,独立负责 RAG 核心模块开发,在公网隔离环境完成模型与检索组件私有化部署,支持长技术报告知识问答、复杂问题多轮检索及证据溯源。
技术栈:Python、MinerU、BGE-M3、Milvus、BM25、RRF、Reranker、Qwen、Celery、Redis
核心职责:
• 负责内网 RAG 系统开发,在公网隔离环境完成 MinerU、BGE-M3、Milvus、Reranker、Qwen 等组件本地化部署;针对长技术报告固定切片容易造成语义割裂与重复上下文的问题,采用 Parent-Child Chunk 分层索引,以细粒度子块完成召回并回溯父级内容生成回答。
• 针对缩写、设备型号及专业术语在纯向量检索中容易漏召回的问题,融合 BGE-M3 Dense 与 BM25 Sparse 双路检索,通过 RRF 合并候选结果并使用 BGE Reranker 精排,同时结合时间、技术领域等 Metadata Filter 缩小检索范围;在固定技术问答评测集上 Recall@10 由 0.72 提升至 0.87,MRR@10 由 0.64 提升至 0.79。
• 针对 PDF 解析、Chunking、Embedding 等耗时操作阻塞在线问答的问题,基于 Celery + Redis 将文档解析、向量化及索引写入改为异步任务,并缓存高频 Query 与 Retrieval / Rerank 结果,减少重复模型计算与向量检索。
• 针对复杂趋势问题单次检索难以覆盖完整证据的问题,实现 Query Rewrite 与多轮补充检索,根据已获取证据动态调整查询并结合时间、技术领域等条件限制检索范围;进一步结合主题演化、时间序列与变点检测生成趋势判断,并为 Document / Page / Chunk 建立 Evidence ID,使分析结论能够回溯至原始文档及具体页面。
派聪明 RAG 知识库 RustFS
项目简介:基于 Elasticsearch 混合搜索的 RAG 知识库系统,支持文档上传、分块解析、向量检索和智能问答。
技术栈:Spring Boot、RustFS、AWS SDK for Java v2、Elasticsearch、Kafka、PyIceberg、DuckDB
核心职责:
- 将对象存储从 MinIO 迁移到 RustFS,通过标准 S3 API 对接 AWS SDK for Java v2,业务代码零改动
- 设计分片上传合并方案,解决浏览器分片小于 S3 Multipart 5 MiB 限制的问题,支持断点续传和失败自动回滚
- 编写 Python 跨存储迁移工具,支持 SHA-256 校验、元数据保留和 dry-run 模式,迁移过程零数据丢失
- 集成 RustFS S3 Tables(Iceberg REST Catalog),实现 RAG 分块数据的结构化存储和 SQL 查询
- 配置 Docker Compose 编排 RustFS 服务,实现健康检查、CORS 跨域、内外网双地址预签名
YuForge Knowledge Engine|研发知识库与 AI Agent 知识引擎
GitHub: gxySkywalker/YuForge-Knowledge-Engine
项目简介:面向企业研发团队与 Coding Agent 的研发知识引擎,统一管理需求、架构、规范及版本文档,通过 RAG 为开发者与 Codex 等 Agent 提供带引用、可追溯、权限隔离的知识检索与智能问答,并支持 Web、REST、CLI、MCP 多种接入方式。
技术栈:Java、Spring Boot、MySQL、Redis、Kafka、MinIO、Elasticsearch、Apache Tika、WebFlux、Qwen Embedding / Reranker、DeepSeek、MCP
核心职责:
• 基于 Elasticsearch 实现 Hybrid Retrieval,融合 BM25 关键词检索与 2048 维 Dense Vector 语义召回,通过 RRF 合并候选结果并使用 Qwen3 Reranker 精排;增加 Confidence Gate 对低置信度结果拒答,兼顾代码标识、专业术语与自然语言查询的检索效果。
• 设计 Evidence-grounded RAG 问答机制,针对跨需求、架构、规范等多主题问题拆分检索子任务,并按照显式版本、知识权威等级及相关性选择证据;生成结果要求逐项绑定稳定 Citation,并对引用有效性进行校验,在证据不足时支持部分回答或明确拒答,减少无依据内容进入研发决策。
• 设计 Asset → DocumentVersion → ContentNode → Chunk → Embedding 分层知识模型,通过 DocumentVersion 管理同一研发资产的历史版本,并以状态机控制解析、切片、Embedding、索引及失败恢复;基于 Kafka 将文件上传与知识加工异步执行,支持 100 MiB 文件、20 分片乱序上传、重复分片幂等及断点续传。
• 针对企业知识存在部门、项目及资产权限边界的问题,基于用户角色、组织标签、公开属性与资产归属生成 ACL Filter,并在 BM25 与向量检索阶段直接限制候选范围,避免无权限内容被召回后进入 LLM Context,实现检索阶段的数据权限隔离。
• 建立 Retrieval 与 Generation 双层评测机制,通过黄金数据集持续评估 Recall、MRR、nDCG 等检索指标,以及事实完整度、Citation 有效性与拒答准确率;结合自动化回归覆盖知识版本、权限、检索及问答场景,避免检索策略或模型调整造成效果退化。
项目名称:PaiSmart 2026年4月-2026年5月
项目介绍:基于 RAG 的企业级 AI 知识库,支持多租户文档智能检索与对话问答,提供从文档上传、切片向量化到语义检索、流式对话等。
技术栈:Spring Boot 3.4 / WebSocket / Elasticsearch 8 / Kafka / Redis / MinIO / MySQL / DeepSeek API / 阿里 Embedding
核心职责:
基于 WebSocket 实现全双工流式对话,后端通过 WebFlux 的 Stream 接入 DeepSeek 等 LLM 的 SSE 流,实现逐字输出;支持用户主动中断,后端同步取消 LLM 侧的流式连接,避免错误提示词下的 Token 消耗;整体首字响应延迟控制在 500ms 以内。
基于 LiteParse 命令行工具重构 PDF 解析流程,通过子进程调用实现本地 OCR,解决扫描件与图片型 PDF 在知识库中无法被检索的问题
设计可插拔 OCR 适配层,借助 LiteParse 的 ocr-server-url 机制将识别引擎在本地 Tesseract 与阿里云高精版 OCR 之间无缝切换
实现对话内容的持久化和断线续传,每个流式内容原子写入 Redis,并通过状态机维持状态;用户断线重连后自动恢复上一次输出进度,不丢失已生成文本,保障弱网环境下的用户体验。
利用 Elasticsearch + IK 分词器对知识库文档进行索引和向量检索,支持 Word、PDF 和 TXT 等多种文本类型;并集成阿里 Embedding 模型进行文本到向量的转换,支持 2048 维;再结合 ES 的 KNN 向量召回、关键词过滤和 BM25 重排序实现「关键词+语义」的双引擎搜索,同时内嵌多租户权限过滤,确保数据隔离。
基于 Spring WebSocket 实现全双工流式对话,后端通过 WebFlux 的 Reactive Stream 接入 DeepSeek 等 LLM 的 SSE 流,实现逐字输出;支持用户主动中断生成,后端同步取消 LLM 侧的流式连接,避免无效 Token 消耗;整体首字响应延迟控制在 500ms 以内。
前端使用 SparkMD5 计算文件指纹,然后开启 4 个 worker 并发上传分片;后端通过 Bitmap 追踪分片状态;合并阶段按 chunkIndex 升序组装后调用 MinIO 进行合并,保证分片不乱序。
利用 Kafka 进行异步文档处理,覆盖「文件解析 → 文本切片 → 向量化入库」全流程,并通过事务确保生产者侧消息不丢失不重复,消费端失败的消息经 4 次重试后自动路由至死信队列。
通过 Redis 维护 20 条消息的上下文窗口,供 LLM 调用时毫秒级加载;并将完整对话内容持久化到 MySQL。
实现可热插拔的多模型路由与 Token 配额管理,支持运行时切换 DeepSeek、通义千问等 LLM 和 Embedding 供应商,无需重启服务;并通过流式 usage 解析实现精确的 Token 消耗计量,结合每日请求数 + Token 余额双维度限流,控制调用成本。
西南技术工程研究所|大模型应用开发 2025.07 – 2026.02
项目名称:Agentic RAG 企业知识库系统
项目简介:面向环境工程领域的企业知识库系统,支持文档解析、知识图谱构建、结构化数据查询及智能问答,通过 Agentic RAG 完成复杂问题分析与知识检索,为科研场景提供智能检索能力。
技术栈:Spring Boot、MySQL、Redis、Kafka、Elasticsearch、MinIO、MinerU、Ollama
核心职责:
• 使用 Kafka 构建文档异步处理流程,将文件上传、解析、切片、向量化拆分为后台任务执行;结合 Redis Bitmap 管理分片上传状态,并使用 MinIO 实现大文件断点续传,提高文档处理吞吐能力。
• 设计 Agent 执行流程,根据用户问题复杂度动态选择 ReAct 或 Plan-Execute 两种执行模式;同时实现分层上下文管理,通过滑动窗口保留近期对话,对历史内容进行摘要压缩,降低长对话中的 Token 消耗。
• 实现意图驱动的混合检索模块,根据查询类型自动选择检索策略;普通问答采用 BM25、KNN 双路召回及 RRF 融合排序,复杂关系查询结合知识图谱完成多跳检索,并统一通过 Rerank 对文本与图谱结果进行排序,提高复杂问题检索准确率。
• 构建知识图谱增量更新机制,将文档实体、关系及文本片段建立关联索引,支持新增文档自动更新知识图谱,减少全量重建带来的计算开销。
• 建立 RAG 离线评测体系,基于 RAGAS 自动回放检索与生成流程,并结合人工校验持续评估证据相关性、信息覆盖率、回答忠实度及答案相关性等指标,核心指标稳定保持在 0.73~0.80。
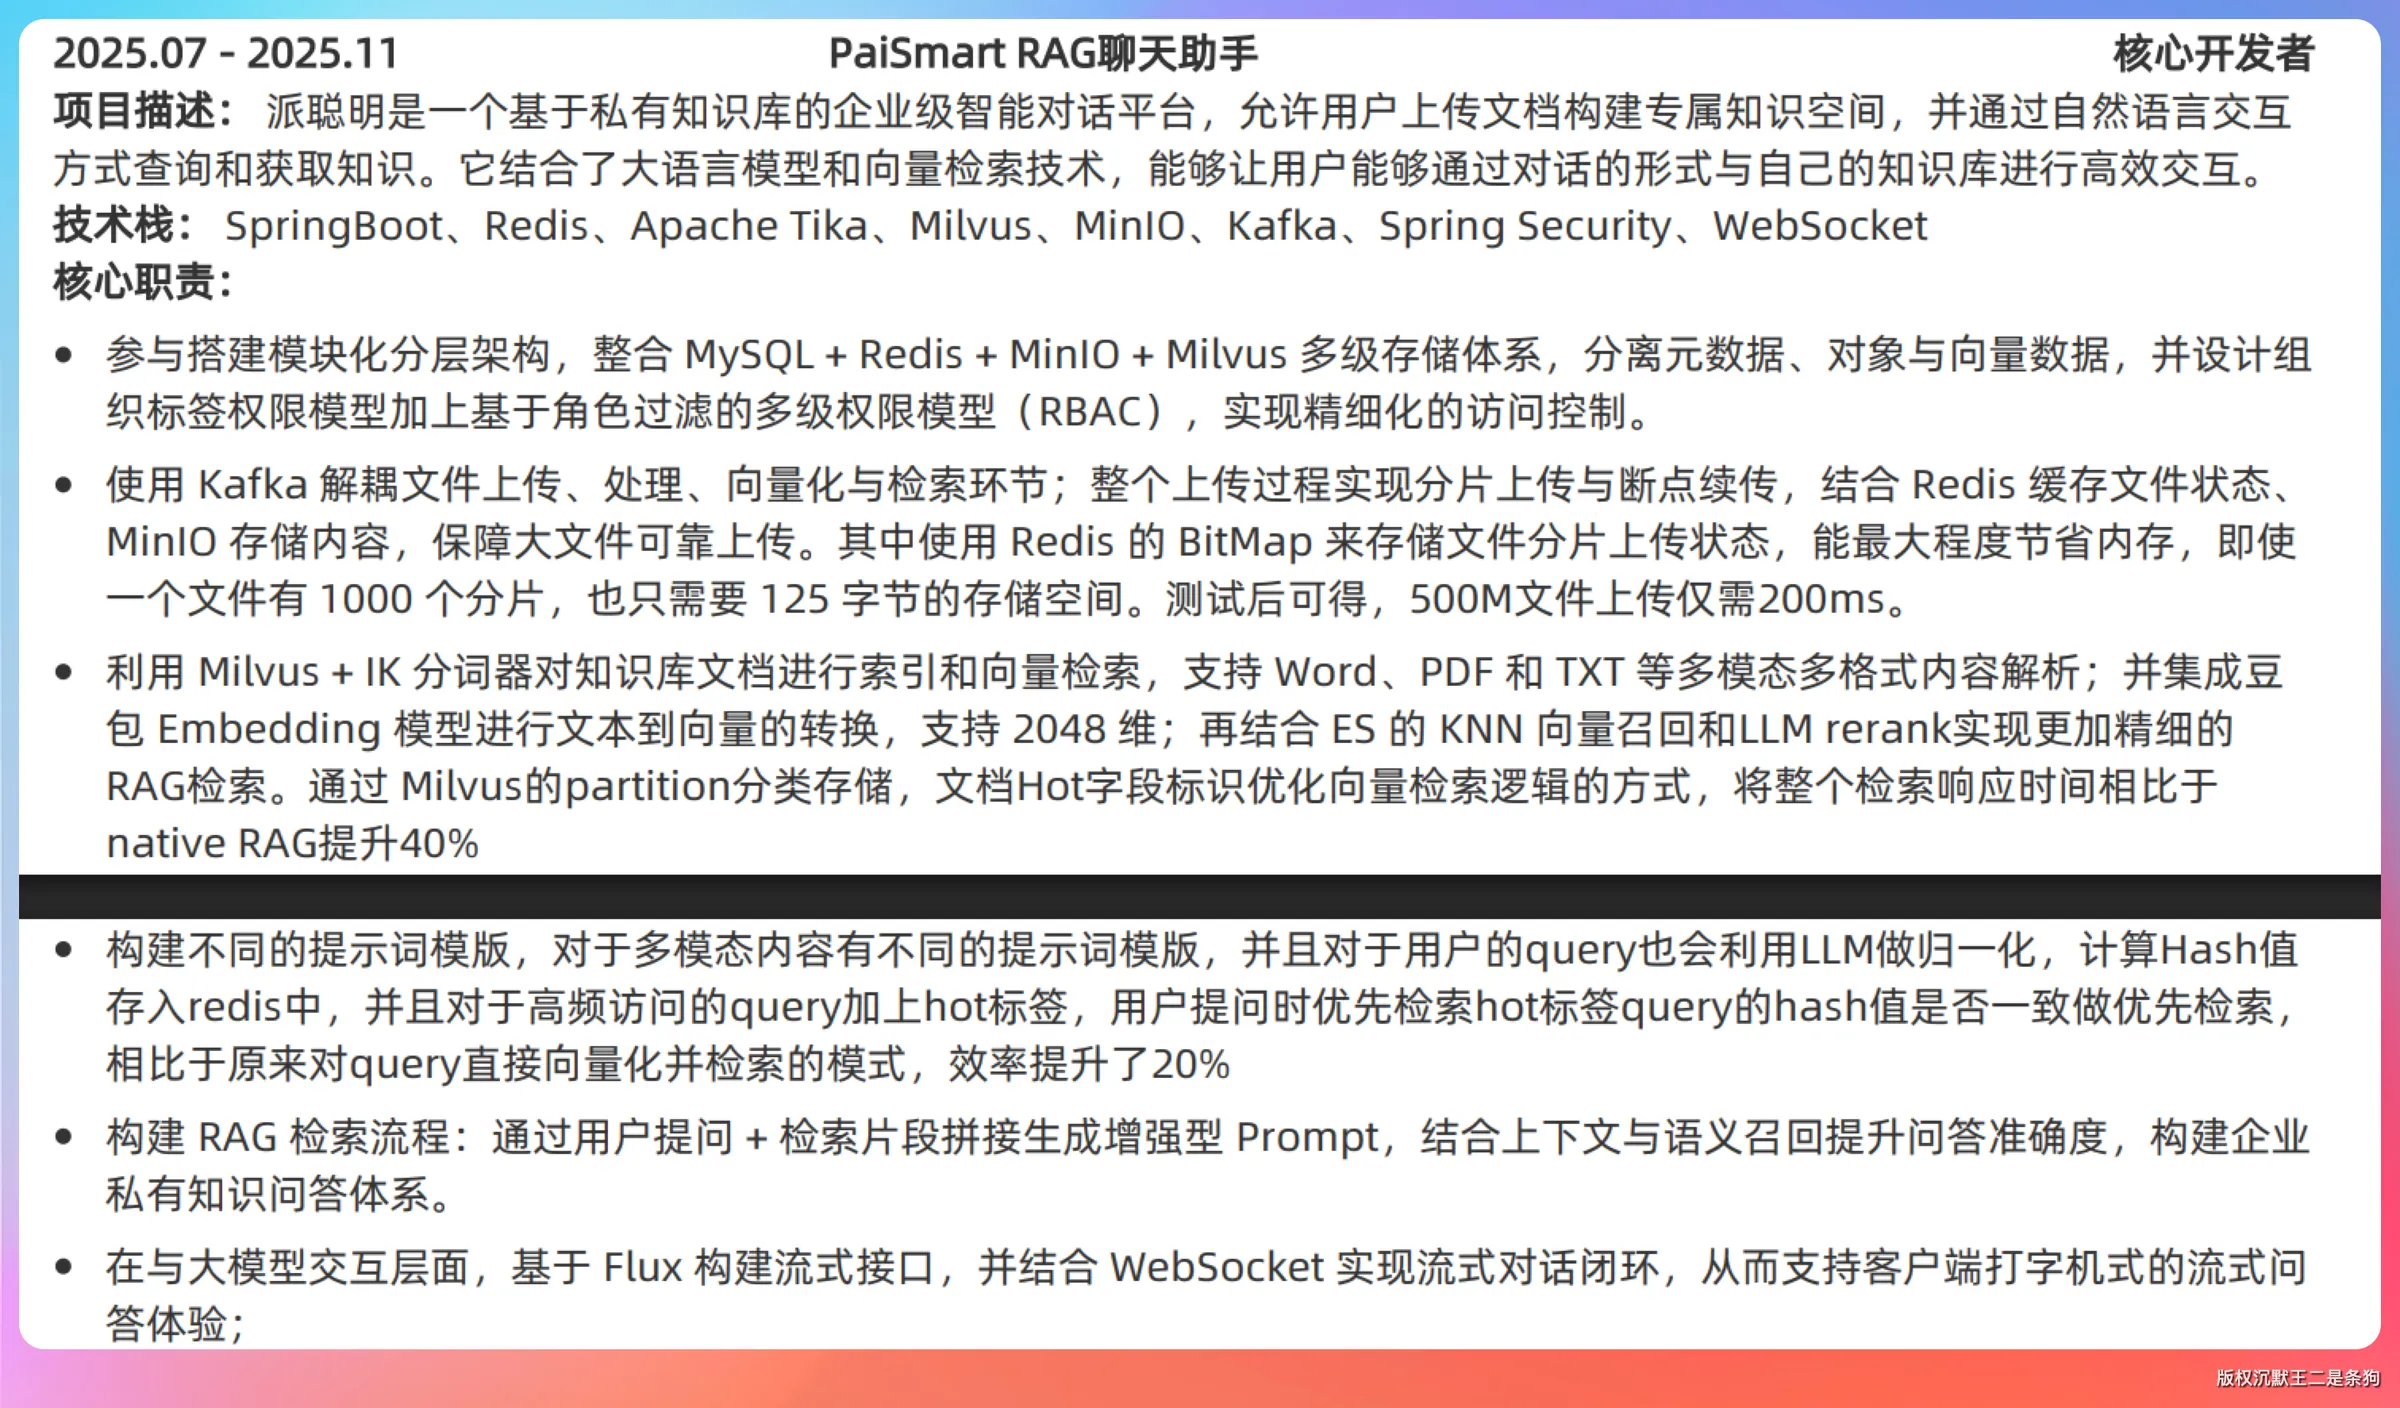
写法1 派聪明 RAG 知识库 Java 后端开发 2025-06 ~ 2025-09
项目描述:派聪明是一个基于私有知识库的企业级智能对话平台,允许用户上传文档构建专属知识空间,并通过自然语言交互方式查询和获取知识。它结合了大语言模型和向量检索技术,能够让用户能够通过对话的形式与自己的知识库进行高效交互。
技术栈:SpringBoot、MySQL、Redis、Apache Tika、Ollama、Elasticsearch、MinIO、Kafka、Spring Security、WebSocket、Linux、Shell
核心职责:
- 编写 shell 脚本,一键启动 Kafka 的 KRaft模式,自动处理 cluster ID 的冲突问题,包括清理日志、生成集群 ID、格式化存储目录、启动 Kafka 服务器等。
- 利用 Elasticsearch 加 IK 分词器对知识库文档进行索引和向量检索,结合 KNN 向量召回与 BM25 关键词匹配,通过 RRF 融合排序实现语义加关键词的双引擎检...
未能定位到原文的划线
企业级Agent工作流编排项目PaiFlow
Vibe Coding版本的PaiAgent
派聪明RAG AI知识库Java版本+Go版本
微服务 PmHub、技术派、MYDB
求职派JobClaw(OpenClaw/Hermes架构
PaiCLI(类似Claude Code的Agent
派简历(代码已完成)
等实战项目。
1. 微信扫右侧的优惠券加入知识星球
2. 解锁星球的实战项目教程和源码: 项目源码+教程获取
70人已点赞



热门评论
86 条评论
回复