
派聪明接入 DeepSeek 全家桶 API
大家好,我是二哥呀。
DeepSeek 在 11 月 13 日开放了全家桶 API,搜索、网页抓取、文件解析和 OCR 都可以直接调用。
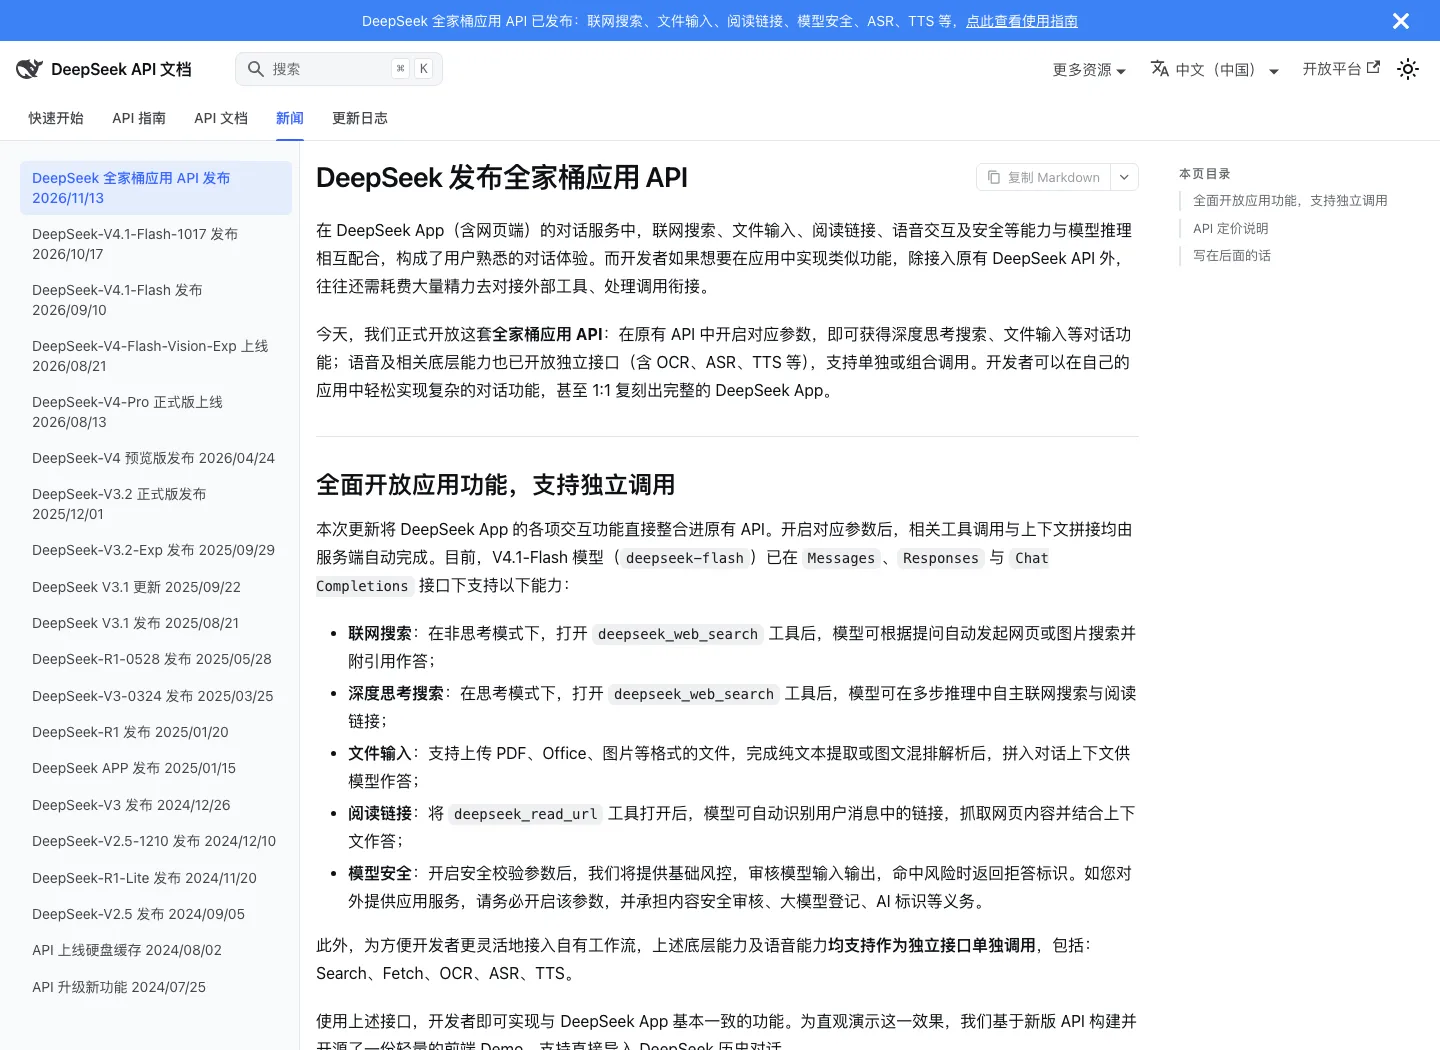
派聪明这次用到了其中的搜索、抓取、OCR、文件输入和模型安全审核,语音识别(ASR)和语音合成(TTS)暂未接入。
先看这几个接口各自负责什么,后面读源码会轻松很多。
| 场景 | 派聪明调用的接口 | 结果的去向 |
|---|---|---|
| 搜索公开资料 | /v1/tools/search |
搜索摘要作为工具结果交给 Agent |
| 阅读一个链接 | /v1/tools/fetch |
网页正文作为工具结果交给 Agent,同时保存来源 |
| 在当前会话中使用附件 | /files |
返回文件标识,由后端拼进发给模型的消息 |
| 从知识库图片中提取文字 | /v1/tools/ocr |
文字进入解析和分块流程 |
| 理解图表、生成回答 | /chat/completions |
生成图片描述或最终回答 |
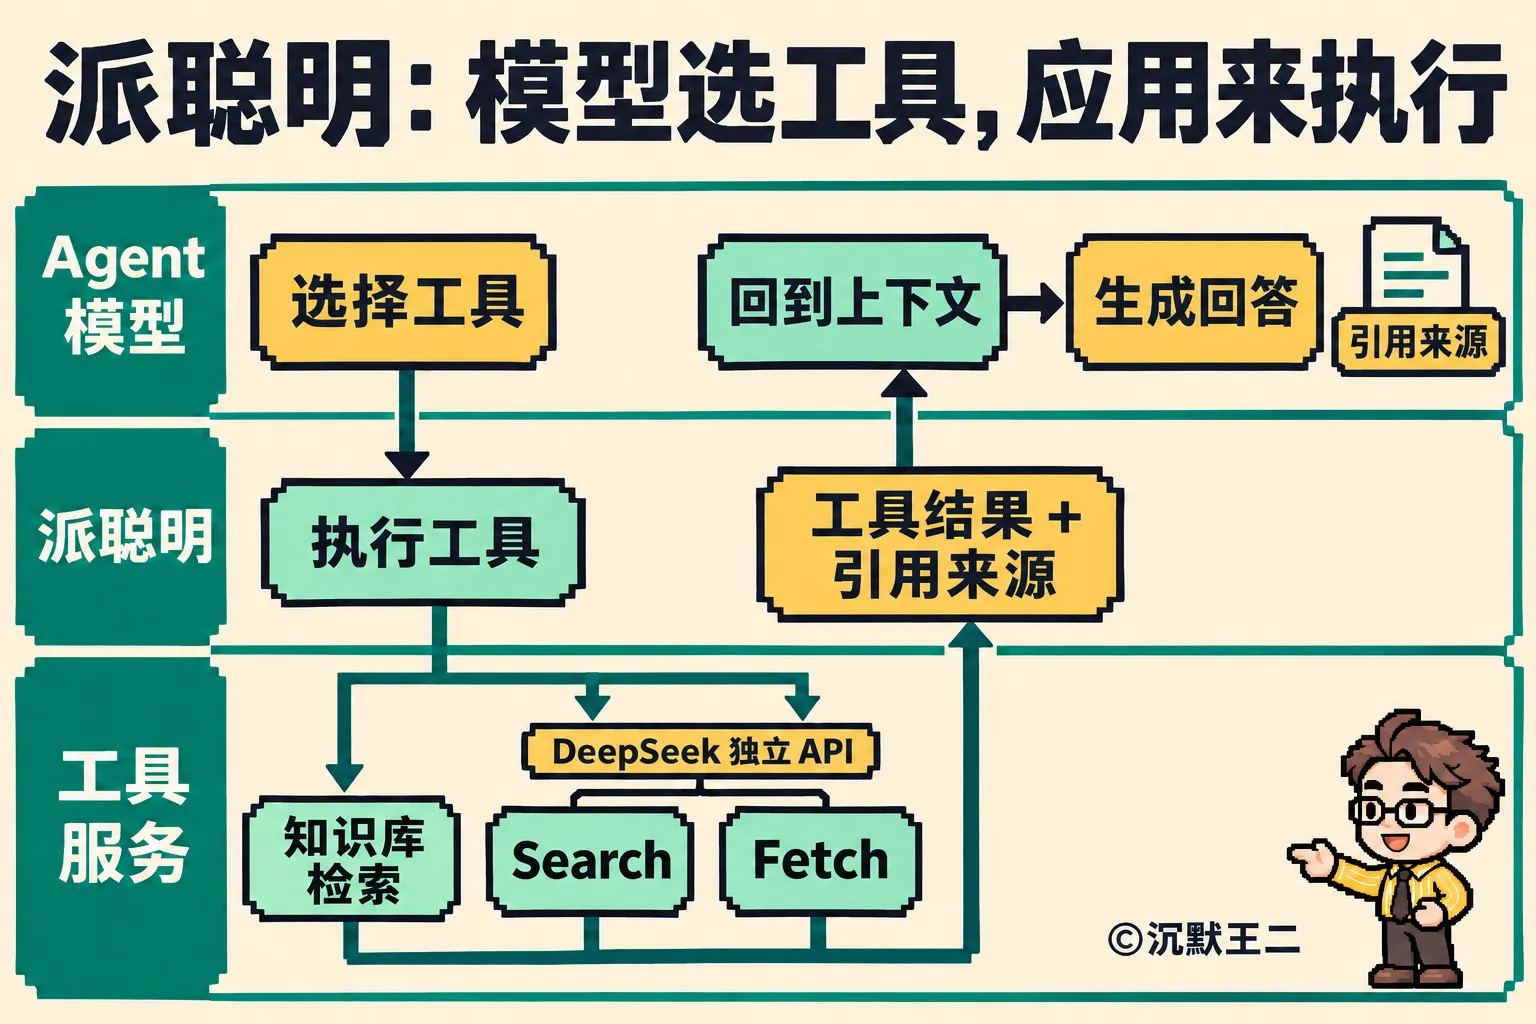
派聪明没有使用官方内置的联网搜索工具,如果使用内置工具,整个搜索过程都由 DeepSeek 服务端完成,派聪明就没办法把搜索结果和自己的知识库检索整合在一起。
01、配置在线增强能力
先确保派聪明已经能正常运行。
后端依赖 MySQL、Redis、Elasticsearch、Kafka 和兼容 S3 协议的对象存储,前端通过 Vite 代理访问后端。
打开项目根目录的 .env,核对下面这些配置。API Key 只写在本地配置里,不要提交到仓库。
DEEPSEEK_APPS_ENABLED=true
DEEPSEEK_APPS_BASE_URL=https://api.deepseek.com
DEEPSEEK_APPS_API_KEY=
DEEPSEEK_APPS_MODEL=deepseek-flash
DEEPSEEK_APPS_SAFETY_ENABLED=true
DEEPSEEK_APPS_OCR_ENABLED=true

FILE_PARSING_ARTIFACTS_ENABLED=true
FILE_PARSING_ARTIFACTS_VERSION=visual-v1
FILE_PARSING_ARTIFACTS_OFFICE_COMMAND=soffice
DEEPSEEK_APPS_API_KEY 留空时,后端会使用模型管理里配置的 DeepSeek Key,它的默认值来自 DEEPSEEK_API_KEY。DEEPSEEK_APPS_BASE_URL 只填域名,各接口的路径由程序自动拼接。
转换 Word、PPT 需要安装 LibreOffice,按页解析 PDF 需要 LiteParse。可以在运行后端的机器上逐条执行下面的命令,确认这些工具都已安装。
java -version
mvn -version
node --version
pnpm --version
command -v lit
soffice --version
如果 soffice 不在 PATH 中,就把配置改成它的完整路径。没有安装 LibreOffice 时,Office 文件会解析失败并给出提示,这时可以先手动把文件转成 PDF 再上传。
启动方式和以前一样。
后端在 PaiSmart 根目录执行 mvn spring-boot:run,前端在 frontend 目录执行 pnpm dev。如果之前是用 IDE 启动的,继续用 IDE 即可。修改环境变量后,要重启服务才会生效。
本文的前端地址是 http://localhost:9527,后端地址是 http://localhost:18081/api/v1。后端端口请以自己的 .env 和 frontend/.env.test.local 为准。
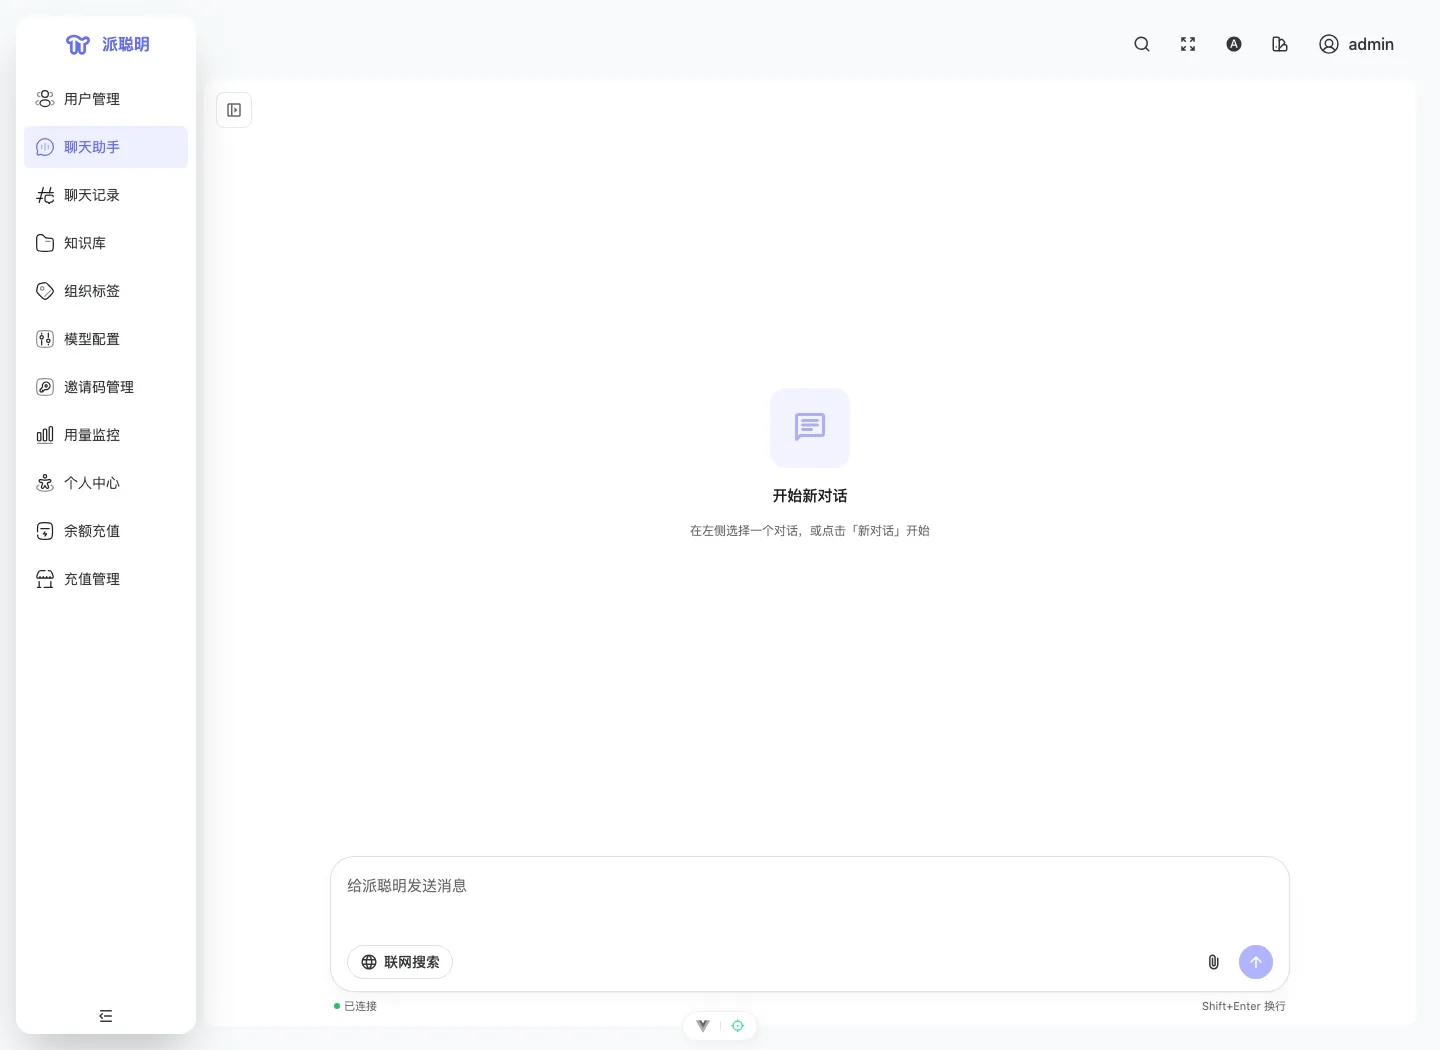
会话输入框里新增了「联网搜索」和「添加文件或图片」两个按钮。联网搜索默认关闭,但只要在消息里贴了一个公网链接,系统仍然会去阅读这个网页。
开启在线增强后,问答固定使用配置好的 DeepSeek 模型。
原因是附件消息和安全审核都依赖 DeepSeek 的接口格式,换成其他供应商的模型可能无法识别。关闭总开关后,问答会恢复原来的模型切换方式。Embedding 仍然使用单独的配置。
02、让网页成为可追溯的回答依据
先试试直接给一个链接。在会话中输入下面的任务:
请阅读这个链接,概括 Search 和 Fetch 的区别,并保留来源链接。
https://api-docs.deepseek.com/zh-cn/guides/search/
模型调用 read_url 后,派聪明会先检查链接地址,没问题才调用 Fetch 接口。目前只允许访问公网的 HTTP 或 HTTPS 地址,本机地址、内网地址和不允许的端口都会被拒绝,防止有人借这个工具访问服务器内部的服务。
如果抓到的网页正文为空,这次工具调用就算失败。如果正文太长,服务端默认只保留前 16000 个字符,并在末尾标明内容已截断。截断是为了控制上下文长度,所以模型拿到的并不是完整网页。
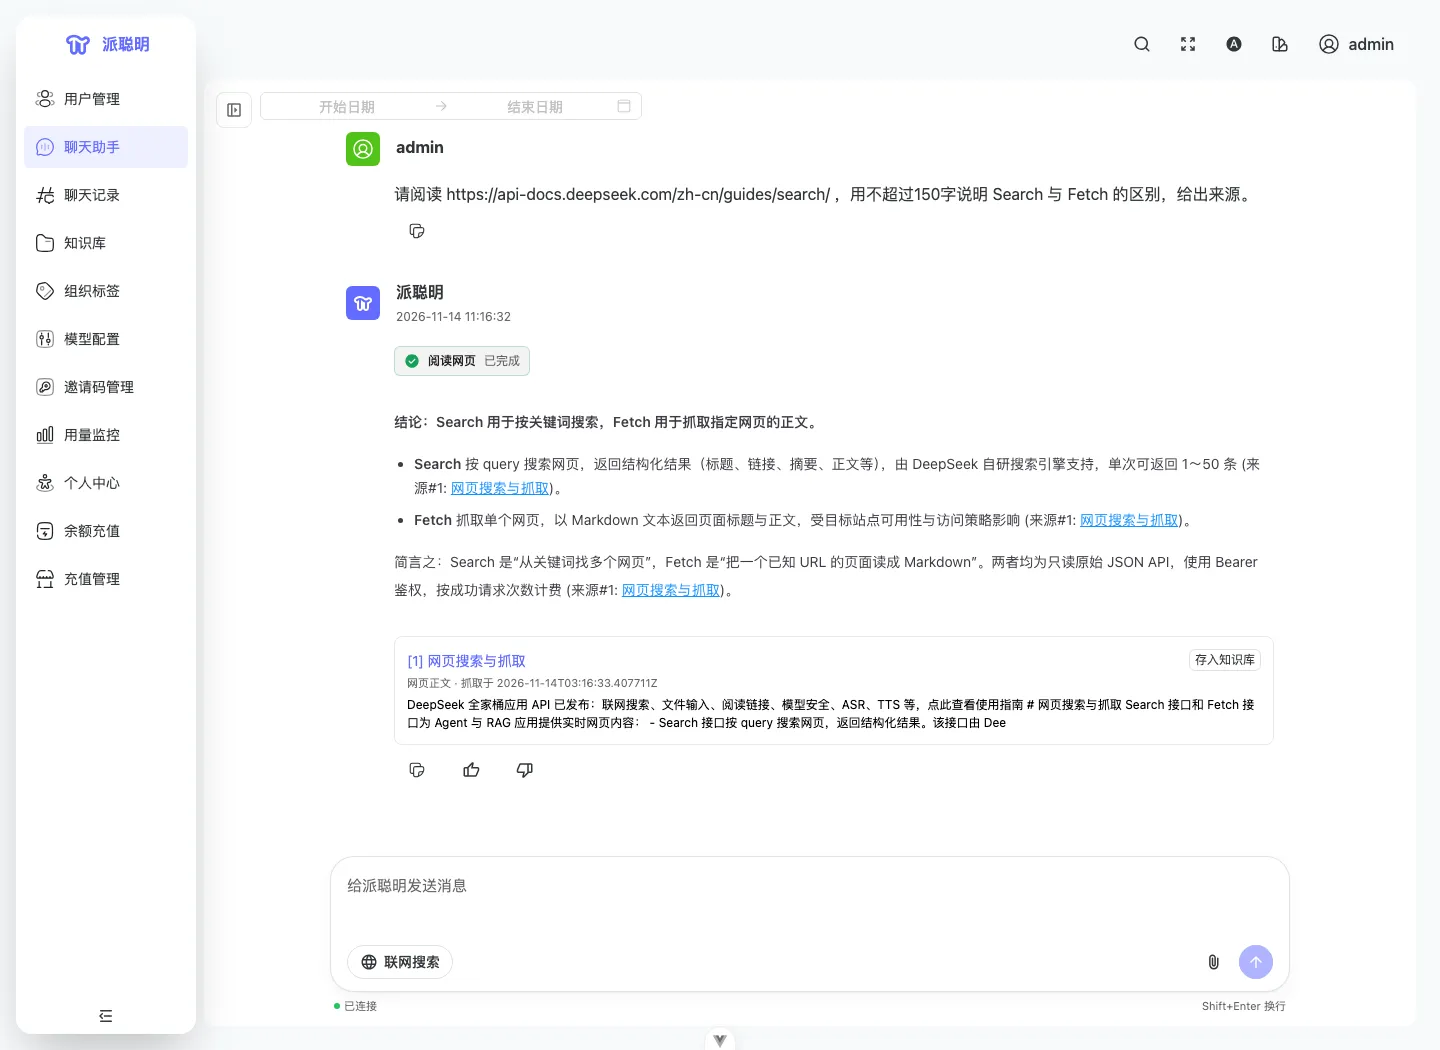
回答下方的来源卡片会显示网页标题、原始链接、抓取时间和引用的原文片段。点击「存入知识库」,保存的是这次抓取到的内容,随后进入原有的上传、解析、向量化流程。
如果来源只是搜索摘要,卡片上会标明“未读正文”;如果正文被截断过,也会标明。存入知识库时,系统不会自动补抓缺失的内容。
接着打开「联网搜索」,让 Agent 自己去找资料:
搜索 DeepSeek 官方文档,说明 Search API 和 Fetch API 分别解决什么问题。
请给出来源,并区分搜索摘要与已经阅读的网页正文。
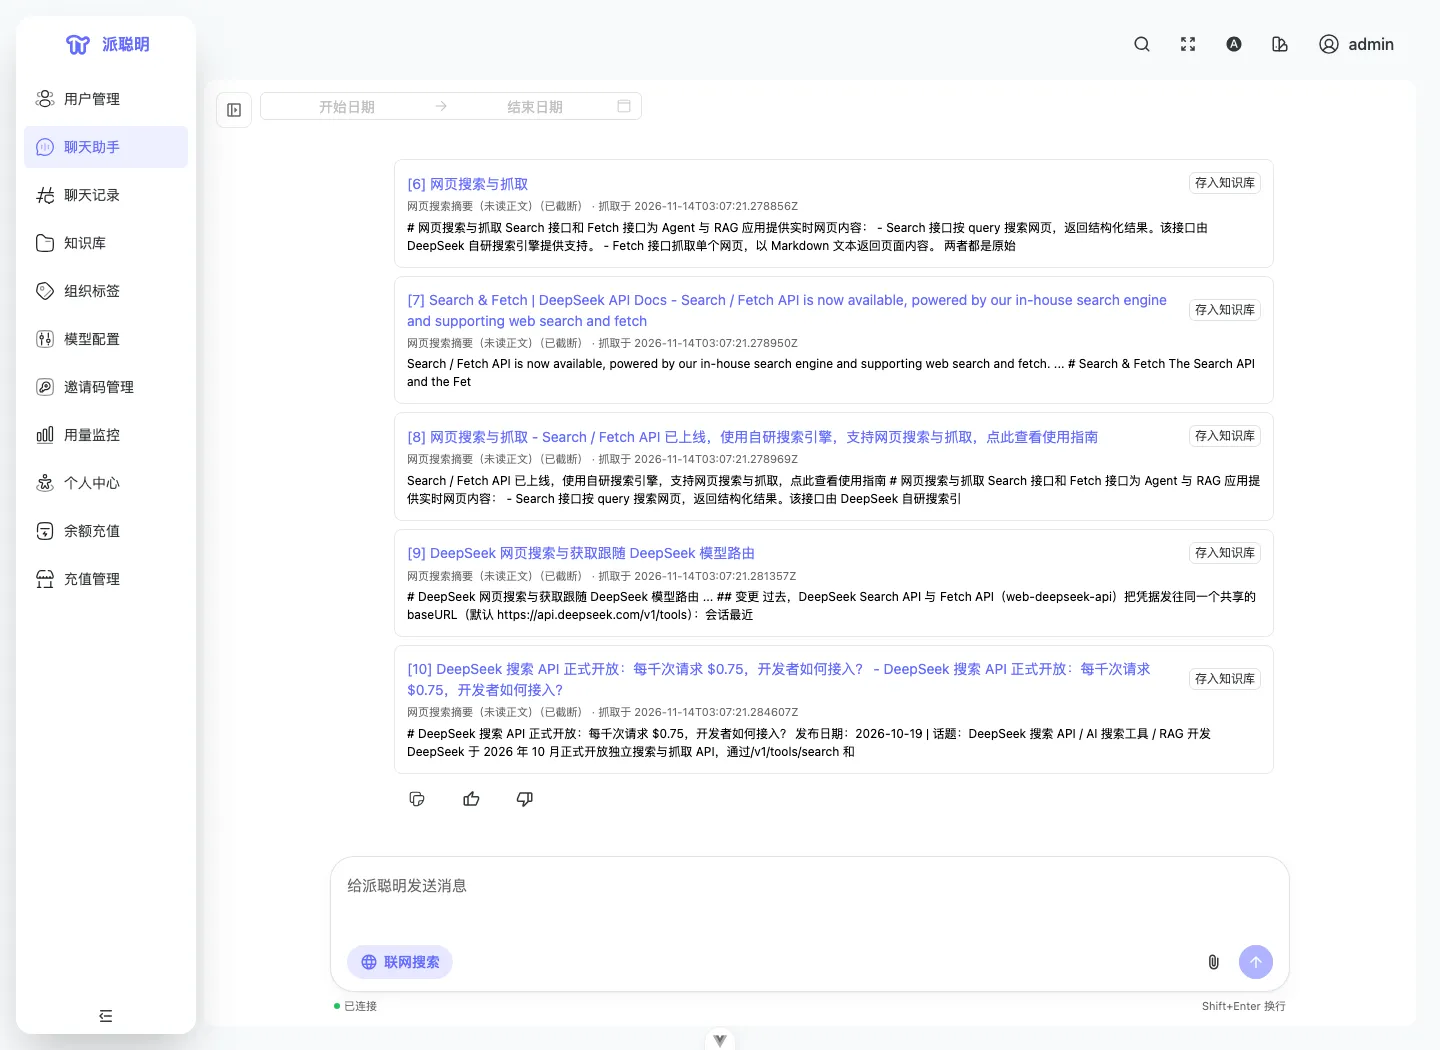
这次返回的来源卡片上标注了“网页搜索摘要(未读正文)”,用户一眼就能看出哪些内容模型只看过摘要。
搜索请求在源码中是这样写的:
return execute(client().post().uri("/v1/tools/search").contentType(MediaType.APPLICATION_JSON)
        .bodyValue(Map.of("query", query, "count", 5, "need_content", false)).retrieve().bodyToMono(JsonNode.class), properties.getTimeoutSeconds());
count 为 5,表示请求 5 条结果;need_content 为 false,表示不返回网页正文。
派聪明先根据摘要判断哪些结果有用,需要细节时再单独阅读具体链接,这样可以避免无关网页占满上下文。
网页和知识库文档使用同一套来源编号,编号和来源的对应关系随回答一起存进 MySQL。刷新页面后,来源卡片依然在,回答里的编号仍然能对应到当时使用的资料。
03、临时附件只在当前会话中使用
有些资料只需要临时分析一下,没必要存进知识库。输入框右下角的回形针按钮就是上传临时附件的入口。
先新建一个 tutorial-attachment.md,填入下面的测试内容。内容只用来验证系统能不能读取附件。
以下数据完全虚构,不代表任何真实服务承诺。

| 级别 | 首次响应时限 | 处理方式 |
| --- | --- | --- |
| P1 | 15 分钟 | 联系值班负责人,立即处理 |
| P2 | 2 小时 | 由负责小组在工作时段处理 |
| P3 | 1 个工作日 | 进入常规排期 |

P1 的升级顺序为值班工程师 → 值班负责人 → 技术负责人。
资料版本为 tutorial-v1,核对口令为 PAI-DEMO-1114。
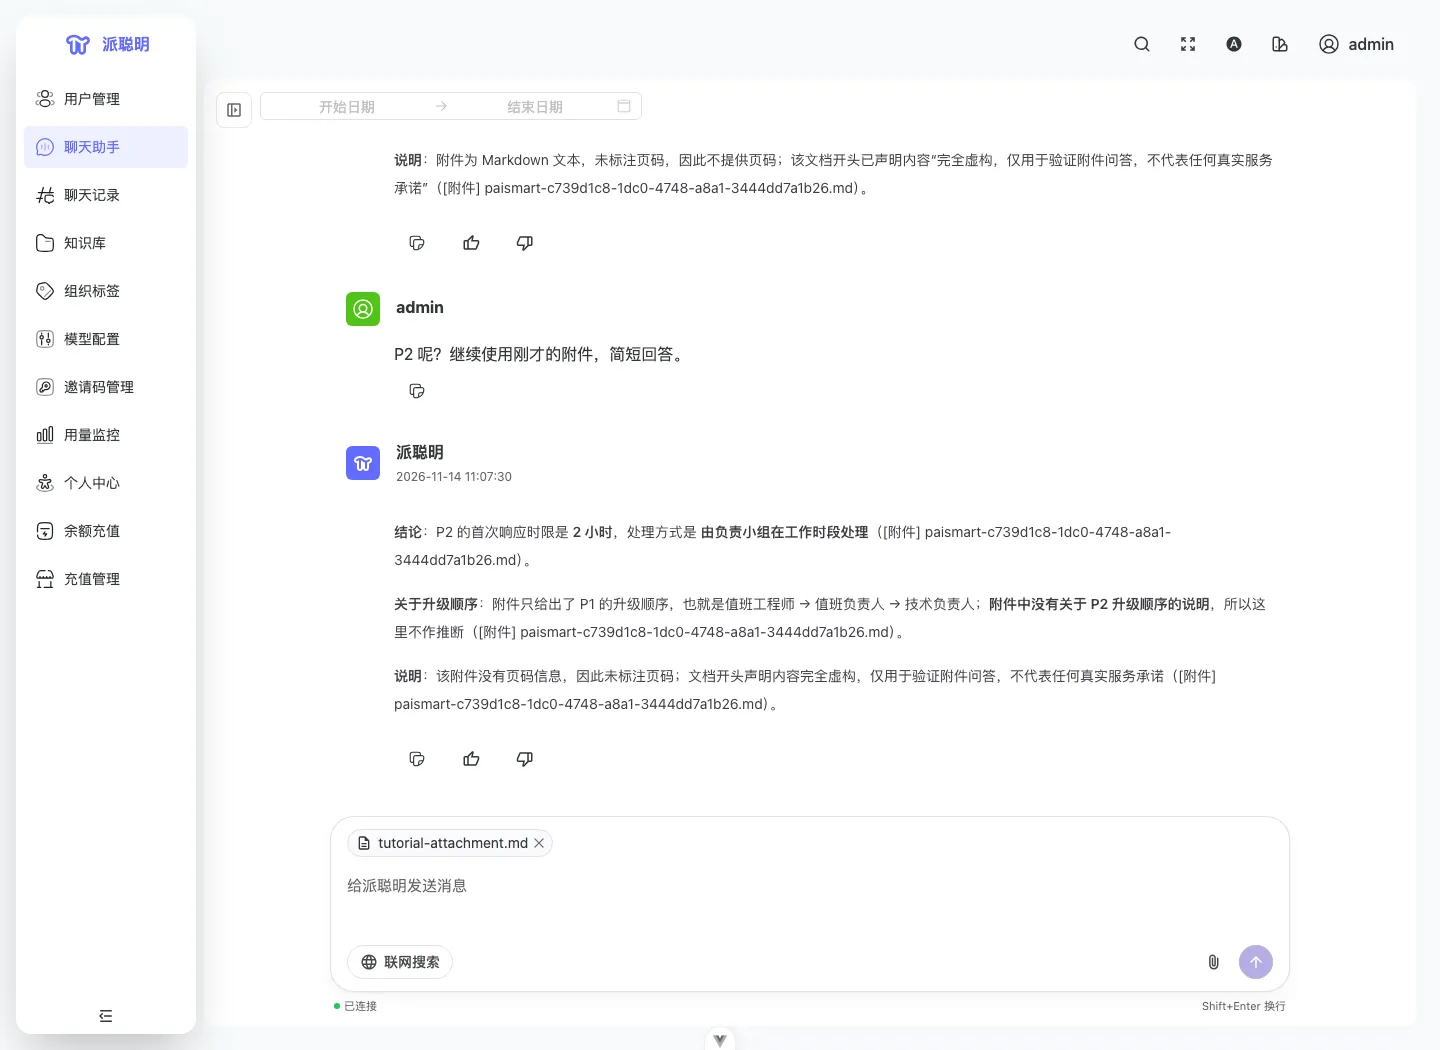
点击「添加文件或图片」,选择这个文件。等文件上传完成后,先输入第一个问题,再接着追问第二个问题:
请根据附件说明 P1 故障的响应时限,并指出依据。
P2 呢?请继续使用刚才的附件。
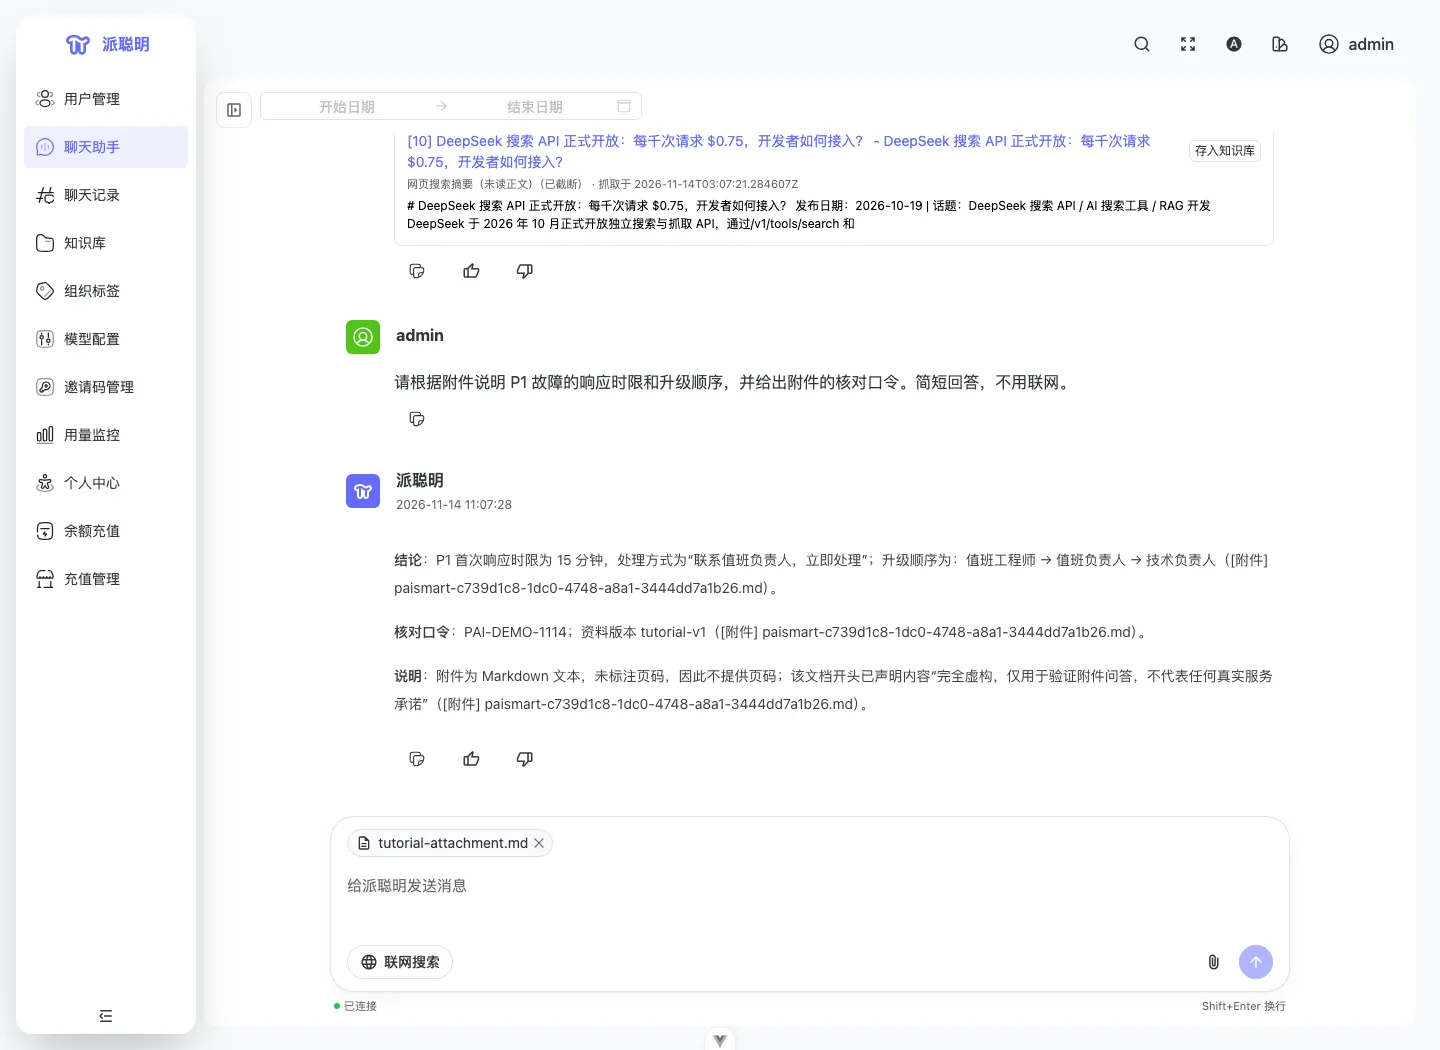
第一个问题,模型答出了 P1 的响应时限是 15 分钟,还读出了文件里的核对口令。
第二个问题,模型继续使用同一个附件,答出 P2 的时限是 2 小时,并指出资料里没有写 P2 的升级顺序。
附件的读取方式按文件类型区分,文本和表格类文件只读取文字;PDF、Office 文档和图片默认开启版面识别,文字和文件里的图片都会交给模型参考。
派聪明默认每个会话最多上传 5 个附件,每个不超过 20 MB,24 小时后失效。这是派聪明自己设定的限制,和 DeepSeek API 允许的上限不是一回事。
前端拿到的只是派聪明本地的附件 ID。服务端每次使用附件前,都会重新检查附件是否属于当前用户和当前会话、是否已经过期,检查通过后才去查对应的 DeepSeek 文件标识。所以,即使有人在请求里填了别人的附件 ID,也拿不到别人的文件。
同一个用户在同一个会话里,如果附件没过期、内容相同、读取方式也相同,系统会直接使用已经上传到 DeepSeek 的文件。后续追问不会再收一次解析费用,但附件内容每次都要发给模型,仍然会消耗对话 Token。
临时附件不会自动存进知识库。如果手动移除附件后再上传同一个文件,系统会把它当作一次新的上传处理。
04、知识库同时保存文字和原图
需要长期检索、多人共用的资料,仍然通过「知识库」上传。临时附件和知识库文档的用途不同,解析流程也是分开实现的。
想自己复现的话,可以下载本文使用的样例图片,再上传到知识库。图片里只有虚构的故障响应规则、颜色标记和箭头。
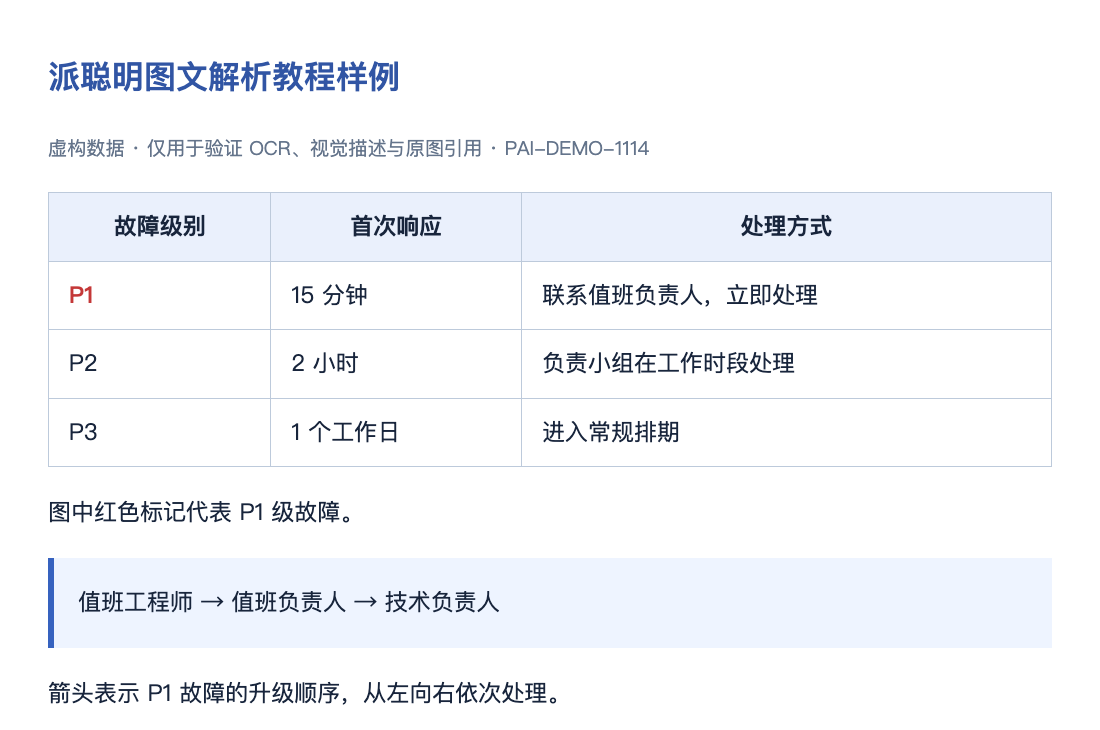
知识库解析把 OCR、图片理解和 Embedding 分成三步:
- OCR 负责提取图片上的文字。
- 视觉模型负责描述图表、颜色、箭头和排版。
- Embedding 负责把解析结果转成向量,供后续检索使用。
为什么要分开?
扫描件上的数字,OCR 能读出来;但箭头连着哪两个步骤、红色区域代表什么,OCR 读不出来,需要视觉模型看图解释。所以解析器把正文、表格和模型生成的图片描述分开保存。
| 文件类型 | 处理方式 |
|---|---|
| 用 LiteParse 按页提取文字,需要时做 OCR;遇到含图片的页面,额外生成页面描述 | |
| 图片 | 提取文字,并生成图片描述 |
| Word、PPT | 先用 LibreOffice 转成 PDF,再按 PDF 处理 |
| Excel | 用 POI 读取单元格内容和公式的计算结果,需要时转换后识别图片 |
| CSV | 正确处理带引号的逗号、换行和转义引号,按表格内容分块 |
表格被拆到多个分块时,每个分块都会带上表头,并尽量不把一行数据拆开。合并单元格较复杂的表格、模糊图片和扫描表格,仍然需要对照原文件核实,模型生成的描述不能当作原文的逐字记录。
检索命中图片描述时,派聪明还会把对应的原图发给模型,让模型对照原图核实。默认每次回答最多发送 3 张原图,同一张图在一次回答中只发送一次。没有实际发送给模型的图片,不能说模型已经核对过。
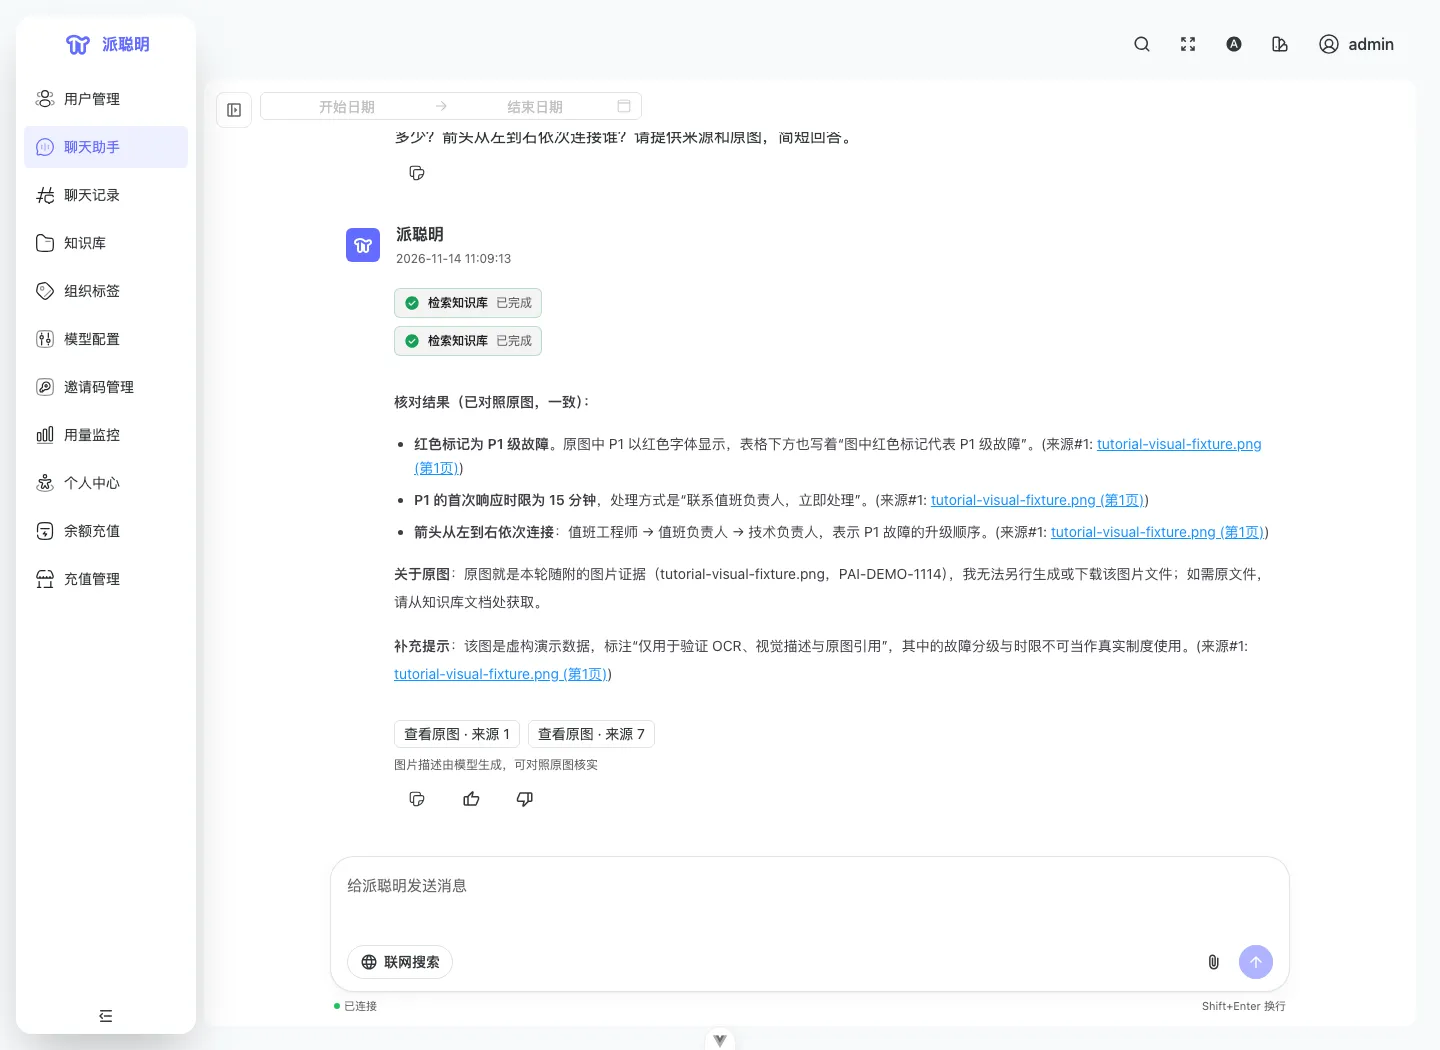
这次检索到样例图后,回答准确说出了红色的 P1 标记、15 分钟的响应时限,以及从左到右的升级顺序。
点击来源下方的「查看原图」,可以打开这次用来核实的图片。
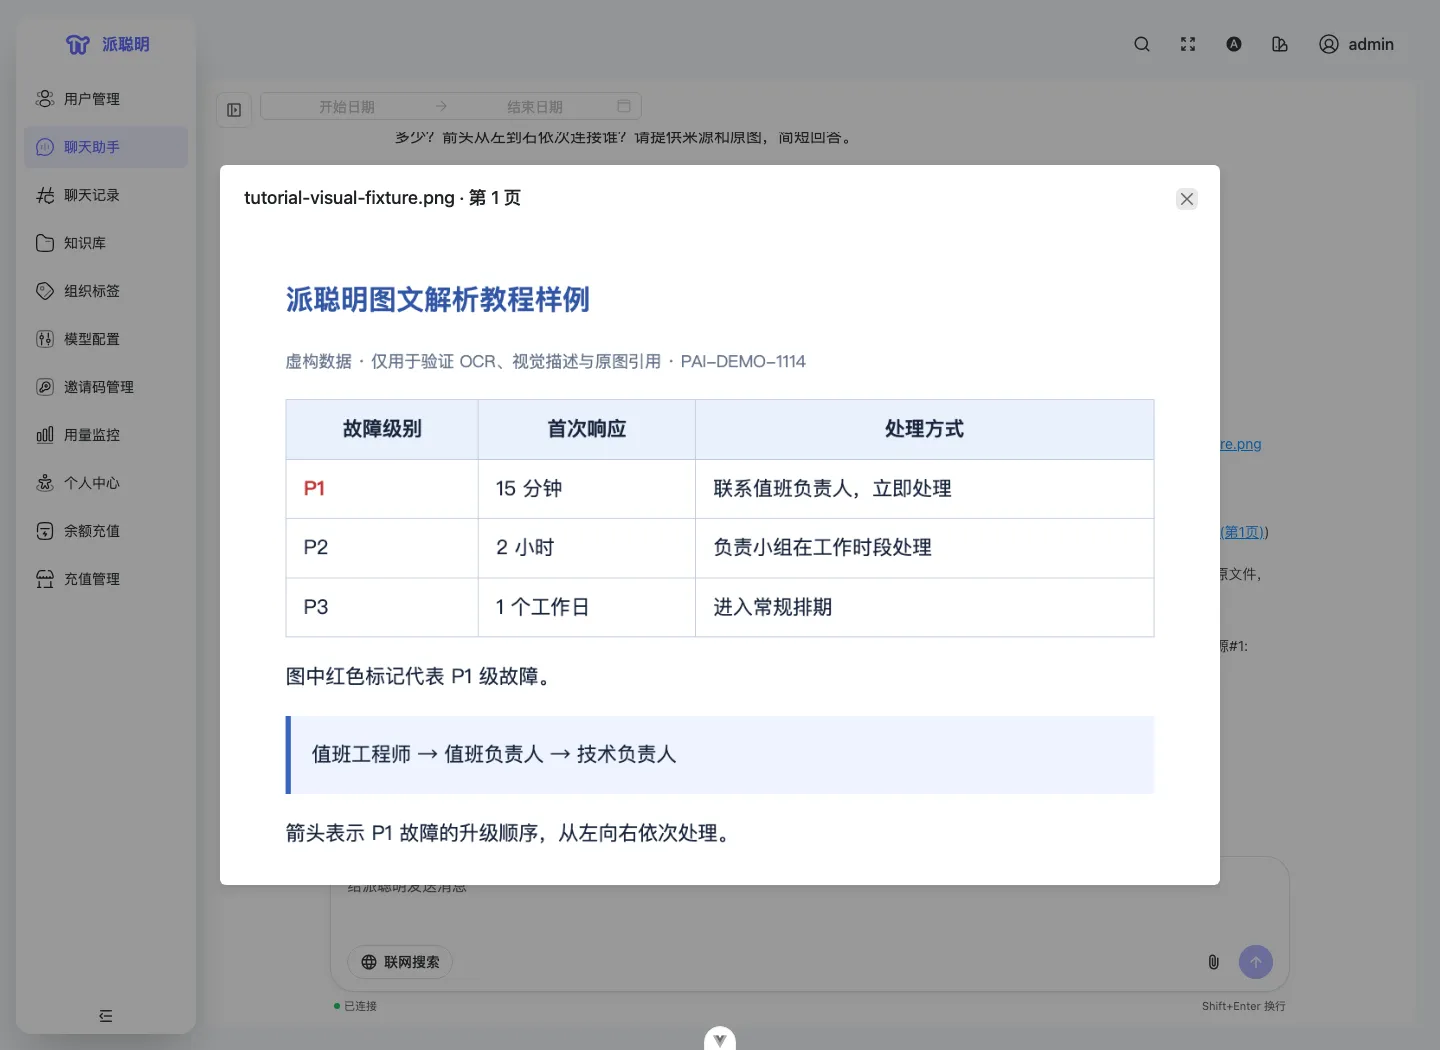
「查看原图」通过需要登录的后端接口读取图片。每次打开都会重新检查文件是否还在、用户是否仍有权限,所以对象存储桶必须设为私有。权限被收回或文件被删除后,旧会话里的「查看原图」也就打不开了。
解析结果必须完整。只要有一页 OCR 失败,即使外部解析程序报告成功,派聪明也会把整份文件标记为解析失败,避免缺页的资料被当成完整资料存进知识库。
05、文档更新时复用已经算过的结果
资料修改后,可以在知识库里点「更新版本」,并选择要替换的旧文件。普通上传始终会新建一份文档,系统不会因为文件名相同就覆盖原有资料。
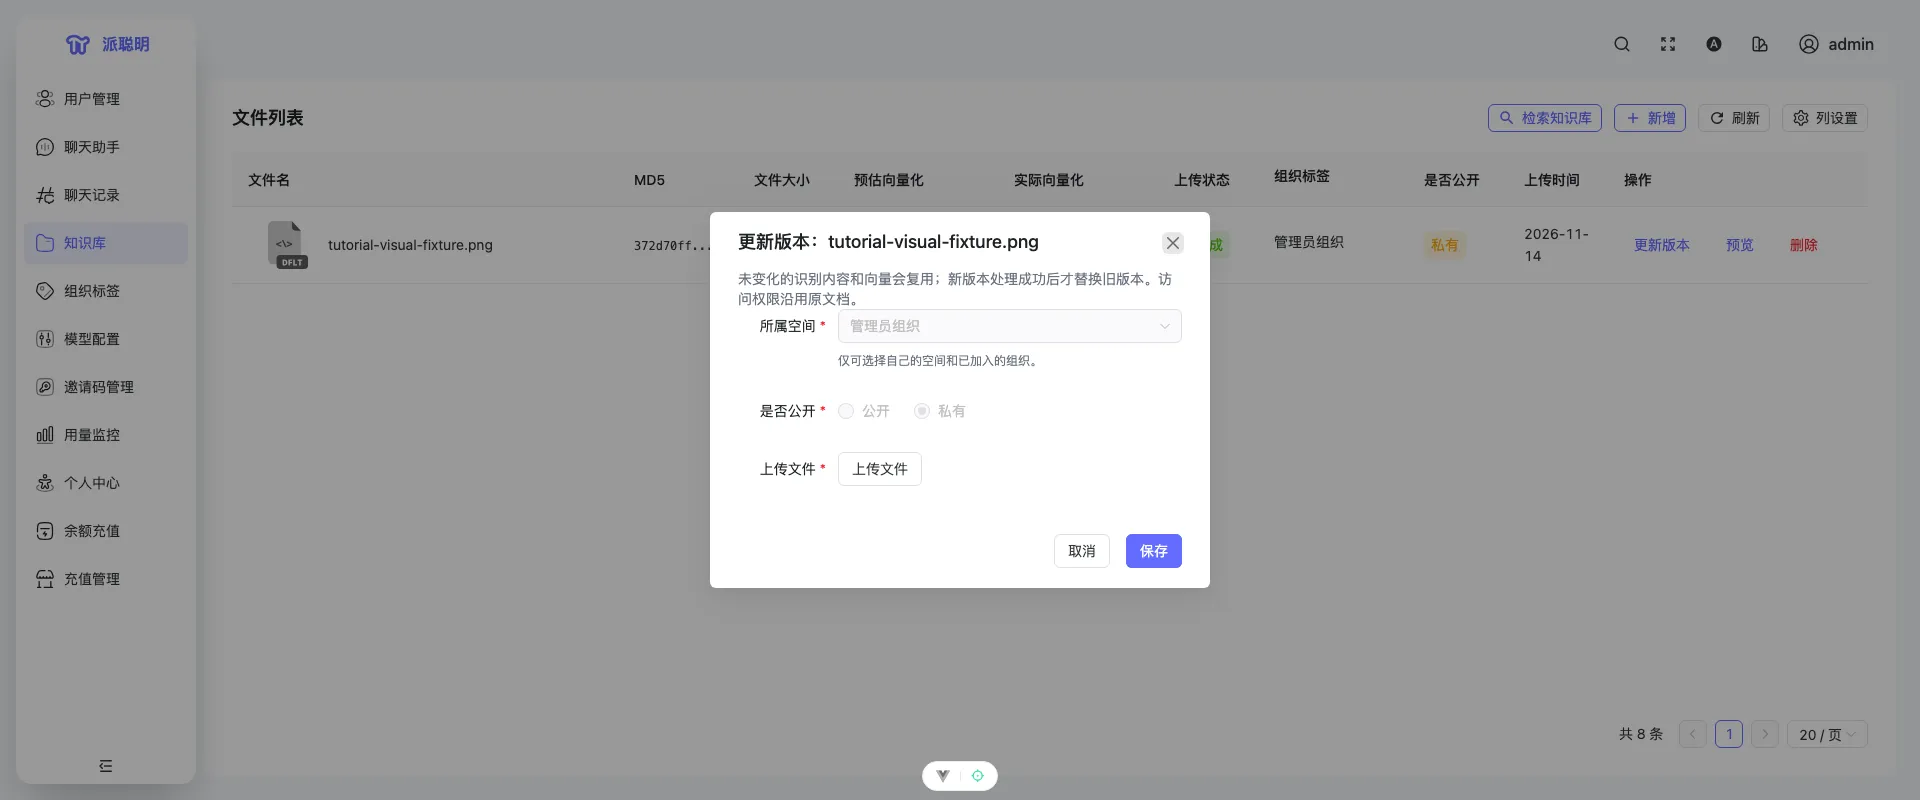
截图里,组织空间和公开状态两项无法修改,因为新版本必须沿用旧版本的设置。这次只打开了更新界面,没有真正提交第二个版本,下面的发布和复用机制是根据源码整理的。
新版本沿用旧版本的访问权限,并且只有上传者本人能更新自己的文件。
新版本解析完成、建好索引之后,系统才会正式启用它,同时把旧版本标记为已替换。如果中途处理失败,旧版本仍然可以正常检索。
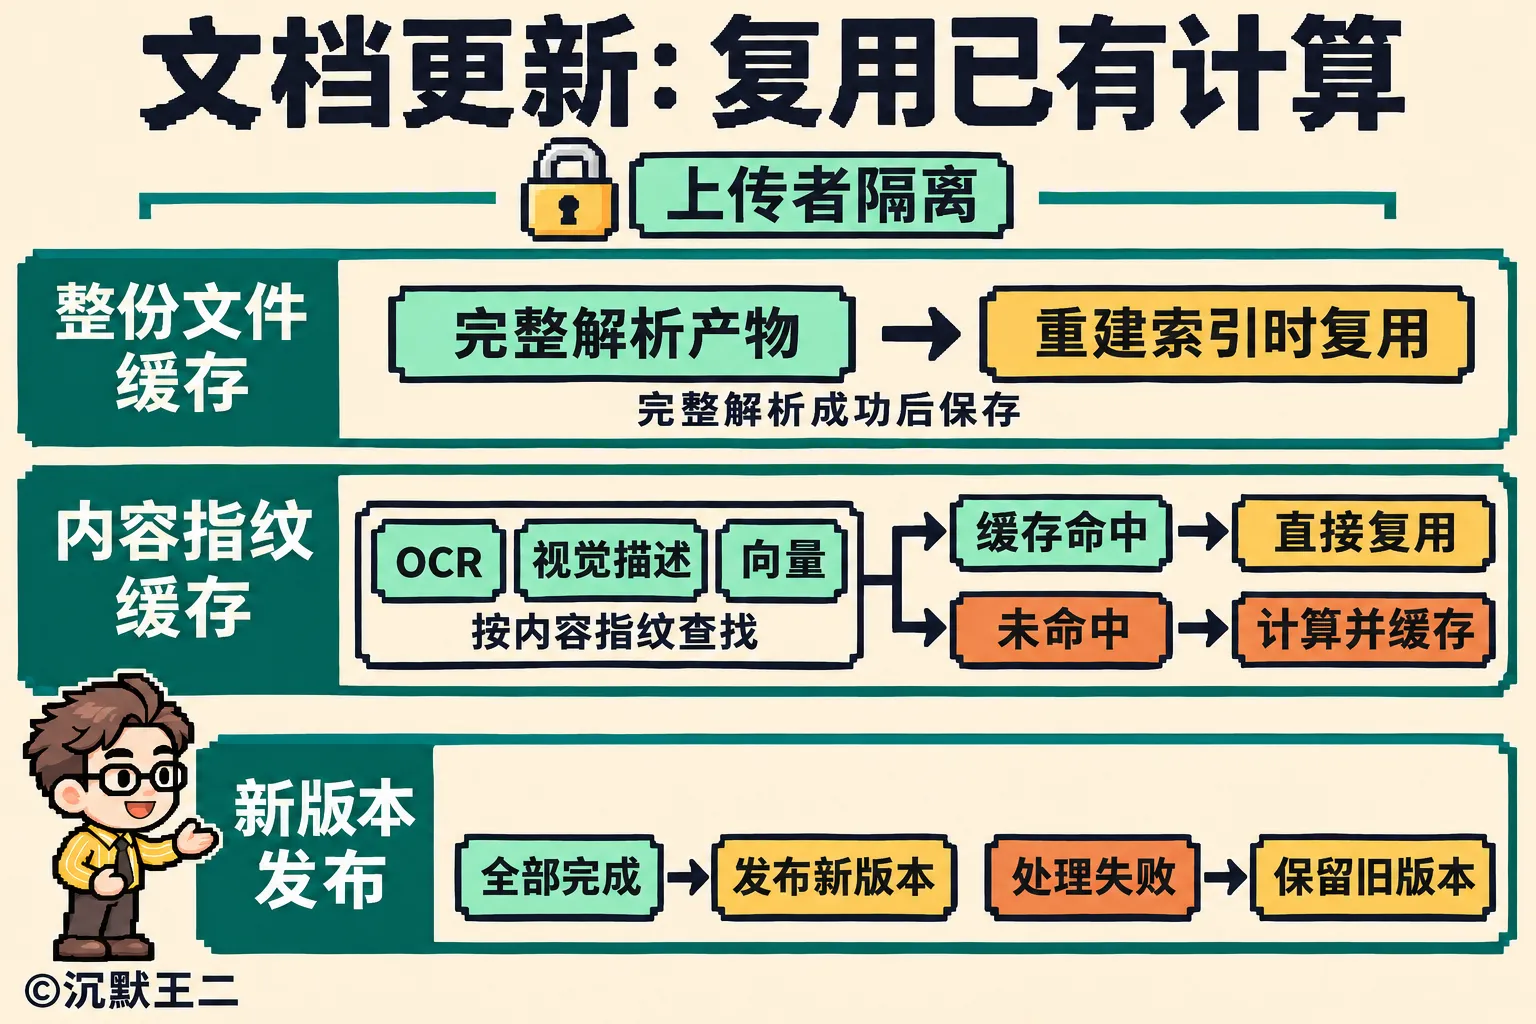
为了避免重复计算,系统保存了两类缓存。
第一类缓存保存整份文件的解析结果,缓存路径包含上传者、文件标识、解析版本、模型名称和文件的 SHA-256 值。只有整份文件全部解析成功,才会写入缓存,以后重建索引时可以直接使用。
第二类缓存按输入内容的哈希值保存 OCR 结果、图片描述和向量。新版本里如果有和旧版本相同的页面或文本,就直接使用缓存结果,只把新增或改动的部分交给模型计算。
向量缓存还记录了服务地址、模型名称和向量维度,防止换了模型以后还用旧模型算出的向量。另外,如果开启了上下文检索,每个分块在向量化时会带上前后文。这时即使某个分块本身没改,前后文变了,也要重新计算向量。
需要说明的是,系统仍然会完整读取新文件、识别格式、为新版本生成索引信息。能复用的只是“输入完全相同”的那部分计算结果,并不是只比较 PDF 或 Office 文件改动了哪些字节。
旧版本的原文件和原图都会保留,历史回答中的引用仍然可以打开。删除当前版本时,系统会按版本关系一并清理历史文件,同时释放对共享缓存的引用。
06、在执行流程中加入审核和计费
API 接好之后,还有三个问题要处理:回答什么时候可以显示给用户,调用失败后要不要重试,费用应该扣几次。
派聪明的在线增强问答默认开启 DeepSeek 的高等级内容安全审核。服务端以流式方式接收模型输出时,先把这一轮的文字暂存在内存里,等收到模型发来的结束状态,确认审核通过后,再把文字发给前端。
如果结束状态显示内容被安全审核拦截,页面就显示拒绝回答。如果连接中断,或者没有收到有效的结束状态,没审核过的文字也不会发给前端。工具的执行进度仍然实时显示,所以用户能看到工具正在运行,只是回答文字会在每一轮结束后才整段出现。
费用方面,搜索、抓取、附件解析、OCR 和图片理解分别记账。Embedding 继续从 Embedding 余额中扣除,其余几项按实际 API 成本换算成 Token,从 LLM 余额中扣除。
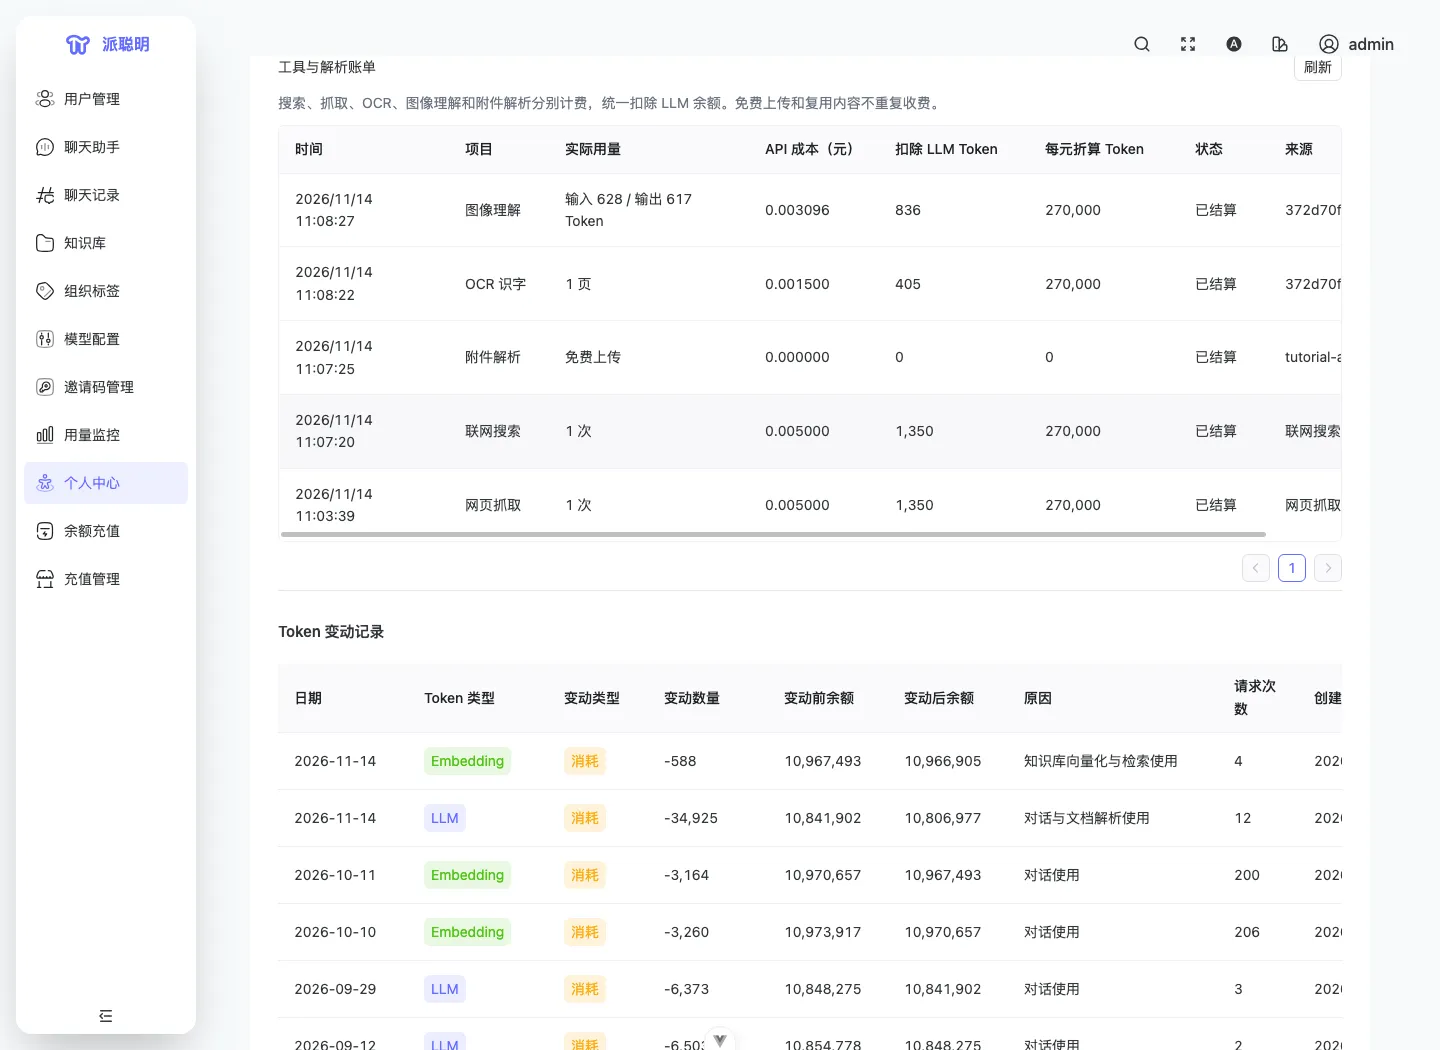
根据 2026 年 11 月 14 日查到的 DeepSeek 价格,搜索和抓取都是每千次 5 元,OCR 和文件解析是每千页 1.5 元。图片理解按 Token 计价,输入、命中缓存的输入和输出分别定价。派聪明在每条账单里保存当时的价格,以后价格调整,已有的账单不会跟着变。
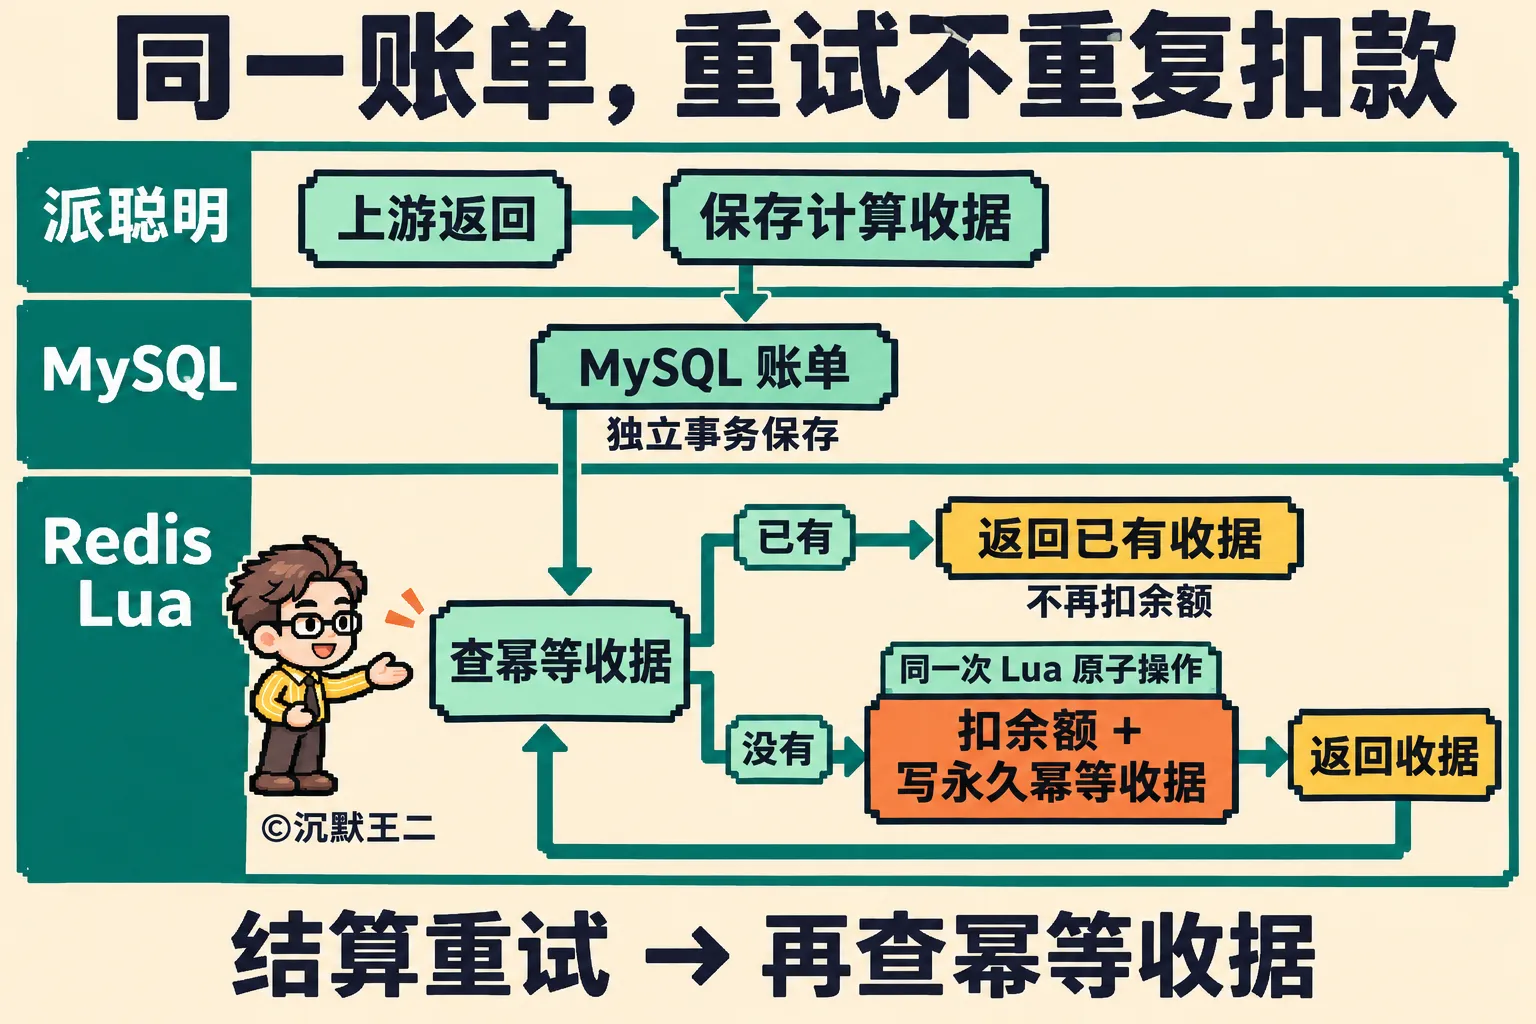
为了保证同一笔费用只扣一次,结算同时用到了 MySQL 和 Redis。DeepSeek 返回结果后,系统先保存一条计算记录,再用单独的事务保存账单,最后通过 Redis Lua 脚本扣减余额,同时写入一条永久保存的扣费收据。
local saved=redis.call('GET',KEYS[2])
if saved then return saved end
local before=tonumber(redis.call('GET',KEYS[1]) or '0')
local after=redis.call('DECRBY',KEYS[1],ARGV[1])
local receipt=tostring(before)..':'..tostring(after)
redis.call('SET',KEYS[2],receipt)
脚本里,KEYS[1] 是用户余额,KEYS[2] 是这笔账单的扣费收据。
Redis 执行 Lua 脚本时不会被其他命令打断,所以查收据、扣余额、写收据这三步要么全部完成,要么都不执行。
重新结算同一笔账单时,脚本先查收据:已经有收据,说明扣过了,直接返回,不会再扣一次。命中缓存时不会调用 DeepSeek,也不会产生新账单;但如果之前有已经产生、还没结算的费用,这时仍会补上结算。
这次实测的账单里,网页抓取和联网搜索各有一条 0.005 元的已结算记录,Markdown 附件有一条 0 元的上传记录。用同一个附件连续追问,没有产生新的解析账单。
最麻烦的情况是,DeepSeek 已经处理了请求,派聪明却没收到结果。
对于临时附件,系统会用上传时生成的唯一文件名去 DeepSeek 查询,找回结果。对于无法确认结果的调用,账单会标记为“待核对”,需要和 DeepSeek 对账。另外,文档入库失败时,OCR 或图片理解可能已经真实产生了费用,所以入库失败并不代表没有花钱。
07、对照结果验收
先运行这次新增能力对应的测试:
mvn -q -Dtest=DeepSeekAppsSafetyTest,DeepSeekOcrCallbackTest,ChatAttachmentServiceTest,AppToolBillingServiceTest test
这组测试共 10 项,全部通过,覆盖了审核拒绝与放行、OCR 失败、附件权限、工具账单的复用和补结算。
测试中用模拟对象代替了真实的 DeepSeek 接口,所以接口能不能真正调通,还要在浏览器里实际操作确认。
复现时,建议按下面的顺序逐项检查:
- 贴一个已知链接,确认回答下方有来源卡片,并且刷新页面后还在。
- 开启联网搜索,确认工具确实执行了,并且来源卡片区分了搜索摘要和已读正文。
- 上传临时附件并连续追问,确认附件只在当前会话中可用,回答引用的是自己上传的文件。
- 往知识库上传带文字和图表的资料,解析完成后检索,检查图片来源和「查看原图」的权限。
- 打开个人中心的账单,核对实际用量、换算比例和结算状态。工具有没有收费,要看账单,不能只看回答内容。
这次实际跑通了网页抓取、联网搜索、附件连续追问、图片入库和查看原图,也在个人中心核对了对应的账单。
09、派聪明如何写到简历上
项目名称 派聪明企业知识库
项目简介 面向企业资料检索与分析,支持文档入库、混合检索、网页阅读、临时附件问答和带来源的回答。接入 DeepSeek 全家桶 API,由后端统一管理解析结果、文档版本和实际费用。
技术栈 Java 17、Spring Boot、Vue 3、MySQL、Redis、Elasticsearch、Kafka、S3 兼容对象存储、DeepSeek API。
- 基于 Spring WebFlux 接入 DeepSeek 搜索与网页抓取,通过工具调用让 Agent 获取外部资料,搜索默认请求 5 条结果并保留来源信息。
- 基于 DeepSeek Files API 实现会话附件管理,按用户、会话和有效期校验访问权限,默认每个会话最多 5 个附件、有效期 24 个小时。
- 基于 LiteParse、PDFBox 与视觉模型实现图文资料解析,分别保存正文和图片描述,单次回答默认最多发送 3 张原图供模型核实。
- 基于 SHA-256 与对象存储复用 OCR、图片描述和向量计算结果,按上传者隔离缓存,新版本处理完成后再替换旧版本。
- 基于 MySQL 独立事务与 Redis Lua 脚本实现扣费结算,用永久保存的扣费收据防止同一账单重复扣款,并编写工具账单和附件恢复的单元测试。
未能定位到原文的划线
真诚点赞 诚不我欺
回复