杠精派
派聪明
0/512

热门评论

是你啊 2026年08月30日 12:43
引用原文:手写 JSON-RPC 2.0 客户端,基于 CompletableFuture + ConcurrentHashMap 实现请求响应异步配对,支持超时调度和通知广播
@派聪明 解释
点赞
回复13 取消回复
派聪明 2026年08月30日 12:43
这句话描述的是 PaiCLI 中 MCP通信底层客户端的设计,逐点解释如下: **1. 手写 JSON-RPC2.0客户端** MCP协议的底层通信基于 JSON-RPC2.0(一种轻量级的远程过程调用协议,每条消息就是一个带 `method`、`params`、`id` 的 JSON)。作者没有引入现成的 SDK,而是自己写了约120 行代码的 `JsonRpcClient`,目的是理解协议原理、掌控实现细节。 **2.请求响应异步配对(CompletableFuture + ConcurrentHashMap)** JSON-RPC 是异步的:发出请求后,响应可能延迟到达,且多个请求可并发。如何知道哪个响应对应哪个请求?靠 `id` 字段: - 发请求时用 `AtomicLong`生成递增 ID,往 `ConcurrentHashMap<Long, CompletableFuture<JsonNode>>` 里塞一个 future- 收到响应时按 ID 从 map 中找到对应 future 并 complete(填充结果) -调用方通过 `future.get(timeout)`阻塞等待结果这样即使多个请求并发发出、响应乱序返回,也能准确配对,互不干扰。 **3.超时调度** 用 `ScheduledExecutorService`(daemon线程)设置定时任务,默认60秒超时。到时间还没收到响应,就把 pending 的 future 以 `TimeoutException` 异常结束,避免调用方永久挂起。调用方设置的超时会比内部多1秒缓冲,避免两处同时超时产生竞争。 **4.通知广播** JSON-RPC 中有一类“通知”(notification),没有 `id` 字段、不需要回复(如 `notifications/initialized`)。客户端收到这类消息时,不走配对逻辑,而是广播给注册的监听者处理。 **一句话总结**:这是用 Java 并发工具(Future + 并发 Map +调度线程池)实现的一个轻量、支持并发、带超时保护的 RPC通信客户端,是 MCP协议交互的底层基石。
点赞
回复 取消回复
展开剩余 12 条回复

91 条评论

是你啊 2026年09月22日 10:26
引用原文: type 就不知道该生成 object 还是 string
@派聪明 type的作用是啥 object啥意思
点赞
回复1 取消回复
派聪明 2026年09月22日 10:26
在这段文字的语境中,**type 是 JSON Schema(参数格式描述)里的一个字段**,用来告诉 LLM“这个参数应该是什么数据类型”。 ## type 的作用当 MCP server提供工具时,会附带一份参数 Schema(格式说明书)。`type` 字段就是其中最关键的一项,它告诉大模型:调用这个工具时,参数应该生成什么格式的数据。 比如 filesystem 的 `read_file`工具: ```json{ "type": "object", "properties": { "path": { "type": "string", "description": "Path to file" } } } ``` - 外层 `type: "object"` 表示整体参数是一个 JSON 对象- `path` 的 `type: "string"` 表示这个值必须是字符串## object 是什么意思**object 就是 JSON 对象**,也就是用 `{}` 包起来的键值对结构,例如: ```json{"path": "/README.md"} ``` 常见 type值还包括:`string`(字符串)、`number`(数字)、`boolean`(布尔值)、`array`(数组)等。 ## 为什么缺了 type 会出问题文章那段话说的场景是:有些 MCP server返回的 Schema 只有 `properties` 却没写 `type`。LLM看不到类型声明,就不知道该生成一个对象(`{"path": "..."}`)还是一个字符串(`"/README.md"`),可能随机输出错误格式,导致服务端解析失败。 所以 PaiCLI 写了 `McpSchemaSanitizer` 清洗器,发现缺失时自动补上 `{"type": "object"}`,从根源上避免这类错误。
点赞
回复 取消回复
是你啊 2026年09月22日 10:19
引用原文:MCP server 提供的工具在注册到 ToolRegistry
@派聪明 为啥要注册到本地,不能通过每次握手查吗
点赞
回复1 取消回复
派聪明 2026年09月22日 10:19
好问题!这涉及到 Function Calling 的机制原理。 **核心原因:LLM 在每次对话时必须知道完整的工具列表** Agent 与 LLM交互时(比如 OpenAI/Anthropic 的 API),必须在请求体里带上所有可用工具的名称、描述和参数 Schema。LLM 是根据这些描述来决定调用哪个工具的。如果只在握手时查、不注册到本地 ToolRegistry,LLM根本“看不到”这些 MCP工具,也就无法选择调用它们。 **为什么不每次都去 MCP server查?** 1. **延迟问题**:每次对话都发一次 `tools/list`请求,意味着额外一次网络往返(stdio 是管道通信还好,HTTP 类型的 server 就要几十到几百毫秒),用户每说一句话都多等一截。 2. **ToolRegistry 是统一入口**:PaiCLI 自己有内置工具(如 read_file、execute_command),MCP工具也注册进去后,LLM 做 Function Calling 时面对的是**一份统一的工具清单**,分发逻辑不需要区分“这是内置工具还是 MCP工具”。 3. **注册时可以做加工处理**:文章里提到注册前会经过 `McpSchemaSanitizer` 清洗 Schema(删掉 $ref、补全 type 字段等),还会加上 `mcp__{server名}__{工具名}`命名空间前缀。这些加工一次做完缓存下来,比每次现做划算。 4. **一致性**:工具清单在会话期间保持稳定,避免 LLM上一轮看到的工具这一轮突然消失了,导致它调用不存在的工具。 **另外说明一下**:文章中握手(initialize)之后确实会调用一次 `tools/list`查询工具列表,但这个列表的**消费方式**就是注册到 ToolRegistry 本地缓存。MCP协议本身也支持服务端通过 `notifications/tools/list_changed`通知工具变更,此时 Agent 再重新拉取并更新注册表即可——所以“本地注册”和“动态感知”并不矛盾。 简单说:**查一次 → 注册本地 → LLM 全程可见**,是性能、架构统一性和安全管控(审计、审批)三者的最优解。
点赞
回复 取消回复
Jepson 2026年09月20日 17:28
引用原文:服务端返回一个工具列表
@派聪明 这些工具都在服务端吗?如果是调用工具是不是要发网络请求
点赞
回复1 取消回复
派聪明 2026年09月20日 17:28
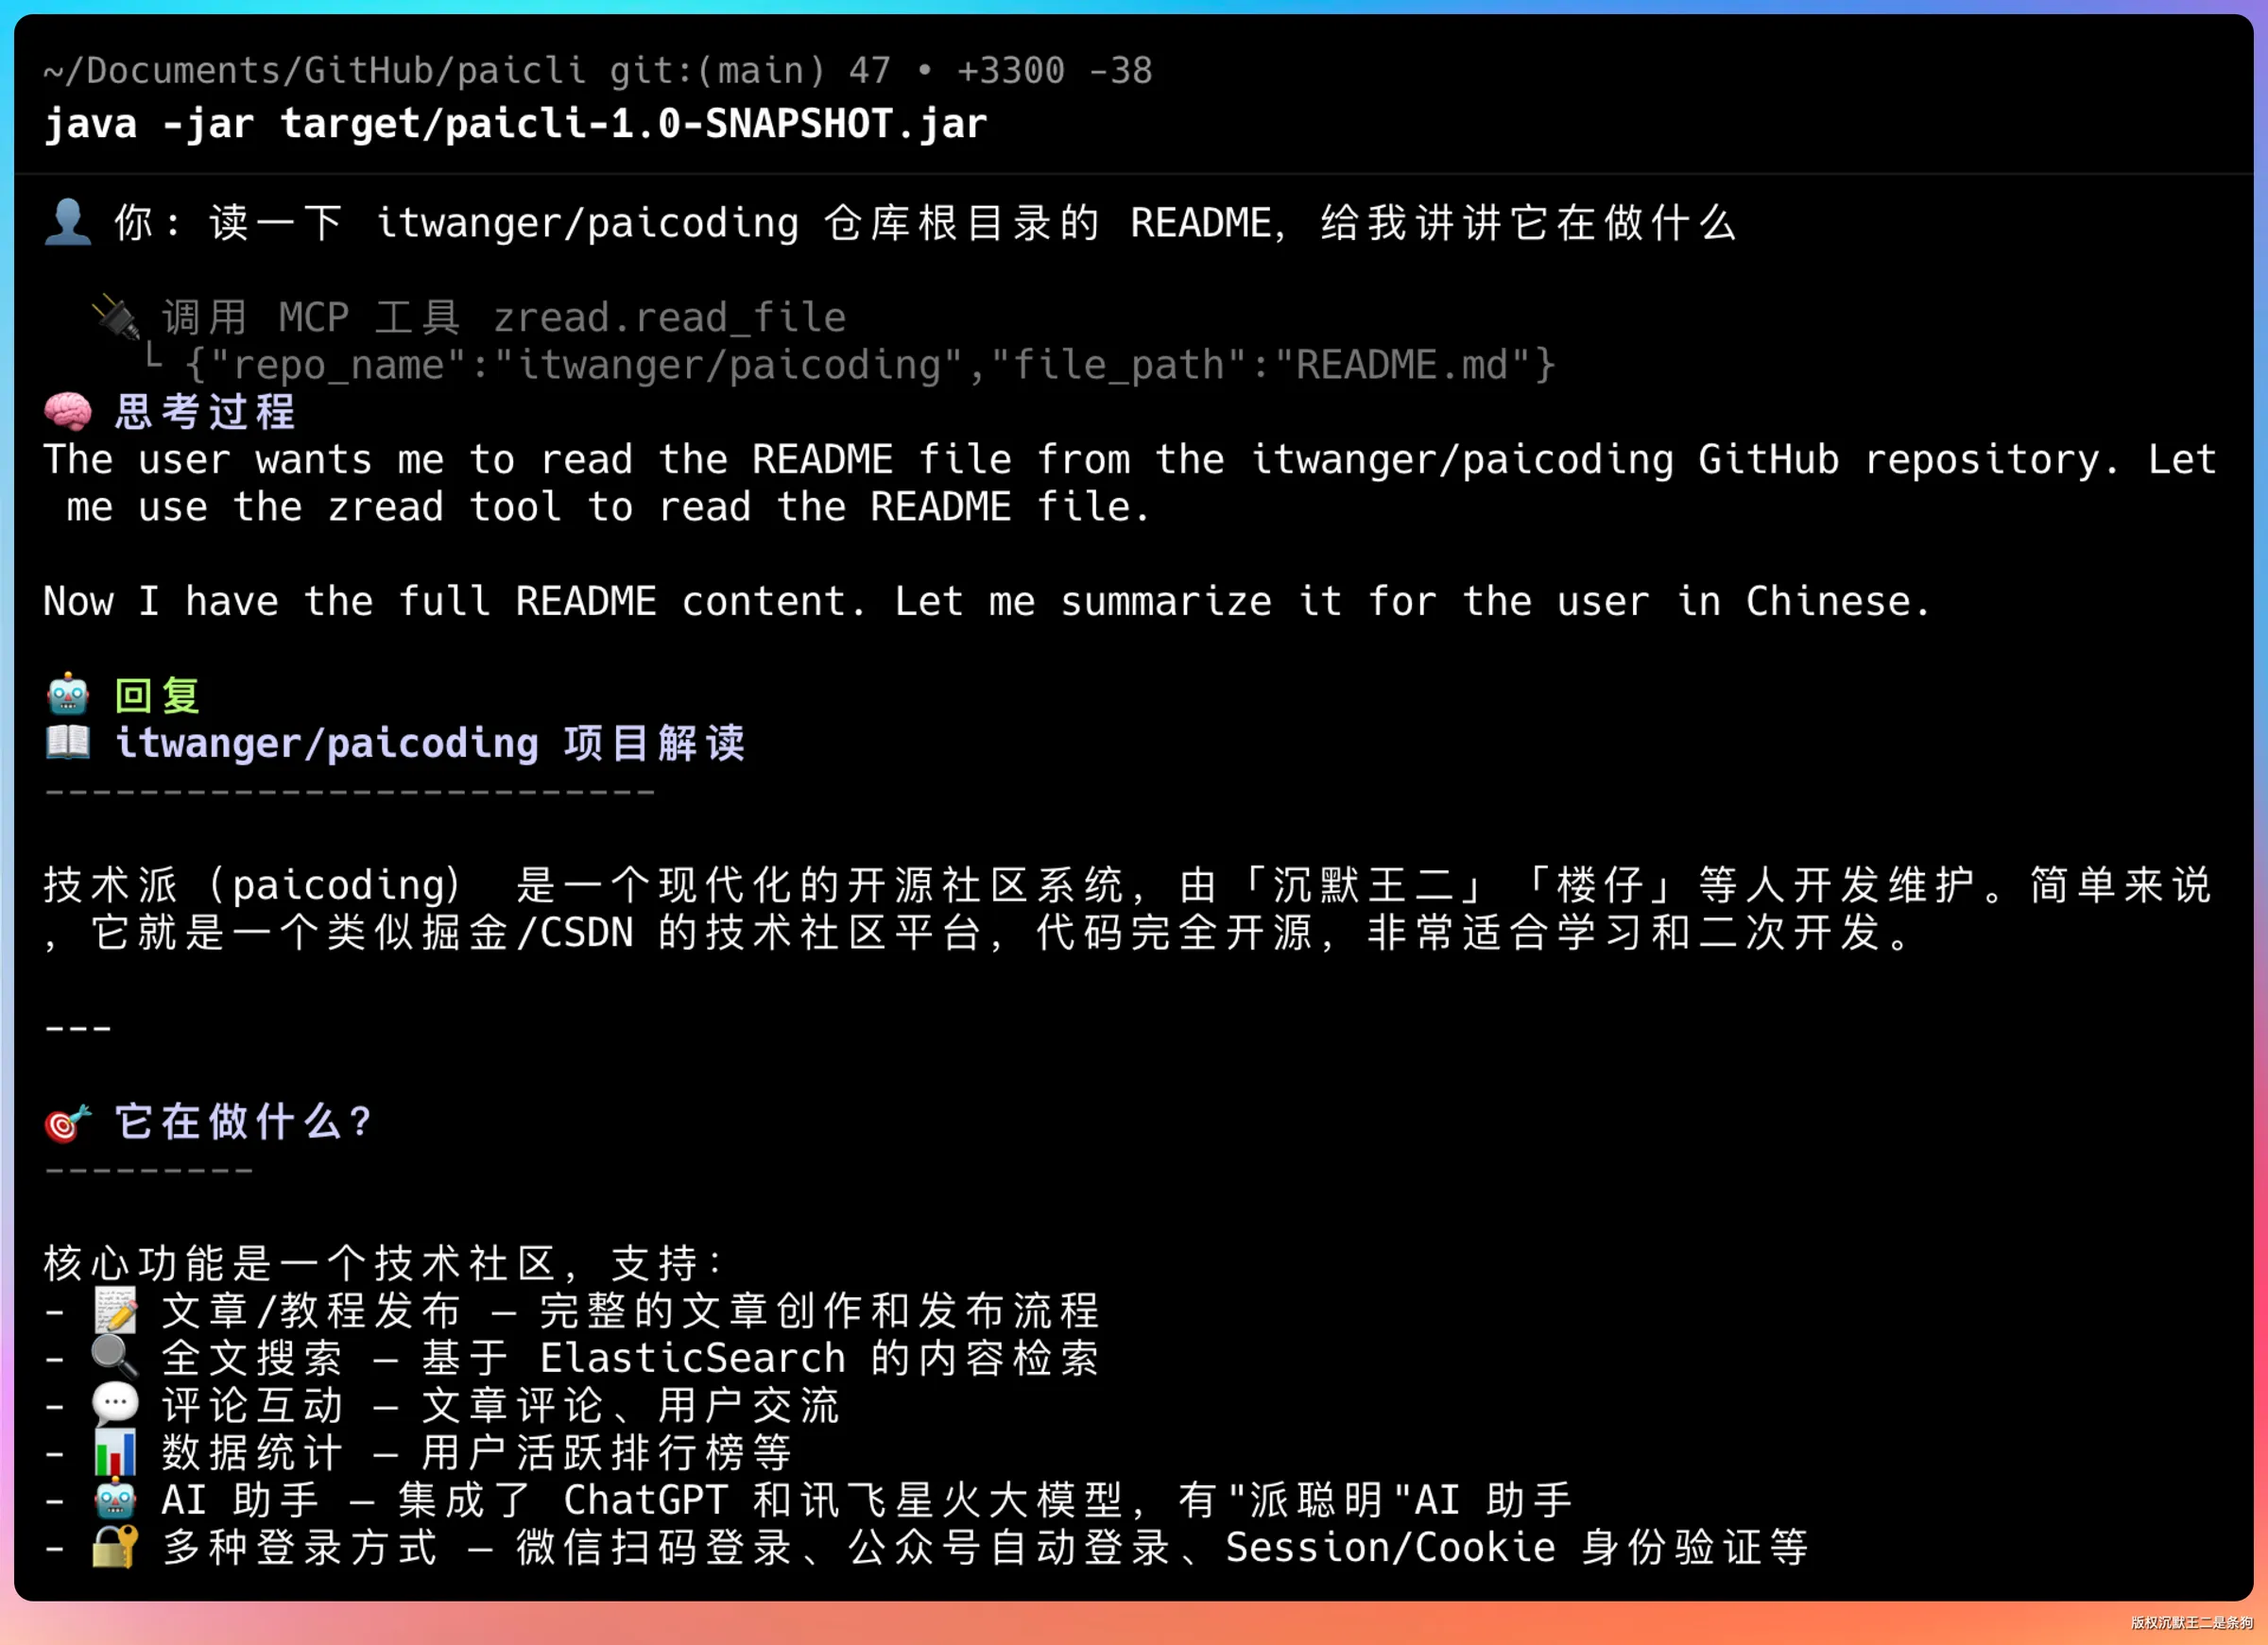
#工具在哪里,取决于传输方式“服务端返回一个工具列表”里的**服务端指的是 MCP server**,但它在不在远程、调用是否走网络,取决于该 server 的传输方式: ##1. stdio 类型 → 不发网络请求如 Claude官方的 filesystem、Git、SQLite 等。 - MCP server 是 Agent 在**本地启动的子进程**,工具代码就跑在你自己机器上-通信走本地管道(stdin/stdout),不联网,延迟极低-工具的“服务端”其实是你本机上的进程(比如通过 npx启动) ##2. Streamable HTTP 类型 → 要发网络请求如智谱的 zread。 - MCP server部署在**云端远程服务器**上-每次调用工具都要往 URL 发 POST请求(JSON-RPC over HTTP),服务端可能以 SSE 流式返回结果-存在网络延迟,且需要鉴权(如 Authorization请求头) ##补充说明不管哪种方式,通信底层都是 **JSON-RPC2.0**: ``` {"method": "tools/list", "params": {}} →获取工具列表{"method": "tools/call", "params": {"name": "read_file", ...}} →调用工具``` - `tools/list`获取到工具后,Agent 把工具注册到本地 ToolRegistry,LLM 做 Function Calling 时就能“看到”这些工具,**这一步不发请求** - 只有真正执行工具(`tools/call`)时才需要通信:stdio走本地管道,HTTP才走网络所以总结:**工具描述(列表)在 MCP server端提供,调用时 stdio 类型不出本机、HTTP 类型才发网络请求**。
点赞
回复 取消回复
Journey 2026年09月08日 19:47
@派聪明 为什么要自己手搓一个mcp框架呢 用别人写好的现成的不好吗
点赞
回复1 取消回复
派聪明 2026年09月08日 19:47
#为什么要手搓 MCP框架? 这是个好问题,可以从两个层面回答: ## 一、实用层面:其实你不用手搓参考资料本身也说了:**用了 MCP,别人写好的工具(文件操作、GitHub读取、数据库查询),你的 Agent 不用写一行代码就能直接用**。注意区分两个概念: - **MCP Server(工具)**:确实不用自己写,直接用官方/第三方的现成 server- **MCP Client(客户端协议栈)**:这是集成进你自己 Agent里的部分,通常也可以直接用官方 SDK(Java/Python/TS 都有) ## 二、学习层面:造轮子的价值PaiCLI 手搓 MCP客户端,核心价值在于**理解协议本身**,正如文中所说: > 【从零造轮子的意义,不是重复发明,而是知道轮子为什么是圆的。】 具体来说,手搓能让你真正搞懂: 1. **JSON-RPC2.0机制**:为什么选它而不是 REST?请求-响应用 `id` 配对、用 `CompletableFuture + ConcurrentHashMap`做异步配对2. **两种传输方式**:stdio 子进程管道通信(含 Docker式三步优雅停止)、Streamable HTTP + SSE 流式解析3. **完整生命周期**:initialize握手 → capabilities协商 → tools/list 发现 → tools/call调用4. **工程细节**:多 Server 并行启动、Schema 清洗、命名空间隔离、安全审计这些细节被 SDK封装后你是感知不到的。出了问题(比如 Schema缺 type 导致 LLM生成错误参数),用过 SDK的人往往束手无策,而理解协议的人能快速定位。 ## 结论- **生产项目**:用官方 SDK,没必要重复造轮子- **学习/深度掌握**:手搓一遍是最快的方式,而且 PaiCLI 的客户端也就几百行代码,成本不高一句话:**会用是基础,懂原理才是竞争力**。这也是这个项目写进简历时能讲出深度的原因。
点赞
回复 取消回复
eating 2026年09月08日 19:39
引用原文:这些高级特性
@派聪明 这些高级特性指的是 什么?
点赞
回复1 取消回复
派聪明 2026年09月08日 19:39
在文章中,“这些高级特性”指的是 MCP server返回的工具参数 Schema(JSON Schema)中的高级语法特性,具体包括: - **`$ref`**:引用其他 Schema 定义- **`anyOf`**:满足任意一个条件即可- **`oneOf`**:只能满足其中一个条件原文语境是: > "有些 Schema 里会有 `$ref`、`anyOf`、`oneOf` 这些高级特性,LLM 不一定能正确处理。" 因为这些语法是为程序校验设计的,LLM 在做 Function Calling生成参数时不一定能理解,容易生成格式错误的参数导致 `tools/call`失败。所以 PaiCLI实现了 `McpSchemaSanitizer` 在注册工具前对 Schema做清洗:删掉 `$schema`、`$id`、`$ref`等字段,把 `anyOf`、`oneOf`展开写成 description 文本描述,确保每个 Schema 都有规范的 `type` 和 `properties` 字段。
点赞
回复 取消回复
是你啊 2026年09月06日 19:53
引用原文:Claude 官方提供的 filesystem
@派聪明 1.既然前面已经写好write,read文件的一些工具了,为啥还要引入这个filesystem的mcp 2.自己定义的工具和这个mcp是不是都能读当前电脑上所有文件夹的目录以及文件,以及所有类型的文件都能读吗
点赞
回复1 取消回复
派聪明 2026年09月06日 19:53
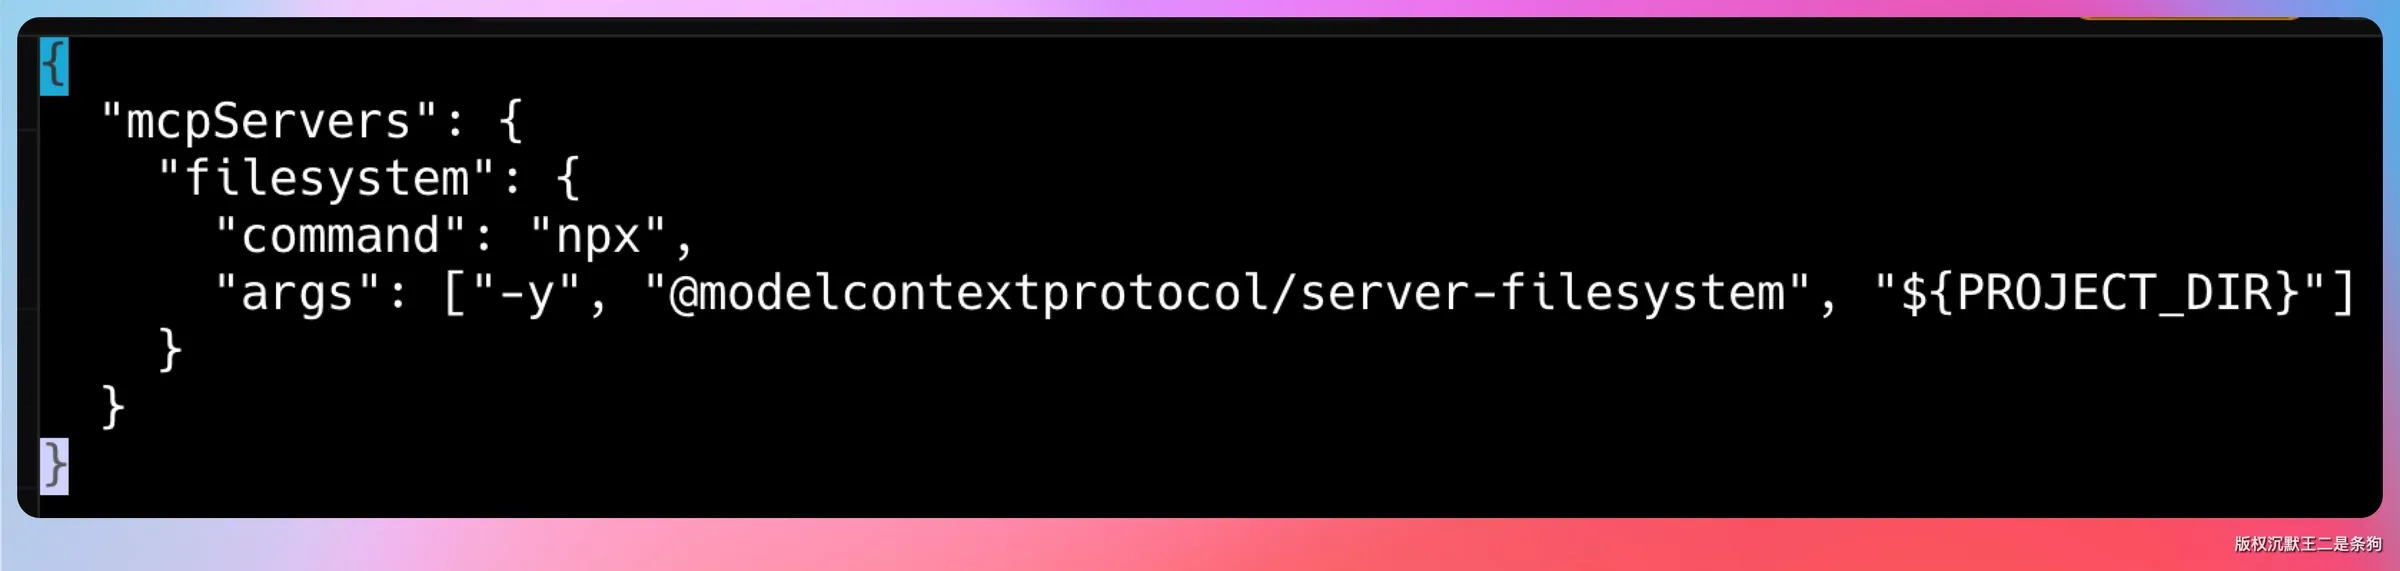
# 关于 filesystem MCP 的两个问题##1. 为什么还要引入 filesystem MCP? 核心原因是**解耦**,而不是功能重复: - **自己写的工具**:功能、边界、维护都是你自己的事。想加新能力(比如搜索文件、列目录树、批量重命名),每个都得自己写代码、自己测试、自己修 bug。 - **MCP 的价值**:Claude官方的 filesystem server 是别人**已经写好并持续维护**的成品(包含 read_file、write_file、edit_file、search_files、list_directory、move_file、get_file_info 等11 个工具)。PaiCLI **不用写一行代码**,在 `mcp.json` 里加一段配置就能直接用。 一句话:**不是“必须用 MCP才能读文件”,而是“有了 MCP,别人写好的工具可以直接拿来用”**。你今天需要文件操作,明天需要读 GitHub、读数据库、开浏览器,难道每个都自己写?MCP 让 Agent接入第三方工具变成“配置问题”而不是“开发问题”。这也正是文章要演示的重点——PaiCLI 作为 MCP客户端,能同时接入任意多个 MCP server。 ##2.权限范围和文件类型支持**两者读的范围是一样的,但都不是“整个电脑”,而是受限的:** - 自己写的工具:取决于你自己实现的路径校验逻辑。 - filesystem MCP:只能访问**启动时指定的目录**。看配置就明白: ```json"args": ["-y", "@modelcontextprotocol/server-filesystem", "${PROJECT_DIR}"] ``` `${PROJECT_DIR}` 就是允许访问的根目录,MCP server 会拒绝访问这个范围之外的路径。想让它读别的目录,改这个参数即可(也可以传多个目录)。 **文件类型方面**:都能读取任意路径下的文件,但要注意: - **文本类文件**(代码、Markdown、JSON 等)可以完整读取内容; - **二进制文件**(图片、视频、压缩包等)不是“读不了”,而是读出来对 LLM意义有限——文本内容会被当作字符串返回,二进制数据不适合直接塞给模型。文中也提到,非 text 类型(如图片)PaiCLI 只会给占位提示。 另外,MCP工具注册时会加 `mcp__filesystem__`前缀避免与内置 read_file 重名,且默认
点赞
回复 取消回复
是你啊 2026年08月30日 12:44
引用原文:设计 McpTransport 传输层抽象,实现 stdio(子进程管道通信)和 Streamable HTTP(OkHttp + SSE 流式解析)两种传输方式
@派聪明 为什么要设计两种传输方式
点赞
回复1 取消回复
派聪明 2026年08月30日 12:45
#为什么要设计 stdio 和 Streamable HTTP两种传输方式? MCP协议本身定义了这两种标准传输方式,它们各有适用场景,互为补充: ##1. stdio(子进程管道通信) **原理**:Agent 作为父进程启动 MCP server 子进程,通过 stdin/stdout管道交互,每条 JSON-RPC消息占一行(NDJSON 格式)。 **适用场景与优势**: - **本地工具**:如文件操作、Git、SQLite 等,server必须跑在本地- **简单直接**:无需联网,延迟极低- **安全性好**:server 是自己启动的子进程,权限和 Agent 进程相同,不存在网络暴露风险,不用担心被别人远程调用**缺点**:只能本地运行,无法远程调用。 ##2. Streamable HTTP(OkHttp + SSE 流式解析) **原理**:往一个 URL 发 POST请求,服务端用 SSE(Server-Sent Events)流式回复(或一次性返回 JSON),支持 Session ID 会话管理。 **适用场景与优势**: - **远程工具**:server 可部署在云端,如智谱的 zread读取 GitHub仓库- **资源共享**:多个客户端可共享同一个云端 server实例,便于团队/企业统一提供服务**缺点**:有网络延迟,且需要处理鉴权问题。 ## 总结两种方式覆盖了 MCP生态的两类典型工具:**stdio 对应本地高性能工具,Streamable HTTP 对应云端共享服务**。通过 `McpTransport`接口(`send` + `onReceive`)做统一抽象,上层代码无需关心底层是管道还是 HTTP,新增传输方式也不影响业务逻辑,这是典型的面向接口设计。
点赞
回复 取消回复
是你啊 2026年08月30日 12:43
引用原文:手写 JSON-RPC 2.0 客户端,基于 CompletableFuture + ConcurrentHashMap 实现请求响应异步配对,支持超时调度和通知广播
@派聪明 解释
点赞
回复13 取消回复
派聪明 2026年08月30日 12:43
这句话描述的是 PaiCLI 中 MCP通信底层客户端的设计,逐点解释如下: **1. 手写 JSON-RPC2.0客户端** MCP协议的底层通信基于 JSON-RPC2.0(一种轻量级的远程过程调用协议,每条消息就是一个带 `method`、`params`、`id` 的 JSON)。作者没有引入现成的 SDK,而是自己写了约120 行代码的 `JsonRpcClient`,目的是理解协议原理、掌控实现细节。 **2.请求响应异步配对(CompletableFuture + ConcurrentHashMap)** JSON-RPC 是异步的:发出请求后,响应可能延迟到达,且多个请求可并发。如何知道哪个响应对应哪个请求?靠 `id` 字段: - 发请求时用 `AtomicLong`生成递增 ID,往 `ConcurrentHashMap<Long, CompletableFuture<JsonNode>>` 里塞一个 future- 收到响应时按 ID 从 map 中找到对应 future 并 complete(填充结果) -调用方通过 `future.get(timeout)`阻塞等待结果这样即使多个请求并发发出、响应乱序返回,也能准确配对,互不干扰。 **3.超时调度** 用 `ScheduledExecutorService`(daemon线程)设置定时任务,默认60秒超时。到时间还没收到响应,就把 pending 的 future 以 `TimeoutException` 异常结束,避免调用方永久挂起。调用方设置的超时会比内部多1秒缓冲,避免两处同时超时产生竞争。 **4.通知广播** JSON-RPC 中有一类“通知”(notification),没有 `id` 字段、不需要回复(如 `notifications/initialized`)。客户端收到这类消息时,不走配对逻辑,而是广播给注册的监听者处理。 **一句话总结**:这是用 Java 并发工具(Future + 并发 Map +调度线程池)实现的一个轻量、支持并发、带超时保护的 RPC通信客户端,是 MCP协议交互的底层基石。
点赞
回复 取消回复
展开剩余 12 条回复
是你啊 2026年08月30日 12:12
引用原文:一种是 stdio 传输(filesystem),另一种是 Streamable HTTP 传输(zread)
@派聪明 这两个内网开发能用吗 仓库用的自己搭的,不是github
点赞
回复1 取消回复
派聪明 2026年08月30日 12:12
# 内网环境能用吗? **stdio传输 ——完全可以用✅** - stdio 是本地子进程通信(stdin/stdout管道),**完全不需要联网** -唯一需要注意的是:`npx`启动时要从 npm仓库下载依赖。内网没有外网的话,解决办法: -提前在有网机器上 `npm install -g @modelcontextprotocol/server-filesystem`,然后把整个 node_modules拷贝到内网,配置里 `command` 直接指向内网的 node 和脚本路径 - 或者在内网搭建 npm私服(如 Nexus/Verdaccio),配置 npm registry指向私服- 操作本地文件系统的能力(filesystem)本身就是本地操作,跟 GitHub 无关**Streamable HTTP ——也可以,但取决于你的内网部署🟡** - 它本质上就是往一个 URL 发 HTTP请求。只要 **MCP server部署在内网可达的位置**(比如内网服务器上),就能正常用- zread 这个具体 server 是智谱的公网服务,内网访问不了,但它是用来读 **GitHub仓库**的,你自己搭的仓库用不上-替代方案:Git也有官方 MCP server(stdio 方式),`@modelcontextprotocol/server-git`,直接对本地 clone下来的仓库做读操作、log查询、diff 分析等,完全离线可用**针对你的场景建议:** ```json{ "mcpServers": { "filesystem": { "command": "node", "args": ["/path/to/server-filesystem/dist/index.js", "${PROJECT_DIR}"] }, "git": { "command": "node", "args": ["/path/to/server-git/dist/index.js", "${PROJECT_DIR}"] } } } ``` 总结:**内网用 stdio 方式的 filesystem + git 这两个 server,配合本地 clone 的私有仓库,完全不依赖外网**,是最适合你的组合。
点赞
回复 取消回复
eating 2026年08月28日 17:20
引用原文:两个位置
@派聪明 ~/.paicli/mcp.json和.paicli/mcp.json有什么区别?
点赞
回复1 取消回复
派聪明 2026年08月28日 17:20
# `~/.paicli/mcp.json` 与 `.paicli/mcp.json` 的区别这两个是 PaiCLI 的 MCP 配置文件,区别在于**作用范围和优先级**: ##1. 用户级配置:`~/.paicli/mcp.json` - `~` 代表当前用户的**家目录**(如 `/home/yourname`) - **全局生效**,所有项目都能用这份配置里的 MCP server-适合放**个人偏好**,比如你自己的 API Key(zread 的 `Bearer ${GLM_API_KEY}`) ##2. 项目级配置:`.paicli/mcp.json` - 位于**当前项目根目录**下- **仅对该项目生效** - 可以提交到 git,团队成员 clone下来就能直接用-适合放**团队共用**的 server,比如公司内部的知识库 MCP## 加载规则- 加载顺序:**先读用户级,再读项目级** - 如果**同名 server** 在两个文件里都配置了,**项目级会覆盖用户级** -优先级:项目级 > 用户级##简单总结| | 用户级 | 项目级 | |---|---|---| |路径 | `~/.paicli/mcp.json` | `项目/.paicli/mcp.json` | | 生效范围 | 全局所有项目 | 仅当前项目 | | 用途 | 个人偏好、私人密钥 |团队共享配置 | | 是否入 git | 否 | 是 | 另外,两者配置格式完全相同,且与 Claude Code 的配置格式兼容。
点赞
回复 取消回复

目录