杠精派
派聪明
0/512

热门评论

东呆西萌 2026年07月20日 17:15
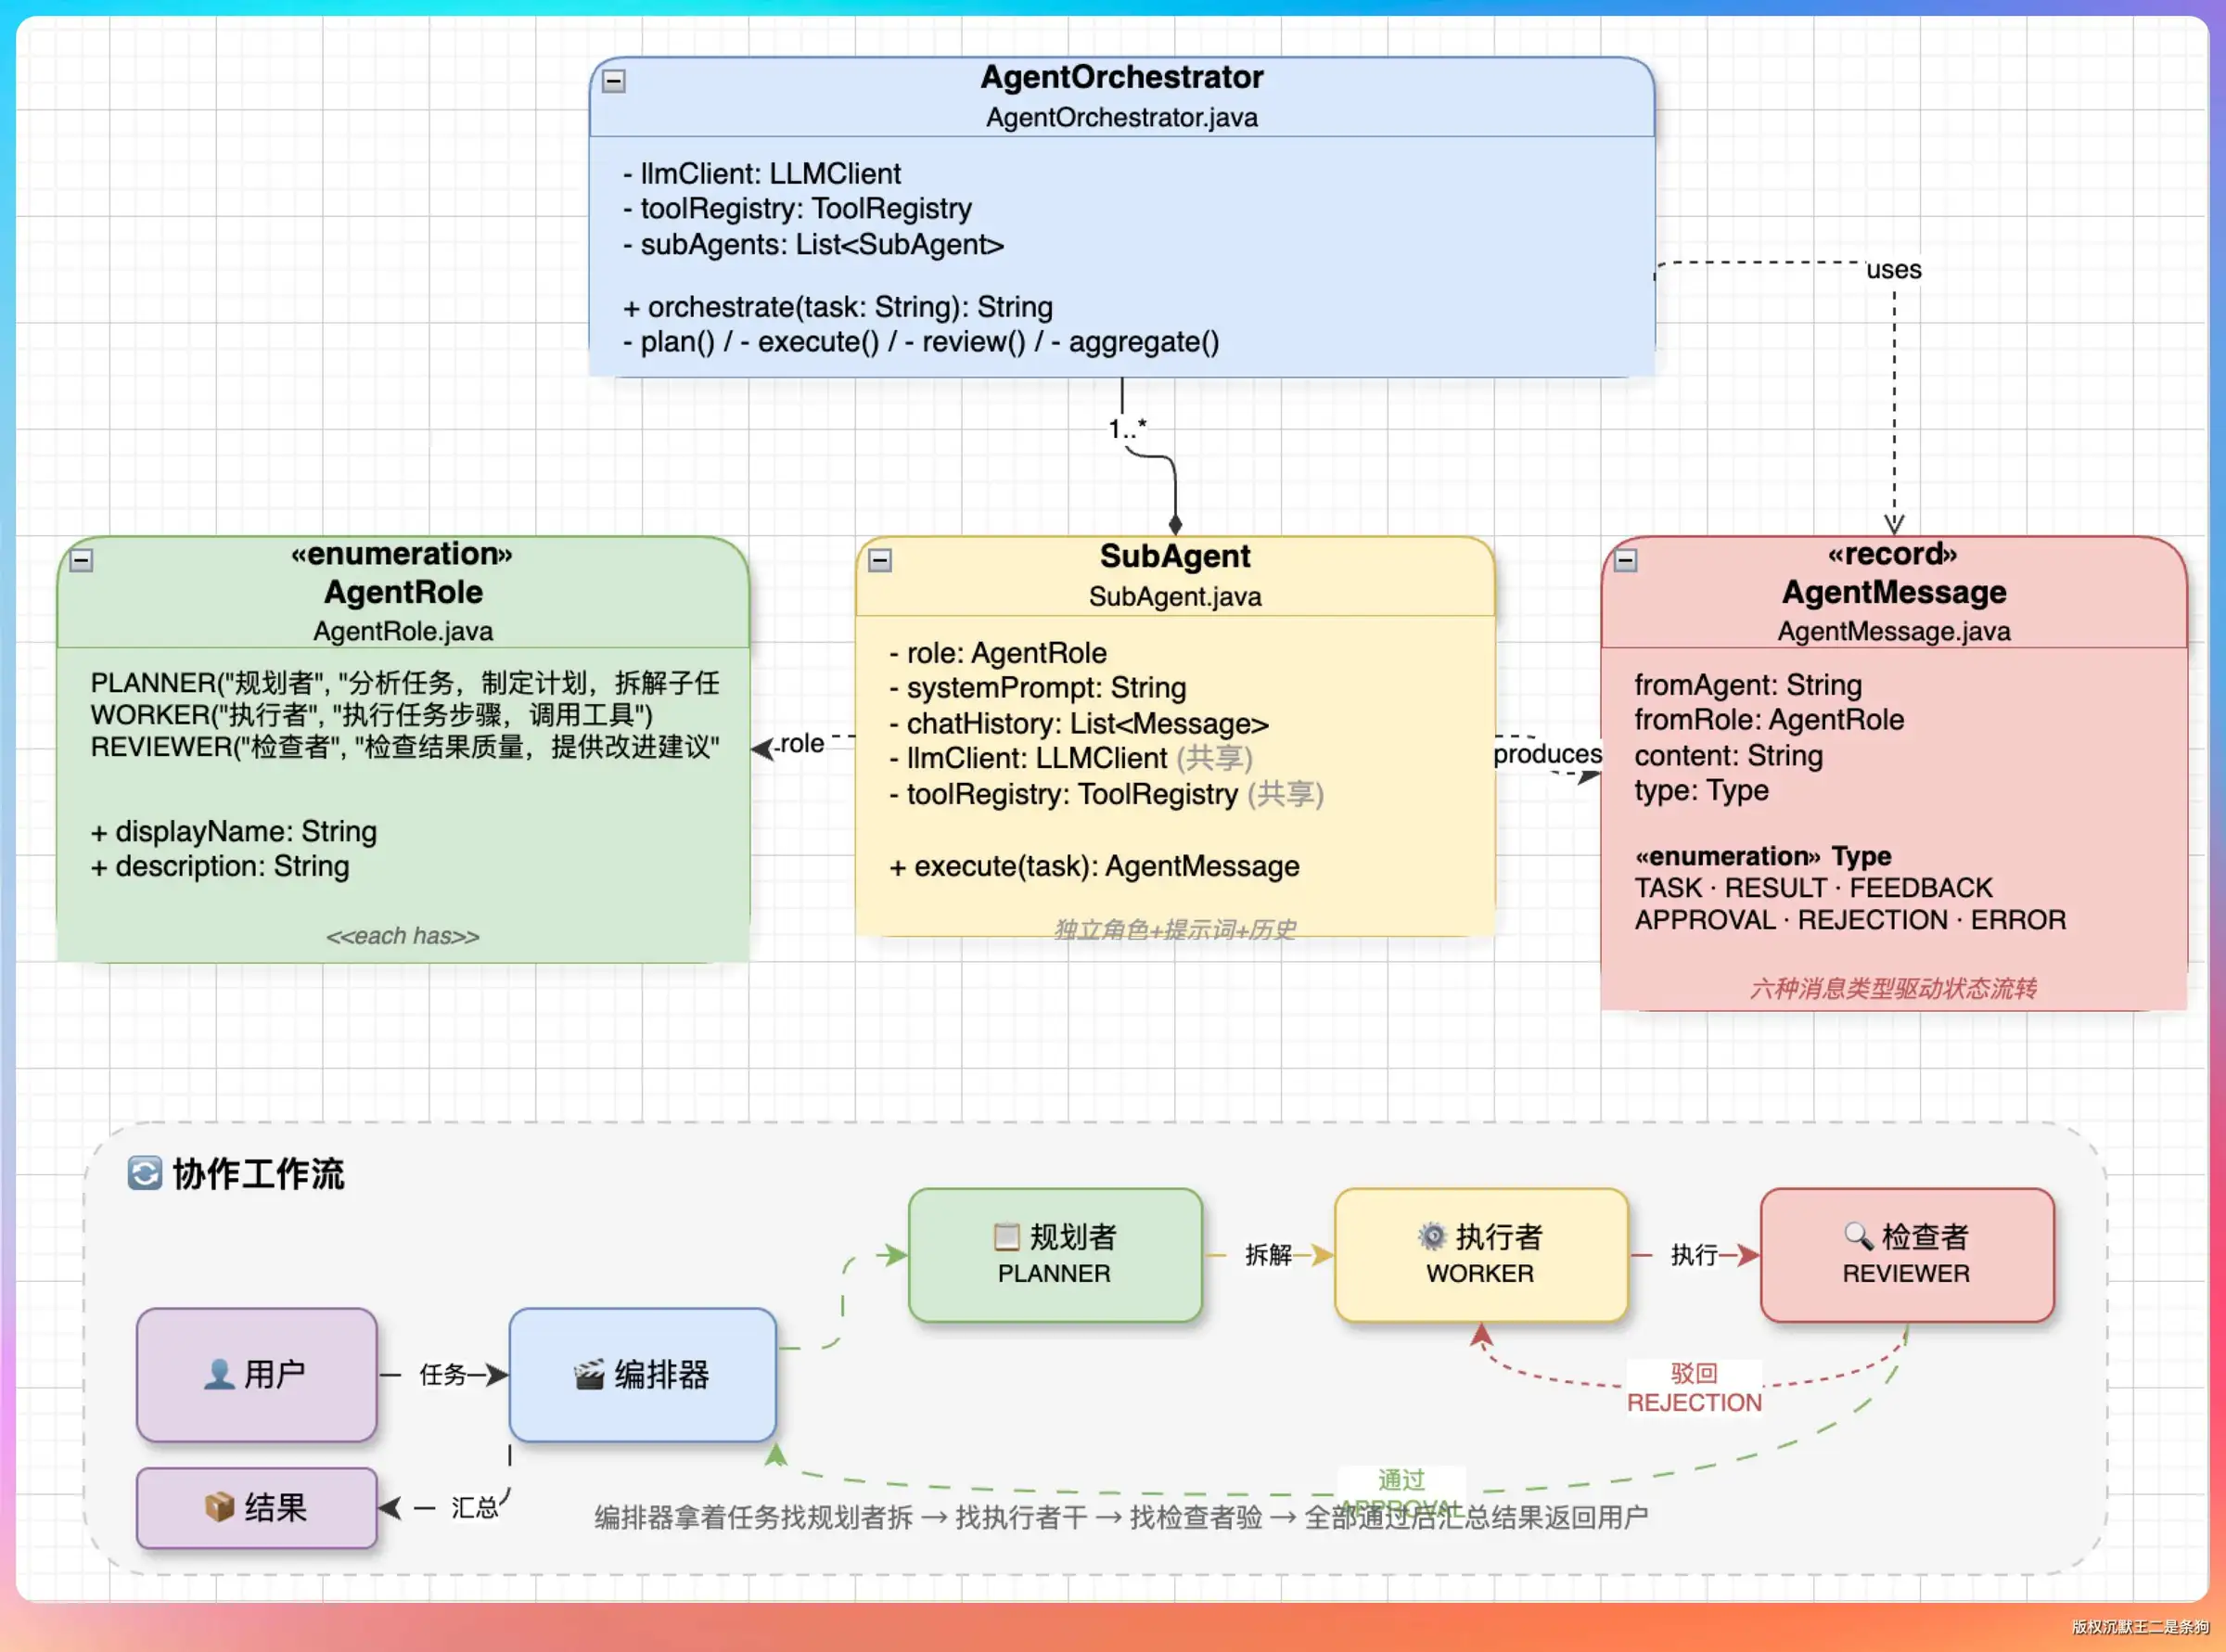
引用原文:六种消息类型:TASK(任务)、RESULT(结果)、FEEDBACK(反馈)、APPROVAL(通过)、REJECTION(拒绝)、ERROR(错误)。
@派聪明 我的问题是每种消息类型都对应着谁到谁的过程
点赞
回复5 取消回复
派聪明 2026年07月20日 17:16
根据文章中 PaiCLI 的 Multi-Agent 设计(主从架构 + 三角色分工),六种消息类型对应的发送方和接收方如下: | 消息类型 | 发送方 → 接收方 | 场景说明 | |---------|---------------|---------| | **TASK(任务)** | **编排器 → 子Agent** | 编排器给规划者发"拆解任务"、给执行者发"执行步骤"、给检查者发"审查结果" | | **RESULT(结果)** | **子Agent → 编排器** | 规划者返回执行计划、执行者返回操作结果、检查者返回审查结论 | | **FEEDBACK(反馈)** | **检查者 → 编排器 → 执行者** | 审查不通过时,检查者给出问题列表和改进建议,编排器将反馈注入上下文让执行者重试 | | **APPROVAL(通过)** | **检查者 → 编排器** | 审查通过,`approved: true`,编排器标记该步骤为 COMPLETED | | **REJECTION(拒绝)** | **检查者 → 编排器** | 审查不通过,`approved: false`,编排器触发重试机制(最多2次) | | **ERROR(错误)** | **任意Agent → 编排器** | 执行过程中出现异常,编排器进行异常处理或终止流程 | **核心规律**:所有消息都经过编排器路由(主从模式),子Agent之间不直接通信。**TASK 是向下分发的指令,其他五种都是向上返回的状态/结果。**
点赞
回复 取消回复
展开剩余 4 条回复

74 条评论

是你啊 2026年09月06日 16:17
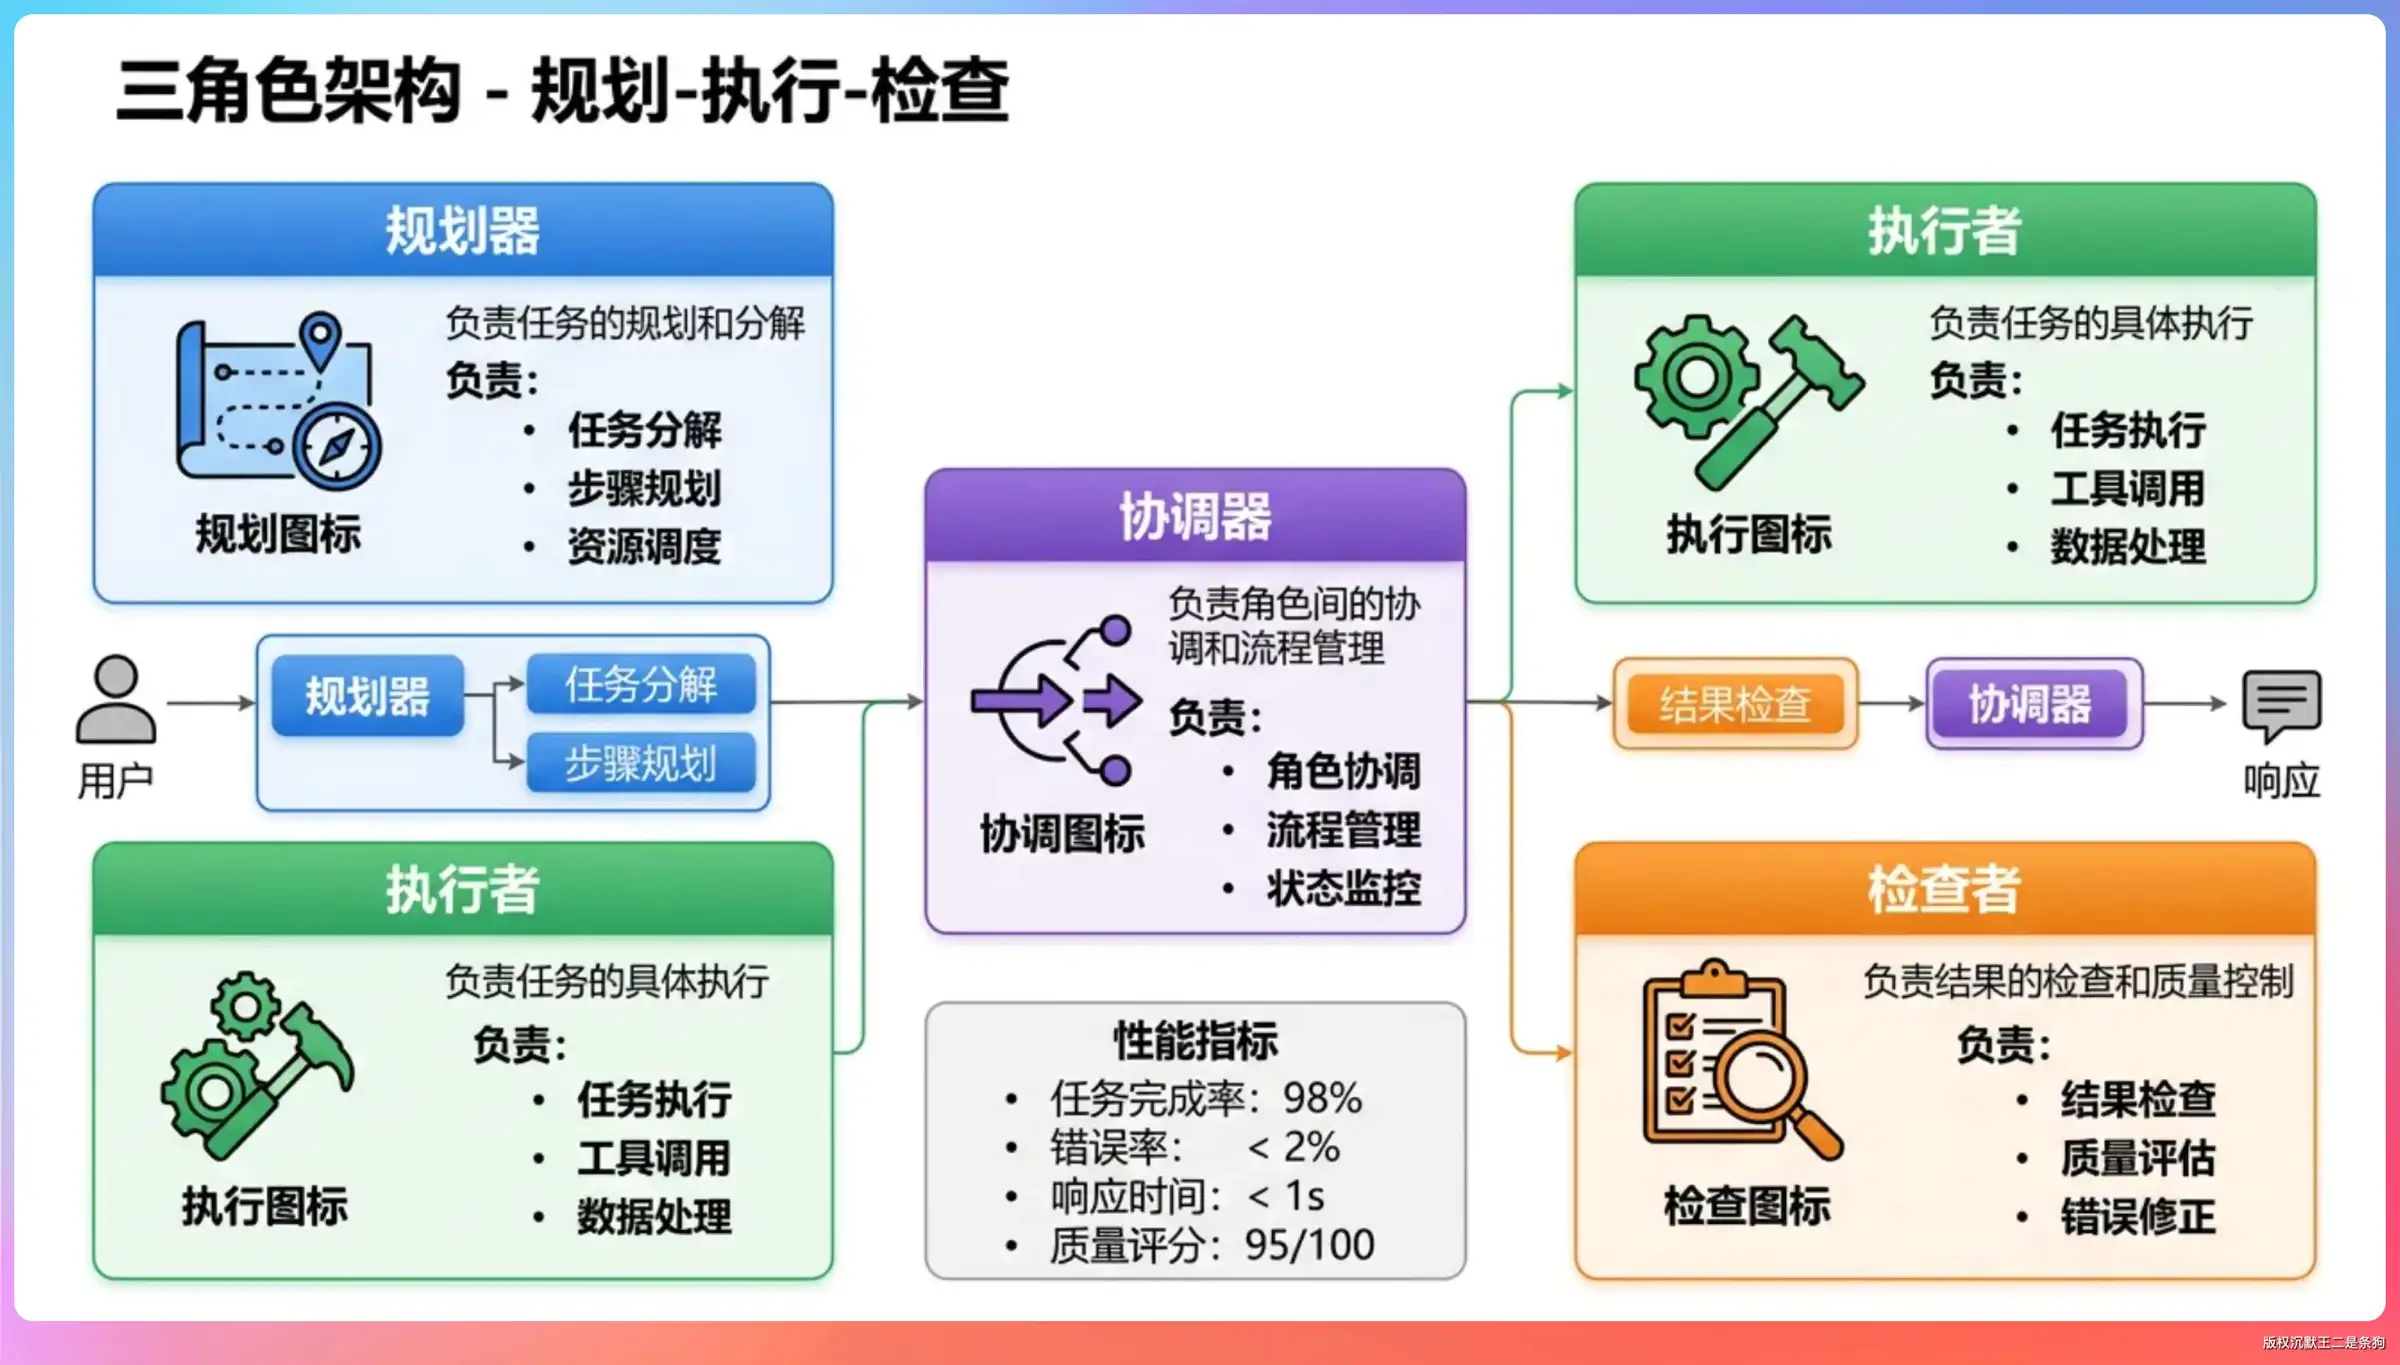
引用原文:检查者
@派聪明 检查者是怎末判断代码的好坏的 是怎末检查的
点赞
回复1 取消回复
派聪明 2026年09月06日 16:17
#检查者如何判断代码好坏检查者(Reviewer)本身**不直接看代码**,而是基于 LLM 的分析能力,通过以下方式检查: ##1.检查的输入编排器把两样东西交给检查者: - **原始任务描述**(这一步本来应该做什么) - **执行者的执行结果**(Worker调用工具后产生的输出,如文件内容、命令执行结果等) ```javaAgentMessage reviewResult = reviewer.review(step.description(), result.content(), out); ``` ##2.检查的输出检查者被系统提示词约束为输出固定 JSON 格式的“质检报告”: ```json{ "approved": true 或 false, "summary": "检查摘要", "issues": ["问题1", "问题2"], "suggestions": ["建议1", "建议2"] } ``` ##3.判断逻辑检查者由 LLM驱动,将“任务要求”与“实际结果”进行比对,从**正确性、完整性、质量**三个角度判断: - 结果是否完成了任务要求- 是否符合预期(如项目结构是否正确、文件是否生成) - 有无明显错误或遗漏##4.审批结果的保守策略解析检查者输出时采用**保守策略**: - `approved: true` →放行- `approved: false` → 打回,附上问题列表和改进建议- JSON 解析失败或缺少字段 → **默认不通过** 原因:错误结果被放行的代价远大于正确结果多审一次的代价。 ##5. 不通过怎么办未通过时,编排器会把拒绝原因注入上下文,让执行者重新执行,**最多重试2 次**;超过2次则保留当前结果,不再死磕。 简单说:检查者靠“任务描述 vs执行结果”的比对 +严格 JSON输出 +保守放行策略来完成质量把关。
点赞
回复 取消回复
是你啊 2026年09月06日 14:11
引用原文: Multi-Agent
@派聪明 多agent之间怎末通信
点赞
回复1 取消回复
派聪明 2026年09月06日 14:12
# Multi-Agent之间的通信机制根据文章,PaiCLI 的 Multi-Agent 采用**主从架构(Orchestrator-SubAgent)**,通信有以下特点: ##1.消息统一经过编排器路由子 Agent之间**不直接对话**,所有消息都由编排器(AgentOrchestrator)转发。这样协调逻辑集中、结构清晰、调试方便。 ##2. 通过 AgentMessage消息传递用 Java17 record 定义了消息格式,包含发送方、角色、内容、类型: ```javapublic record AgentMessage( String fromAgent, // 发送方 AgentRole fromRole, // 角色 String content, // 内容 Type type //消息类型) { public enum Type { TASK, // 任务 RESULT, // 结果 FEEDBACK, // 反馈 APPROVAL, // 通过 REJECTION, //拒绝 ERROR //错误 } } ``` 六种消息类型覆盖了协作全流程的状态流转。 ##3.通信流程示例- 编排器发 **TASK**消息给规划者 →规划者返回执行计划(**RESULT**) - 编排器把步骤作为 **TASK**派给执行者(Worker)→执行者返回结果- 结果交给检查者审查 → 通过返回 **APPROVAL**,不通过返回 **REJECTION**(附问题列表) - 收到拒绝时,编排器把问题作为 **FEEDBACK** 注入执行者上下文,触发重试(最多2 次) ##4.补充说明-每个子 Agent 有独立的对话历史,但共享 LLM客户端、工具注册表和记忆(Memory) - 同一批次无依赖的步骤,通过 `ExecutorService + BlockingQueue` 实现 Worker 并行执行简言之:**消息总线在编排器手里,角色之间靠结构化消息(六种类型)协作,像团队里所有沟通都走项目经理中转**。
点赞
回复 取消回复
Jepson 2026年09月02日 15:46
引用原文:AutoGen 是偏对话驱动的多 Agent 协作,多个 Agent 围绕同一个问题展开讨论,适合需要反复沟通和协商的场景。
这里多agent 讨论不需要给这些agent 指定的角色吗?不指定的话那怎么站在对应的立场阐述问题呢
点赞
回复 取消回复
粗心的超短裙 2026年08月31日 22:19
引用原文:下一期
还有下yiqi吗
1
回复 取消回复
是你啊 2026年08月30日 09:37
引用原文:基于 ProcessBuilder + Future + 超时控制 重构 Shell 执行路径,解决 execute_command 长时间阻塞影响主流程的问题,并完成真实 /team 端到端验证及 119 个测试全量通过。
@派聪明 解释
点赞
回复1 取消回复
派聪明 2026年08月30日 09:37
这段话出自文章末尾“简历包装”部分,是对 PaiCLI 项目一项技术工作的简历式描述。逐层拆解如下: **1. “基于 ProcessBuilder + Future +超时控制 重构 Shell执行路径”** - **ProcessBuilder**:Java原生的进程创建 API,用于启动外部 Shell命令(即 `execute_command`工具的底层实现)。 - **Future**:Java 并发编程接口,用于异步提交任务并获取执行结果。 - **超时控制**:为命令执行设置时间上限。 - “重构 Shell执行路径”指的是:把原来执行系统命令的逻辑重新设计——命令通过 ProcessBuilder启动,包装成异步任务交给线程池,再通过 Future 配合超时时间等待结果。 **2. “解决 execute_command长时间阻塞影响主流程的问题”** 这是重构的动机。旧实现中,如果 Agent执行了一条耗时长(甚至死循环、挂起)的命令,主线程会一直等待,导致整个 Agent 流程被卡死。重构后: -命令执行是异步的,主流程不会被卡住; - 一旦超过设定的超时时间,就会强制终止该命令,避免无限等待。 **3. “并完成真实 /team端到端验证及119 个测试全量通过”** 这是成果与质量保障: - **端到端验证**:在真实场景下运行 Multi-Agent协作模式(`/team`命令触发规划者→执行者→检查者的完整流程),确认重构后的命令执行在实际多 Agent协作中正常工作,而不只是单元测试通过; - **119 个测试全量通过**:项目的整套自动化测试(119 个)全部通过,说明重构没有引入回归问题。 **一句话总结**:作者把执行系统命令的方式改成了“异步执行 +超时强制终止”,解决了命令卡死会阻塞整个 Agent 的缺陷,并通过真实场景验证和全量测试证明了改动安全可靠。这是典型的“技术方案 + 解决的问题 +验证结果”三段式简历写法。
点赞
回复 取消回复
是你啊 2026年08月30日 09:20
引用原文:重试时会把上次的拒绝原因注入上下文,让执行者知道哪里做错了、该怎么改。
@派聪明 如果是规划者错了怎末重试 怎末判断是规划者应该重试还是执行者
点赞
回复1 取消回复
派聪明 2026年08月30日 09:21
好问题,这段文章描述的重试机制**只针对执行者(Worker)**,而且现有代码里其实**没有规划者层面的重试机制**。下面分两层回答: ## 一、当前机制下怎么处理规划错误在 PaiCLI 的设计中,规划者只输出 JSON计划,不调用工具。如果计划本身有问题,系统有几种“兜底”表现: 1. **JSON 解析失败**:编排器解析规划者的输出失败,通常直接报 ERROR 或终止流程,没有自动重试。 2. **计划拆解不合理**:执行者照着错误的步骤执行,结果被检查者打回。但检查者看到的是“某一步的执行结果”,它的反馈只会注入给 Worker 重试。如果错误根源在计划(比如步骤缺失、依赖关系标错),**Worker 重试2次都不会成功**,超过 MAX_RETRIES 就保留当前结果跳过,流程继续走。这就是当前架构的盲区——错误被“容忍”而不是被“纠正”。 ## 二、怎么判断该重试规划者还是执行者可以从这几个信号判断: **应该重试规划者的情况:** - 多个不同步骤连续被拒,且拒绝原因相似(说明不是单步执行问题,是计划本身错了) - 反馈中指出“任务目标理解错误”“缺少必要步骤”“步骤顺序/依赖错误” - Worker 反馈“该步骤无法执行,因为缺少前置操作”——典型的计划缺陷- 解析出的步骤列表为空或与用户需求明显不符**应该重试执行者的情况:** - 只有单一步骤被拒,且拒绝原因是具体操作层面:文件内容写错、命令执行失败、结果不完整-步骤描述本身清晰可执行,只是产出质量不达标## 三、改进方案(如果要实现) 在编排器加重试循环外层: ``` for plan_attempt in1..2: 计划 = planner.execute(用户需求 + 上次计划失败的原因) # 注入失败反馈 for step in计划: Worker执行 → Reviewer审查 if某步骤重试2次仍不通过 and 反馈指向计划缺陷: 把失败信息回传给 Planner重新规划,break ```
点赞
回复 取消回复
eating 2026年08月28日 16:30
引用原文:这在代码里通过 shouldUseTools() 控制
@派聪明 具体是如何控制只有执行者才能调用工具的?
点赞
回复1 取消回复
派聪明 2026年08月28日 16:30
# `shouldUseTools()` 的控制机制在 `SubAgent.java` 中,通过判断角色来决定是否允许工具调用: ```javaprivate boolean shouldUseTools() { return role == AgentRole.WORKER; } ``` **逻辑很简单:只有当子 Agent 的角色是 `WORKER`(执行者)时,返回 `true`,其余角色返回 `false`。** ##工作原理这个方法会在 SubAgent 与 LLM交互的流程中被调用,用于决定: 1. **是否在请求中注入工具定义**:当 `shouldUseTools()`返回 `false` 时,规划者和检查者发送给 LLM 的请求中不携带工具(tools)声明,模型根本“看不到”任何可用工具,自然无法产生工具调用。 2. **是否处理工具调用循环**:执行者走完整的工具调用流程(模型返回 tool_call →执行工具 → 把结果回传模型);而规划者和检查者只做一次纯文本生成,直接输出 JSON 格式的分析结果。 ## 设计意图- **职责隔离**:规划者只拆任务、检查者只做验收判断,它们的输出是纯文本(JSON计划 / JSON审批结果)。这避免了角色混乱——正如文章所说:“规划者一旦调了工具,它就变成了一个又规划又执行的混合角色”,容易在规划阶段陷入执行细节。 - **输出可解析**:由于不产生工具调用,规划者的执行计划和检查者的审批结果都能保证是干净的 JSON,方便编排器用 `parsePlan()`、`parseReviewApproval()` 解析。 简言之,这个方法是一个“开关”:通过角色枚举判断,在请求层面控制工具是否对模型可见,从源头杜绝非执行角色调用工具的可能。
点赞
回复 取消回复
eating 2026年08月28日 16:00
引用原文:每一步都有一组 dependencies,标注它依赖哪些步骤
@派聪明 编排器解析成ExecutionStep列表是什么意思
点赞
回复1 取消回复
派聪明 2026年08月28日 16:01
“编排器解析成 ExecutionStep列表”的意思是:**把规划者输出的 JSON执行计划,转换成程序里可操作的 Java 对象集合**。 ##具体过程**1.规划者输出的是 JSON 文本** 规划者(Planner)拿到用户任务后,会输出一份 JSON 格式的计划,比如: ```json{ "steps": [ {"id": "step_1", "description": "创建项目", "dependencies": []}, {"id": "step_2", "description": "写 Controller", "dependencies": ["step_1"]}, {"id": "step_3", "description": "跑测试", "dependencies": ["step_2"]} ] } ``` 但这只是**字符串**,程序没法直接用它来调度执行。 **2. 编排器把 JSON “翻译”成对象** 编排器(Orchestrator)调用 `parsePlan()` 方法,把 JSON 字符串反序列化成 `List<ExecutionStep>`。每个 `ExecutionStep` 是一个 Java 对象,大致包含: - `id`:步骤编号- `description`:步骤描述- `type`:步骤类型(文件读/写、命令等) - `dependencies`:依赖的步骤 id列表- `status`:步骤状态(PENDING / COMPLETED 等,后续跟踪用) - `result`:执行结果## 为什么必须做这一步转成对象后,编排器才能用代码逻辑控制整个流程,比如: - **依赖判定**:用 `getExecutableSteps()` 过滤出“状态为 PENDING 且所有依赖都 COMPLETED”的步骤,决定哪些能执行- **并行调度**:把同批次互不依赖的步骤分给不同 Worker 并行执行- **状态追踪**:每步执行、审查通过后更新 status,失败时标记并跳过依赖它的步骤- **上下文注入**:Worker执行某步时,能查到它依赖的步骤已完成的结果一句话总结:**解析成 ExecutionStep列表,就是把 LLM 生成的“自然语言计划”变成程序可以依赖驱动、并行调度、状态管理的结构化数据结构**。没有这一步,编排器拿到 JSON 字符串也无从调度。
点赞
回复 取消回复
eating 2026年08月28日 15:58
引用原文:每一步都有一组 dependencies,标注它依赖哪些步骤
@派聪明 dependencies是规划者输出的吗?也就是说依赖关系是由规划者确定的?
点赞
回复1 取消回复
派聪明 2026年08月28日 15:59
是的,依赖关系是由规划者确定的。 根据文章内容,规划者在输出执行计划时,每一步除了 `id`、描述、类型之外,还必须标注 `dependencies` 字段(依赖哪些步骤)。规划者的系统提示词中明确要求按 JSON 格式输出: ```json{ "id": "step_1", "description": "步骤描述", "type": "FILE_READ | FILE_WRITE | COMMAND | ANALYSIS | VERIFICATION", "dependencies": [] } ``` 具体的流程分工是: 1. **规划者(Planner)**:拿到用户需求后,负责拆解任务并标注每步的依赖关系; 2. **编排器**:拿到 JSON计划后,解析成 `ExecutionStep`列表,建立步骤间的依赖关系,并在执行阶段用 `getExecutableSteps()` 过滤出“状态为 PENDING 且所有依赖都 COMPLETED”的步骤来调度执行。 也就是说,依赖关系是规划者在规划阶段确定的,编排器只负责根据这些依赖关系来决定执行顺序和并行批次。
点赞
回复 取消回复
UoSerein 2026年08月25日 15:25
@派聪明 Worker之间的上下文传递 最开始每个Worker是完全隔离的,Worker A的结果要通过”把结果写进下一步的Prompt”来传递。但结果很长的时候(比如Worker A分析了10个文件,输出了5000字的分析报告),塞进Worker B的Prompt就爆了。这里怎么处理的
点赞
回复1 取消回复
派聪明 2026年08月25日 15:25
Worker之间的上下文传递 最开始每个Worker是完全隔离的,Worker A的结果要通过”把结果写进下一步的Prompt”来传递。但结果很长的时候(比如Worker A分析了10个文件,输出了5000字的分析报告),塞进Worker B的Prompt就爆了。这里怎么处理的 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复

目录