杠精派
派聪明
0/512

热门评论

东呆西萌 2026年07月15日 17:15
@派聪明 在记忆检索模块说要对短期记忆进行检索,但是在将记忆模块集成到Agent的模块中却只对长期记忆进行检索,这是为什么?
点赞
回复9 取消回复
派聪明 2026年07月15日 17:16
这个问题问得很细,核心原因在于:**短期记忆的内容已经通过对话历史(`conversationHistory`)直接传给 LLM 了,Agent 不需要再额外检索一次。** 具体拆解一下: 1. **短期记忆 = 对话历史本身**。在 `Agent.run()` 方法中,用户输入是先存进短期记忆,然后紧接着就添加到 `conversationHistory` 列表里了(第三步)。后续 ReAct 循环会把整个 `conversationHistory` 作为 messages 传给 LLM。所以短期记忆里的每一条消息都已经原封不动地出现在 LLM 的输入上下文中,**不需要再从记忆系统里捞一次**——捞出来也是重复的,浪费 token。 2. **长期记忆是跨会话的、对话历史里没有的**。用户上一轮会话说“我喜欢 JDK 17”,清空对话后,`conversationHistory` 里已经没有这条消息了。但长期记忆的 JSON 文件里还存着。所以 Agent 需要主动检索长期记忆,把那些**对话历史里不存在但对当前任务有帮助**的事实捡回来,注入到 system prompt 里。 3. **`buildContextForQuery` 内部虽然会检索短期记忆**,但检索出来的内容本质上是对话历史已有的信息,真正有价值的是长期记忆那部分。注释写“检索相关长期记忆”是一种**业务语义上的简化**——Agent 集成层最关心的、最缺的、唯一需要额外补充的,就是长期记忆。短期记忆的检索更多是检索器层面的通用设计(比如给其他场景复用),但在 Agent 主流程里,它起到的作用接近于零。 一句话总结:**短期记忆已经通过对话历史直接喂给 LLM 了,无需再检索;只有长期记忆是对话历史里没有的,才需要 Agent 主动去“想起来”并注入到上下文中。**
点赞
回复 取消回复
展开剩余 8 条回复

192 条评论

潇洒的黑夜 2026年09月29日 20:13
@派聪明 长期记忆是怎么存储下来的?存到本地文件吗
点赞
回复1 取消回复
派聪明 2026年09月29日 20:13
长期记忆是怎么存储下来的!存到本地文件 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
安安 2026年09月25日 15:26
引用原文:对话
一个对话组合就是一个entries吗 @派聪明
点赞
回复1 取消回复
派聪明 2026年09月25日 15:26
这是我从文章中选择的一段文本:"对话" 一个对话组合就是一个entries 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
安安 2026年09月25日 15:25
引用原文:对话
一个对话组合就是一个entries吗 @派聪明
点赞
回复1 取消回复
派聪明 2026年09月25日 15:25
这是我从文章中选择的一段文本:"对话" 一个对话组合就是一个entries 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
んuyunlong💋 2026年09月24日 09:50
@派聪明 超出token预算的时候是采用裁剪最旧的消息还是map-reduce
点赞
回复3 取消回复
派聪明 2026年09月24日 09:50
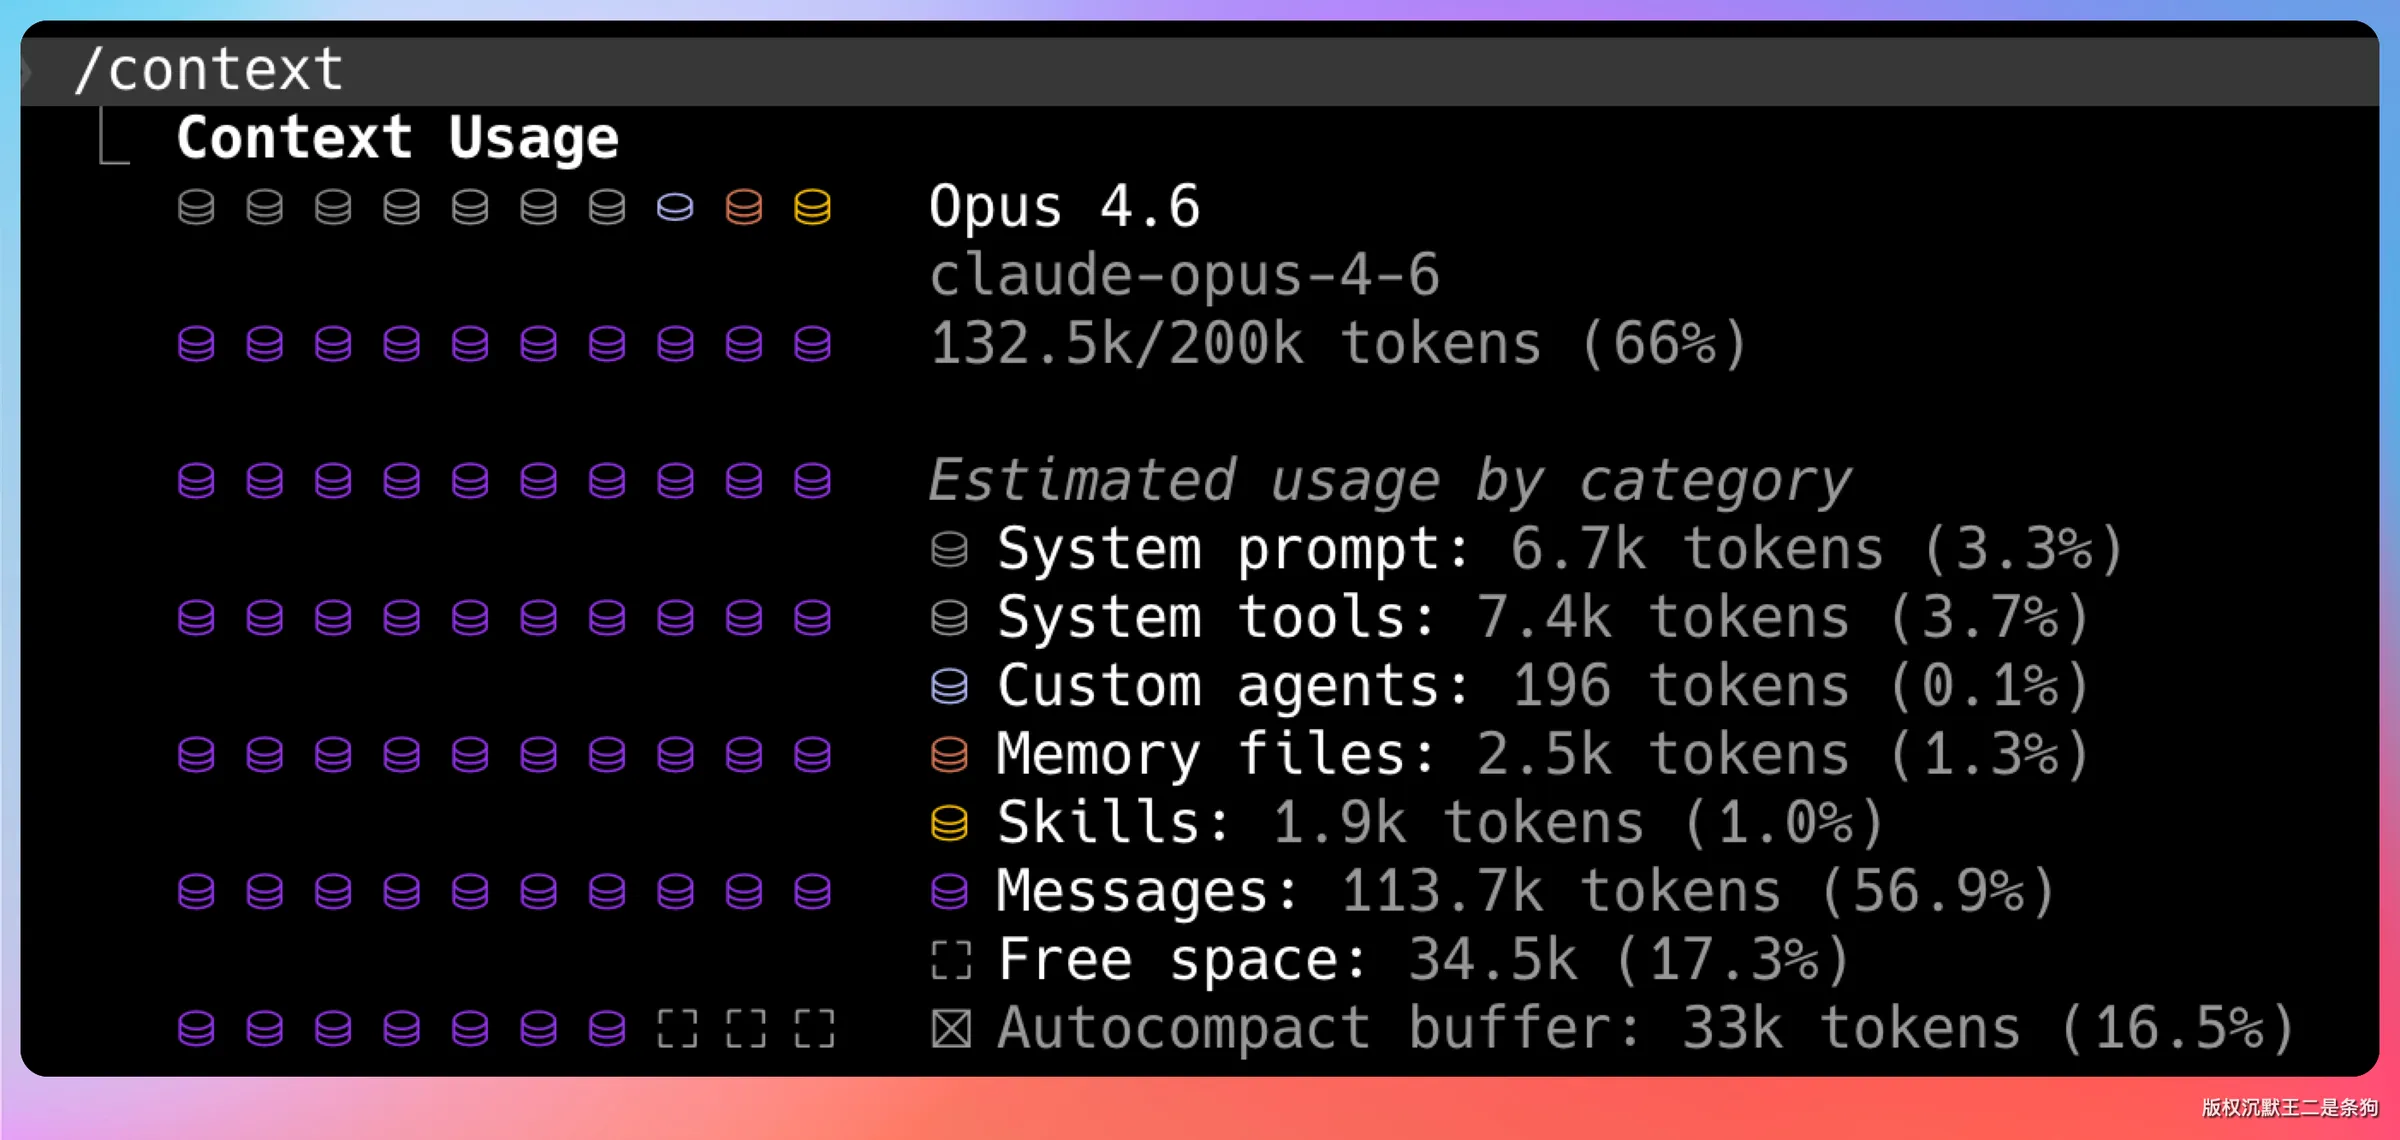
两者结合使用,具体流程如下: **先裁剪,再压缩(Map-Reduce)**,并不是二选一。 1. **自动淘汰(裁剪)**:每次存消息时,`ConversationMemory.store` 会检查当前 token 是否超出 `maxTokens`。超出时用 FIFO策略自动淘汰最旧的条目(类似操作系统的页面置换)。但被淘汰的消息**不会直接扔掉**,而是放入 `compressedSummaries`列表,等待后续压缩成摘要。 2. **Map-Reduce压缩**:当对话 token 使用率超过可用预算的 **80%**(`TokenBudget.needsCompression`判断,留20% 余量是因为字符估算不精确),MemoryManager 的 `compressIfNeeded` 就会触发 `ContextCompressor`,采用 Map-Reduce策略: - **Map阶段**:把旧消息按每5 条一组分片,每组独立调用 LLM生成摘要(短文本摘要质量更高); - **Reduce阶段**:多个分片摘要合并成最终摘要; - **关键细节**:最近 `retainRecentRounds`(3轮)消息不参与压缩,原样保留,因为刚聊的内容通常是当前任务的核心上下文。 压缩完成后清空旧记忆,注入 `[历史对话摘要]`,再回填近期消息。 简单说:**裁剪是常态化的即时止损,Map-Reduce压缩是到达阈值后的系统性整理**,两者配合既控制 token 又不丢关键信息。
点赞
回复 取消回复
展开剩余 2 条回复
んuyunlong💋 2026年09月23日 10:29
引用原文:把旧消息分成每 5 条一组,每组独立调用 LLM 生成摘要
@派聪明 5条一组是指发送一次消息算一条吗,还是一个usermessage或者一个assistant就算一条
点赞
回复7 取消回复
派聪明 2026年09月23日 10:29
是的,这里的“一条”指的是一条记忆条目,即一条消息。在 PaiCLI 的 Memory系统中,短期记忆(ConversationMemory)里的每一个 `MemoryEntry` 对应一条消息记录,具体来说: - **一次交互会产生多条条目**:用户发一句话,存一条 `CONVERSATION` 类型的条目;Agent 回复一段内容,又存一条条目;如果中间还执行了工具,工具返回的结果会存一条 `TOOL_RESULT` 类型的条目。 所以“每5 条一组”的分片粒度是**按消息条数(MemoryEntry 数量)来算的**,不是按“一轮对话”(一轮 user + assistant交互可能包含2 条甚至更多条目)。 **为什么要这样分组?** 压缩时是从 `memory.getAll()`拿到所有条目列表,然后从头部切出旧消息(保留最近3轮不压缩)。这些旧条目按每5 条一个 chunk切分: - 每个 chunk独立调用一次 LLM生成摘要,短文本的摘要质量比一次性丢几十条消息高得多- 多个 chunk 的摘要再在 Reduce阶段合并成最终摘要,只有一个 chunk 时直接用,不额外调 LLM简单总结:**一个 usermessage 或一个 assistant 回复各算一条,工具执行结果也单独算一条,5 条这样的条目构成一个压缩分片。**
点赞
回复 取消回复
展开剩余 6 条回复
忐忑的羽毛 2026年09月17日 14:47
引用原文:长期记忆 短期记忆跟着会话走,对话一关就没了。但有些信息是跨会话都需要的——“用户喜欢 JDK 17”“项目用 Maven 构建”——
@派聪明,既然你都说了对话一关,短期记忆就没有了,那之前的两个组件conversationMemory以及conversationHistory中的内容都会消失吗?
点赞
回复3 取消回复
派聪明 2026年09月17日 14:48
是的,这两个组件的内容在会话关闭后都会消失,但它们的定位和“消失”的方式略有不同: **1. ConversationMemory(短期记忆)** -纯内存对象,数据存在 `LinkedHashMap` 里,没有任何持久化逻辑- 会话结束(进程退出)后内容全部丢失- 即使在会话中,超出 token预算时最旧的条目也会被 FIFO淘汰(但会转为压缩摘要保留信息) **2. ConversationHistory(对话历史)** - 这是发给 LLM 的消息列表(`List<Message>`),同样只在内存中,从未写入磁盘- 会话关闭后同样消失**那为什么 Agent 还能“记住”偏好?** 关键在于信息消失前的“抢救机制”: - 用户输入 `/clear` 或对话结束时,会先调用 `memoryManager.extractAndSaveFacts()`,用 LLM 从对话中提取关键事实(如“用户喜欢 JDK17”) - 这些事实以 `MemoryType.FACT` 类型存入 **LongTermMemory**,并立即 `saveToDisk()`持久化到 `~/.paicli/memory/long_term_memory.json` - 下次启动 Agent 时,`LongTermMemory`构造函数会自动 `loadFromDisk()` 加载所以设计思路是:**短期容器(ConversationMemory + ConversationHistory)注定是一次性的,只服务当前会话;真正需要跨会话的信息在消失前被提炼并落盘到长期记忆,通过检索重新注入新会话的 system prompt。** 简言之:消失是设计预期,不消失靠的是“事实提取 +磁盘持久化”这条转移链路。
点赞
回复 取消回复
展开剩余 2 条回复
忐忑的羽毛 2026年09月17日 14:30
引用原文: jieba 来算关键词匹配度的
@派聪明,请你详细说明解释一下如何使用jieba来做关键词匹配度的
点赞
回复1 取消回复
派聪明 2026年09月17日 14:30
# 使用 jieba做关键词匹配度详解在这篇文章的 Memory系统中,`MemoryRetriever.computeRelevanceScore` 用 jieba 分词来计算记忆条目与查询的相关度。整体流程分三步: ##1.查询分词```javafinal class MemoryQueryTokenizer { private static final JiebaSegmenter SEGMENTER = new JiebaSegmenter(); static Set<String> tokenize(String query) { LinkedHashSet<String> tokens = new LinkedHashSet<>(); List<String> words = SEGMENTER.sentenceProcess( query.toLowerCase(Locale.ROOT).trim()); for (String word : words) { String trimmed = word.trim(); // 过滤单字符和纯标点 if (trimmed.length() >=2 && !isPunctuation(trimmed)) { tokens.add(trimmed); } } return tokens; } } ``` 要点: - 用 `JiebaSegmenter.sentenceProcess()` 把句子切成词,如“项目技术栈”→“项目”“技术栈” -转小写做归一化,避免大小写不匹配- **过滤单字和标点**:中文里“的”“了”“是”这类单字没有检索价值,留着只会带来噪音- 用 `LinkedHashSet`去重并保持顺序##2.匹配记忆内容对每条记忆的 content(及 metadata)同样分词,然后与查询 token做交集匹配: ```javastatic boolean matches(String text, Set<String> queryTokens) { Set<String> textTokens = tokenize(text); return textTokens.stream().anyMatch(queryTokens::contains); } ``` 命中任意一个词即视为相关(`search` 里用 OR匹配)。 ##3.计算相关度分数在 `computeRelevanceScore` 中,分数由三个维度组合: - **关键词匹配**:命中的查询词数量越多、占比越高,分数越高。比如查询“JDK 版本偏好”,记忆“用户喜欢 JDK17”命中“JDK”,得基础分- **时间衰减**:24 小时内分数从1.0线性衰减到0.5,越新的记忆权重越高(这也是为什么长期记忆加载时要保留原始时间戳) - **来源加权**:长期
点赞
回复 取消回复
是你啊 2026年09月11日 13:42
引用原文:组件都写好了
@派聪明 用户每次进来 都走这个吗 先存短期记忆 再检索长期记忆 ,这样的话会不会消耗token和时间呢 还是说只有第一次输入才去检索上下文
点赞
回复1 取消回复
派聪明 2026年09月11日 13:43
好问题!根据文章的设计,**每次用户输入都会走这个流程**,但这个设计在 token 和时间消耗上是有所控制的。 ##实际流程(每次输入都执行) ```javapublic String run(String userInput) { memoryManager.addUserMessage(userInput); //每次都存 String memoryContext = memoryManager .buildContextForQuery(userInput,500); //每次都检索 updateSystemPromptWithMemory(memoryContext); ... } ``` ##消耗确实存在,但被三层控制住了**1.检索本身不调 LLM,几乎不花时间和钱** `MemoryRetriever.retrieve()` 用的是 jieba 分词 + 关键词匹配 + 时间衰减评分,纯本地计算,不走模型 API。所以“检索”这一步本身是毫秒级的,没有额外 LLM调用开销。 **2. 注入的记忆有 token 上限** 注意 `buildContextForQuery(userInput,500)` —— 第二个参数限定了注入的记忆上下文最多500 token 左右,不是把全部记忆塞进去。所以每次多消耗的 token 是有上界的。 **3.没有相关记忆就恢复原始 prompt** ```javaif (memoryContext == null || memoryContext.isEmpty()) { conversationHistory.set(0, Message.system(SYSTEM_PROMPT)); //恢复原样} ``` 查询跟长期记忆都不沾边时,什么都不注入,token零消耗。 ## 为什么每次都要检索? 因为不检索就会漏。用户第三轮说“还是用刚才那个版本吧”,如果只在第一次检索,Agent 就“忘了”前面相关的事实。记忆相关性是跟着每次输入变化的,不同 query命中的记忆不同。 ##真正的消耗大头在哪? 不在检索,而在 **LLM调用本身**——每次请求多带几百 token 的记忆上下文。这个消耗相对于整个 ReAct循环(还要带系统提示词、工具定义、完整对话历史)来说占比很小,换来的是跨会话的“记性”,性价比是划算的。 如果未来记忆量大到检索本身变慢,或者需要语义匹配("Java框架”匹配“Spring Boot"),文章也提到了第四期会上 Embedding + RAG 方案。
点赞
回复 取消回复
是你啊 2026年09月11日 13:28
引用原文:jieba 分词
@派聪明 分词之后这些分词放在哪
点赞
回复1 取消回复
派聪明 2026年09月11日 13:29
根据文章,jieba 分出来的词**并不持久化存储**,而是作为临时检索用的数据结构放在内存里,具体流程如下: ##1.存放在 `LinkedHashSet` 中`MemoryQueryTokenizer.tokenize()` 的返回值就是一个 `LinkedHashSet<String>`: ```javastatic Set<String> tokenize(String query) { LinkedHashSet<String> tokens = new LinkedHashSet<>(); List<String> words = SEGMENTER.sentenceProcess(...); // 过滤单字和标点后加入 tokens return tokens; } ``` 用 `LinkedHashSet` 的好处:**去重**(同一个词只算一次)+ **保持分词顺序**。 ##2. 用完即弃,只服务于当次检索这些分词会被传给两处使用: - **长期记忆的 `search` 方法**:用 `queryTokens`去逐条匹配记忆条目的 `content` 和 `metadata`,命中的条目返回; - **MemoryRetriever 的 `computeRelevanceScore`**:根据分词命中数量计算相关度分数(再叠加时间衰减和来源加权)。 也就是说,分词结果只在**一次查询的生命周期内存在**,检索完成后就被垃圾回收了,既不写入磁盘,也不存入长期记忆的 JSON 文件。 ##3. 对比:记忆本体存在哪| 内容 |存储位置 | |---|---| | 分词结果 | 内存中的临时 Set,用完丢弃 | |长期记忆条目 | `~/.paicli/memory/long_term_memory.json` | |短期记忆条目 | 内存中的 LinkedHashMap | 所以简单说:**jieba 分出来的词是“查询钥匙”,不是“记忆内容”**——每次检索时现场分词、现场匹配,不额外占存储空间。
点赞
回复 取消回复
是你啊 2026年09月06日 14:34
引用原文:完整的
@派聪明 一个完整的 Agent 记忆系统应该如何设计?包括哪些模块?
点赞
回复1 取消回复
派聪明 2026年09月06日 14:34
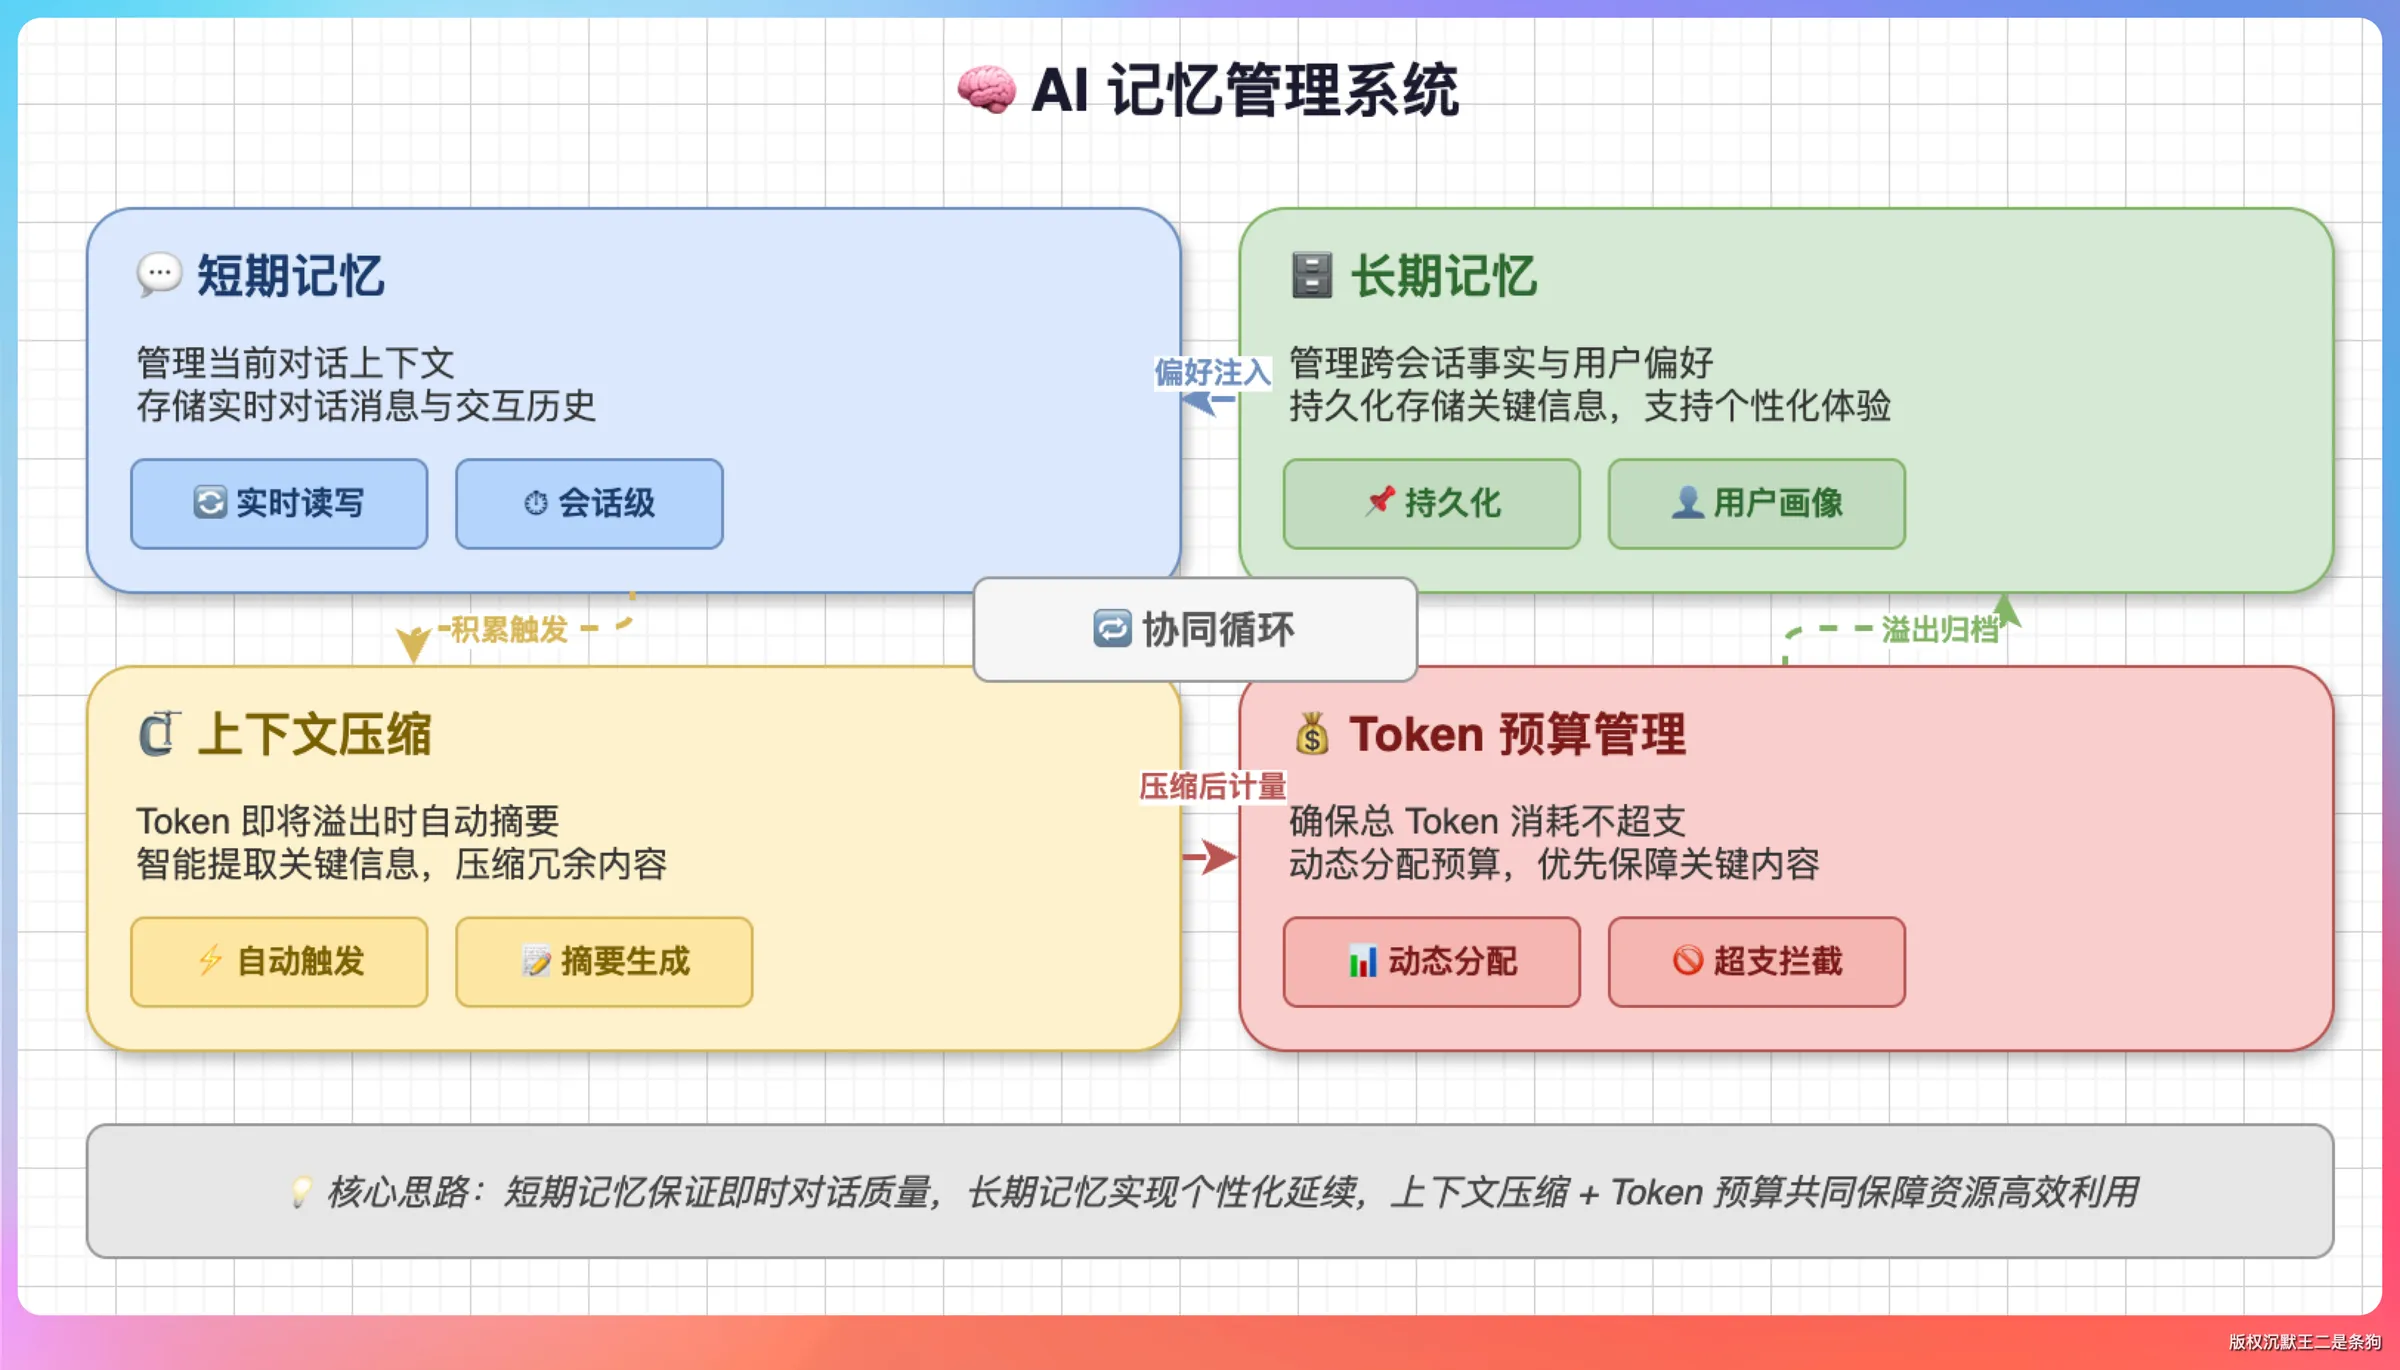
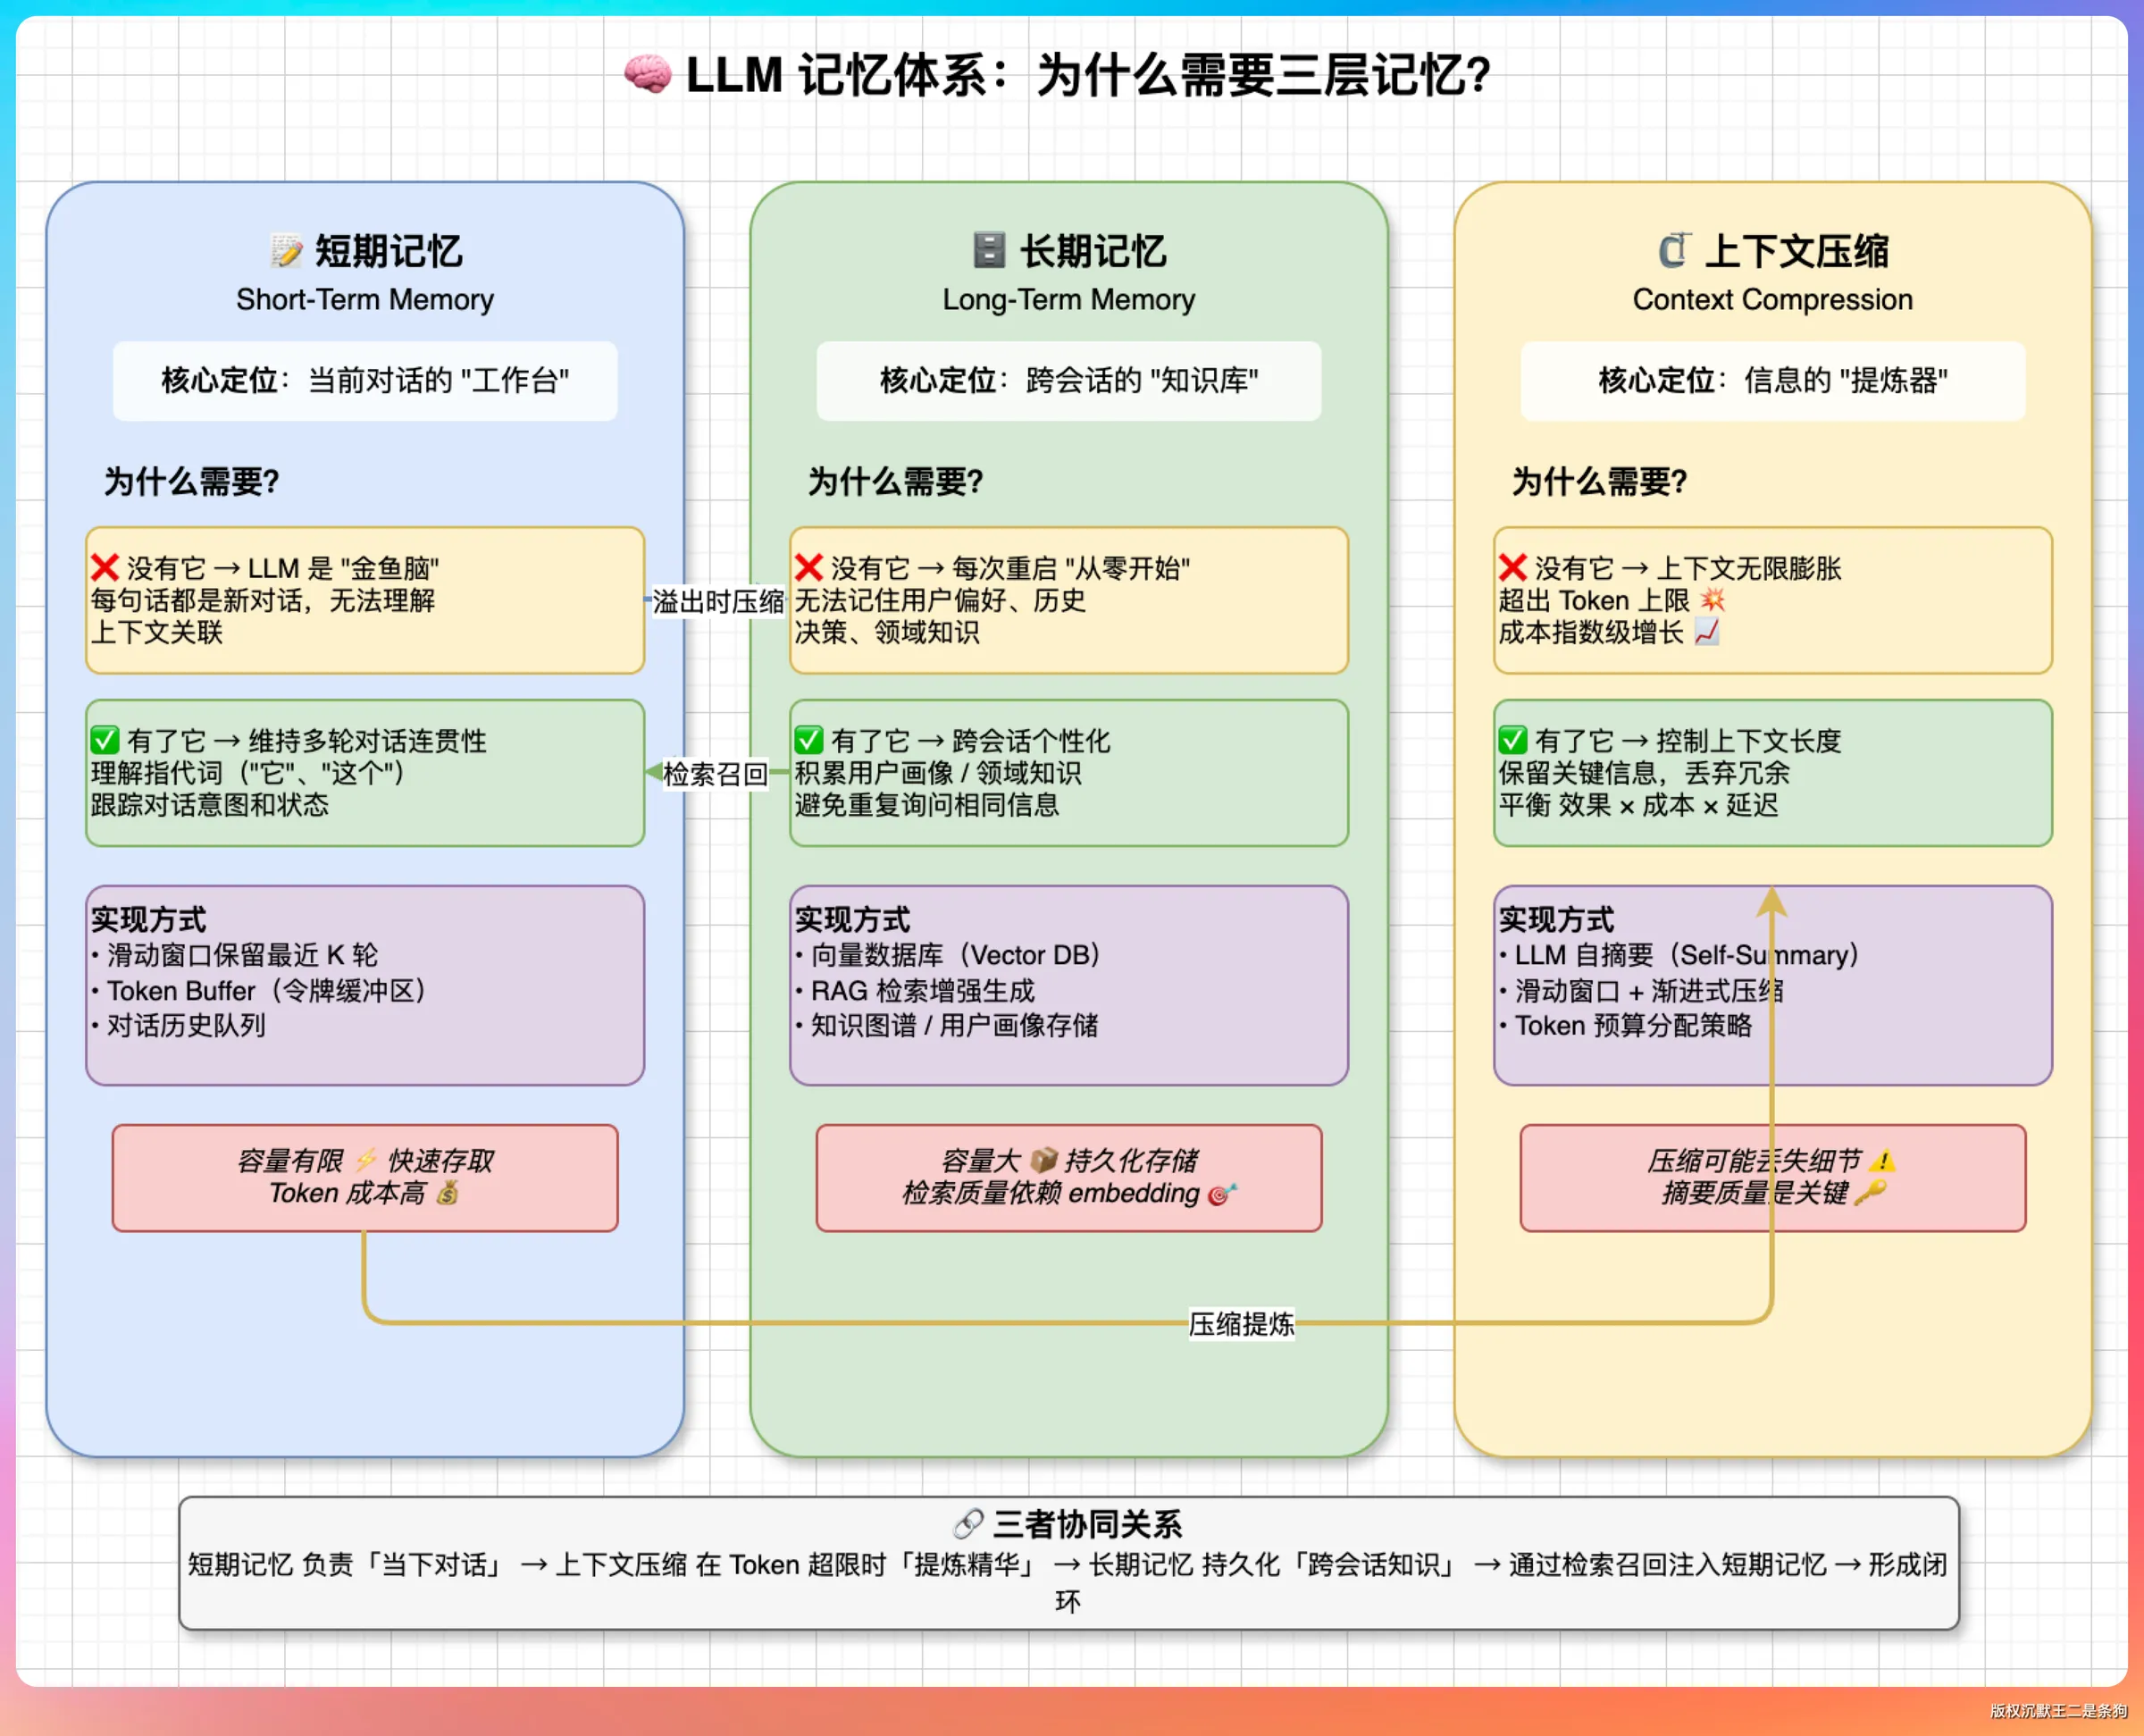
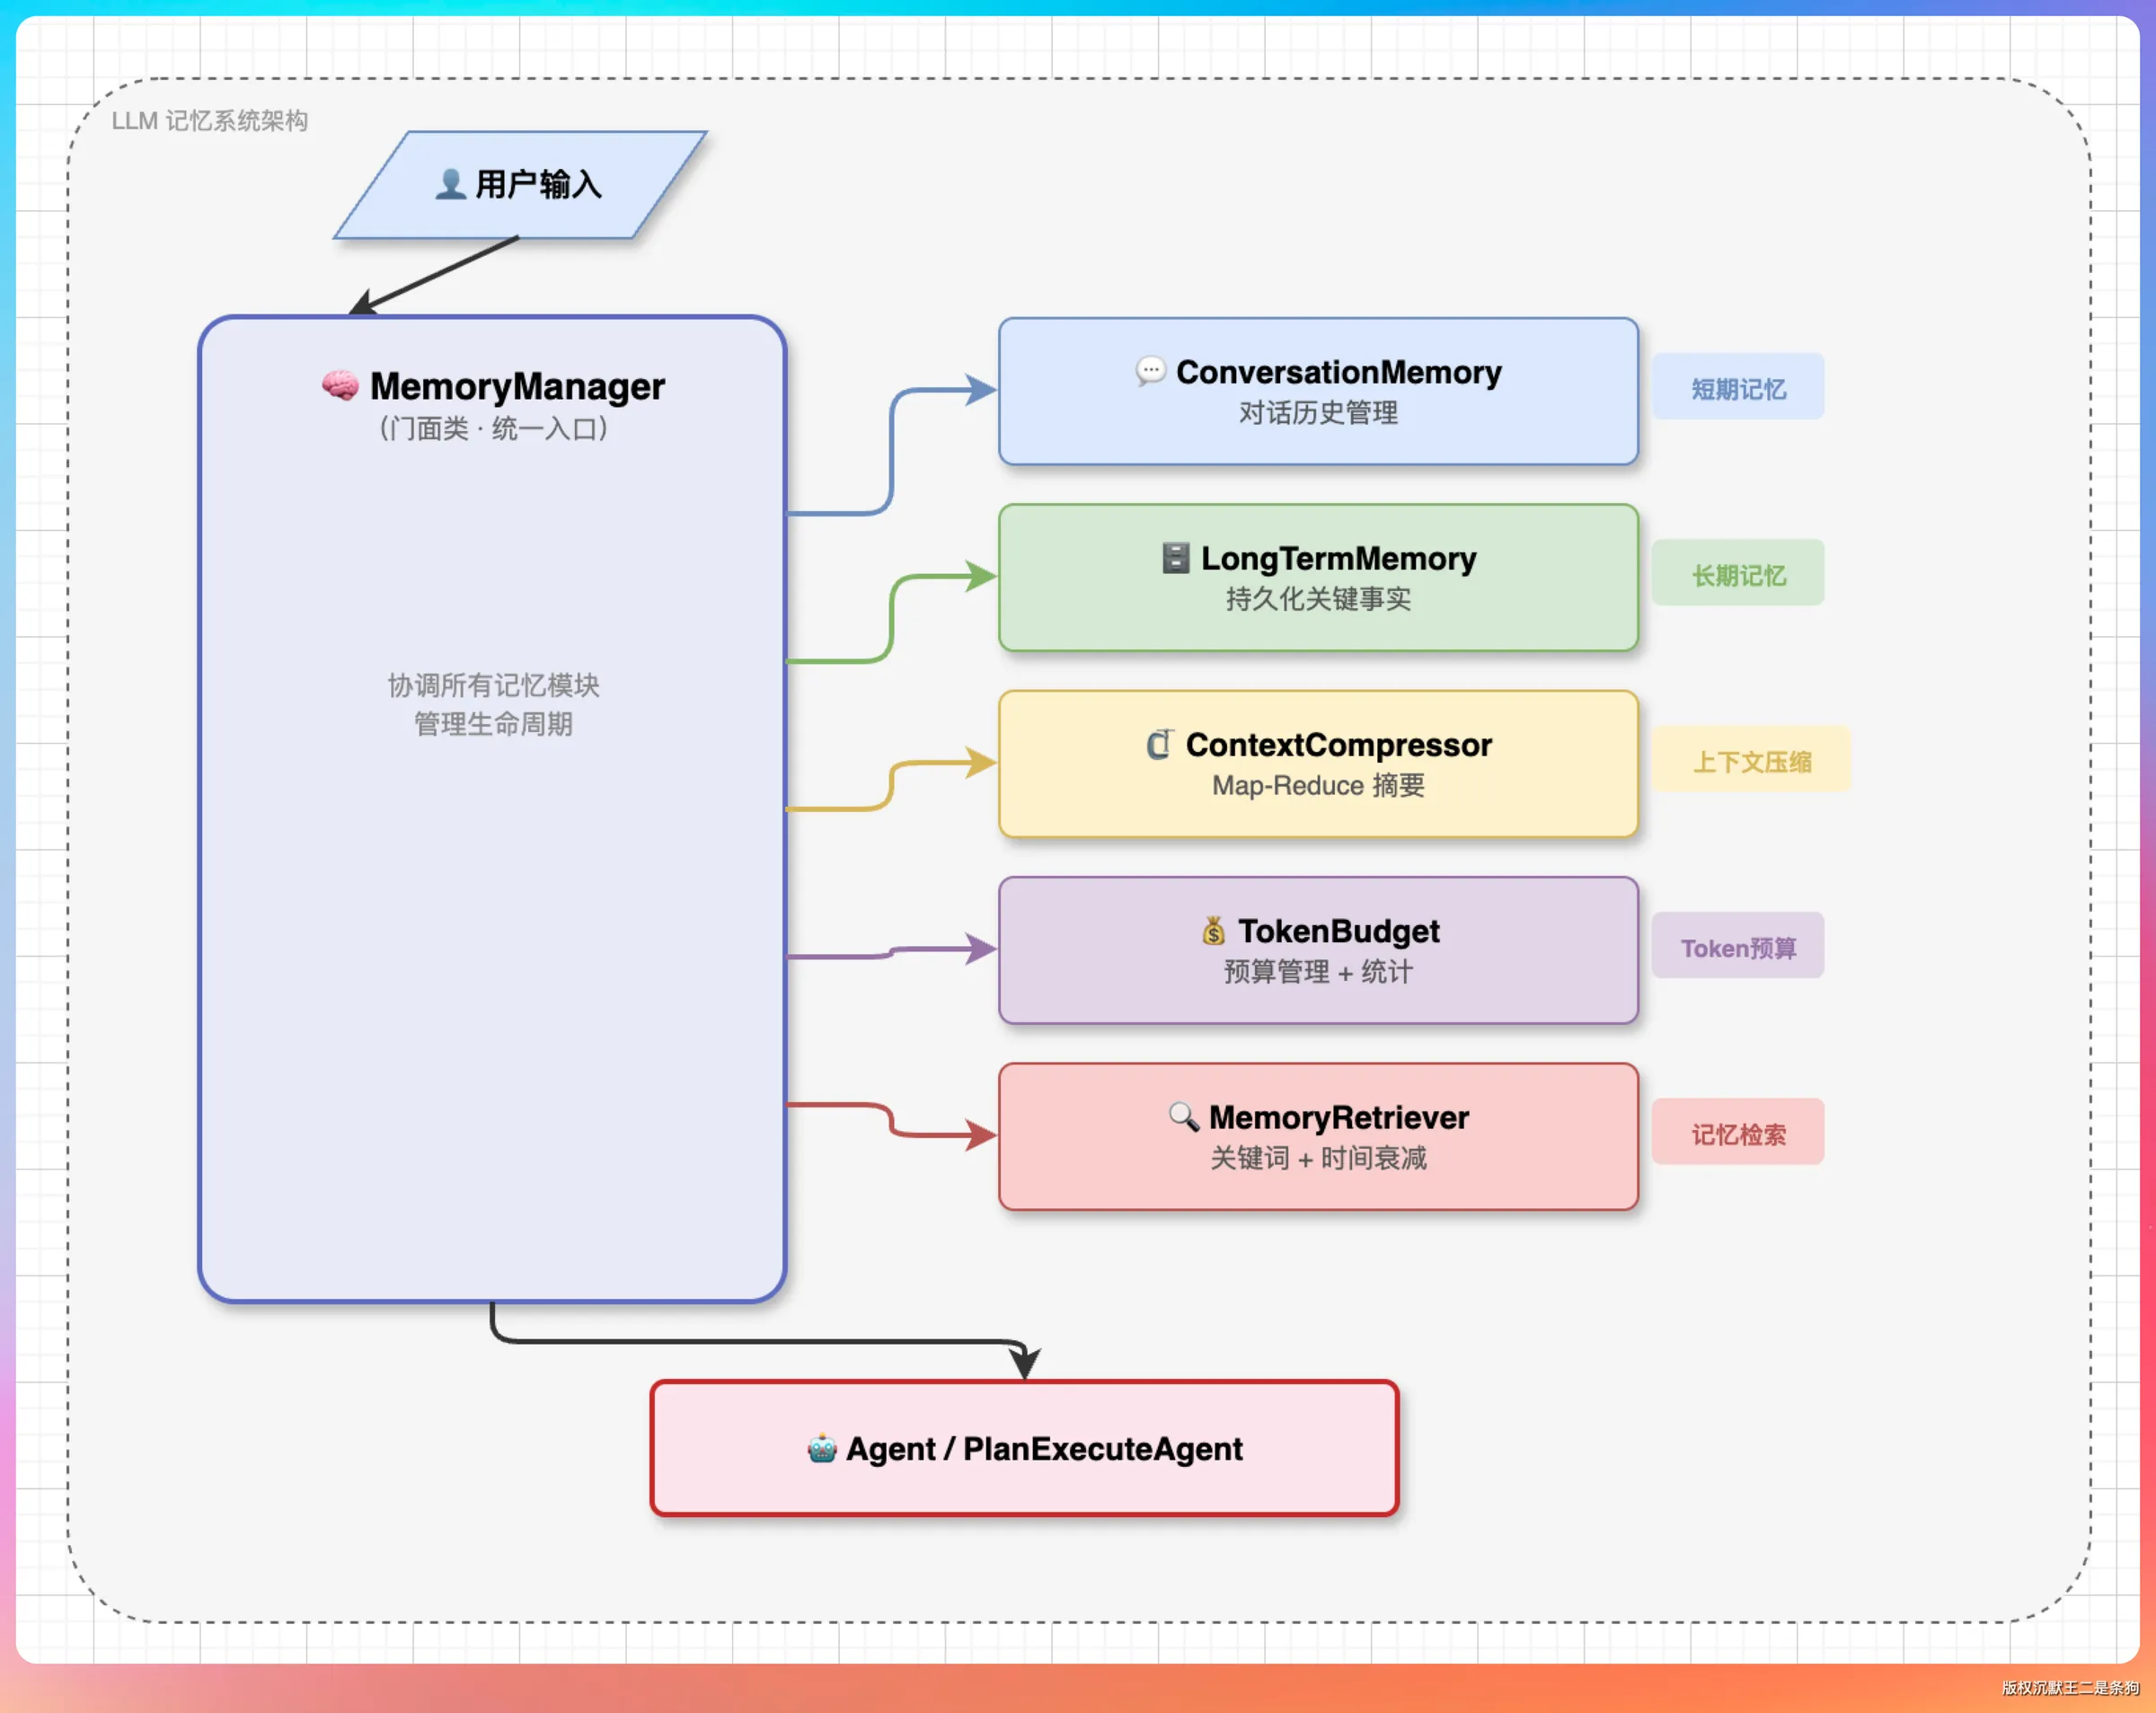
# Agent记忆系统的完整设计LLM 本身是无状态的,每次请求独立,不记得上一轮内容。要让 Agent“记住”用户偏好和上下文,需要三层设计: ## 一、三大核心模块**1.短期记忆** -管理当前对话上下文:用户输入、工具返回、Agent决策- token预算有限,超出时自动淘汰最旧的消息(FIFO策略,类似页面置换) -被淘汰的消息不直接丢弃,转为摘要等待重新注入**2.长期记忆** -跨会话持久化关键信息(用户偏好、项目技术栈、代码约定)到磁盘-每次存储即持久化,启动时自动加载-支持自动去重,内容相同的直接跳过-检索用 jieba 分词 + 关键词匹配(后续可升级为 Embedding 向量检索) **3.上下文压缩** - 采用 **Map-Reduce策略**:旧消息按每5 条一组分别生成摘要,再合并- 最近3轮消息不压缩,原样保留(当前任务核心上下文) - 对话结束时自动提取关键事实存入长期记忆## 二、辅助模块- **TokenBudget**:预算分配器,为系统提示词、工具定义、模型回复预留空间,对话历史超80%预算触发压缩- **MemoryRetriever**:按相关度检索(关键词匹配 +24h 时间衰减 +长期记忆1.2倍加权),只注入最相关的记忆- **MemoryManager**:门面模式,统一协调以上组件,Agent 只管“存消息、取记忆” ## 三、记忆类型划分每条记忆分四类:CONVERSATION(对话)、FACT(事实)、SUMMARY(摘要)、TOOL_RESULT(工具结果)。工具结果单列是因为内容长,压缩时可更激进地裁剪。 **核心思想**:记住什么(短期记忆)、忘掉什么(压缩淘汰)、想起什么(检索注入)。
点赞
回复 取消回复

目录