杠精派
派聪明
0/512

热门评论

贪玩的月亮 2026年07月20日 10:16
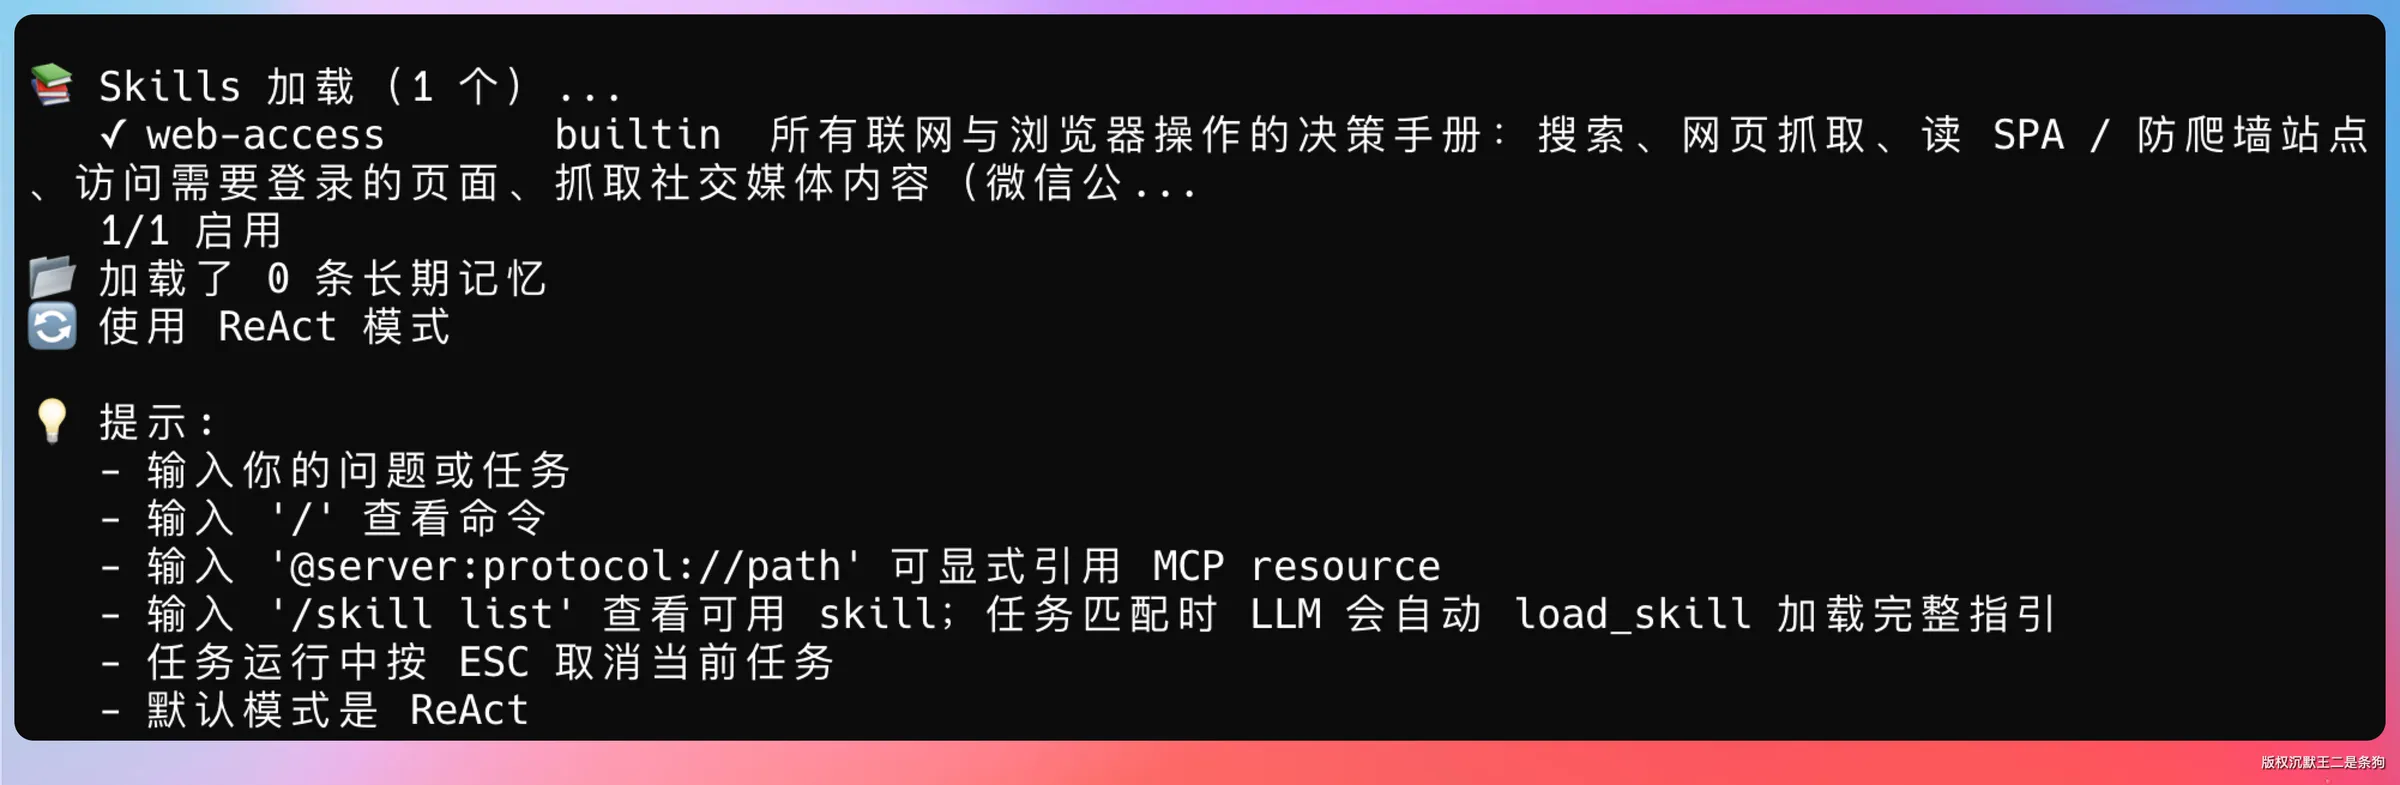
引用原文:内置的 references 在 PaiCLI 启动时由 SkillBuiltinExtractor 从 jar 包解压到 ~/.paicli/skills-cache/web-access/references/。
@派聪明 为什么要将内置的references从jar包解压到用户目录下呢
点赞
回复10 取消回复
派聪明 2026年07月20日 10:16
这个设计主要有三个核心原因: **1. 让 Agent 能够直接读取文件内容** LLM 是通过 `read_file` 工具来获取站点经验的。如果 references 留在 jar 包里(二进制压缩包),Agent 无法直接读取。解压到用户目录下的 `~/.paicli/skills-cache/` 后,Agent 才能通过 `read_file("~/.paicli/skills-cache/web-access/references/site-patterns/mp.weixin.qq.com.md")` 获取对应站点的操作经验,比如知道微信公众号是 SPA 渲染、必须走 CDP 浏览器。 **2. 支持用户自定义和扩展** 解压到用户目录后,用户可以随时查看、修改甚至补充这些经验文件。比如你可以给某个站点添加新的 CSS 选择器或 JS 提取片段,Agent 下次就能用上。如果留在 jar 包里,用户想改就必须重新打包,根本不现实。 **3. 版本化缓存机制,提升启动性能** extractor 并非每次启动都解压——它会检查 `skills-cache/<name>/.version` 文件与 jar 内置版本号是否一致。一致就跳过,不一致或文件不存在时才重写整个 cache 目录。这样既保证了内置经验能随版本更新,又避免了每次启动都解压带来的 IO 开销,**一举两得**。
点赞
回复 取消回复
展开剩余 9 条回复

68 条评论

dafengbaicha 2026年09月21日 15:45
@派聪明 当前skill加载是否有时序问题呢
点赞
回复1 取消回复
派聪明 2026年09月21日 15:45
# PaiCLI Skill 加载的时序分析根据参考资料,Skill 加载的整体时序是清晰设计的,但存在几个值得注意的点: ##✅ 设计上已处理的时序问题**1. 三层扫描顺序固定** `SkillRegistry` 按 builtin → user → project顺序扫描,同名 Skill 后者覆盖前者,顺序是确定的,不存在竞态。 **2.热重载不打断当前调用** `/skill reload` 只影响下一轮对话,不会打断正在进行的 LLM调用,避免了运行中上下文不一致的问题。 **3.按需加载避免启动阻塞** Skill body 不在启动时塞入 system prompt,LLM调用 `load_skill` 后,body 在**下一轮**才注入 user message。这是刻意设计的时序: ``` 第 N轮:LLM调用 load_skill("web-access") ↓工具只返回简短确认,body 进入 SkillContextBuffer第 N+1轮:user message前拼上 "## 已加载 Skill"段落``` ##⚠️ 可能存在的时序边界问题**1. 加载后需“隔轮”生效** `load_skill` 的返回结果不含 body,指引要到下一轮才出现。如果 LLM期望当轮就按指引行动,可能出现一轮“空转”(只确认加载、未实际执行任务)。 **2.一次性消费 +跨轮记忆依赖** buffer 的 `drain()` 取出后即清空,下一轮 user message 不再携带 Skill body。LLM 必须“记得”之前读过的指引。在长对话中上下文截断后,可能出现遗忘指引、重复决策失误的情况(尽管 system prompt提示“同一会话内一次足够”)。 **3.调试时的时序陷阱** 修改 SKILL.md 后,必须先 `/clear` 清空旧 buffer,再 `/skill reload`,顺序错了 Agent 读到的可能是旧内容。 **总结**:核心加载时序(三层覆盖、热重载、渐进式披露)设计合理,主要风险点在于 body 注入的“隔轮生效”和一次性消费机制对 LLM记忆能力的依赖。
点赞
回复 取消回复
。 2026年09月13日 21:26
引用原文:y 的完整内容。body 是在下一轮构造 user message 时,从 buffer 里取出来拼到用户输入的前面
@派聪明,意思是用户提出一个问题,llm判断需要load-skill,工具加载出来的skill正文不会在本轮中让llm看到, 而是在下一次用户又发送一个问题时才会让llm看到这个skill吗
点赞
回复5 取消回复
派聪明 2026年09月13日 21:27
不完全是。这里的“下一轮”指的是 LLM 的**下一个交互回合(下一轮 agent loop)**,而不是等用户再提一个新问题。 实际流程是这样: 1. 用户发问,LLM判断需要 skill,调用 `load_skill("web-access")`工具2.工具立即执行,返回一条**简短确认**:“已加载 skill完整指引(3.2KB),将在下一轮上下文中体现”——此时 body 内容确实还没给 LLM 看到3.工具执行完后,控制权**立刻回到 LLM**,进入下一轮推理。这时 PaiCLI构造新的 user message(工具结果),并从 SkillContextBuffer 取出 body拼在前面: ``` ## 已加载 Skill:web-access<SKILL.md body完整内容> --- 用户输入:<原始消息> ``` 4. 所以 LLM 在同一个任务的紧接着的下一次调用中就能看到 skill 正文,然后按指引继续行动(比如先 web_fetch、失败再切 Chrome DevTools) 也就是说,用户只问了一次问题,LLM 内部经历了多轮“思考→调用工具→看结果→继续思考”的循环,skill 正文在工具调用后的**下一次模型调用**中就已经生效了,无需用户再发消息。 关键点在于**工具的返回结果本身不含 body**,body 通过 SkillContextBuffer 注入到下一轮 user message 中——这样设计一是因为 user message里的内容 LLM 会当作“指令”对待,决策权重更高;二是避免修改 system prompt 导致 prompt cache失效。
点赞
回复 取消回复
展开剩余 4 条回复
Next Station Ashore 2026年09月13日 16:05
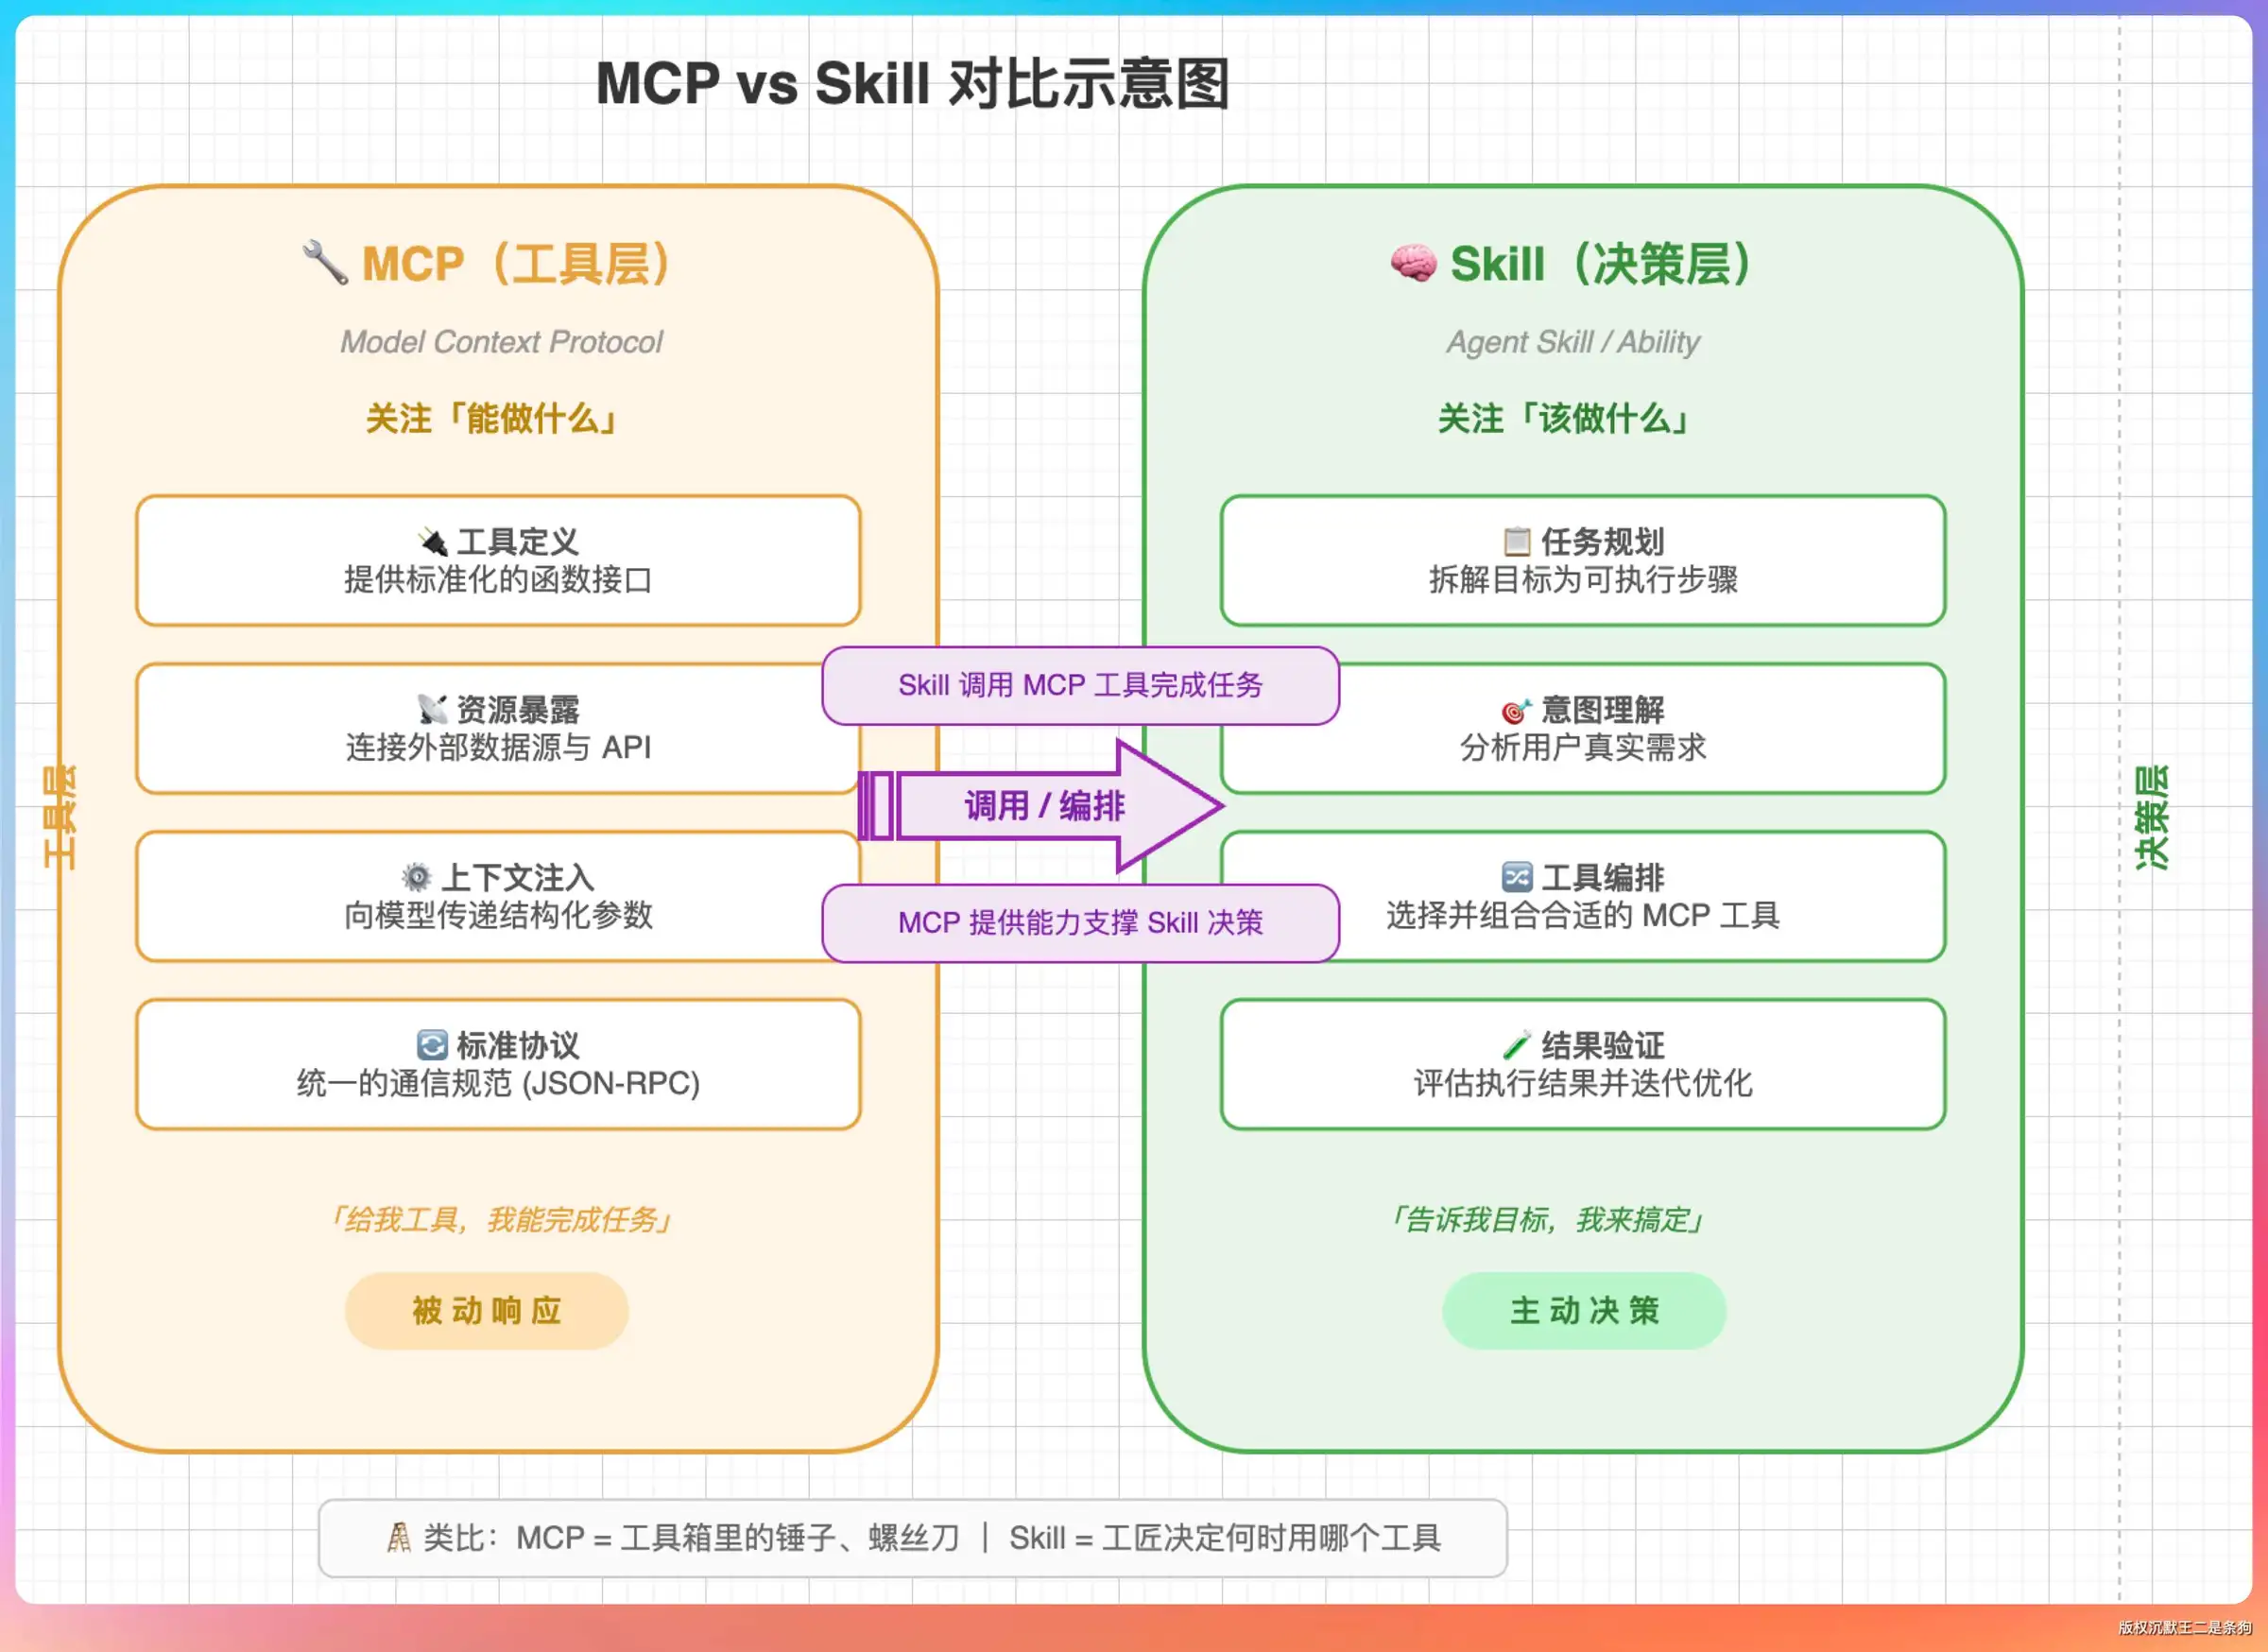
引用原文:Skill 提供的是决策
这不是LLM的功能吗?
点赞
回复 取消回复
忐忑的羽毛 2026年09月06日 15:35
引用原文:Jina Reader(curl https://r.jina.ai/<url>)
@派聪明,这是什么意思
点赞
回复1 取消回复
派聪明 2026年09月06日 15:35
这是文章中提到的**网页抓取兜底方案**。 **含义拆解:** - `r.jina.ai` 是 Jina AI提供的一个免费网页转 Markdown 服务- 使用方式很简单:在命令行把目标网页的 URL拼接在 `https://r.jina.ai/` 后面,用 curl请求即可**举例:** ```bashcurl https://r.jina.ai/https://mp.weixin.qq.com/s/xxxxx``` 返回的结果是网页正文的 Markdown 文本,Agent 可以直接阅读。 **为什么需要它(兜底地位):** 文章中 Agent抓网页的优先级是三层递进的: 1. 先用 `web_fetch` 直接抓(成本最低) 2.抓不到就上 Chrome DevTools MCP 用浏览器渲染3.浏览器也搞不定的(如反爬极强的站点),才走 Jina Reader兜底——因为它本质是第三方代抓服务,由 Jina 的服务器帮你请求并解析网页,能绕过一些本地抓取失败的情况。 简单说:这是 web-access Skill决策手册里“最后一张底牌”,当前两个工具都失败时用来保证仍能拿到网页内容。
点赞
回复 取消回复
是你啊 2026年08月31日 17:27
引用原文:重新启用一个被禁用的 Skill
@派聪明 这些命令都怎末实现的 为啥输入/skill 能有对应的操作
点赞
回复1 取消回复
派聪明 2026年08月31日 17:27
# /skill命令的实现原理输入 `/skill` 能触发对应操作,是因为 CLI工具在读取用户输入后有一个**命令路由分发机制**,整体流程如下: ##1.输入拦截:斜杠命令优先于 LLM当你在 PaiCLI输入内容时,程序首先判断输入是否以 `/` 开头: - **是斜杠命令**(如 `/skill list`)→走本地命令处理逻辑,**不会发给 LLM** - **普通文本** → 作为对话消息发给大模型##2.命令解析:拆分命令名和参数输入 `/skill off web-access`会被解析为: -命令组:`skill` - 子命令:`off` - 参数:`web-access` 程序根据命令组名查表(类似 `Map&lt;String, CommandHandler&gt;` 的注册表),找到对应的处理器执行。 ##3. 以 `/skill on` 为例的具体实现“重新启用一个被禁用的 Skill” 的操作流程: 1. **接收参数**:拿到 Skill 名称 `web-access` 2. **读取状态文件**:加载 `~/.paicli/skills.json`,内容形如 `{&quot;disabled&quot;: [&quot;web-access&quot;]}` 3. **修改状态**:把 `web-access` 从 `disabled` 数组中移除4. **写回文件**:持久化保存,所以重启后禁用/启用状态仍然生效5. **输出反馈**:提示用户该 Skill 已启用##4. 其他子命令对应的操作|命令 |实现逻辑 | |------|---------| | `/skill list` |调用 `SkillRegistry`扫描三层目录(builtin/user/project),列出所有 Skill 及状态 | | `/skill show &lt;name&gt;` |读取并展示 SKILL.md完整内容(frontmatter + body) | | `/skill off &lt;name&gt;` | 把名称写入 skills.json 的 disabled列表,索引和 load_skill 都不再可见 | | `/skill reload` |重新扫描三层目录,热加载新增/修改的 Skill,只影响下一轮对话 | **核心思想**:斜杠命令是纯本地逻辑(读写文件、操作内存中的注册表),执行速度快、结果确定,不需要也不应该消耗 LLM 的 token;而自然语言对话才交给大模型
点赞
回复 取消回复
是你啊 2026年08月31日 17:26
引用原文:禁用一个 Skill
这些命令都怎末实现的 为啥输入/skill 能有对应的操作
点赞
回复 取消回复
是你啊 2026年08月31日 09:58
引用原文:builtin → user → project
@派聪明 这几个分别是啥意思
点赞
回复1 取消回复
派聪明 2026年08月31日 09:58
# Skill 三层加载架构这是 PaiCLI 的 Skill系统按优先级从低到高的三层加载顺序: **1. builtin(内置层)** 打包在 PaiCLI 的 jar 包里,随版本一起发布。目前内置了 `web-access` Skill,教 Agent 如何做联网操作(搜索、抓网页、用浏览器)。 **2. user(用户级)** 放在 `~/.paicli/skills/&lt;name&gt;/SKILL.md`。存放用户自己写的全局 Skill,所有项目都能使用。 **3. project(项目级)** 放在 `&lt;项目目录&gt;/.paicli/skills/&lt;name&gt;/SKILL.md`。针对特定项目的 Skill,**优先级最高**。 ## 加载规则扫描时按 **builtin → user → project** 的顺序处理,每扫到一个**同名 Skill 就直接覆盖前一层**的。也就是说: &gt; project覆盖 user,user覆盖 builtin例如:内置的 `web-access` 是 builtin 来源,如果你在 `~/.paicli/skills/web-access/` 下创建同名 Skill,`/skill reload` 后来源就会从 `builtin`变成 `user`,覆盖生效。 这样设计的好处是:默认开箱即用(内置),个人偏好可全局定制(用户级),特定项目还能进一步精细覆盖(项目级)。
点赞
回复 取消回复
Lee 2026年08月06日 19:53
引用原文: Jina Reader
@杠精派 @派聪明 这是什么
点赞
回复1 取消回复
杠精派 2026年08月06日 19:53
小派正在努力回答中, 耐心等待一下吧...
点赞
回复 取消回复
Lee 2026年08月06日 19:53
引用原文: Jina Reader
@派聪明 这是什么
点赞
回复1 取消回复
派聪明 2026年08月06日 19:53
小派正在努力回答中, 耐心等待一下吧...
点赞
回复 取消回复
Lee 2026年08月06日 19:53
引用原文: Jina Reader
@派聪明 这是什么
点赞
回复1 取消回复
派聪明 2026年08月06日 19:53
小派正在努力回答中, 耐心等待一下吧...
点赞
回复 取消回复

目录