杠精派
派聪明
0/512

热门评论

んuyunlong💋 2026年09月20日 00:11
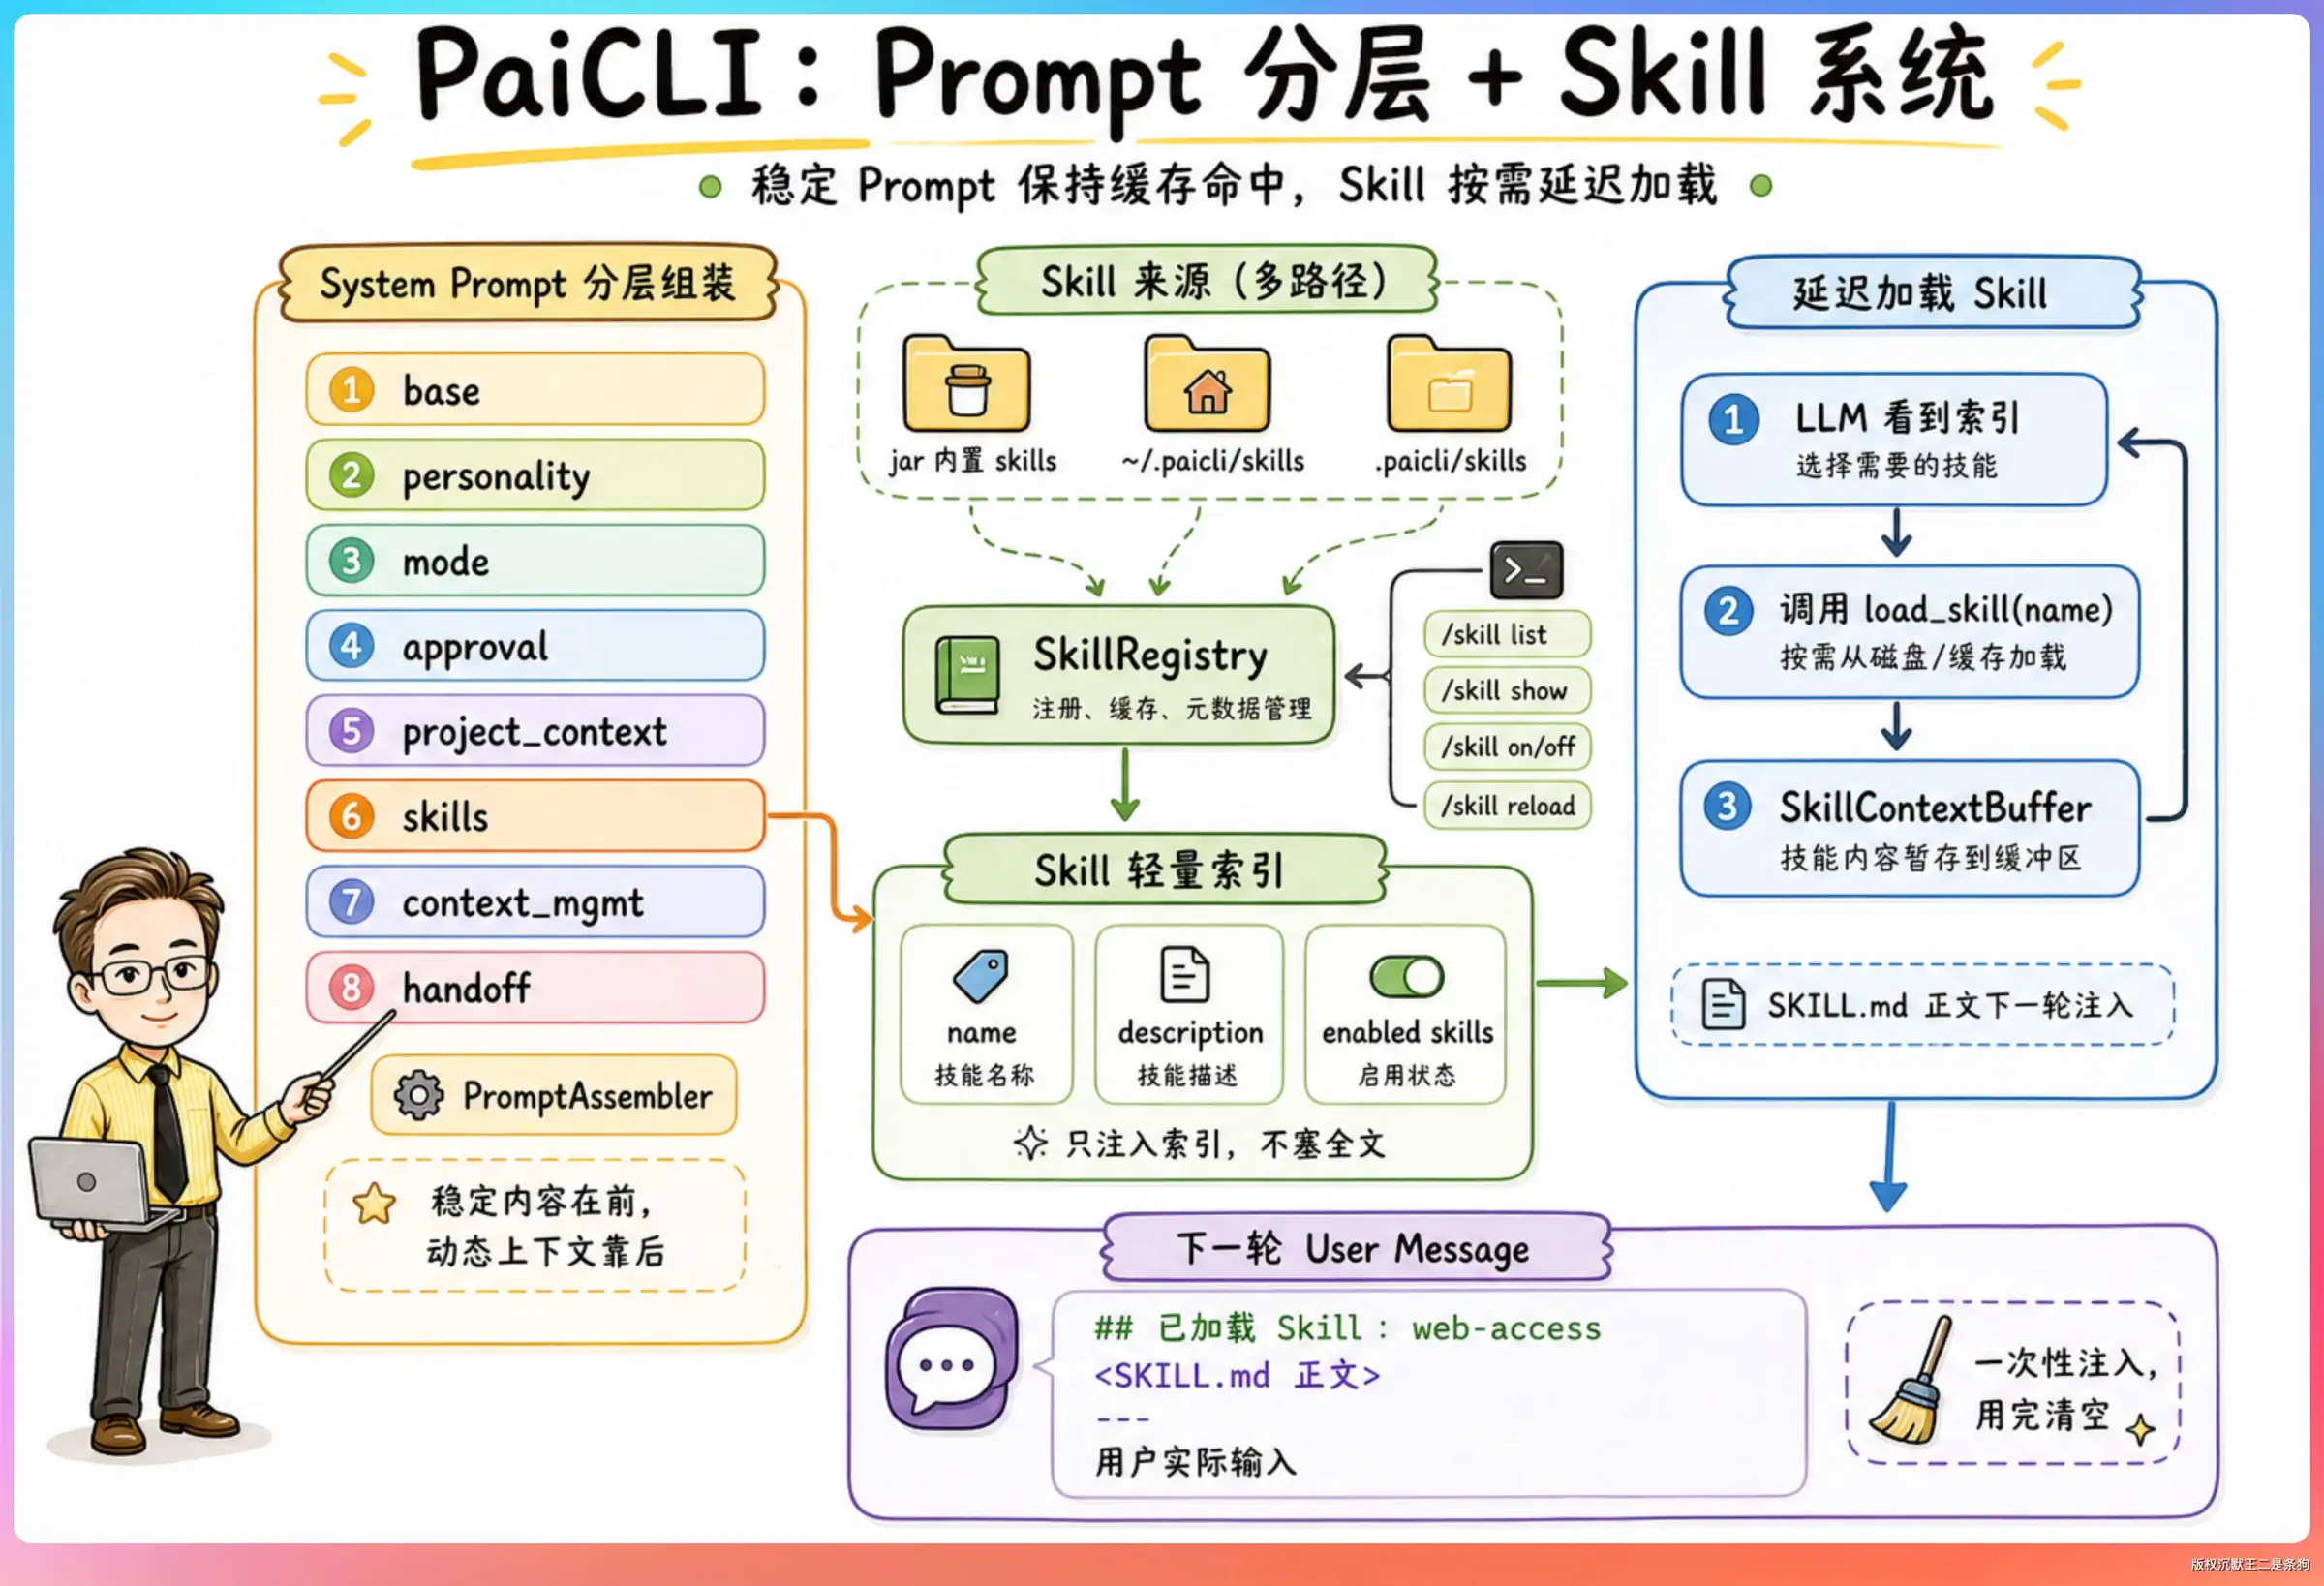
引用原文:,在下一轮对话时前置注入到 user message 前面。注入是一次性的,取出后自动清空,不会跨轮重复注入。
@杠精派 为什么要下轮对话才注入,而不是Agent loop循环中调用 load_skill后注入到message 列表里面,以user的身份在当前轮次注入
点赞
回复11 取消回复
杠精派 2026年09月20日 00:11
谁说不能当前轮注入?你这就是把一个工程取舍当成了唯一真理来杠。😅首先,“下一轮注入”不是能力缺陷,是设计选择。当前轮如果中途硬插一条 user message,你猜会怎样?模型正在生成的回复逻辑突然被一条“半路杀出”的指令打断,上下文连贯性直接碎一地。你以为你在“及时补信息”,实际上是在污染当前轮的推理链路,模型可能前面刚说“我没有这个技能的细节”,后面突然收到技能文档,输出自相矛盾,这种撕裂感谁负责? 其次,以 user 身份当前轮注入,你考虑过对话历史的完整性吗?Agent loop 里 load_skill 之后消息列表顺序就乱了:user→assistant(带工具调用)→tool result→又一条“伪 user”→assistant 继续。这历史记录回放给谁看?后续模型重读这段历史时,会以为用户中途插话了,指令遵循的归因全乱套。下一轮前置注入,历史干净、归因清晰,这才是对齐“user 发起内容”的语义边界——技能内容本质上是系统供给的上下文,不是用户真实意图。 再者,“取出后自动清空、不跨轮重复”这个一次性机制恰恰说明设计者想清楚了:避免技能文档在每一轮都占 token。如果改成当前轮注入,你打算每次 load 都塞一遍吗?上下文窗口是免费的? 所以结论是:不是“为什么要下轮才注入”,而是“你为什么只想得到当前轮注入这一种做法”?工程上很多看似‘更及时’的方案,代价是上下文污染和历史混乱。慢一拍,稳一生。🤷
点赞
回复 取消回复
展开剩余 10 条回复

62 条评论

んuyunlong💋 2026年09月20日 00:11
引用原文:,在下一轮对话时前置注入到 user message 前面。注入是一次性的,取出后自动清空,不会跨轮重复注入。
@杠精派 为什么要下轮对话才注入,而不是Agent loop循环中调用 load_skill后注入到message 列表里面,以user的身份在当前轮次注入
点赞
回复11 取消回复
杠精派 2026年09月20日 00:11
谁说不能当前轮注入?你这就是把一个工程取舍当成了唯一真理来杠。😅首先,“下一轮注入”不是能力缺陷,是设计选择。当前轮如果中途硬插一条 user message,你猜会怎样?模型正在生成的回复逻辑突然被一条“半路杀出”的指令打断,上下文连贯性直接碎一地。你以为你在“及时补信息”,实际上是在污染当前轮的推理链路,模型可能前面刚说“我没有这个技能的细节”,后面突然收到技能文档,输出自相矛盾,这种撕裂感谁负责? 其次,以 user 身份当前轮注入,你考虑过对话历史的完整性吗?Agent loop 里 load_skill 之后消息列表顺序就乱了:user→assistant(带工具调用)→tool result→又一条“伪 user”→assistant 继续。这历史记录回放给谁看?后续模型重读这段历史时,会以为用户中途插话了,指令遵循的归因全乱套。下一轮前置注入,历史干净、归因清晰,这才是对齐“user 发起内容”的语义边界——技能内容本质上是系统供给的上下文,不是用户真实意图。 再者,“取出后自动清空、不跨轮重复”这个一次性机制恰恰说明设计者想清楚了:避免技能文档在每一轮都占 token。如果改成当前轮注入,你打算每次 load 都塞一遍吗?上下文窗口是免费的? 所以结论是:不是“为什么要下轮才注入”,而是“你为什么只想得到当前轮注入这一种做法”?工程上很多看似‘更及时’的方案,代价是上下文污染和历史混乱。慢一拍,稳一生。🤷
点赞
回复 取消回复
展开剩余 10 条回复
忐忑的羽毛 2026年09月12日 14:34
引用原文:Multi-Agent 模式下,Planner、Worker、Reviewer 各持一个独立的缓冲区实例,避免角色间的提示词污染。
@派聪明,请你详细解释一下
点赞
回复1 取消回复
派聪明 2026年09月12日 14:34
#详解:Multi-Agent模式下的独立缓冲区设计## 背景:Skill缓冲区是什么PaiCLI 中,Skill(决策手册)采用延迟加载机制:LLM调用 `load_skill(name)` 后,Skill 正文先写入一个**缓冲区(buffer)**,然后在下一轮对话时前置注入到 user message 前,且注入是一次性的,取出后自动清空。 ##为什么要“各持一个独立缓冲区实例” 在 Multi-Agent模式下,系统中有多个角色同时工作: - **Planner**:负责任务规划拆解- **Worker**:负责具体执行任务- **Reviewer**:负责审查 Worker 的产出每个角色背后是独立的 LLM 会话,各有自己的上下文和 system prompt。 **如果三个角色共享同一个缓冲区,会出现“提示词污染”问题:** 1. **串台注入**:假设 Worker(正在做网页抓取任务)加载了 `web-access` Skill,正文进入缓冲区。下一轮如果是 Planner 发起请求,共享缓冲区会把这份“网页抓取决策手册”错误地注入给 Planner——但 Planner 只做规划,根本不需要这个 Skill 的内容。 2. **无关上下文干扰**:每个角色收到的应该是与自己职责匹配的提示词。被注入不相关的 Skill 内容,不仅浪费 token,还可能误导 LLM 的决策(比如 Reviewer被注入抓取经验后,开始对代码审查任务给出联网建议)。 3. **并发写入混乱**:异步工具调用可能在不同线程触发 `load_skill`,多个角色共用一个缓冲区,写入内容会互相覆盖、顺序错乱。 ## 解决方案让 Planner、Worker、Reviewer **各自持有一个独立的缓冲区实例**: - Worker 加载的 Skill 只进入 Worker 自己的缓冲区,只在 Worker 的下一轮对话中注入- Planner 和 Reviewer 的上下文完全不受影响-每个角色的提示词空间保持“干净”,职责边界清晰这与缓冲区本身做的 `synchronized`线程安全处理相配合,既解决了**并发安全**问题(同角色内多线程写入),又解决了**角色隔离**问题(不同角色互不干扰)。 **一句话总结**:独立缓冲区本质上是一种**上下文隔离机制**,确保每个 Agent角色只接收到自己真正需要的 Skill指引,防止
点赞
回复 取消回复
忐忑的羽毛 2026年09月12日 14:26
引用原文:ffer 会随着工具调用持续膨胀。 PaiCLI 的做法是最多保留 3 个 Skill,超出后按加载顺序淘汰最早
@派聪明,进入到SkillContextBuffer中的已加载的skill不是用完(即注入到下一轮user message中)就直接清空了吗?那这里为什么还要用一个LRU淘汰呢?最早被使用的还在这个ConTextBuffer中的不是早就被清空了了吗?为什么还要再使用LRU机制来淘汰呢?
点赞
回复1 取消回复
派聪明 2026年09月12日 14:26
这是个好问题,关键在于区分「**注入内容的消费**」和「**Skill 条目的留存**」这两件事。 ## 两者的区别**「取出后自动清空」清的是内容注入状态,不是删掉整个条目。** SkillContextBuffer 里实际有两层东西: 1. **注入用的正文内容**:load_skill 加载的 SKILL.md 正文放进缓冲区,下一轮注入到 user message前面后,这部分内容被标记为已消费、自动清空——目的是**避免同一份正文跨轮重复注入**,浪费 token。 2. **Skill 的条目记录(name等元信息)**:这个条目本身仍然留在缓冲区里。它有作用: - 后续轮次 LLM 再次需要这个 Skill 时,不需要重复调用 `load_skill`,或者至少能知道它已被加载过; -记录加载顺序,供容量控制使用。 ## 为什么条目要留着,从而需要 LRU如果条目也在注入后立刻删除,那么每次任务涉及同一 Skill 的多轮对话,LLM 就得反复调用 `load_skill`、反复注入正文,反而增加开销。 但条目一直留着,又会随工具调用无限膨胀。所以需要一个上限(最多3 个),超出时淘汰最早加载、大概率已经用完的那个——这就是 LRU 的作用。 **简单总结:** - LRU淘汰的是「缓冲区中长期留存、占用容量的 Skill 条目」; - 「注入后清空」清的是「一次性注入的正文内容」; -两者作用对象不同,并不矛盾。LRU管的是“名单还能记几个”,一次性消费管的是“正文不会重复注入”。
点赞
回复 取消回复
忐忑的羽毛 2026年09月12日 11:40
引用原文:缓冲区,在下一轮对话时前置注入到 user message 前面。
@派聪明,为什么要下轮对话才注入,而不是Agent loop循环中调用 load_skill后注入到message 列表里面,以user的身份注入
点赞
回复1 取消回复
派聪明 2026年09月12日 11:40
这是一个很好的问题,核心原因有几个: **1. Agent loop 的执行流约束** 在 Agent loop 的单次循环中,LLM 发起 `load_skill` 是一次 tool call,工具返回值会作为 tool result 回到 message列表。如果直接把几千 token 的 SKILL.md 全文塞进 tool result,会带来问题:工具返回值本来应该轻量、结构化(成功/失败/摘要),塞入大段决策手册会让 tool result语义混乱。 **2. 注入时机与“消费时机”匹配** LLM调用 `load_skill` 的那一轮,只是“声明需要”,它还没开始基于 Skill 内容做决策。真正需要消化 SKILL.md的是**下一轮推理**。把内容写入缓冲区,在下轮对话前置注入到 user message 前,恰好让 Skill 内容出现在 LLM 下一次推理的上下文开头位置,符合“加载知识 → 再思考”的顺序。 **3.避免破坏当前轮的结构** 如果在循环中间直接以 user 身份插入一条“这是 Skill 内容”的 message,相当于在 tool call → tool result 的流程中插入了一段伪用户输入,LLM 可能误以为用户发了新指令,干扰当前轮的任务执行。前置注入到下轮 user message前面,则是一种约定俗成的“上下文附加”位置,LLM 能正确理解它是指引而非指令。 **4.一次性消费、不重复注入** 缓冲区设计配合“读取后清空”,保证 Skill 正文只注入一次,不会跨轮重复占用 token。如果直接在 message列表里追加,很难做这种去重和容量控制(配合最多保留3 个的 LRU淘汰)。 **5.线程安全与多 Agent隔离** 异步工具调用可能在不同线程触发 load_skill,通过缓冲区中转(synchronized),Multi-Agent模式下各角色持有独立缓冲区,避免了直接操作共享 message列表带来的提示词污染。 简单说:**load_skill 是“取餐”,缓冲
点赞
回复 取消回复
忐忑的羽毛 2026年09月12日 10:09
引用原文:“按场景按需加载的专家手册
@派聪明,请你详细解释一下这个延迟加载skill的具体流程是什么?
点赞
回复1 取消回复
派聪明 2026年09月12日 10:09
# Skill延迟加载的具体流程“按场景按需加载的专家手册”指的是 Skill 不在启动时全量注入,而是运行时按需加载。具体流程如下: ## 一、启动阶段:只注入“菜单”(索引) Agent启动时,系统只把所有已启用 Skill 的 **name + description**渲染成一段索引,注入到 system prompt末尾,整个索引控制在 **4KB 以内**。 此时 LLM看到的相当于一份“菜单”——知道有哪些 Skill、各自是干什么的,但看不到完整内容。这样避免了20 个 Skill(每个2000-3000 token)一次性占掉40k-60k token 的浪费。 ## 二、运行阶段:LLM主动判断并加载1. **语义判断**:LLM根据用户输入和 description 自行判断需要哪个 Skill(不是关键词硬匹配,而是靠 LLM 的语义理解)。 2. **调用加载工具**:LLM主动调用 `load_skill(name)`工具。 3. **写入缓冲区**:Skill 的正文(SKILL.md)被写入一个缓冲区。 4. **下一轮注入**:在下一轮对话时,缓冲区内容被前置注入到 user message前面,供 LLM 参考。 ## 三、缓冲区管理机制- **一次性消费**:注入后缓冲区自动清空,不会跨轮重复注入。 - **容量控制**:最多保留3 个 Skill,超出时按 LRU(插入顺序,LinkedHashMap 实现)淘汰最早加载的那个。 - **去重刷新**:同名 Skill重复加载时,先删旧记录再插入,避免重复且刷新顺序。 - **线程安全**:异步工具调用可能在不同线程触发 load_skill,缓冲区做了 synchronized处理;Multi-Agent模式下各角色持有独立缓冲区,避免提示词污染。 ## 四、异常处理- **Skill 不存在**:返回“Skill 未找到,可用 /skill list 查看”。 - **Skill被禁用**:返回“Skill 已被禁用,可用 /skill on启用”。 错误信息作为工具返回值交给 LLM,由它决定换一个 Skill 或直接用通用知识回答,不会中断对话流程。 ## 为什么这么设计? 核心是 **token 利用率**:绝大多数场景用户一轮只需要 1-2
点赞
回复 取消回复
Zzz5503 2026年08月20日 16:30
引用原文:两种情况都是把错误信息作为工具返回值交给 LLM,由 LLM 决定下一步怎么做——可以换一个 Skill,也可以直接用通用知识回答。不会因为某个 Skill 加载失败就中断整个对话流程。
@派聪明 这一步是否很容易出现幻觉?如何避免或减少?
点赞
回复1 取消回复
派聪明 2026年08月20日 16:30
这是我从文章中选择的一段文本:"两种情况都是把错误信息作为工具返回值交给 LLM,由 LLM 决定下一步怎么做——可以换一个 Skill,也可以直接用通用知识回答。不会因为某个 Skill 加载失败就中断整个对话流程。" 这一步是否很容易出现幻觉!如何避免或减少! 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
Lee 2026年08月15日 20:57
引用原文:在下一轮对话时前置注入到 user message 前面。注入是一次性的,取出后自动清空,不会跨轮重复注入。
@派聪明 为什么要下轮对话才注入,而不是Agent loop循环中调用 load_skill后注入到message 列表里面,以user的身份注入
点赞
回复1 取消回复
派聪明 2026年08月15日 20:57
这是我从文章中选择的一段文本:"在下一轮对话时前置注入到 user message 前面。注入是一次性的,取出后自动清空,不会跨轮重复注入。" 为什么要下轮对话才注入,而不是Agent loop循环中调用 load_skill后注入到message 列表里面,以user的身份注入 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
过时的草莓 2026年08月10日 11:28
引用原文:上一轮注入过的 Skill 不会下一轮再注入一次
为什么到下一轮才进行skill注入@派聪明
点赞
回复1 取消回复
派聪明 2026年08月10日 11:28
小派正在努力回答中, 耐心等待一下吧...
点赞
回复 取消回复
清净日子 2026年08月01日 01:42
引用原文:删除旧记录再插入新记录,既避免重复,也刷新加载顺序
@派聪明 不是和一次性注入矛盾了吗?用完就消失为什么会一次性存在多个在缓存里?
点赞
回复1 取消回复
派聪明 2026年08月01日 01:42
小派正在努力回答中, 耐心等待一下吧...
点赞
回复 取消回复
清净日子 2026年08月01日 01:42
引用原文:删除旧记录再插入新记录,既避免重复,也刷新加载顺序
@派聪明 不是和一次性注入矛盾了吗?用完就消失为什么会一次性存在多个在缓存里?
点赞
回复1 取消回复
派聪明 2026年08月01日 01:42
小派正在努力回答中, 耐心等待一下吧...
点赞
回复 取消回复

目录