
用 SQLite + Embedding 给 Agent 加上 RAG,从此秒懂项目源码
大家好,我是二哥呀。
前三期我们给自研的 PaiCLI Harness 搭好了 ReAct 循环、Plan-and-Execute 任务调度和三级上下文记忆。现在 Agent 已经能接下多步任务,也能在长对话里管住上下文窗口了。
但只要把它放进一个几万行代码的真实项目里,新的问题马上就会冒出来。
比如你问它,“项目里是怎么压缩上下文的”,或者“权限拦截的逻辑写在哪”。
模型在回答之前,得先去代码库里找到相关的源码文件。怎么找?
在日常开发里,找代码通常分两种情况。
第一种情况是知道明确的类名、方法名、配置项或者报错字符串,比如想找 @Transactional 用在哪些类上,或者 AutoCompactionManager 在哪被调用。这时候用 glob_files 按文件名匹配、用 grep_code 调起底层的 ripgrep 扫描文本,几十毫秒就能定位到具体行号,既不需要提前建索引,也不会漏掉刚改过的代码。
第二种情况是用户只给了一句模糊的自然语言描述,比如“处理登录超时的地方”或者“批量算向量的逻辑”,自己也叫不出类名。这时候让模型靠猜词去跑 grep_code,往往搜上三四轮都捞不到目标代码。
所以在 PaiCLI 的 Harness 设计里,我们把两套方案结合了起来。日常找文件名、搜精确符号,优先走 4 路并行的 glob_files、grep_code 和 read_file;遇到模糊的自然语言提问,或者普通搜索无果时,就调用 search_code 走本地 RAG 混合检索。
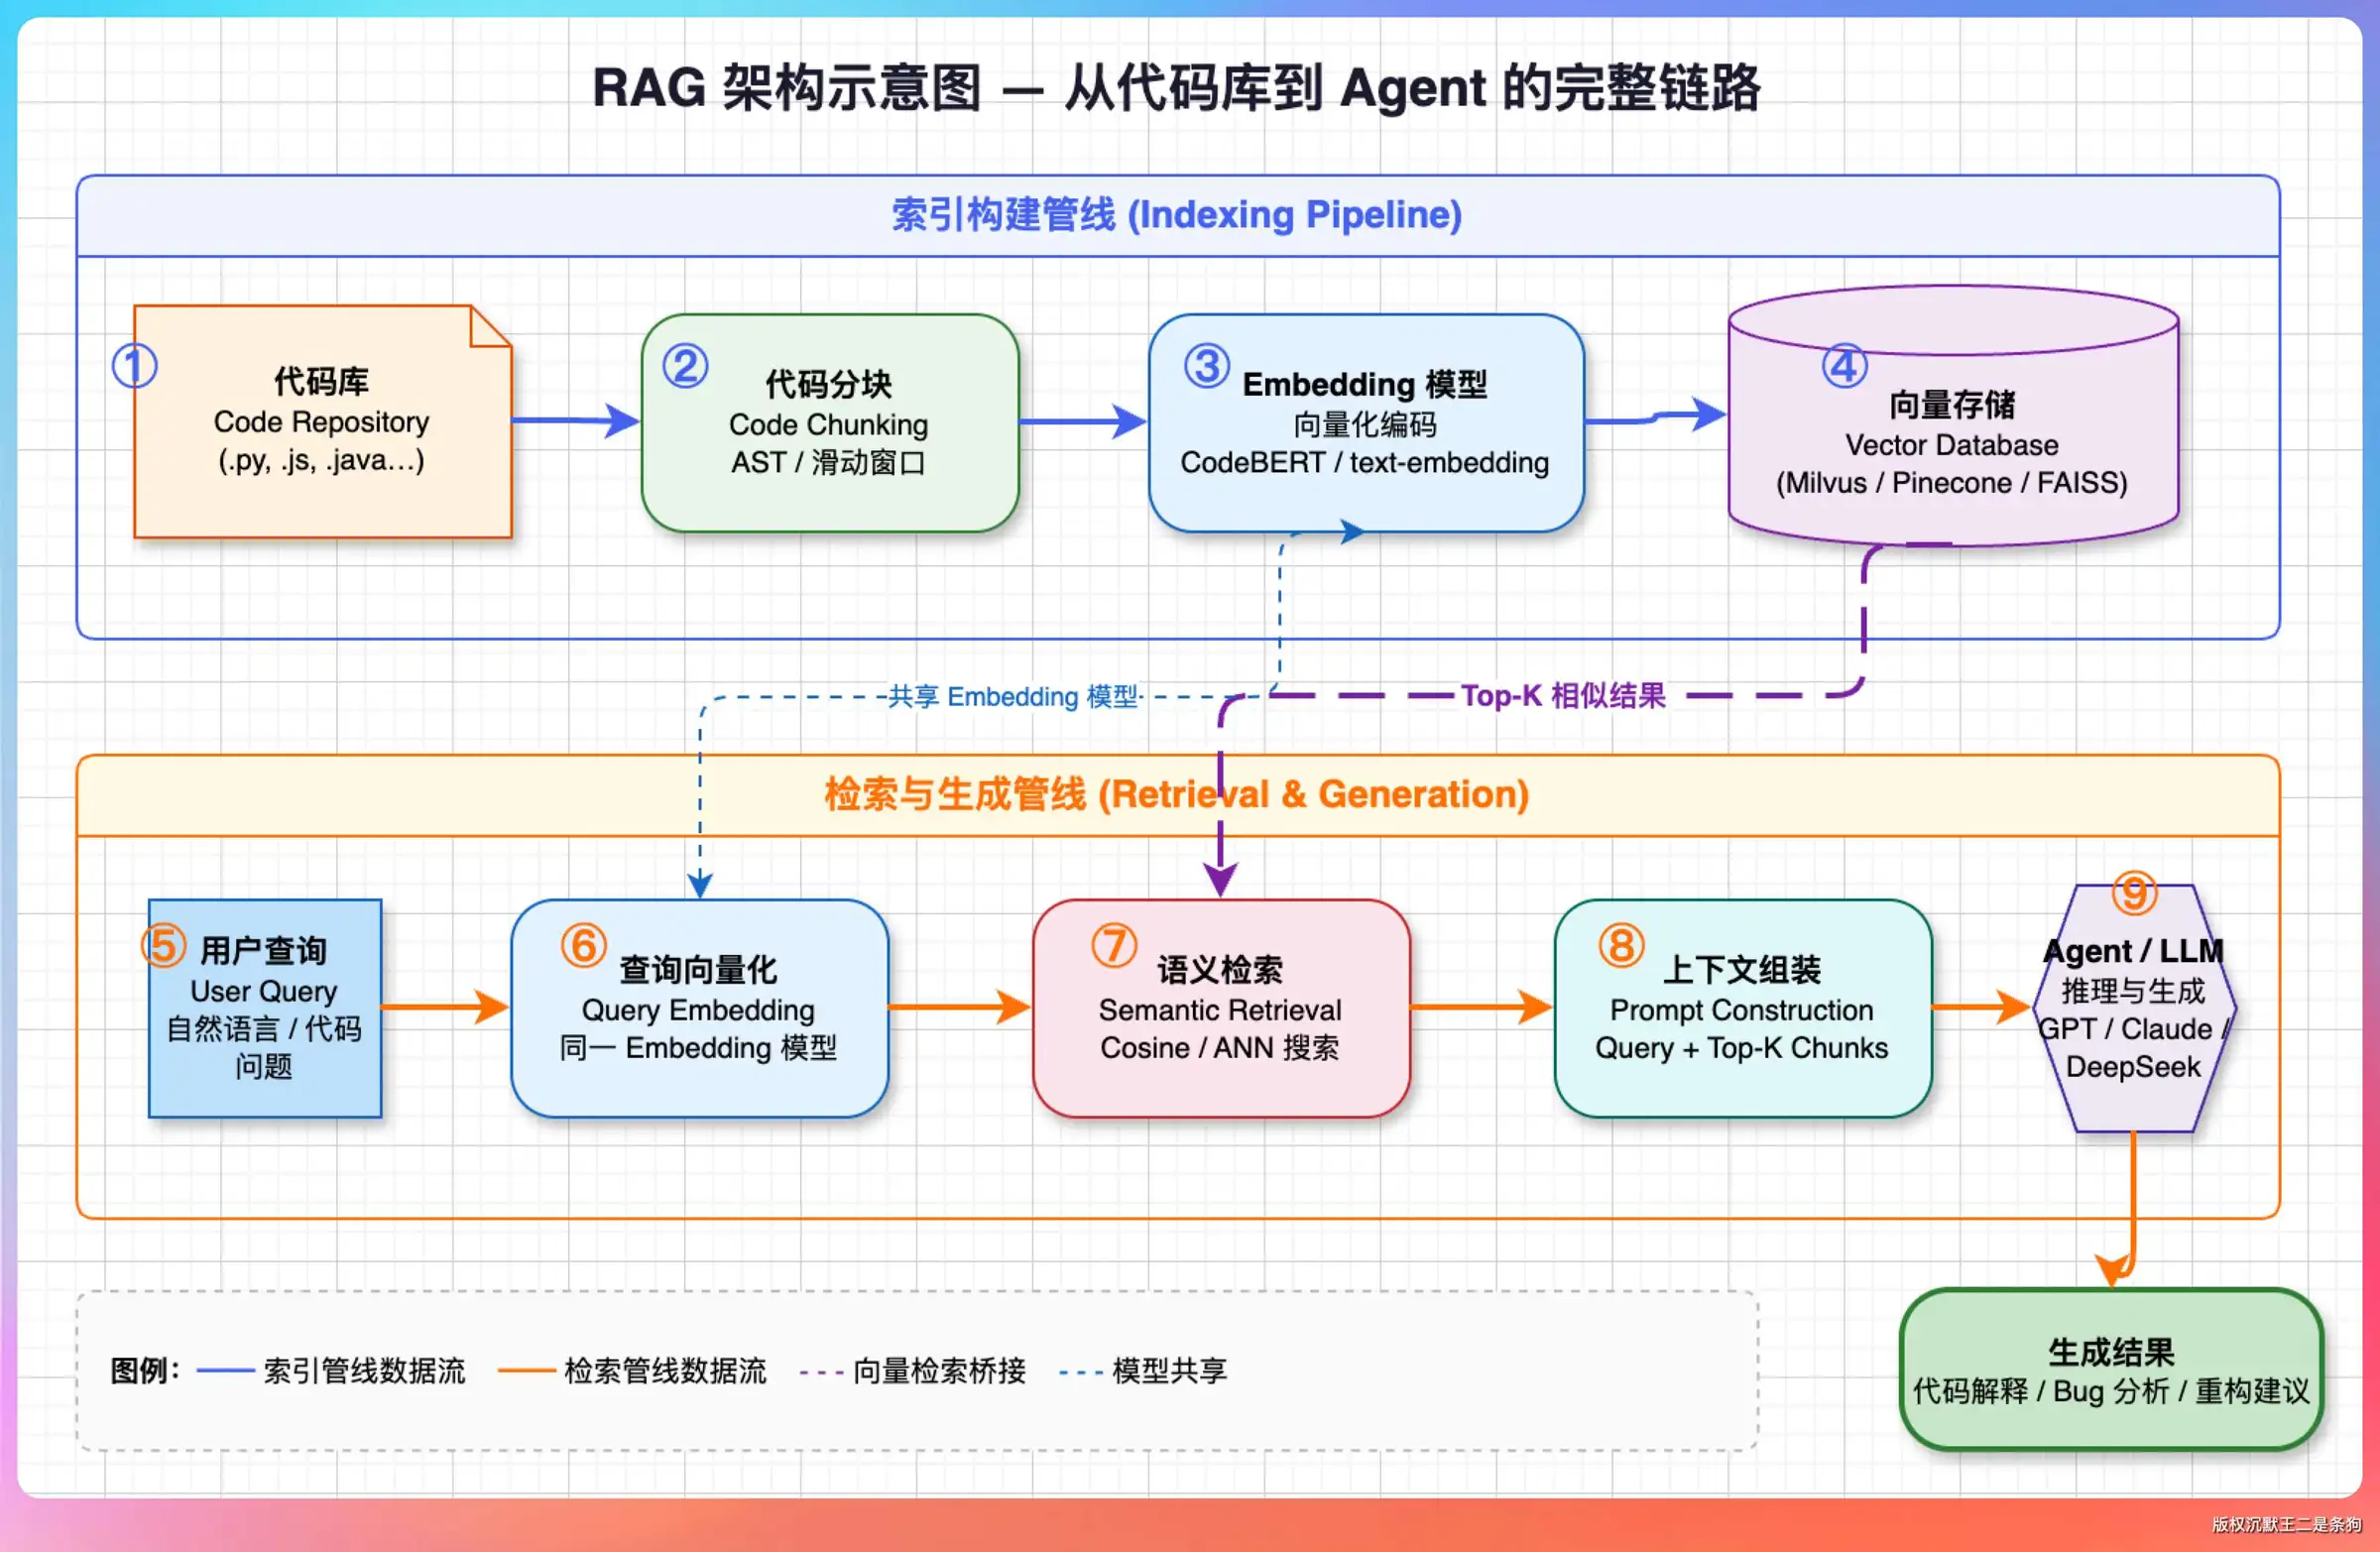
这一期我们对照 PaiCLI 的最新源码,把这套代码搜索与本地 RAG 的实现细节从头到尾讲清楚:
glob_files、grep_code、read_file和search_code四个工具怎么配合;- 怎么用 JavaParser 按语法树把源码切成类块和方法块;
- 向量怎么跨文件批量生成,怎么用 SQLite 和 SHA-256 指纹做秒级增量索引;
- 混合检索怎么把语义相似度、关键词位置加分和代码块类型结合起来,以及怎么从语法树里提取类的继承和调用关系。
01、精确搜索与 RAG 混合检索怎么分工
PaiCLI 的系统提示词 prompts/base.md 给模型定下了明确的代码查找顺序。遇到当前项目内的文件和代码问题,先用 glob_files、grep_code 和 read_file 现用现查;只有用户描述模糊、关键词难以确定,或者普通搜索多轮无果时,才调用 search_code 做语义辅助。
- 当前项目内的文件和代码优先使用 `glob_files` / `grep_code` / `read_file` 现用现查:先找文件或符号,再按需读取具体行段。
- 精确符号、文件名、字符串、命令入口、调用链定位优先 `grep_code` / `glob_files`,不要为了这类任务先走 `search_code`。
- `grep_code` 返回 `partial: true` 或 `suggested_reads` 时,优先缩小 `path`/`glob`/`pattern` 或按建议调用 `read_file offset/limit` 读取命中附近上下文,不要一次性读取大文件。
- `search_code` 只作为语义辅助:适合用户描述很模糊、关键词难以确定、普通搜索多轮无果,或代码/文档/知识混合检索场景。
这四个工具都用于读取项目内容,全部放进了 ToolRegistry.PARALLEL_SAFE_TOOLS 白名单。模型在同一轮里连续发起多个搜索或读文件请求时,执行器会用最多 4 个线程并行执行,最后按原来的顺序把结果交回模型。
其中 grep_code 由 RipgrepCodeSearchEngine 和 JavaCodeSearchEngine 双引擎驱动。本机装了 ripgrep 时优先拉起 rg --json 子进程,限时 8 秒;本机没装 rg 或者启动异常时,自动切回 Java 原生的文件遍历与正则匹配,跳过超过 2 M 的大文件和前 4096 字节里含 \0 的二进制文件。
为了防止一次搜索返回几千行结果把上下文窗口占满,grep_code 做了两道截断保护:
- 在搜索引擎内部,单个文件命中满
head_limit(默认20条)就不再收录该文件的后续行,总命中满max_results(默认50条)就终止搜索并标上partial: true; - 在结果拼接阶段,输出总长度达到
max_chars(默认24000个字符)就停止拼接,提示模型缩小搜索范围。
光搜出命中的那一行还不够,模型还得看那一行前后的代码。如果让模型自己猜行号去读文件,经常会读偏,或者干脆把整个大文件全读进来。所以 ToolRegistry.appendSuggestedReads 会在 grep_code 的结果末尾自动附上最多 3 条分段读取建议。
// src/main/java/com/paicli/tool/ToolRegistry.java
private void appendSuggestedReads(StringBuilder sb, List matches) {
    if (matches.isEmpty()) {
        return;
    }
    sb.append("\nsuggested_reads:");
    Set seen = new LinkedHashSet<>();
    for (GrepMatch match : matches) {
        if (seen.size() >= 3 || !seen.add(match.file())) {
            continue;
        }
        int offset = Math.max(1, match.lineNumber() - 20);
        sb.append("\n- read_file {\"path\":\"")
                .append(match.file().replace("\\", "\\\\").replace("\"", "\\\""))
                .append("\",\"offset\":").append(offset)
                .append(",\"limit\":80}");
    }
}
每条建议都以命中行号为中心,往前推 20 行作为起始行 offset,往下读 80 行作为 limit。模型照着建议调用一次 read_file,就能拿到带行号的目标代码段。
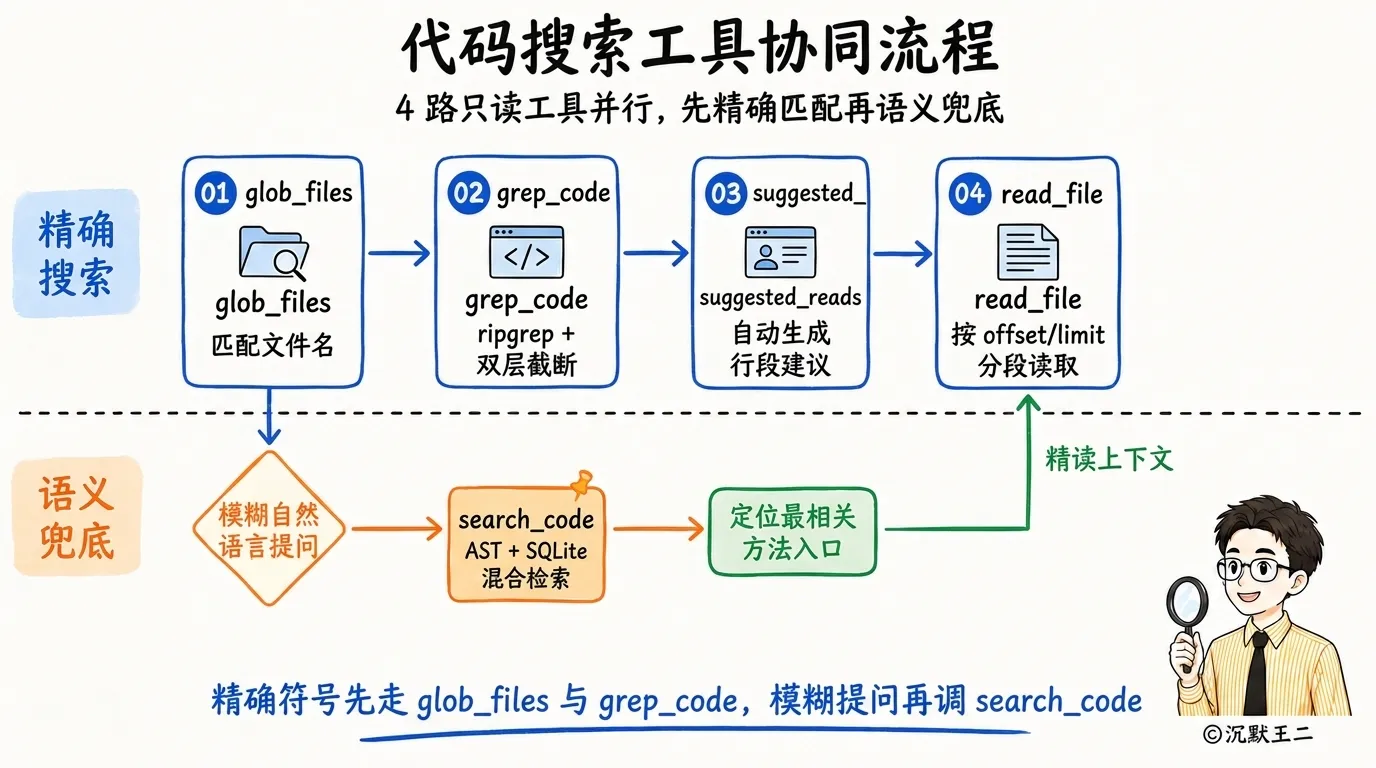
那么遇到模糊提问,轮到 search_code 上场时,本地 RAG 需要依次跨过切分、存储和检索三道关卡。
源码如果按固定字数硬切,经常把一个方法从中间劈成两半,丢失类名和方法签名,所以得先按语法结构切成文件、类和方法三个粒度。
切完算出来的向量还得找地方存。PaiCLI 是一个开箱即用的命令行工具,如果要求用户先装 Docker、启动 Milvus 或 Elasticsearch 才能查代码,使用门槛就太高了,用内嵌的 SQLite 配合增量索引,单文件就能落盘。
存进 SQLite 之后,最后还要解决怎么搜得准确的问题。纯向量检索对自然语言同义词灵敏,但对代码里的精确类名和方法名不够敏感,需要把向量相似度、分词关键词位置加分和代码块类型加分结合起来。
围绕这三个环节,PaiCLI 的 rag/ 包拆分成了这些核心类:
CodeChunk:代码块数据模型,记录文件路径、块类型、名称、源码内容和起止行号JavaSourceParser:用ThreadLocal管理非线程安全的JavaParser实例CodeChunker:基于 AST 语法树切分 Java 代码,非 Java 文件按行分段CodeRelation与CodeAnalyzer:从 AST 提取继承、实现、导入、包含和方法调用五种关系EmbeddingClient:封装本地 Ollama 与远程 OpenAI 兼容向量接口,支持跨文件批量请求VectorStore:基于 SQLite 持久化代码块、关系图谱与文件增量指纹CodeIndex:多线程增量索引流水线入口RagQueryTokenizer:结合jieba中文分词与正则提取代码标识符CodeRetriever:执行语义打底与关键词加权的混合检索SearchResultFormatter:生成零延迟检索摘要,格式化终端与工具输出
02、用 JavaParser 按语法结构切分代码
代码分块决定了后面检索的上限。分块时如果把两个不相干的方法拼在一起,或者把方法头和核心逻辑拆开,算出来的向量就会失真。
PaiCLI 对 Java 源码和其他文本文件采取不同的切分策略。
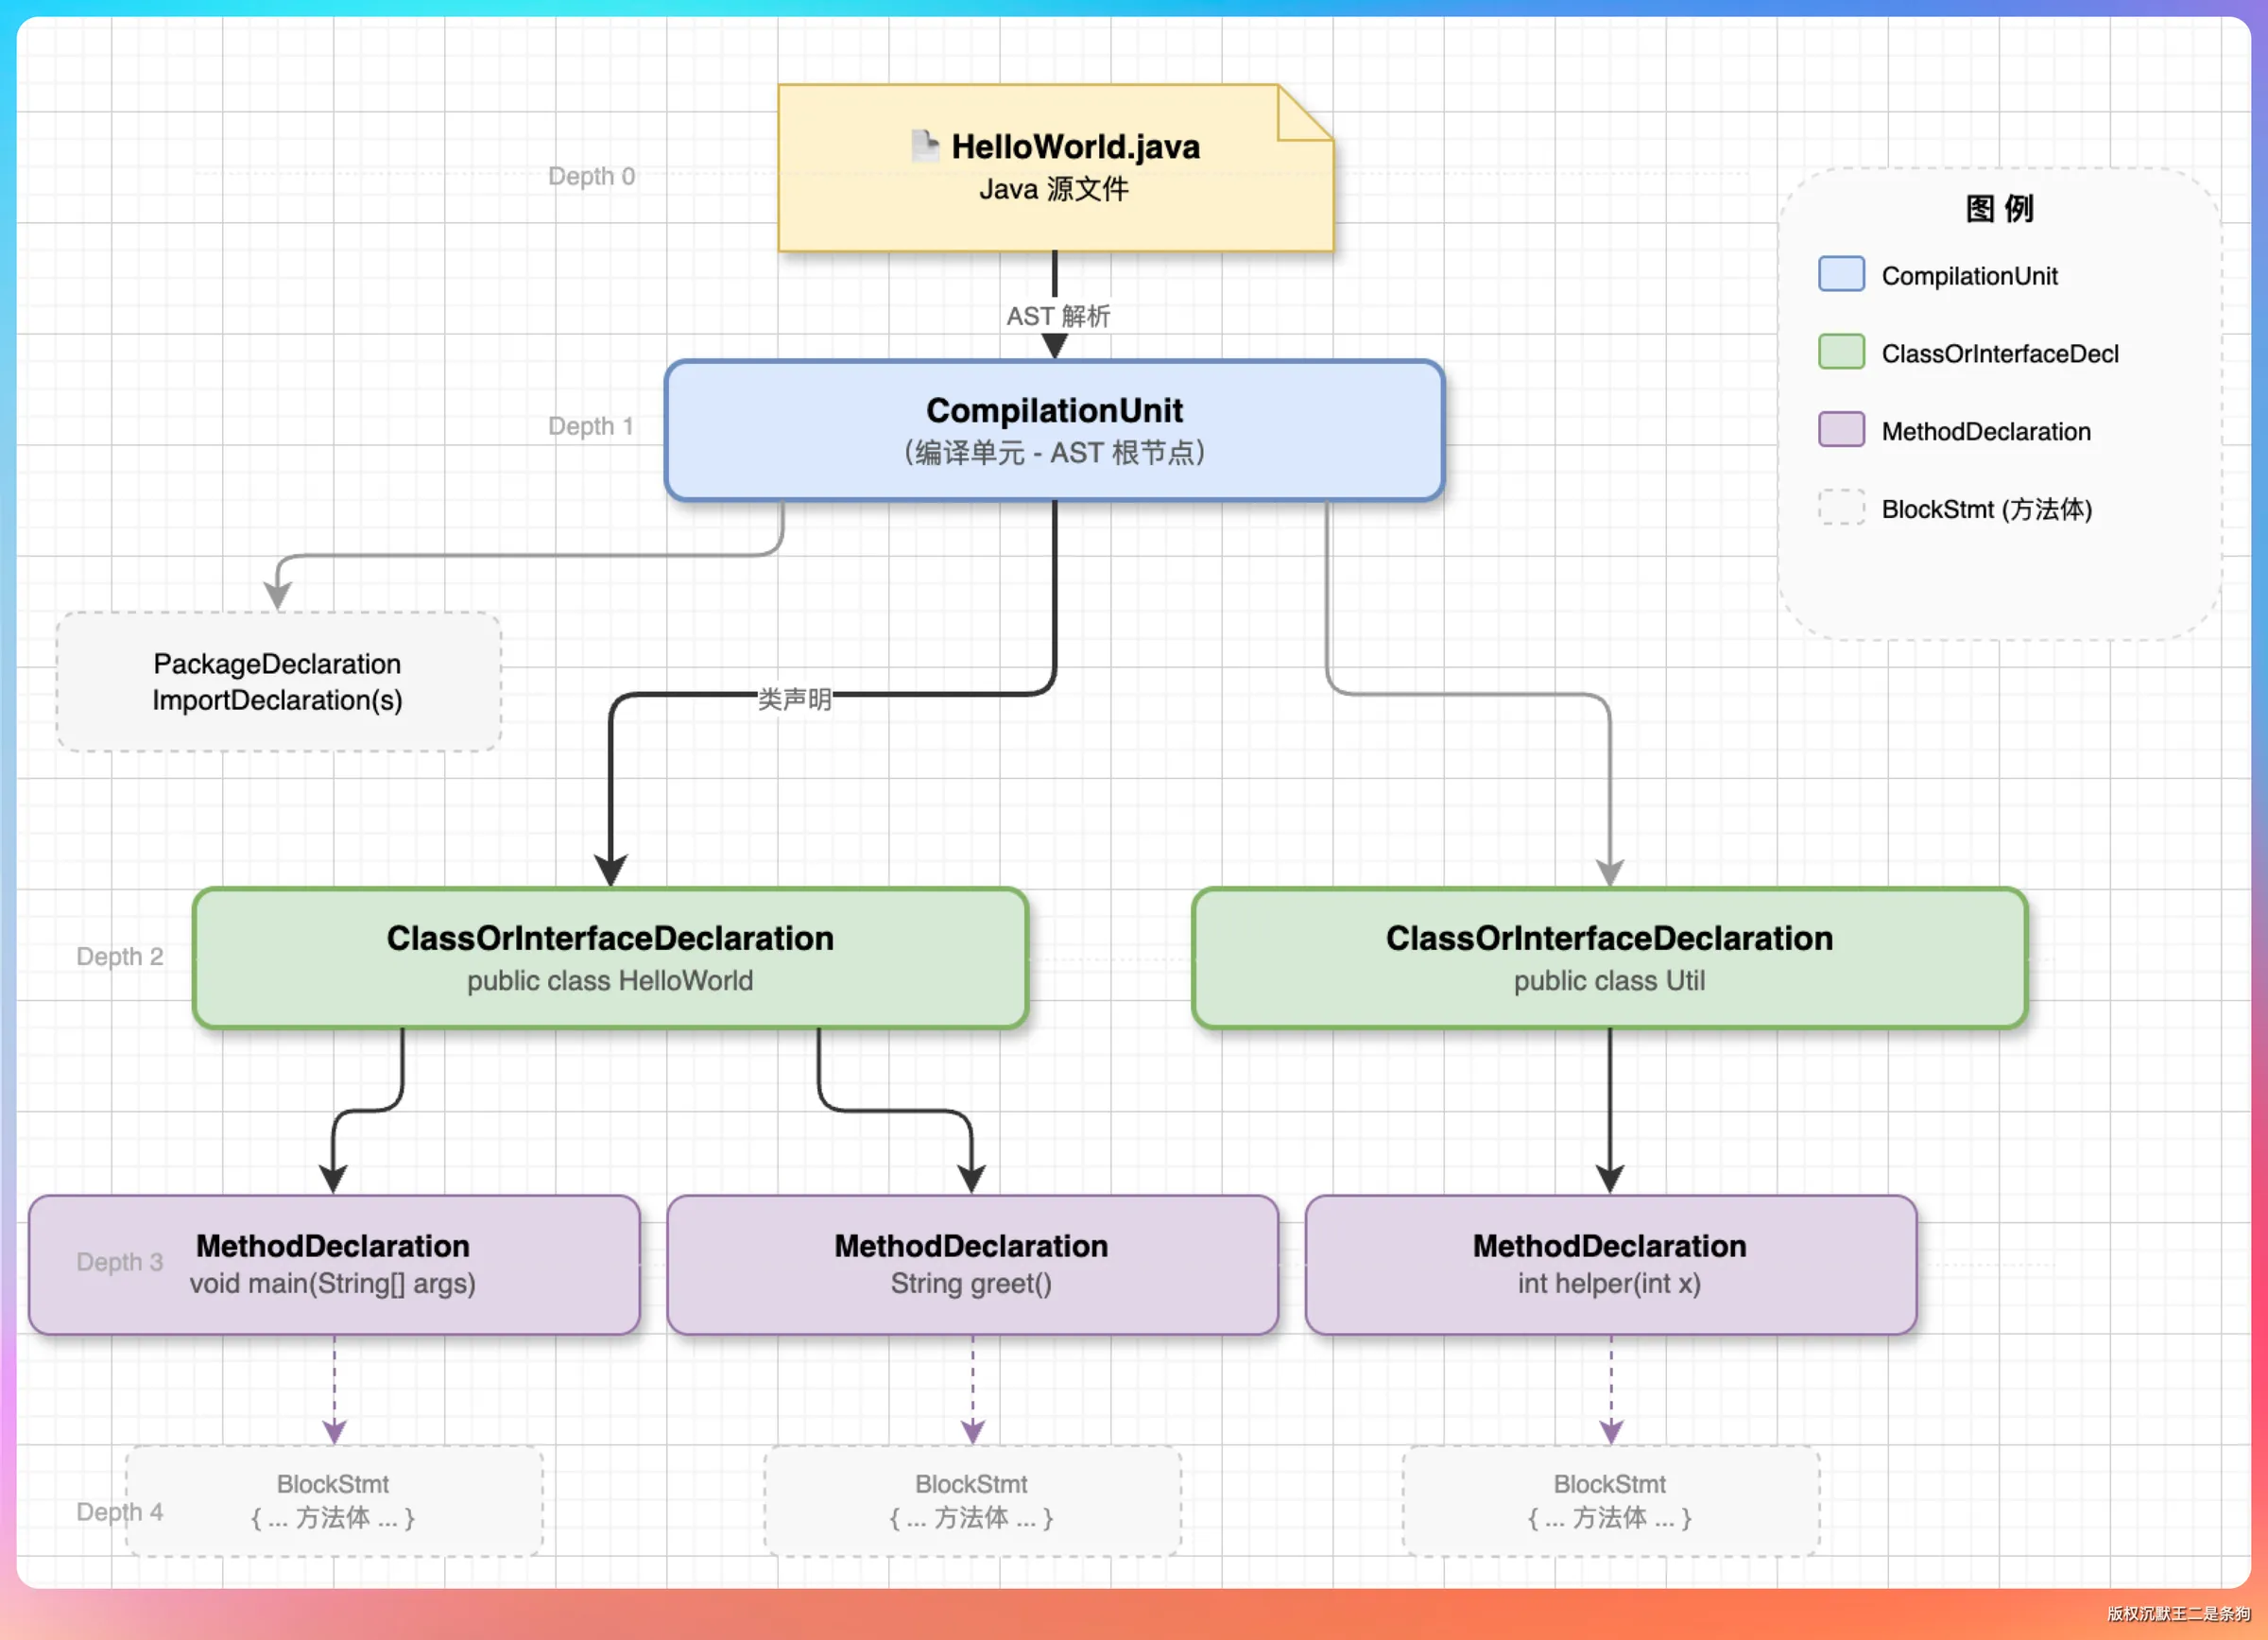
Java 源码统一由 JavaSourceParser 调用 JavaParser 解析成抽象语法树(AST,即 CompilationUnit),语言级别设为 JAVA_17,支持文本块、record 和 sealed class 等语法。
由于官方说明 JavaParser 实例不是线程安全的,而在建索引时会有多个线程同时解析文件,JavaSourceParser 用 ThreadLocal 为每个工作线程分配一个独立的解析器实例。
// src/main/java/com/paicli/rag/JavaSourceParser.java
final class JavaSourceParser {
    private static final ThreadLocal PARSER = ThreadLocal.withInitial(() -> new JavaParser(
            new ParserConfiguration().setLanguageLevel(ParserConfiguration.LanguageLevel.JAVA_17)));

    static Optional parse(String content) {
        ParseResult result = PARSER.get().parse(content);
        if (!result.isSuccessful()) {
            return Optional.empty();
        }
        return result.getResult();
    }
}
解析出来的 Optional 会同时传给分块器 CodeChunker 和关系分析器 CodeAnalyzer,保证每个 Java 文件在建索引时只解析一次语法树。
拿到语法树后,CodeChunker.chunkJavaFile 会遍历文件里的类、接口、枚举和 record 声明,生成类和方法两种粒度的代码块。
针对类声明本身,分块器只截取开头的最多 6 行(从起始行 classStart 到 classStart + 5)生成 class 块,包含包名上下文、类注释、类名、泛型签名和开头的字段声明,不把几百行的方法实现塞进去。
接着分块器继续往里遍历类里的每个方法与构造函数,用 getDeclarationAsString(...
未能定位到原文的划线
企业级Agent工作流编排项目PaiFlow
Vibe Coding版本的PaiAgent
派聪明RAG AI知识库Java版本+Go版本
微服务 PmHub、技术派、MYDB
求职派JobClaw(OpenClaw/Hermes架构
PaiCLI(类似Claude Code的Agent
派简历(代码已完成)
等实战项目。
1. 微信扫右侧的优惠券加入知识星球
2. 解锁星球的实战项目教程和源码: 项目源码+教程获取
16人已点赞




暂无评论
回复