杠精派
派聪明
0/512

热门评论

Ivan 2026年09月06日 09:57
引用原文:“第二套是 conversationHistory 压缩,压的是 Agent 真正发给 LLM 的消息列表。它不是 Map-Reduce,而是在调用 LLM 前检查 token,达到阈值后,把 system 后面、最近 3 个 user 轮次之前的旧消息交给 LLM 总结成一段摘要,再重建消息列表。”
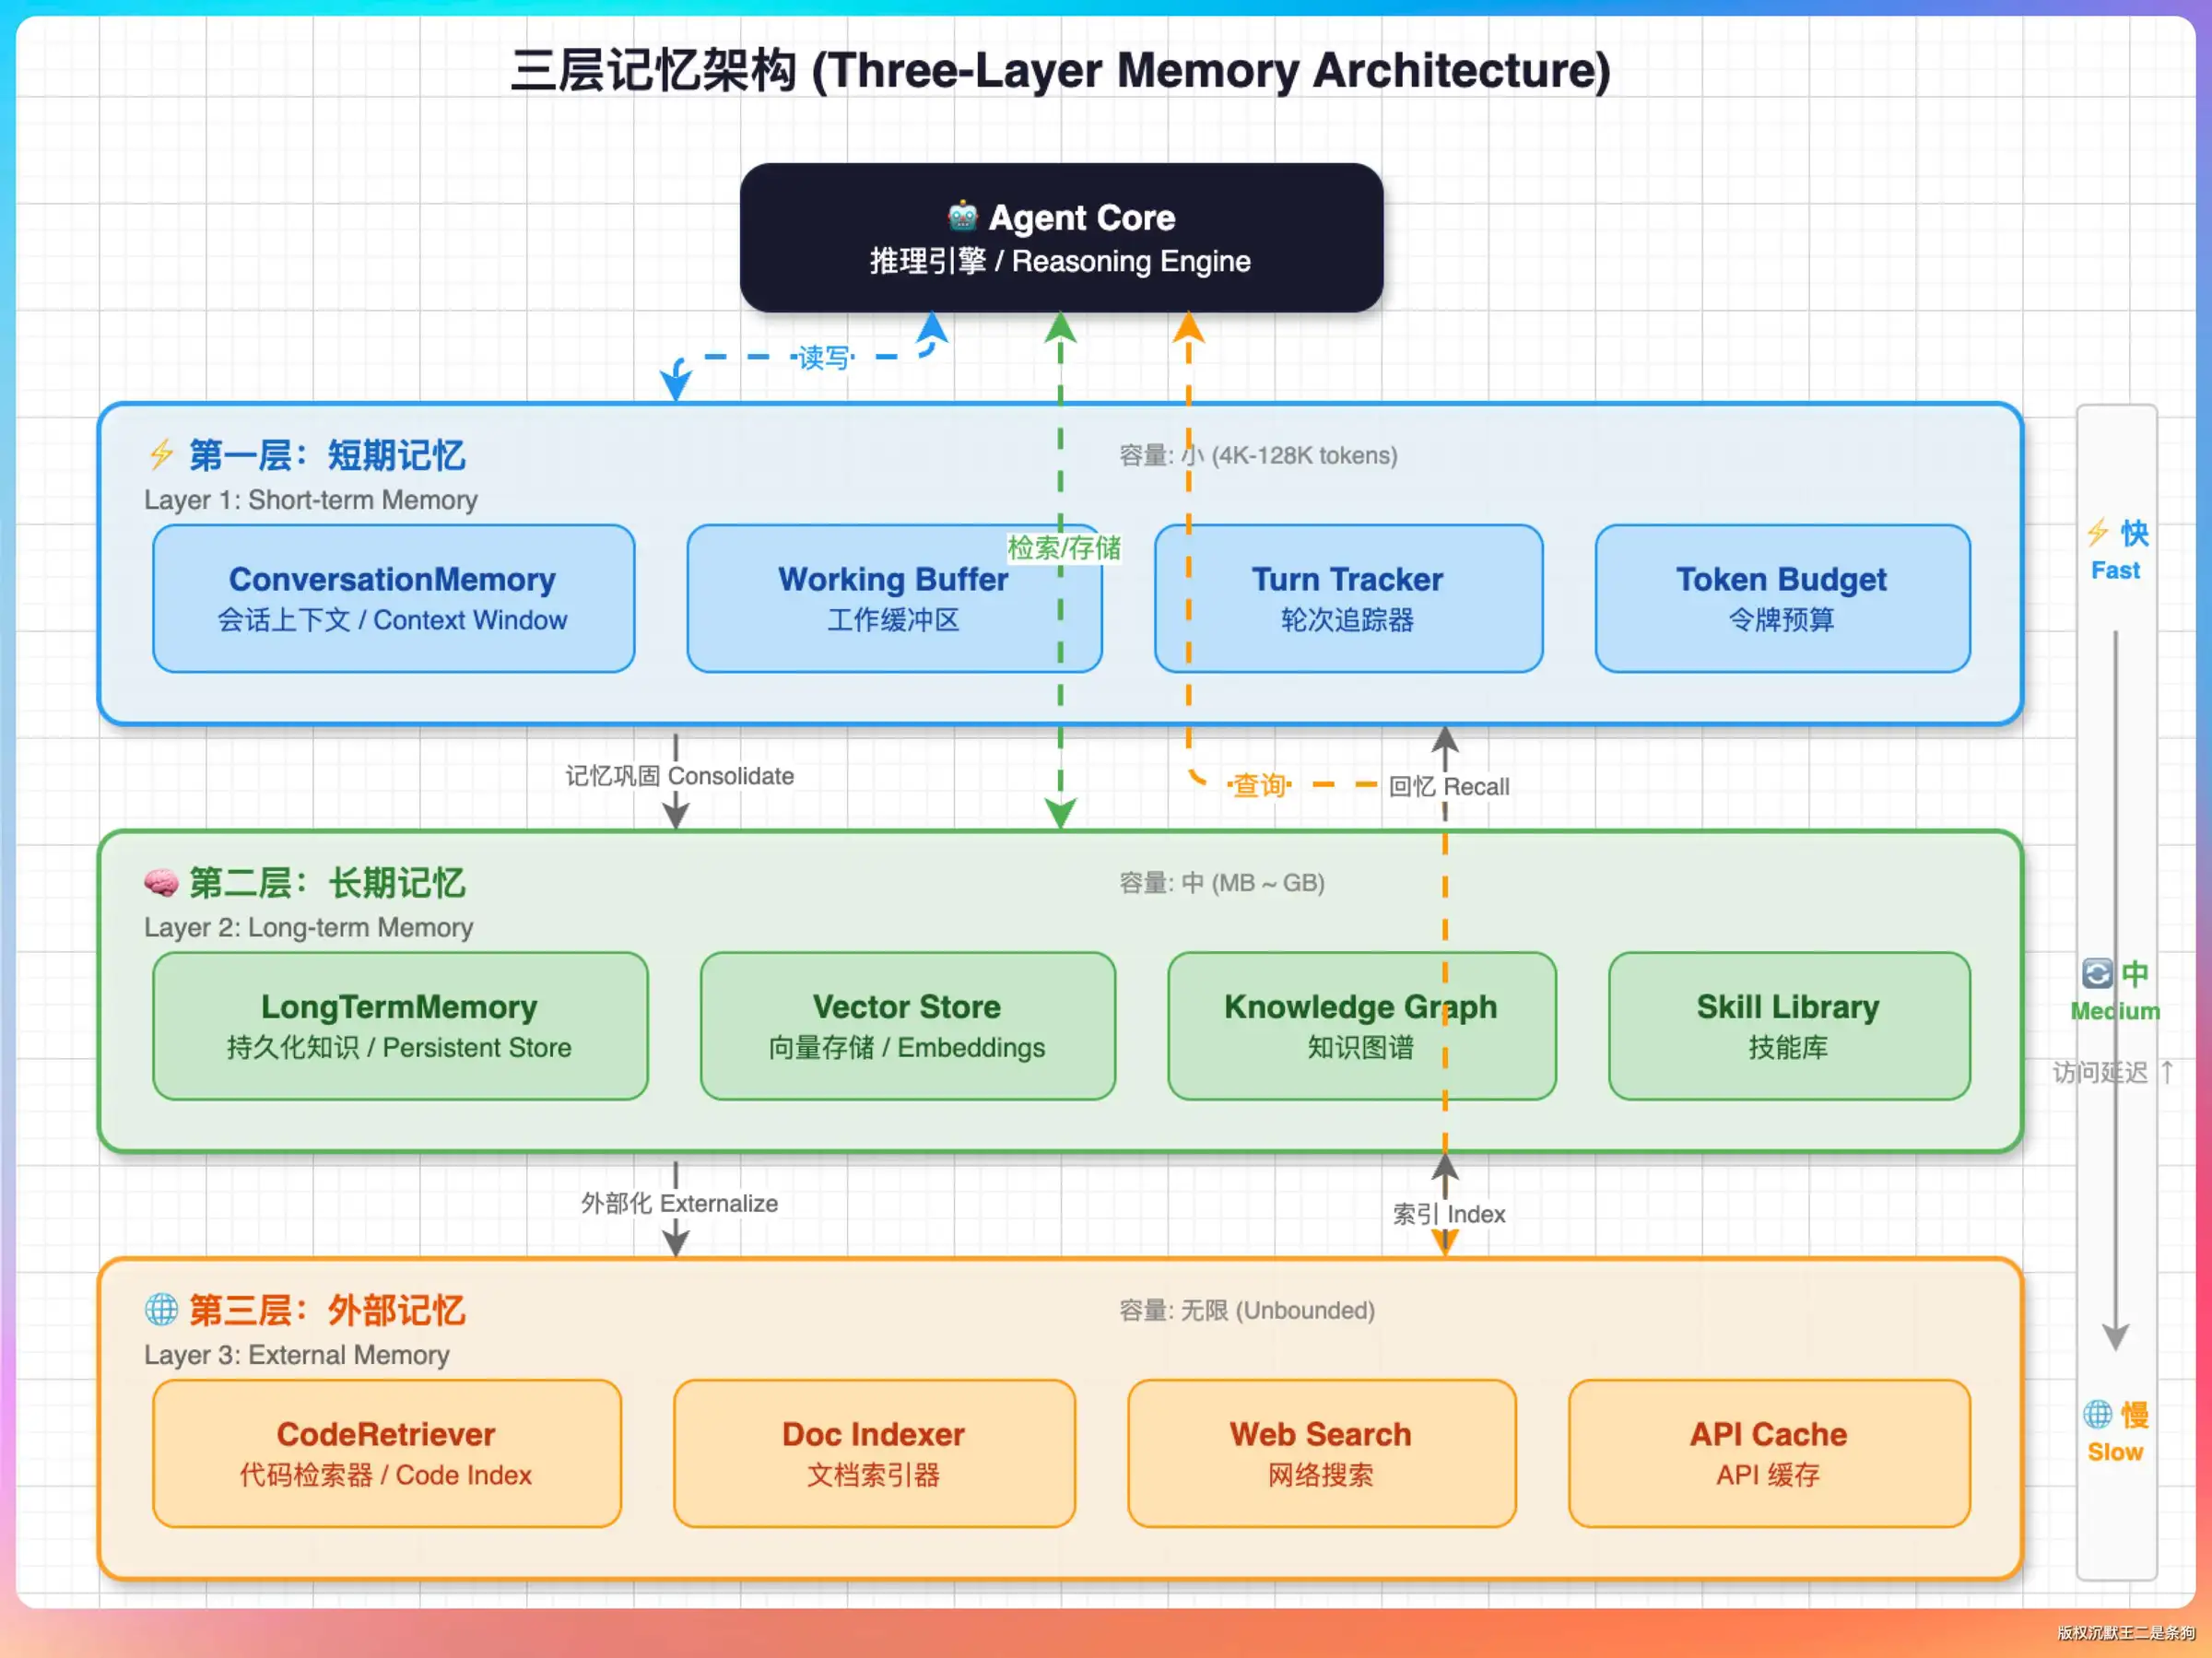
@派聪明 conversationMemory是我们对话中提到的短期记忆吗,它的作用结合代码来看并没有被注入模型对话上下文,真正注入的是conversationHistory,这两种是前者被后者替换过吗?
点赞
回复9 取消回复
派聪明 2026年09月06日 09:58
简单说:**是的,conversationMemory 就是我们说的短期记忆;但不是“被替换”,而是“分工”——一个负责完整存档,一个负责实际喂给模型。**两者是并存关系,不是替换关系。 具体对应关系: **1.短期记忆(Memory系统里的 conversationMemory)** -存的是**全量对话历史**:用户消息、助手回复、工具调用及结果,每轮追加- 它的价值是“完整的记忆档案”,Map-Reduce摘要压缩发生在这一层(触发线是短期记忆预算的90%,即窗口的45% ×90%) - 它本身**不直接发给模型**——你观察得没错**2. conversationHistory(真正发给 LLM 的消息列表)** - 这是 Agent每轮调用 LLM 前**临时组装/维护**的请求消息列表- 发送前检查 token,达到窗口90% 就触发第二套压缩:保留 system + 最近3 个 user轮次,更早的消息总结成一段摘要注入-模型真正“看到”的就是它**为什么要两套?** 因为目的不同: | |短期记忆 | conversationHistory | |---|---|---| | 角色 |完整历史存档 |实际请求载荷 | |压缩方式 | Map-Reduce摘要 | user边界切割 + LLM 总结 | |触发线 |窗口45% 的90% |窗口的90% | | 目的 |控制记忆体量、可供回溯 | 保证请求不超上下文窗口 | 短期记忆在会话内可以保留相对完整的细节(预算只有窗口的45%,靠 Map-Reduce压住),而发送给模型的 conversationHistory 可以包含 system prompt、注入的长期记忆、RAG检索结果等动态拼装内容,并且靠“摘要 + 最近3轮”的方式在协议安全的前提下(不切断 tool_call/tool_result 配对)控制长度。 所以流程是:对话写入短期记忆(做第一
点赞
回复 取消回复
展开剩余 8 条回复

197 条评论

Romantic 2026年09月24日 00:14
引用原文: Agent 的系统提示词里
@派聪明 涉及到的相关代码?
点赞
回复 取消回复
Romantic 2026年09月24日 00:11
引用原文:在 Agent 的系统提示词里,模
@派聪明 相关代码在哪?
点赞
回复 取消回复
Romantic 2026年09月24日 00:11
引用原文:Agent 的系统提示词里
相关的代码在哪?
点赞
回复 取消回复
Romantic 2026年09月24日 00:06
引用原文:需要先建索引
@派聪明 后续代码有修改了 这个索引每次需要重新建?
点赞
回复1 取消回复
派聪明 2026年09月24日 00:06
# 关于 RAG索引是否需要重建的问题**是的,索引建立后不是一劳永逸的,但也不是每次检索前都要重建。** ##索引的生命周期1. **首次使用需要建索引**:执行 `/index`命令,PaiCLI 会扫描代码库、AST 分块、调 Embedding模型转向量,存入 SQLite。这一步有“冷启动成本”,这也是文章里把 RAG降级为“语义辅助”的原因之一——`grep`精确搜索是零预处理、零冷启动的。 2. **代码变更后需要重建/增量更新**:如果你修改了代码(比如改了某个方法的实现),已建的索引里存的还是旧代码的向量,检索出来的可能是过时内容。这时需要重新执行 `/index`。 ## 后续修改带来的缓解按照最新设计,**RAG 已从“必须前置”降级为“锦上添花”**: - Agent优先用 `grep_code`(关键字/正则实时搜索)、`glob_files`(文件名匹配)、`read_file` 这些**精确搜索工具**,它们直接实时扫描当前文件树,永远是最新的,不存在索引过期问题。 - 只有模糊查询、关键词难确定、或精确搜索多轮无果时,才走 RAG语义兜底。 ## 结论-精确符号定位 → 用 grep/glob实时搜索,**不需要索引**,结果永远新鲜。 -模糊语义查询 → 需要 RAG,**代码变更后索引确实要重新建**(或做增量更新),否则可能检索到过时代码。 - 即使完全没建索引,Agent依然能通过精确搜索工作,所以索引过期最多是“语义检索质量下降”,不会导致 Agent失效。 一句话:**索引不是每次都重建,但代码改了之后 RAG 的索引会过期,需要重新 `/index`;实际影响已被‘精确搜索优先’的策略大幅降低。**
点赞
回复 取消回复
Romantic 2026年09月23日 23:29
引用原文:从长期记忆里检索相关条目
@派聪明 这个是怎么检索的?
点赞
回复1 取消回复
派聪明 2026年09月23日 23:29
长期记忆的检索流程(PaiCLI 的实现): **1.触发时机** 每轮对话开始前(请求模型之前),由统一的记忆管理者触发长期记忆检索。 **2.作用域过滤(project/global隔离)** 先做一层**项目可见性过滤**: - **global级**记忆:对所有项目可见(如“用户偏好中文回复”) - **project级**记忆:只有元数据中的项目路径与当前项目路径匹配才可见(防止 A 项目存的“用 Java17”干扰 B 的 Python 项目,路径已做标准化处理) **3. 关键词匹配 +评分排序** 过滤完可见性后,用**关键词匹配**对剩余记忆条目打分排序,取 **top-k 条**注入 system prompt。 注意:这里**不是向量检索**,而是最朴素的关键词匹配。原因是长期记忆通常只有几十条,关键词匹配够用且零依赖;如果记忆量涨到几千条,再换向量检索。 **4. 注入上下文** 检索出的相关记忆条目与外部记忆检索结果、短期记忆的对话历史一起拼装成完整 prompt 发给模型。注入量有上限控制:`min(5000, max(500, window /200))` tokens。 另外用户也可主动查询:`/memory list`查看全部、`/memory search`按当前项目可见性搜索。
点赞
回复 取消回复
iuk 2026年09月19日 17:16
引用原文:。AST 解析
@派聪明 这个是怎么实现的
点赞
回复1 取消回复
派聪明 2026年09月19日 17:16
# AST 解析的实现PaiCLI 中用 **JavaParser**库实现 AST(抽象语法树)解析,主要用于两个场景:**代码分块(RAG索引)** 和 **代码关系图谱**。 ##1.代码分块中的 AST 解析RAG建索引前需要把代码切块,PaiCLI 不按固定行数切,而是解析 Java 文件的语法树,按语法结构生成三种 chunk: - **方法级(最核心)**:从方法声明节点提取起止行号,截取**完整方法源码**,chunk 名称带 `类名.方法签名`,保证方法不会被从中间截断- **类级**:每个类/接口生成一个 chunk,主要保存类声明开头几行,提供类名和结构入口- **文件级**:非 Java 文件或解析失败时回退使用,大文件按行拆成不超过约2000 字符的段**为什么不按行数切?**固定行数会把一个方法劈成两半,检索到上半截时模型看不懂方法在干什么。AST 解析保证每个 chunk 是完整语法单元。 ##2.代码关系图谱中的 AST 解析同样用 JavaParser 分析源码,提取代码元素间的五种结构关系: -继承(extends) -接口实现(implements) - 导入(import) - 方法调用- 包含关系这些关系存到 SQLite,用户执行 `/graph 类名` 即可查看完整关系链,例如“LoginService被谁调用了”。 ##局限与扩展当前只做了 Java 的 AST 分块。若要支持多语言,可改用 **tree-sitter**,它支持几十种语言的语法解析。
点赞
回复 取消回复
Captain_ 2026年09月17日 10:02
@派聪明 ShortTermMemory是我们对话中提到的短期记忆吗,它的作用结合代码来看并没有被注入模型对话上下文,真正注入的是conversationHistory,这两种是前者被后者替换过吗?
点赞
回复1 取消回复
派聪明 2026年09月17日 10:02
不是被替换,两者是**并存的两套东西,服务不同目的**,很多“Memory系统的短期记忆”确实不直接发给 LLM。可以这样理解: ## 两者的定位**conversationHistory(真正的请求消息列表)** - Agent实际发给 LLM 的消息数组,包含 system / user / assistant / tool消息- ReAct 主循环、Plan 子任务、Multi-Agent 的 SubAgent,每次调用 LLM前都会检查并压缩它- 这是“模型看到的对话历史” **Memory系统的 ShortTermMemory(记忆存档层)** - 是把每轮的用户输入、助手回复、工具结果**存档**下来,作为记忆系统的数据源- 主要作用有两个: 1. 为长期记忆的提取、检索提供原始素材2. 通过 Map-Reduce摘要压缩控制自身体积,防止存档无限膨胀## 为什么容易混淆因为两者压缩策略相似(都有 token阈值、都做摘要),且阈值规则不同: | 对象 |预算 |触发线 | |---|---|---| | ShortTermMemory | window ×45% | 达到自身预算的90% | | conversationHistory |整个 window | window ×90%,每次 LLM调用前检查 | 比如 GLM200k窗口下,ShortTermMemory 大约到81k token压缩,conversationHistory 要到180k才压缩。 ## 结论不是替换关系,而是**职责分离**:conversationHistory 负责“这一轮模型实际看到什么”(请求层),ShortTermMemory 负责“把会话内容结构化存下来供记忆系统用”(存档层)。被注入模型上下文的是 conversationHistory,你的观察是对的——但 ShortTermMemory 并没有废弃,它在记忆检索、摘要生成这些环节仍然被消费。
点赞
回复 取消回复
粗心的超短裙 2026年09月17日 02:10
引用原文:触发压缩。
@派聪明 system prompt主要包含什么
点赞
回复1 取消回复
派聪明 2026年09月17日 02:10
system prompt 主要包含以下内容: 1. **系统指令/核心提示词**:Agent 的基础指令、身份设定和任务说明。 2. **人格设定与模式指令**:Agent的人格、行为风格等稳定配置。 3. **注入的长期记忆条目**:每轮对话前,从长期记忆检索出的与当前对话相关的事实(经过项目可见性过滤和评分排序后的 top-k 条),注入到 system prompt 中。 4. **外部记忆检索结果**:需要时按需检索的外部知识内容(如 RAG代码片段)。 5. **项目上下文、技能索引等动态内容**:如当前项目背景信息、可用技能列表等(这些相对不稳定的内容靠后放置)。 组装时遵循“**越稳定的内容越靠前**”的原则:系统提示词、人格设定、模式指令这些每轮都不变的内容放前面,项目上下文、记忆等动态内容放后面。这样设计的好处是更容易命中 provider 的**前缀缓存(Prompt Caching)**,节省重复计算成本。
点赞
回复 取消回复
粗心的超短裙 2026年09月17日 02:08
引用原文:触发压缩。
@派聪明 外部记忆检索不也是调用工具吗
点赞
回复1 取消回复
派聪明 2026年09月17日 02:08
是的,外部记忆检索本质上也是一种工具调用,但它和 Agent主动调用的工具有一个关键区别:**触发时机不同**。 **Agent主动调用的工具**(如 read_file、grep_code、search_code): - 由模型在 ReAct推理过程中**自主决定**何时调用-调用结果作为 tool消息追加到对话历史里- 是模型“思考后”的主动行为**外部记忆检索**: - 由统一的管理者在**每轮请求模型之前**自动执行- 它不是模型决定的,而是框架层的“前置调度”逻辑-检索到的结果会被注入到 prompt 中(通常拼进 system prompt 或上下文区域),而不是作为对话历史中的 tool消息存在所以流程上是这样的: 1. 用户输入新消息2. **管理者先做前置处理**:检索长期记忆相关条目 +获取外部记忆(RAG索引检索结果) 3. 把这些结果和短期记忆的对话历史一起**拼装成完整 prompt** 发给模型4.模型拿到已经“预注入”的上下文开始推理5. 此时模型如果还需要更多代码细节,再**主动调用** grep_code、search_code等工具可以理解为: - **外部记忆检索(前置)**=框架自动做的“背景知识预加载” - **工具调用(推理中)**=模型按需发起的“主动查询” 不过要注意,PaiCLI 最新版本有个变化:RAG 的 search_code 也被做成了 Agent 可调用的工具,模型可以根据查询的模糊程度自己决定是否走语义检索。所以现在外部记忆实际上有两条路径——框架层的前置注入,和模型层的按需工具调用,两者并存。
点赞
回复 取消回复
粗心的超短裙 2026年09月17日 02:06
引用原文:触发压缩。
@派聪明 但是我有个问题,除了system,剩下的不就是短期记忆了嘛
点赞
回复1 取消回复
派聪明 2026年09月17日 02:06
好问题,这里其实是 PaiCLI 里**两套容易混淆的结构**,不能简单说“除了 system 就都是短期记忆”: ##1. Memory系统里的“短期记忆”(持久化存储层) 这是记忆架构三层里的那层“短期记忆”,本质是一个**存储模块**:每轮把用户消息、助手回复、工具调用结果**追加写入**它,生命周期是一次会话,可以做 Map-Reduce摘要压缩,压缩阈值是**短期记忆预算(窗口的45%)×90%**。 它的作用是“记录这次会话发生过什么”,供检索和管理。 ##2. conversationHistory(真正发给 LLM 的消息列表) 这才是你看到的那段示例: ``` [system, user1, assistant1(tool_call), tool1, ..., user20, assistant20] ``` 它是**每轮请求模型前临时组装**出来的,组装方式是: **system prompt +检索到的长期记忆条目 + 外部记忆(RAG/精确搜索)结果 +短期记忆里的对话历史** →拼成完整 prompt。 所以除了 system,里面还有**长期记忆注入的内容**和**检索到的外部知识**,这些不算“短期记忆”,只是被临时拼进了消息列表。 ##为什么要单独压缩 conversationHistory? 因为它才是会**撑爆上下文窗口**的东西,压缩时机是**每次调用 LLM之前**检查,达到 `窗口 ×90%` 就把最近3 个 user轮次之前的旧消息摘要掉。 **一句话总结**:短期记忆是“存档”,conversationHistory 是“发送出去的组装体”,后者 = system +长期记忆 + 外部记忆 +短期记忆拼装的结果,所以要独立做压缩保护。
点赞
回复 取消回复

目录