杠精派
派聪明
0/512

热门评论

过时的草莓 2026年08月05日 20:50
引用原文:Plan 模式强调可预测性,自动重试会让执行过程变得不可控。
@派聪明 如何理解这句话
点赞
回复11 取消回复
派聪明 2026年08月05日 20:50
小派正在努力回答中, 耐心等待一下吧...
点赞
回复 取消回复
展开剩余 10 条回复

164 条评论

喵_coding 2026年09月20日 21:20
引用原文: long 模式
@派聪明,这个long模式到底是什么意思,到底是压不压缩,我看文章的意思是直接不压缩,那要是持续对话怎么办,或者说真的就一次对话用了200k的上下文,不压缩岂不是会让模型上下文超阈值了
点赞
回复1 取消回复
派聪明 2026年09月20日 21:21
## long模式到底是什么long模式是 PaiCLI 第12期引入的**上下文管理策略的自适应切换机制**,核心逻辑是: **窗口 ≥100k 的模型(如 GLM-5.1 的200k、DeepSeek V4 的1M)→跳过 Map-Reduce摘要压缩,直接保留完整对话历史;窗口小的模型 →走原有的摘要压缩路径。** 注意:**“不压缩”不等于“没有预算限制”**。 ##跳过压缩后靠什么兜底你担心的“持续对话撑爆上下文”,文章里其实是有答案的,`AgentBudget` 这套机制并没有被移除: 1. **Token预算仍然生效**:预算 = `maxContextWindow ×80%`,窗口200k 就是160k 的预算上限。这个约束和压不压缩无关,只是决定“还剩多少空间”。 2. **摘要压缩是“延迟介入”而不是“彻底删除”**:long模式的准确含义是——**在预算充裕时不压缩**。日常开发对话很难用到160k,提前压缩反而丢信息、伤体验。但当对话历史真的逼近预算阈值时,`ContextCompressor`依然会介入做 Map-Reduce摘要压缩。 所以完整的逻辑是: ``` 窗口 <100k:积极压缩(阈值低,早点压缩) 窗口 ≥100k(long模式):先不压缩 ├─ 对话历史 <预算阈值 →保留完整历史,体验最好└─ 对话历史逼近阈值 →压缩机制介入,摘要替代早期历史``` ## 一句话总结long模式是“**信任大窗口,压缩后置**”:大窗口模型下不做预防性压缩,把压缩当成预算临界时的兜底手段,而不是常规操作。真正的硬约束始终是 `AgentBudget` 的 Token预算,所以不会出现上下文超阈值的情况——只是压缩的触发时机从“比较早”推迟到了“接近160k/800k 上限时”。
点赞
回复 取消回复
喵_coding 2026年09月20日 21:11
引用原文:区别在于 AI Reviewer 的审查标准是 prompt 里定义的。
@派聪明 这句话表达的意思是什么,code review和当前这个Reviewer的区别到底是什么,我看文章中的意思比较偏向于表达“AI Reviewer代指的是code review”呢,是这个意思吗,因为按理来说,reviewer才应该是shencha标准由prompt来定义的才对
点赞
回复1 取消回复
派聪明 2026年09月20日 21:11
这句话的意思是:**AI Reviewer 本质上就是在模拟/自动化 Code Review 这个流程,两者的“角色分工”逻辑完全相同,唯一的区别在于审查标准的来源不同**。 具体拆解一下: **相同点(角色层面)** 文章里做了一个类比: - Planner = Tech Lead 分任务- Worker = 开发写代码- Reviewer =审查者提 comment也就是说,Multi-Agent里的 Reviewer 对应的就是团队里做 Code Review 的那个人,工作内容是一样的:看产出、给结论(通过/不通过)、给反馈意见。 **区别点(标准层面)** -人类 Reviewer 的审查标准来自:他的个人经验、团队规范、沟通中形成的共识等,是“隐性知识”。 - AI Reviewer 的审查标准来自:system prompt 里写死的质量标准和反馈格式(要求输出“通过/不通过 +具体原因”),是“显性定义”。 **你的理解需要修正的地方** 你说“按理来说,reviewer才应该是标准由 prompt 定义的才对”——其实文章正是这个意思。这句话的主语就是 AI Reviewer(Reviewer),说的是它的审查标准由 prompt 定义,和人做 Code Review时的标准来源不同。 你误解的点可能在于:这句话不是说“AI Reviewer 代指 code review”,而是说“AI Reviewer **扮演的角色相当于** code review中的审查者”。Code Review 是一个流程/活动,Reviewer 是流程中的一个角色,两者不是同一个概念,文章是把 AI Reviewer 类比为这个流程里的审查者角色。 一句话总结:**AI Reviewer 干的活就是自动化的 Code Review,区别只在于人类审查靠经验判断,AI审查靠 prompt 里预先写好的标准来判断。**
点赞
回复 取消回复
安静的薯片 2026年09月08日 19:30
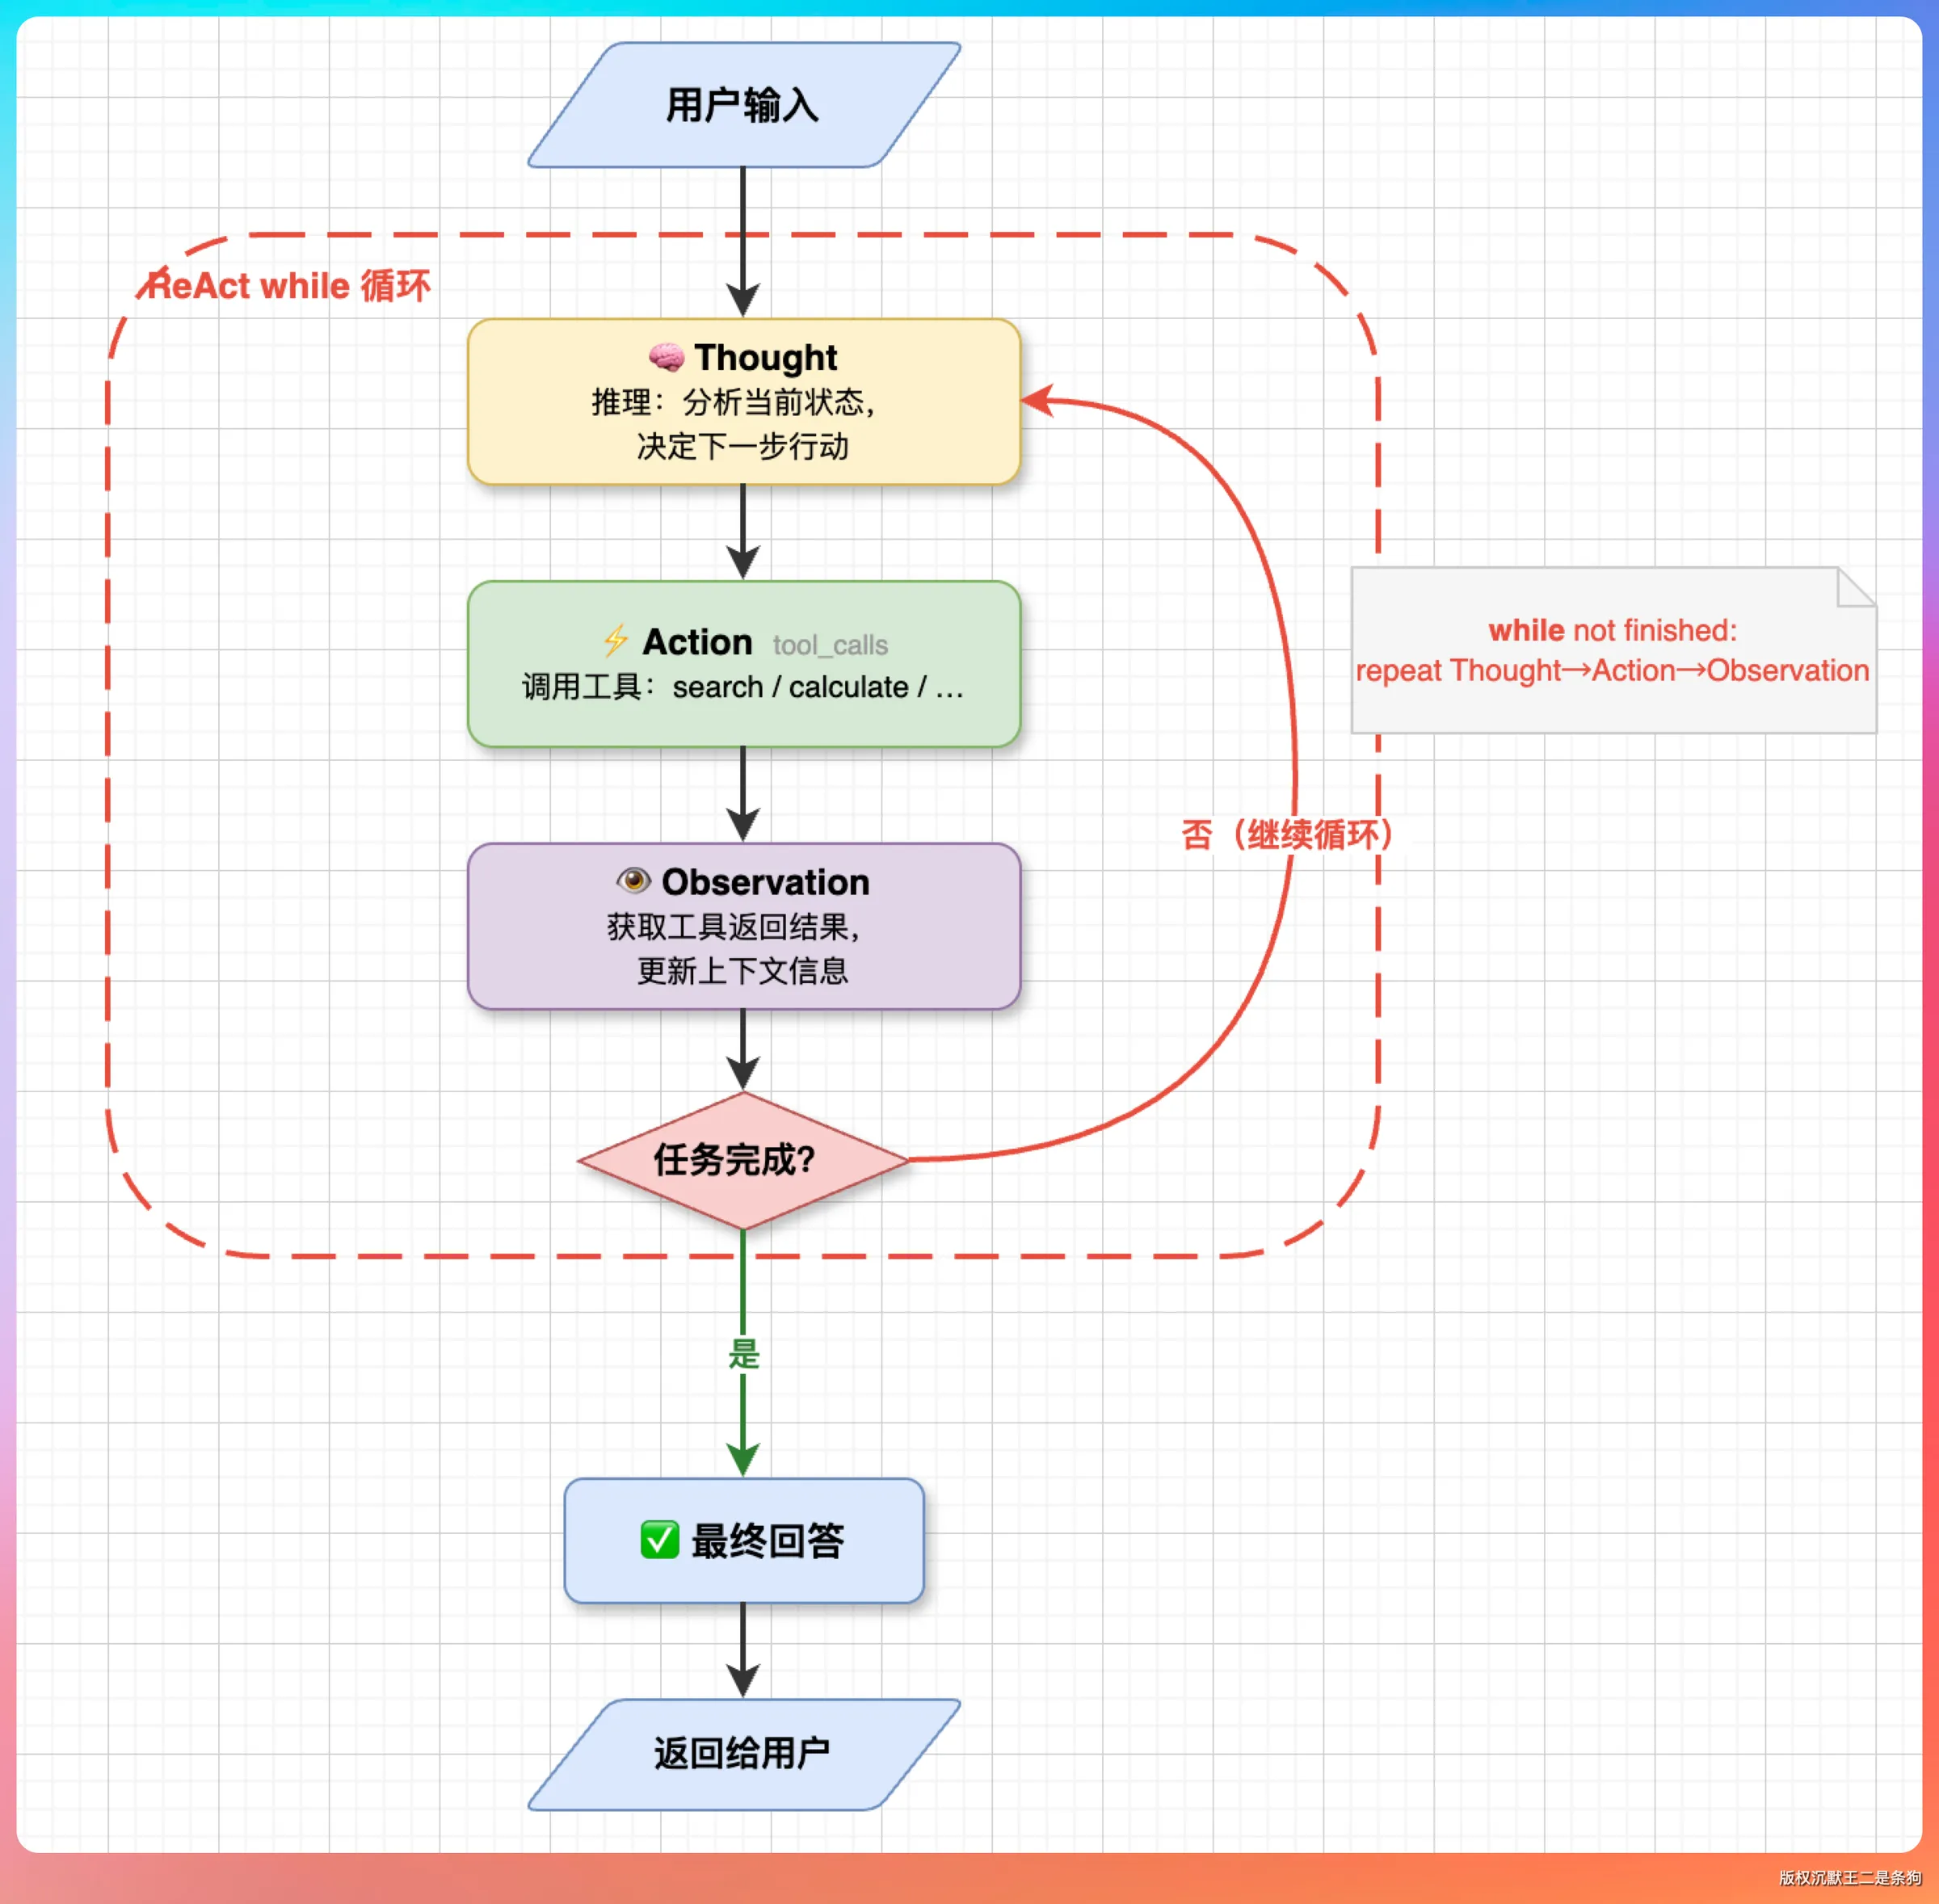
引用原文:Agent 把这段推理塞回去再请求 LLM,LLM 继续自言自语,永远不收尾。
@派聪明 paicli里面不是根据有没有工具调用判断结没结束吗?这种情况不是直接结束咯吗?如果不是,怎么判断是最终答案还是自言自语呢?
点赞
回复1 取消回复
派聪明 2026年09月08日 19:31
# 关于“自言自语死循环”的判断问题你的理解是对的:PaiCLI 的核心退出条件确实是 **LLM响应里没有 `tool_calls` 就退出循环**。所以“永远不收尾”这个说法需要澄清一下。 ##实际会发生什么场景二的真实情况是: 1. LLM返回一段推理文字,**没有 tool_calls** →按退出条件,ReAct循环**确实会结束** 2. 但结束不等于“拿到了正确答案”——那可能只是 LLM 在“自言自语”,比如说了半截“我接下来应该……”就停了,或者输出了一堆没有结论的中间推理所以问题的准确表述是:**循环会终止,但输出的内容不是合格的最终答案**。这就是“自言自语”的危害——不是无限循环,而是**提前以错误的方式终止**。 ## 那“死循环”的说法哪来的? 死循环更多出现在**场景一**(工具反复失败、LLM换参数无限重试),那种情况下 LLM一直返回 tool_calls,循环确实不会自然终止,只能靠防护机制(Token预算、循环上限等)兜住。 ##怎么判断是最终答案还是自言自语? 工程上没有完美的确定性判断,PaiCLI 的做法是组合手段: 1. **System Prompt约束**:明确要求 LLM“如果没有工具可调,必须直接给出面向用户的最终答复,不要输出中间思考” 2. **`reasoning_content` 不进历史**:思考过程只写日志、不回传对话历史,避免 LLM看到自己之前的碎碎念后继续碎碎念,这是从源头减少自言自语的诱因3. **结构化输出要求**:要求最终回复是完整、可直接呈现给用户的答案4. **兜底防护**:即使真的陷入循环(比如一直发无意义的 tool_calls),Token预算、循环上限、用户取消(ESC / `/cancel`)也能强制终止##面试时可以这样说> “严格说,无 tool_calls 时循环会正常退出,所谓‘自言自语’问题是终止时输出的不是合格答案。真正的死循环来自工具反复失败重试。我们的治理思路是:prompt层面约束输出行为,reasoning_content 不回流历史,再配合 Token 预
点赞
回复 取消回复
eating 2026年09月08日 14:21
引用原文:并行工具调用会有冲突吗
@派聪明 multi-Agent模式下如何防止多个woker之间同时写文件冲突呢?
点赞
回复1 取消回复
派聪明 2026年09月08日 14:22
# Multi-Agent模式下如何防止多个 Worker 同时写文件冲突? ##核心思路:架构上避免,而不是靠锁Multi-Agent模式比单 Agent 并行工具调用更可控,因为冲突防范可以在**任务分配阶段**就完成: **1. Planner拆解时消除冲突(最关键)** Planner 在生成任务 DAG 时,会分析各子任务的资源占用。如果两个任务要写同一批文件,会通过 `depends_on` 字段建立依赖关系,把它们放到**不同批次串行执行**,而不是同一批次并行。DAG拓扑排序天然保证了只有“无依赖”的任务才会并行。 ``` 批次1: task_1(改 LoginService.java) 批次2: task_2(更新测试,依赖 task_1) ``` **2. System Prompt约束** Worker 的 prompt(`modes/team-worker.md`)中明确指导:有依赖关系的操作应分轮次执行,避免同轮发起冲突写入。 **3.工程兜底** -每个工具有独立超时,单个卡死不阻塞其他任务- 单个工具/任务失败只影响自身及其下游(标记 SKIPPED),不污染其他任务- Git Side-History 快照机制可回滚错误写入## 为什么不做文件级锁? 做真正的文件锁需要解析工具参数中的路径再做锁管理,成本高,而收益有限——只要 Planner 的依赖分析和 prompt 引导到位,冲突概率本身很低。Claude Code、Cursor 也是同样的思路:**靠 LLM 不犯错 +工程兜底**,而不是细粒度锁。 一句话总结:**冲突在 DAG依赖设计阶段就该被消灭,工程层只做超时和失败隔离兜底。**
点赞
回复 取消回复
A.Mars(水准) 2026年09月08日 10:26
引用原文:第 7 期的并行调度器并行执行
这里具体是怎么实现的@派聪明
点赞
回复1 取消回复
派聪明 2026年09月08日 10:26
同一批次内的任务通过并行调度器并行执行,具体实现(PaiCLI 第7期在 `Agent.java` 中落地,ReAct、Plan、Team 三条路径复用同一套机制): **核心流程** LLM一次响应返回多个 `tool_calls` →提交到 `ExecutorService`线程池并行执行 →等待全部完成(有统一超时兜底)→ **按原始 tool_call顺序**拼装结果 →一起塞回消息历史。 **简化代码** ```javaList<Future<ToolResult>> futures = new ArrayList<>(); for (ToolCall call : toolCalls) { futures.add(executor.submit(() -> toolRegistry.executeTool(call.name(), call.arguments()) )); } //等待所有工具完成,按原始顺序收集结果for (int i =0; i < futures.size(); i++) { results.add(futures.get(i).get(timeout, TimeUnit.SECONDS)); } ``` **为什么按原始顺序拼装很重要**:LLM 的 API协议要求每个 tool message 的 `tool_call_id` 与对应 tool_call严格匹配,乱序会导致模型理解错误。 **性能收益**:I/O密集型操作提升最明显。比如3 个文件读取各100ms,串行需300ms,并行约100ms;对 `execute_command` 这类耗时数秒的命令,并行价值更大。 **冲突处理策略**:不做细粒度文件锁,而是“引导 LLM +工程兜底”——system prompt(`base.md`)中写明“有依赖关系的工具应分多轮调用”;工程层面每个工具独立超时,单个卡死不阻塞其他工具,某工具失败只返回该工具的错误给 LLM,不影响同批次其他结果。Claude Code、Cursor 也是同样思路。 在 Plan-and-Execute 中,`PlanExecuteAgent` 先用 DAG拓扑排序把子任务分批次(同批次内无依赖),同批次任务交由这套并行调度器执行,不同批次间严格串行。
点赞
回复 取消回复
eating 2026年09月08日 10:26
引用原文:并行调度器
@派聪明 并行调度器的工作原理
点赞
回复1 取消回复
派聪明 2026年09月08日 10:26
# 并行调度器的工作原理**并行调度器**是 Agent 中用来同时执行多个工具调用的机制。当 LLM 在一轮响应中返回多个 `tool_calls`(比如同时读3 个文件)时,调度器会把它们提交到 `ExecutorService`线程池并行执行。 ##核心执行流程1. **解析**:从 LLM响应中解析出所有 `tool_calls` 2. **并行提交**:将每个工具调用提交到线程池,每个调用返回一个 `Future` 3. **等待完成**:统一等待全部完成,有超时兜底(如 `execute_command`60秒超时) 4. **按序拼装**:按原始 `tool_call`顺序收集结果——这一点很关键,因为 LLM API协议要求每个 tool message 的 `tool_call_id` 与对应的 tool_call严格匹配,乱序会导致模型理解错误5. **回填历史**:把结果一起塞回消息历史,供 LLM下一轮推理```javaList<Future<ToolResult>> futures = new ArrayList<>(); for (ToolCall call : toolCalls) { futures.add(executor.submit(() -> toolRegistry.executeTool(call.name(), call.arguments()) )); } for (int i =0; i < futures.size(); i++) { results.add(futures.get(i).get(timeout, TimeUnit.SECONDS)); } ``` ## 性能提升对 **I/O密集型操作**提升最明显:3 个文件读取各100ms,串行需300ms,并行约100ms。对 `execute_command` 这类可能耗时数秒的操作,并行收益更大。 ##冲突处理两个工具同时写同一文件属于冲突场景。处理策略是**不做细粒度锁,靠 LLM 不犯错 +工程兜底**: - 在 system prompt 中引导 LLM 把有依赖关系的操作分到不同轮次调用-每个工具有独立超时,单个卡死不阻塞其他工具-某个工具失败只返回该工具的错误,不影响同批次其他结果真正做文件级锁(分析参数中的路径再做锁管理)成本高、收益有限,Claude Code、Cursor 也是同样的思路。 ##复用设计这套并行调度器在 **ReAct、Plan-and-Execute
点赞
回复 取消回复
eating 2026年09月08日 10:19
引用原文:DAG(
@派聪明 DAG是LLM模型生成的吗?
点赞
回复1 取消回复
派聪明 2026年09月08日 10:19
不是,DAG 本身不是 LLM 生成的,它是一种经典的数据结构/算法概念。 准确说,两者分工是: 1. **LLM负责生成“计划”**:Planner角色的 LLM根据任务拆解出子任务列表,并在每个任务的 `depends_on` 字段中声明依赖关系(比如 task_2依赖 task_1)。 2. **程序代码负责构建和执行 DAG**:`ExecutionPlan.java`拿到 LLM返回的这份结构化任务定义后,将其构建为有向无环图,再用拓扑排序把任务分批次,同批次并行执行、不同批次串行。 所以可以理解为:**LLM提供图的数据(节点和边),工程代码负责图的构建、排序和调度**。 面试时可以补充一句:因为依赖关系是 LLM声明的,代码层还需校验其合法性(如是否成环、依赖的任务是否存在),这正是“LLM 不确定性需要工程兜底”的典型例子。
点赞
回复 取消回复
eating 2026年09月07日 22:43
引用原文:long 模式
@派聪明 long模式是什么意思?为什么要跳过摘要压缩呢,我感觉都到不了80%这个阈值,本身就不会触发压缩
点赞
回复1 取消回复
派聪明 2026年09月07日 22:44
## 什么是 "long模式”? long模式是 PaiCLI 第12期“长上下文工程”中引入的一种上下文管理策略。当检测到模型上下文窗口 ≥100k token(如 GLM-5.1 的200k、DeepSeek V4 的1M)时,Agent 自动进入 long模式,**直接跳过 Map-Reduce摘要压缩这一步**;窗口较小的模型则仍走原来的“接近阈值就压缩”的路径。 ##为什么要跳过摘要压缩? 核心原因是:**在这么大的窗口下,日常开发对话根本用不满预算,压缩大概率永远不会触发,即使触发也是接近尾声了**。 你的感觉其实是对的——这正是这个设计的前提。以200k窗口为例: -预算 =200k ×80% =160k token 可用-减去 system prompt(含分层 Markdown prompt)、tools 定义(9 内置 +60+ MCP工具的 JSON Schema)后,剩余空间仍然非常充裕-日常一问一答、读几个文件、改几处代码的会话,对话历史很难膨胀到160k那既然到不了阈值、不会触发压缩,为什么还要专门做“跳过”这个动作?价值在于: 1. **避免误伤**:压缩逻辑一旦触发,早期对话被摘要替代是有信息损失的(LLM看不到原始细节)。大窗口下能不压缩就不压缩,保留完整上下文的体验明显更好——这是“不压缩体验更好”的直接含义。 2. **判断成本与收益**:`ContextCompressor`需要实时跟踪 token 数、分段调用 LLM做摘要(额外消耗多次 LLM调用)。如果对话注定用不满预算,这套机制就是纯开销。 3. **极端情况的兜底仍在**:跳过压缩不等于放弃防护。如果工具结果特别大(比如反复读取大文件),历史真的逼近预算,`AgentBudget` 的硬上限仍会触发强制终止——只是日常路径上不再做主动压缩。 一句话总结:long模式不是“取消了预算”,而是承认大窗口模型下压缩很少派上用场,与其保留一套低频且有损的机制,不如默认保留完整对话历史,把压缩留给真正需要的场景。
点赞
回复 取消回复
eating 2026年09月07日 22:10
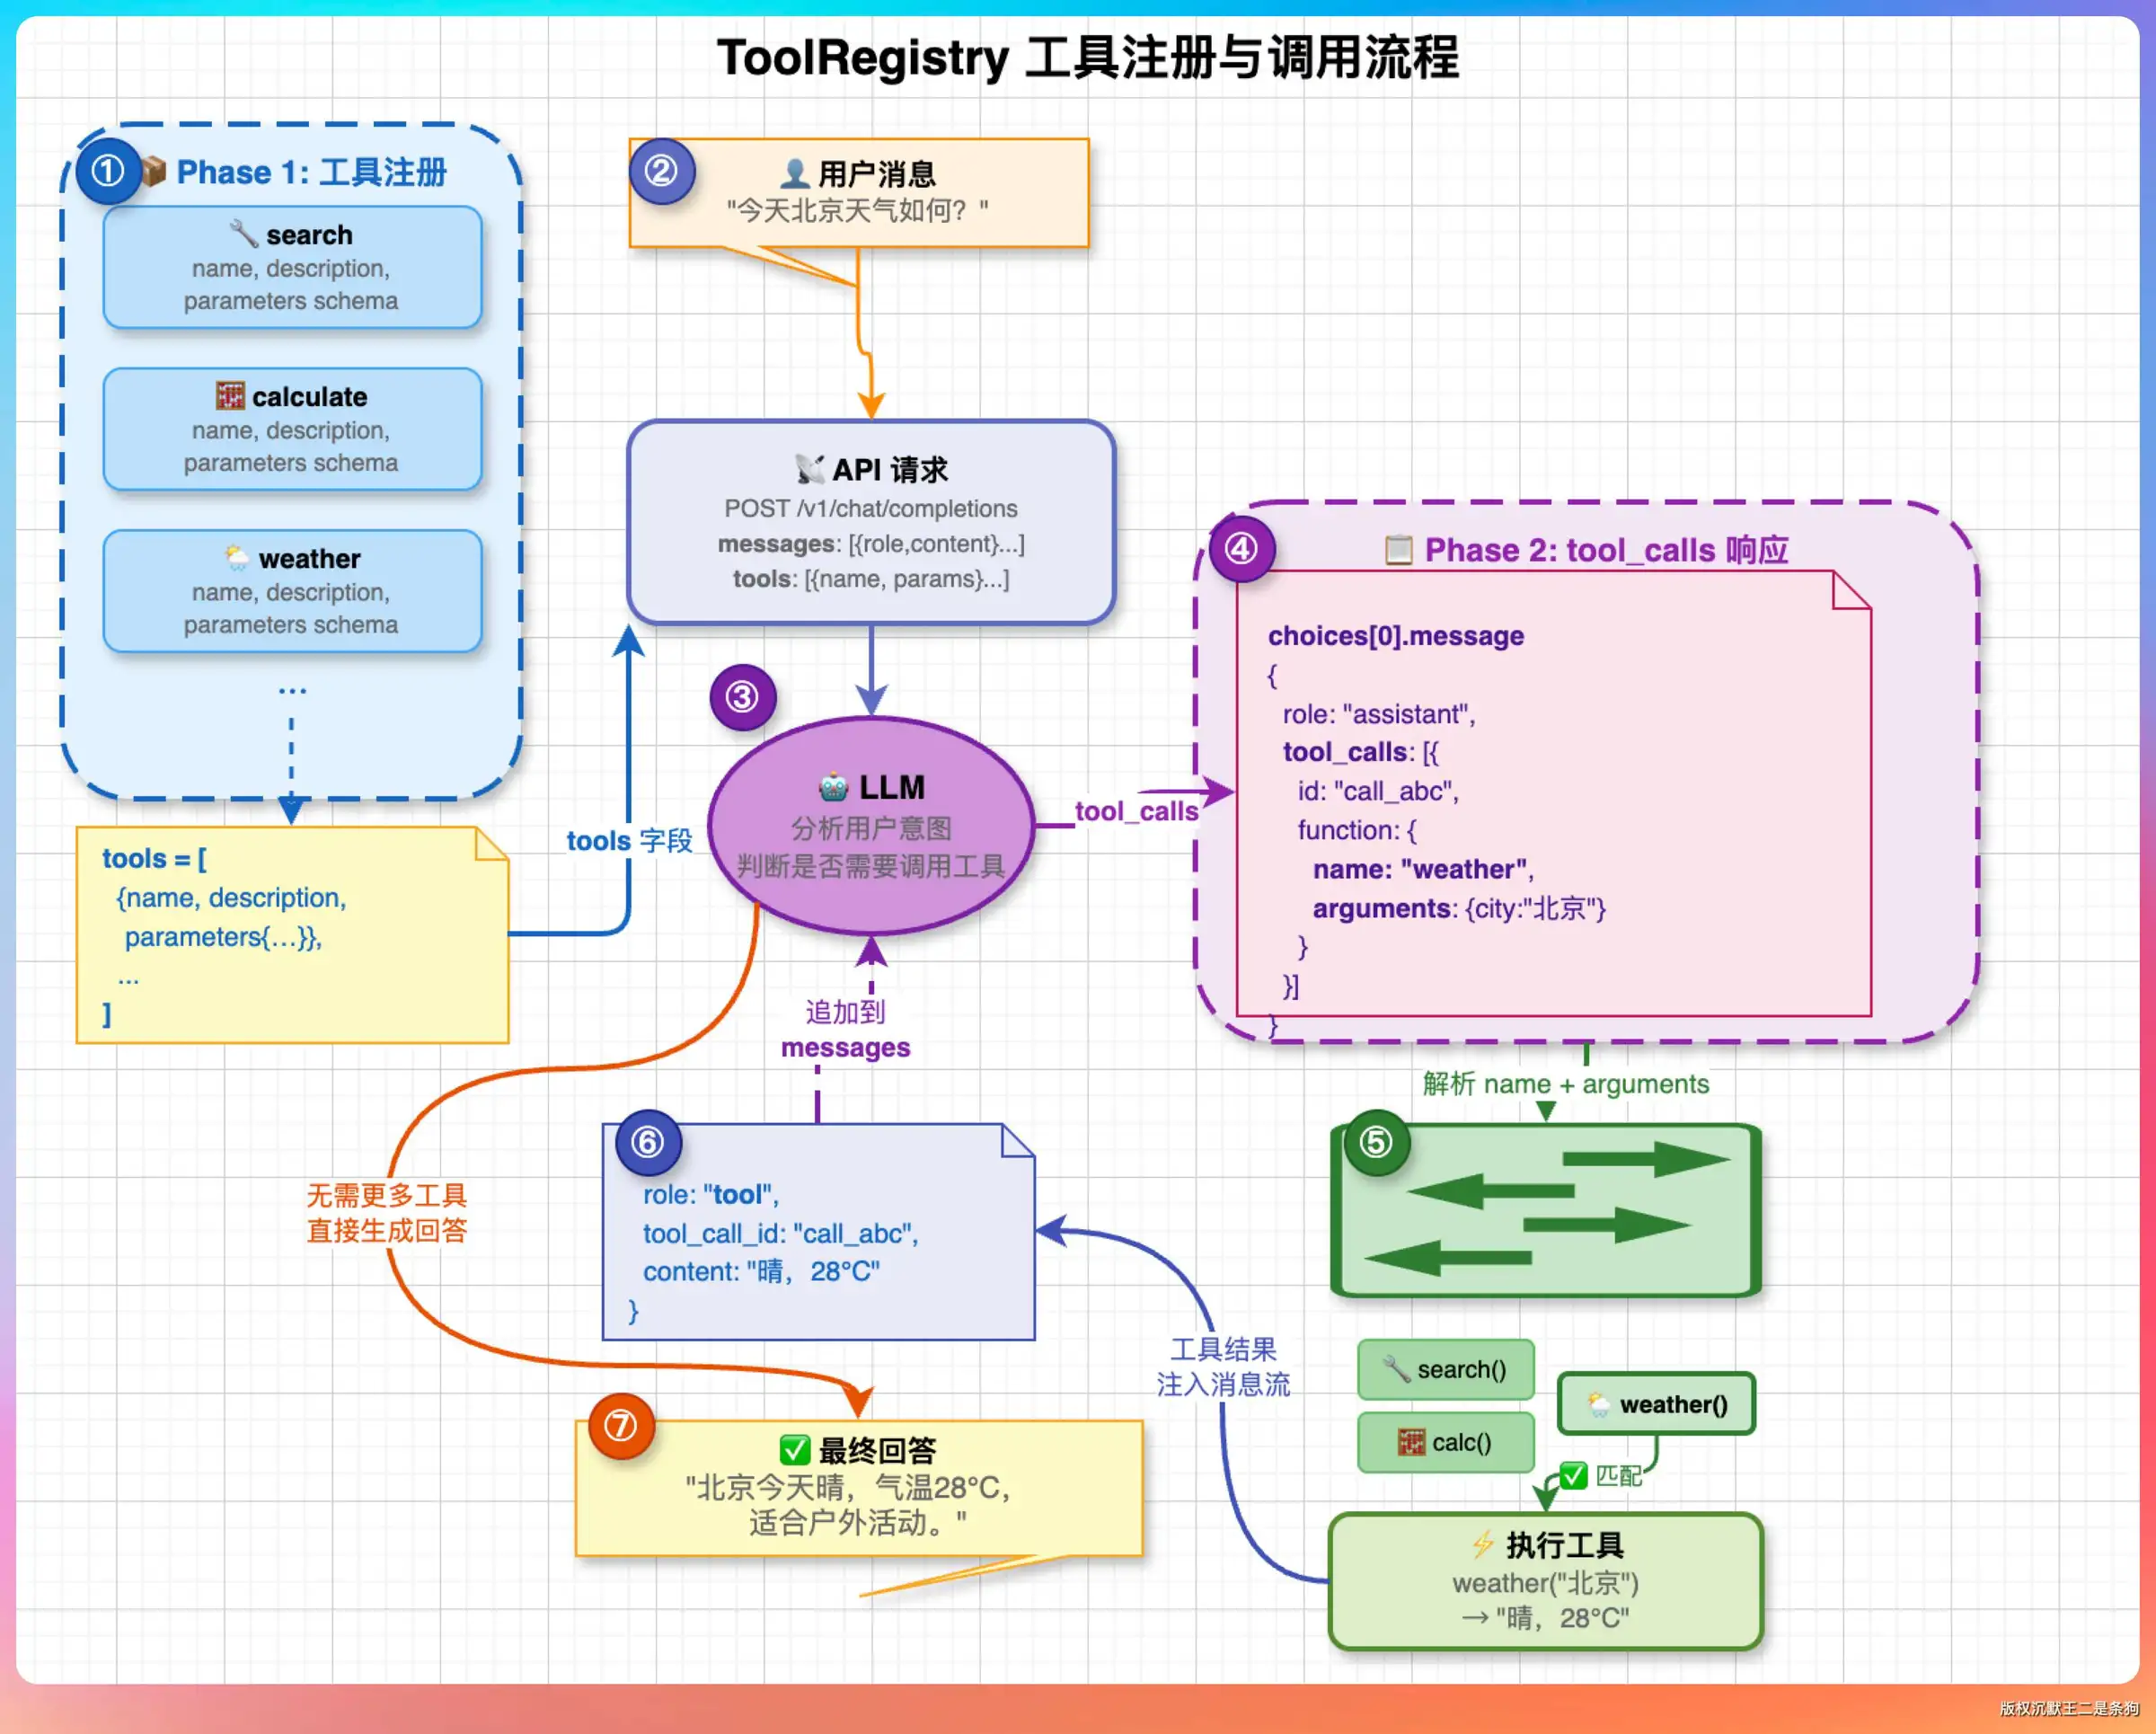
引用原文:返回不存在的工具名
@派聪明 为什么会返回不存在的工具名
点赞
回复1 取消回复
派聪明 2026年09月07日 22:10
LLM返回不存在的工具名,本质上是**大模型的概率性输出特性**导致的,具体原因有: **1. LLM 本身不是确定性系统** Agent 把所有工具定义(名称+描述+参数 Schema)放在请求体的 `tools` 字段发给 LLM,由 LLM 根据 Function Calling协议生成 `tool_calls`。但 LLM 是基于概率预测下一个 token 的,它完全可能“编造”一个看起来合理但注册表里不存在的工具名,比如把 `read_file` 写成 `readFile` 或 `open_file`。 **2.工具描述写得不好** 这是最常见的原因。比如工具描述太简洁或语义重叠,LLM 无法准确区分该用哪个工具,就可能自己“发明”一个名字。文章中的实际案例:PaiCLI早期 `execute_command`描述太简单,LLM 就经常用 `cat`命令代替 `read_file`去读文件。 **3. System Prompt 或上下文误导** 如果对话历史里有类似工具名的残留信息,或 system prompt提到了未注册的能力,LLM 会顺着“幻觉”出一个工具调用。 **怎么处理?** PaiCLI 的 `ToolRegistry.executeTool()`做了兜底:找不到工具就返回 `"未知工具: xxx"`,这个错误信息作为 tool message塞回对话历史,LLM下一轮看到后会自动修正。 **关键经验**:如果 LLM 反复返回不存在的工具名,说明问题出在 prompt层面,应该去**优化工具描述和 system prompt**,而不是不断加兜底逻辑。工具描述的质量直接决定 LLM选择的准确率。
点赞
回复 取消回复
忐忑的羽毛 2026年09月07日 19:07
引用原文:PaiCLI 的 Plan-and-Execute 当前没有任务级重试
@派聪明,请你解释一下
点赞
回复3 取消回复
派聪明 2026年09月07日 19:07
这句话出自关于 Multi-Agent 与 Plan-and-Execute失败处理机制的讨论(对应原文第05节“DAG 是怎么工作的”)。 **含义解释** 在 PaiCLI 的 Plan-and-Execute模式下,如果某个子任务执行失败,系统**不会自动重新执行该任务**。它的处理策略是: -失败的任务标记为 `FAILED` -依赖它的下游任务自动标记为 `SKIPPED`(跳过,不执行) - 与它无依赖关系的其他任务照常继续执行也就是说,失败就是“认了”,只做隔离止损,不做自动重试。 **为什么这样设计** 原文指出这是**有意的设计选择**:Plan模式的核心价值在于**可预测性**——用户在执行前已确认过计划,如果系统在背后自动反复重试,执行过程会变得不可控,用户难以预期结果。 **对比:Multi-Agent模式有重试** 与之形成对比的是,Multi-Agent(/team)模式下,Reviewer审查不通过时会把反馈拼给 Worker **重做,最多重试2 次**。原因是该模式的目标是质量保障,且重试有成本(每次重试约消耗2轮 LLM调用),所以设了上限。 **一句话总结**:不同架构模式的失败策略服务于不同目标——Plan模式求“可控”所以不重试,Multi-Agent模式求“质量”所以有限重试。
点赞
回复 取消回复
展开剩余 2 条回复

目录