
AI Agent 面试题第七弹:多模型适配、运行时切换、成本控制 12 题
老王这次没废话,直接开问:“PaiCLI 接了几家大模型?”
“目前支持 GLM、DeepSeek、Kimi、StepFun。”
“那你 API 调用的代码是不是写了四遍?”老王的语气里带着一点挑衅。
我笑了:“那不至于,一个基类搞定,每个 Provider 实现就二三十行。”
01、怎么设计一个支持多模型的 LLM 客户端接口?
策略模式。定义一个统一接口,每个模型的 Provider 自己实现差异化逻辑。
接口需要声明两组能力。
第一组是行为能力,也就是对话方法。一般设计两个 chat 方法,一个带流式监听器参数,一个不带。不带监听器的方法内部调用带监听器的。
第二组是声明式能力。包括模型名称、Provider 名称、最大上下文窗口、是否支持提示词缓存、缓存模式等等。
public interface LlmClient {
    ChatResponse chat(List messages, List tools) throws IOException;
    ChatResponse chat(List messages, List tools,
                      StreamListener listener) throws IOException;
    String getModelName();
    String getProviderName();
    default int maxContextWindow() { return 128_000; }
    default boolean supportsPromptCaching() { return false; }
    default String promptCacheMode() { return "none"; }
}
为什么要把能力声明放在接口里?
因为上下文管理模块需要根据模型能力做策略调整。
短期记忆预算、压缩触发阈值、MCP 资源索引,这些参数全部可以从上下文窗口大小推导出来。
接口声明了这些能力后,上层不需要写 if-else 判断“当前是哪个模型”,直接读接口方法的返回值就行。
四个 Provider 实现类共享一个基类,负责通用的 SSE 解析和 HTTP 请求逻辑,每个子类只覆盖 API 地址、默认模型名、API Key 来源这几个差异点。
02、模板方法模式在多模型适配里怎么用?
都兼容 OpenAI 协议。
就是把相同的部分提到基类里,子类只覆盖差异点。
基类的 chat 方法定义了完整的 SSE 请求-响应流程:构建请求体、发送 HTTP 请求、逐行解析 SSE 流、合并增量 tool_calls、提取 usage 统计、返回最终响应等。
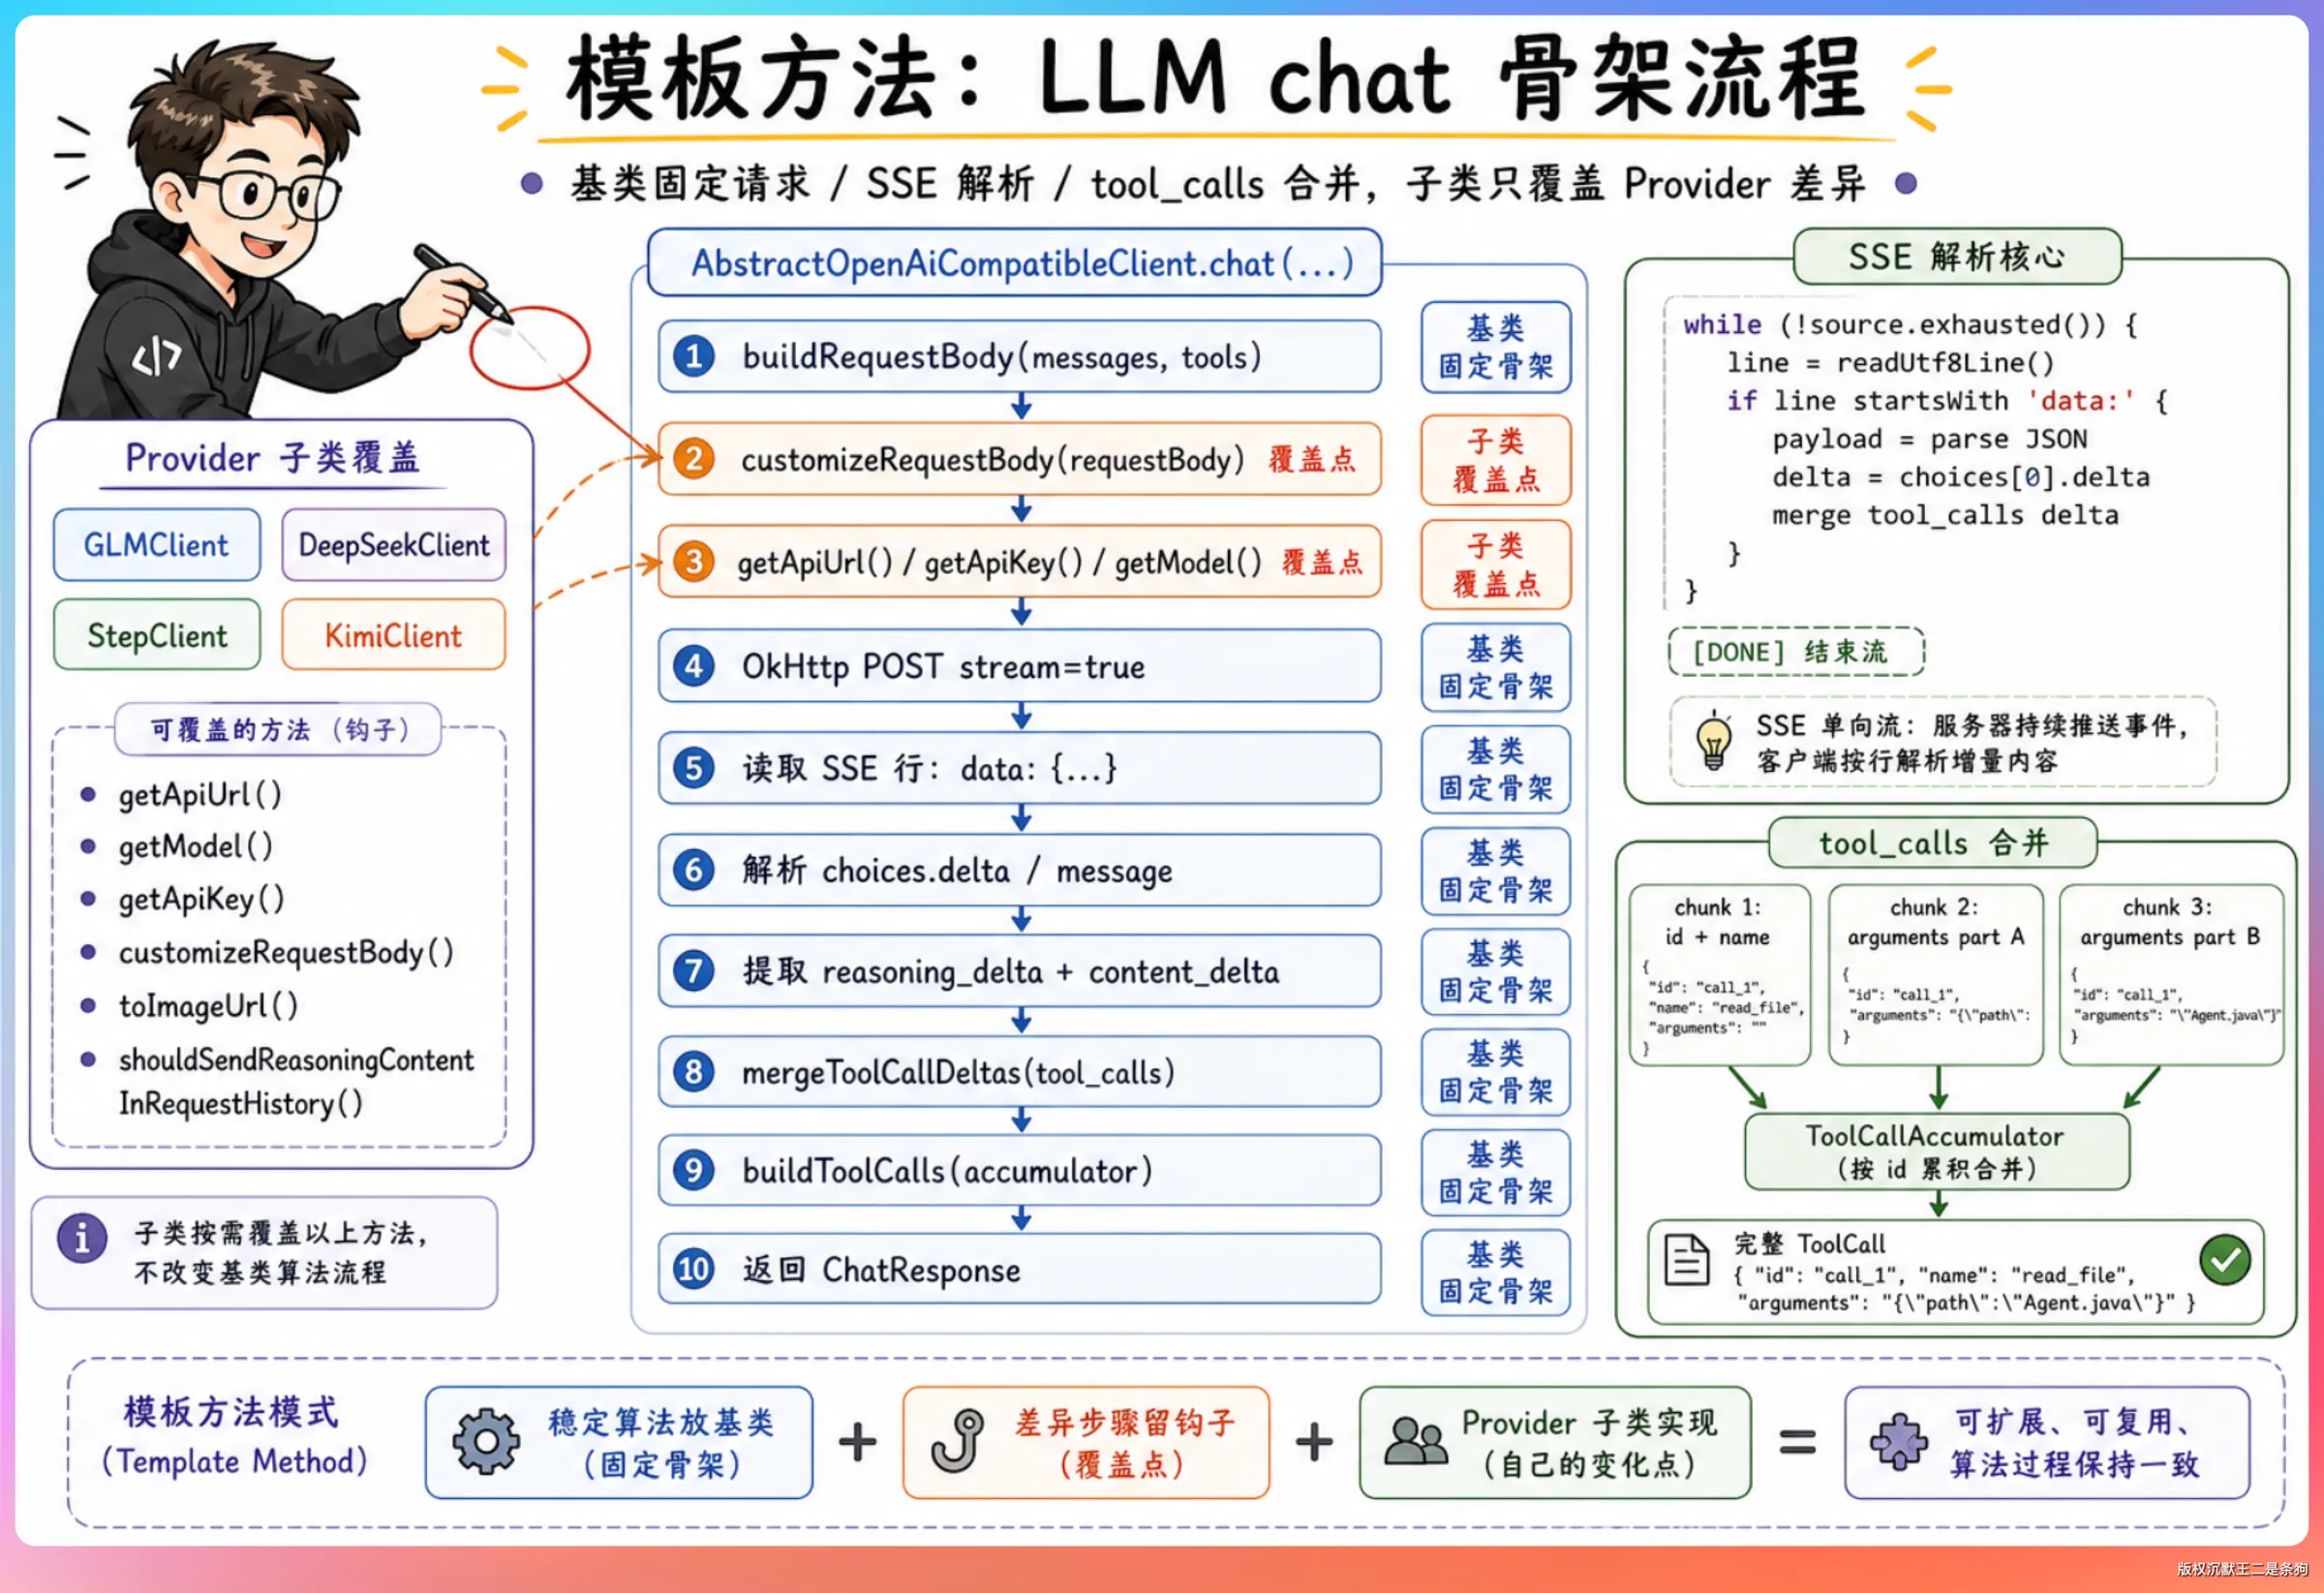
所有 Provider 都是一样的。
子类只需要覆盖三个抽象方法:API 端点地址、默认模型名、API Key。
拿 DeepSeek 的实现来说,整个类不到 60 行代码,SSE 解析、tool_calls 合并、HTTP 超时处理一行没写,全在基类里。
// DeepSeek 的实现,继承基类后只需覆盖差异点
protected String getApiUrl() { return "https://api.deepseek.com/chat/completions"; }
protected String getModel()  { return "deepseek-v4-flash"; }
protected String getApiKey() { return apiKey; }
public int maxContextW...企业级Agent工作流编排项目PaiFlow
Vibe Coding版本的PaiAgent
派聪明RAG AI知识库Java版本+Go版本
微服务 PmHub、技术派、MYDB
求职派JobClaw(OpenClaw/Hermes架构
PaiCLI(类似Claude Code的Agent
派简历(代码已完成)
等实战项目。
1. 微信扫右侧的优惠券加入知识星球
2. 解锁星球的实战项目教程和源码: 项目源码+教程获取
1人已点赞

热门评论
27 条评论
回复