杠精派
派聪明
0/512

热门评论

东呆西萌 2026年07月13日 16:32
引用原文:Task 类设计
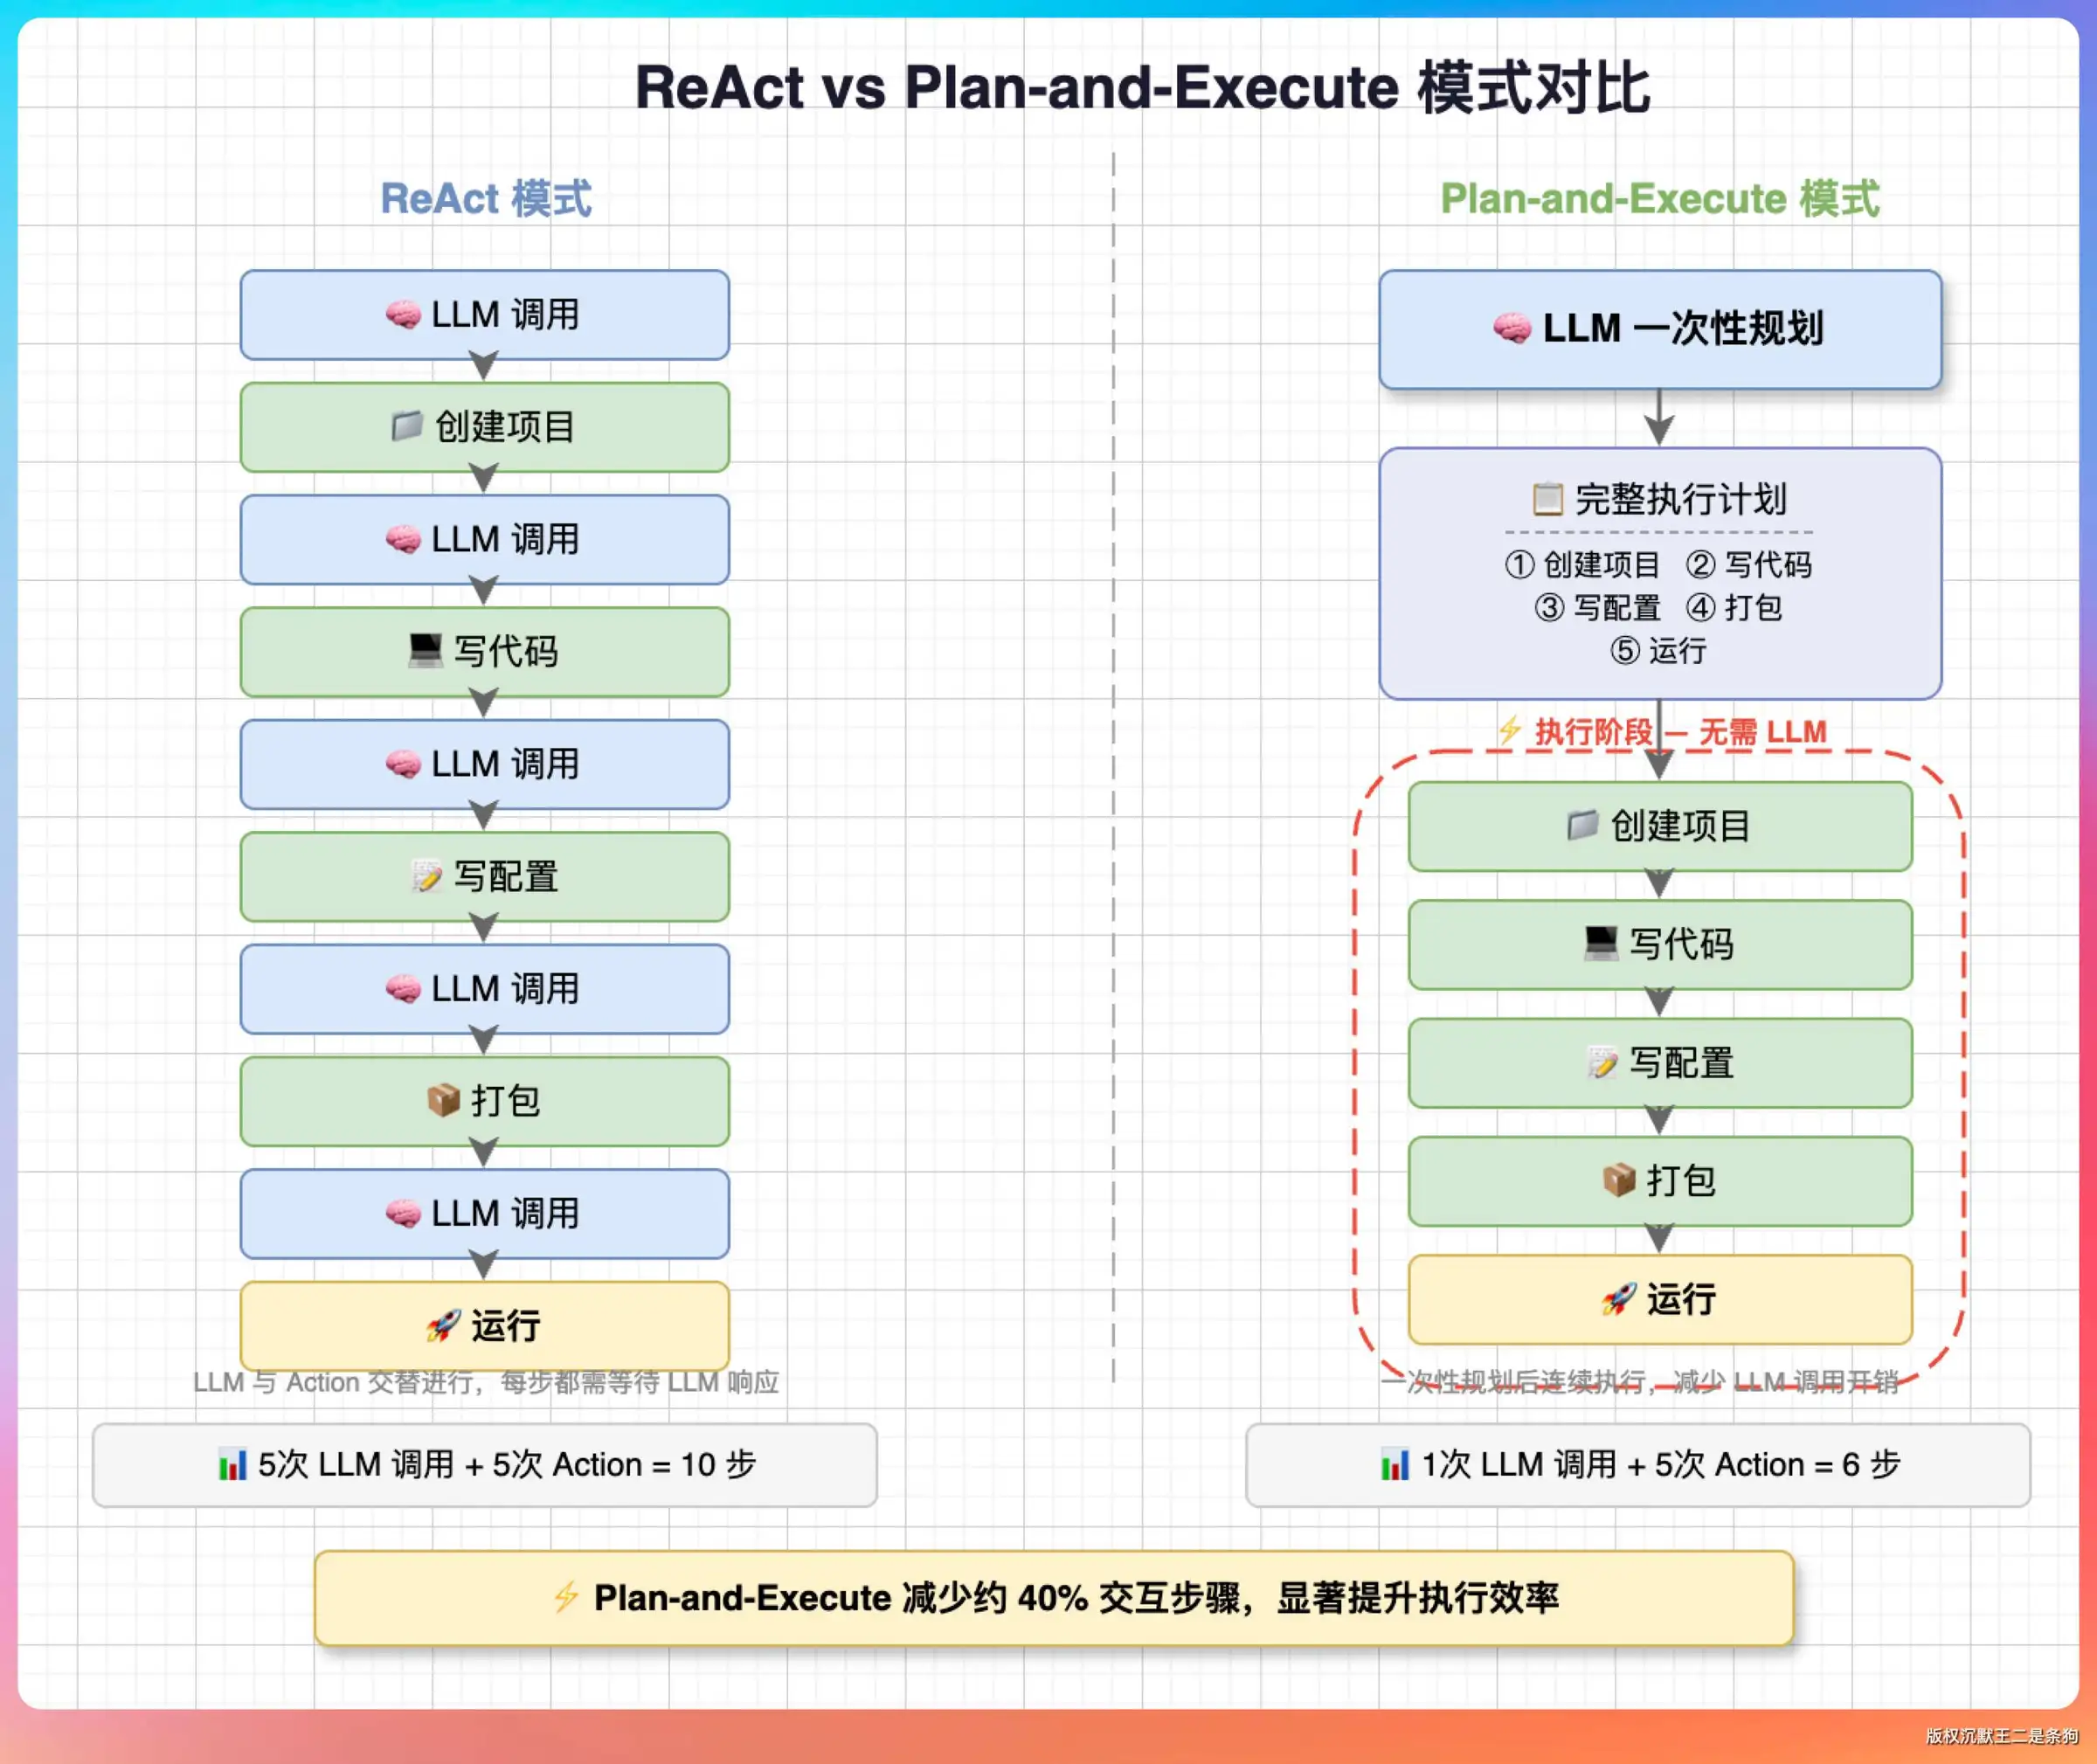
@派聪明 在 Plan-and-Execute 中,执行每一个任务时,虽然是在本地上执行的,但是在这个任务类里面并没有记录完成当前任务所需要的工具,如果执行任务的过程中需要使用tool,不是还要调用大模型吗?所以我不太理解为什么会说Plan-and-Execute只需要调用一次大模型,并且这还是它相较于ReAct的优势
点赞
回复11 取消回复
派聪明 2026年07月13日 16:32
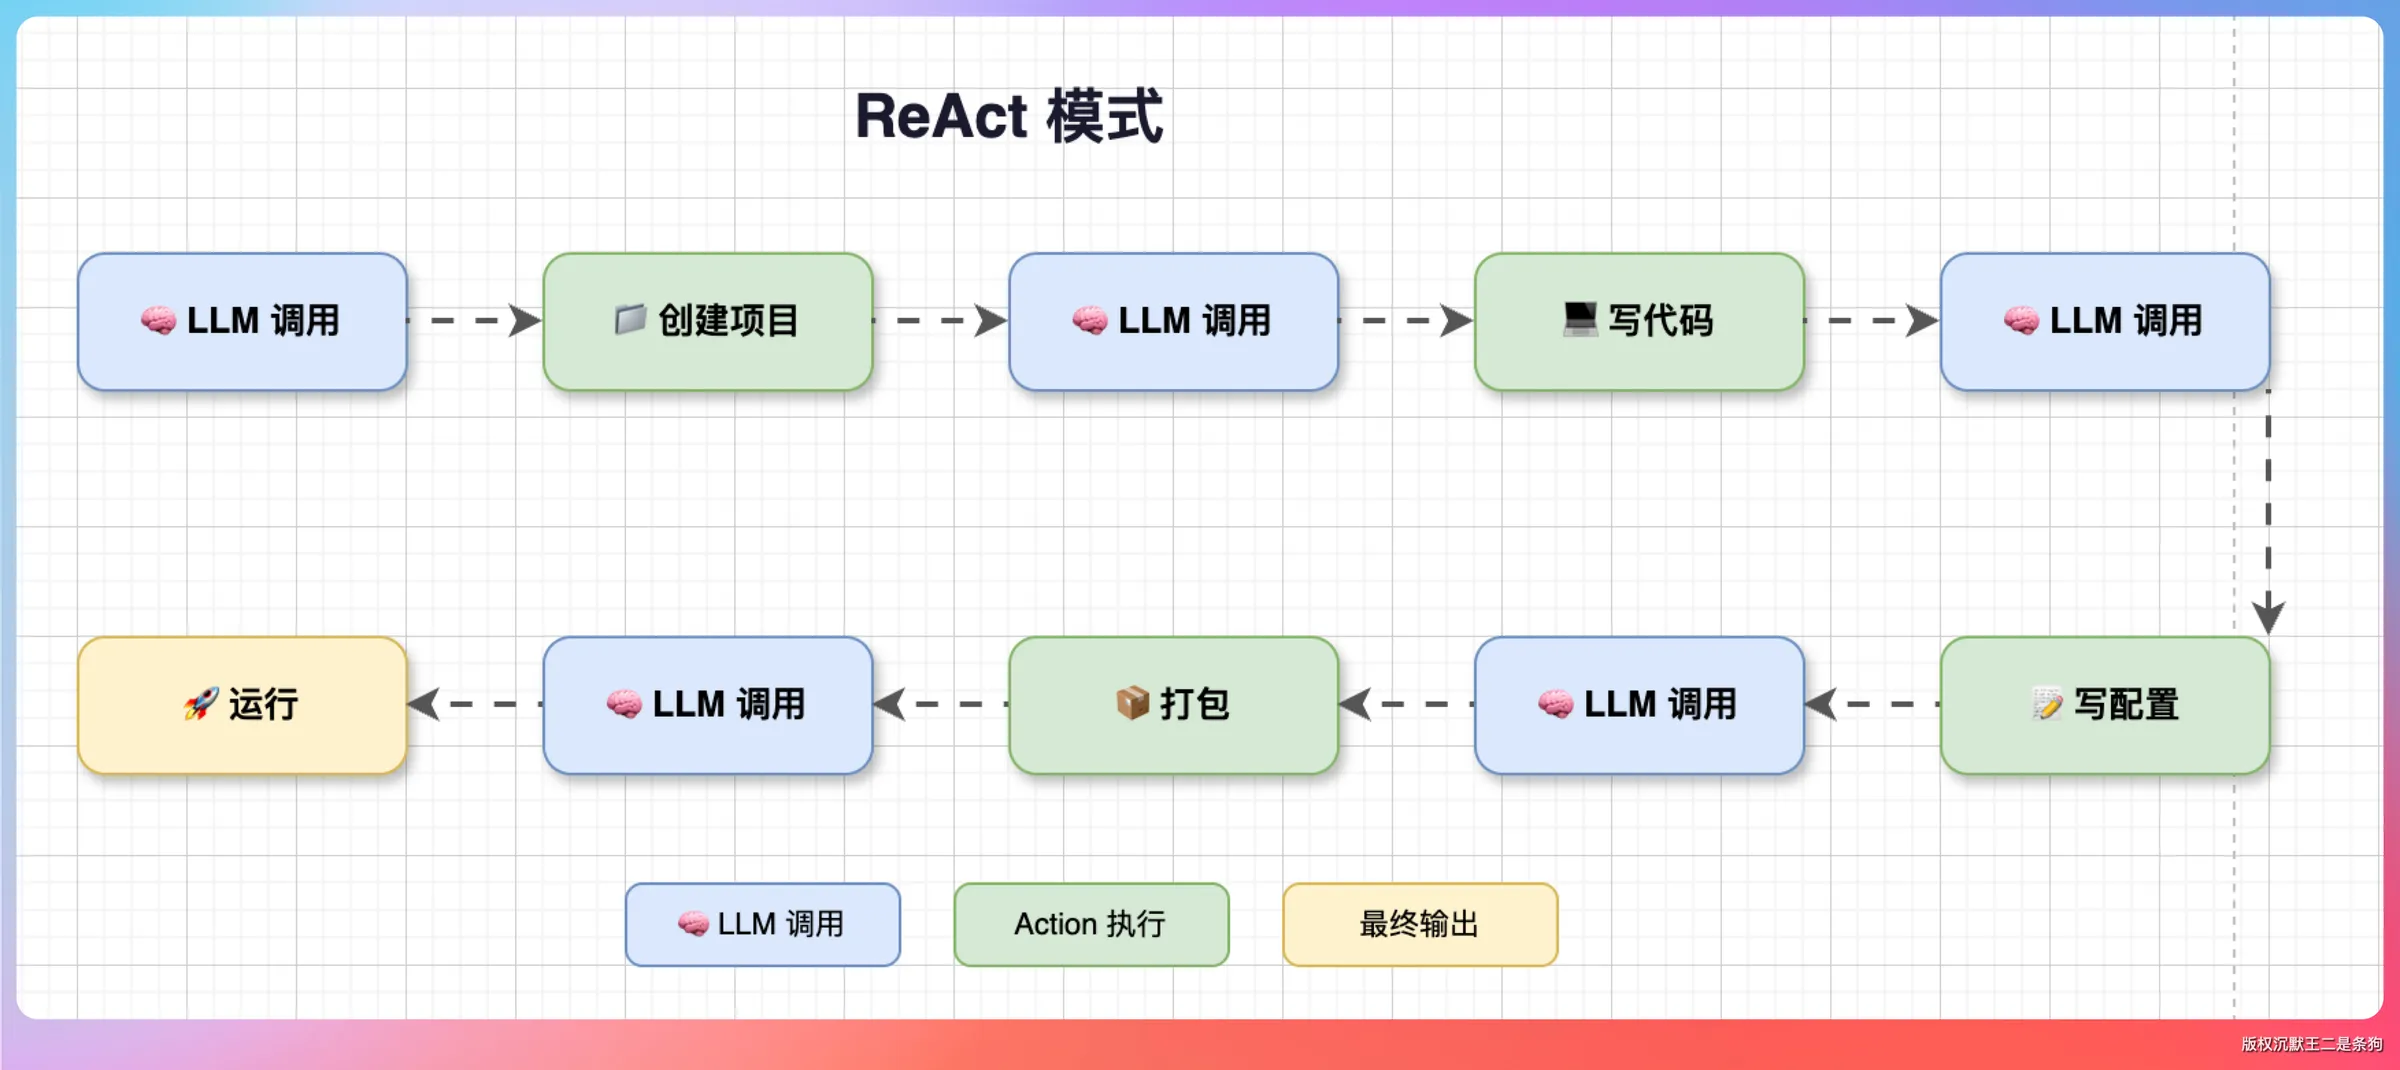
你这个问题问得非常准,说明你对 Agent 的工作原理思考得很深入。我来帮你把这个模糊地带彻底理清。 --- ## 核心误解:「只调一次 LLM」指的是「推理层」,不是「工具执行层」 在 Plan-and-Execute 中,**「只调一次 LLM」的意思是:只调用一次 LLM 来进行「决策/推理」**,而不是说整个过程完全不用 LLM。 ### 关键区分:工具执行 vs. 决策推理 | 环节 | ReAct | Plan-and-Execute | |------|-------|------------------| | **决策/推理**(下一步做什么) | 每步都调 LLM | **只调一次**(规划阶段) | | **工具执行**(读写文件、跑命令) | 代码执行 | 代码执行(两者一样) | ### 为什么 ReAct 需要多次调 LLM? ReAct 的模式是:「思考→行动→观察→再思考→再行动→…」 ``` LLM思考:"我需要创建一个Java项目" → 调用工具创建项目(代码执行) → 把结果返给LLM → LLM再思考:"现在要写Hello类" → 调用工具写文件(代码执行) → 再把结果返给LLM → ... ``` **每一轮「思考」都要调用一次 LLM**,这是最耗时的部分(网络往返 + 大模型推理)。 ### Plan-and-Execute 省掉的是什么? 计划阶段,LLM 一次性输出了完整的任务清单: ``` task1: "创建一个Java项目叫demo" → 工具:COMMAND("mvn archetype:generate ...") task2: "写一个Hello类" → 工具:FILE_WRITE("src/main/java/Hello.java", 内容) task3: "编译运行" → 工具:COMMAND("mvn compile && java Hello") ``` **执行阶段**,每个任务对应的工具调用是预先确定的、**写死在任务描述里的**,代码直接按计划执行工具,不需要再问 LLM: ```java // 伪代码 - 执行器直接按计划做事,不调LLM if (task.getType() == COMMAND) { Runtime.exec(task.getDescription()); // 直接执行命令 } if (task.getType() == FILE_WRITE) { Files.write(路径, 内容); // 直接写文件 } ``` **没有「思考」环节,只有「机械执行」**。这就是省掉 LLM 调用的地方。 --- ## 那你说的「执行中需要 tool 怎么办?」 你担心的其实是:**如果工具执行的结果需要分析/决策,不还是得调 LLM 吗?** 对的,这时确实需要。但参考资料已经给出了解决方案: ### 1. 把「分析/决策」也建模成一个任务 ``` task5 (ANALYSIS类型): "分析编译输出,判断是否成功" ``` 这个任务内部**可以调 LLM**。但整个计划里只有这一个分析任务需要 LLM,而不是每一步都要。 ### 2. 失败时重新规划 如果某个任务失败,触发 `replan()`,基于已完成进度重新规划一次——**又是一次 LLM 调用,但不是每步都调**。 ### 3. 混合模式(最实用的方案) 参考资料最后也说了: > 用 Plan-and-Execute 制定整体计划 > 每个任务内部用 ReAct 执行 > 如果某步失败,用 ReAct 分析原因 也就是说,**宏观上 Plan-and-Execute 节省了大部分「无用思考」的 LLM 调用**,但对于真正需要分析决策的步骤,仍然可以调 LLM。 --- ## 用数字对比一下更直观 **场景:创建一个 Spring Boot 项目 + 写 REST API + 编译运行** | 模式 | LLM 调用次数 | 耗时大头 | |------|-------------|---------| | 纯 ReAct | **5 次**(每次都要网络往返) | 等待 LLM 响应 | | Plan-and-Execute | **1 次**(规划) + 可能 1 次(分析结果) | 本地执行 | 所以「只调一次大模型」是**相对于 ReAct 每步都调而言的**,不是说工具执行不需要调 LLM——工具执行本来就不需要调 LLM,它只是本地代码执行。**省掉的是那些「无意义的中间思考轮次」**。
点赞
回复 取消回复
展开剩余 10 条回复

57 条评论

是你啊 2026年09月06日 23:03
引用原文:拓扑排序算法把 DAG
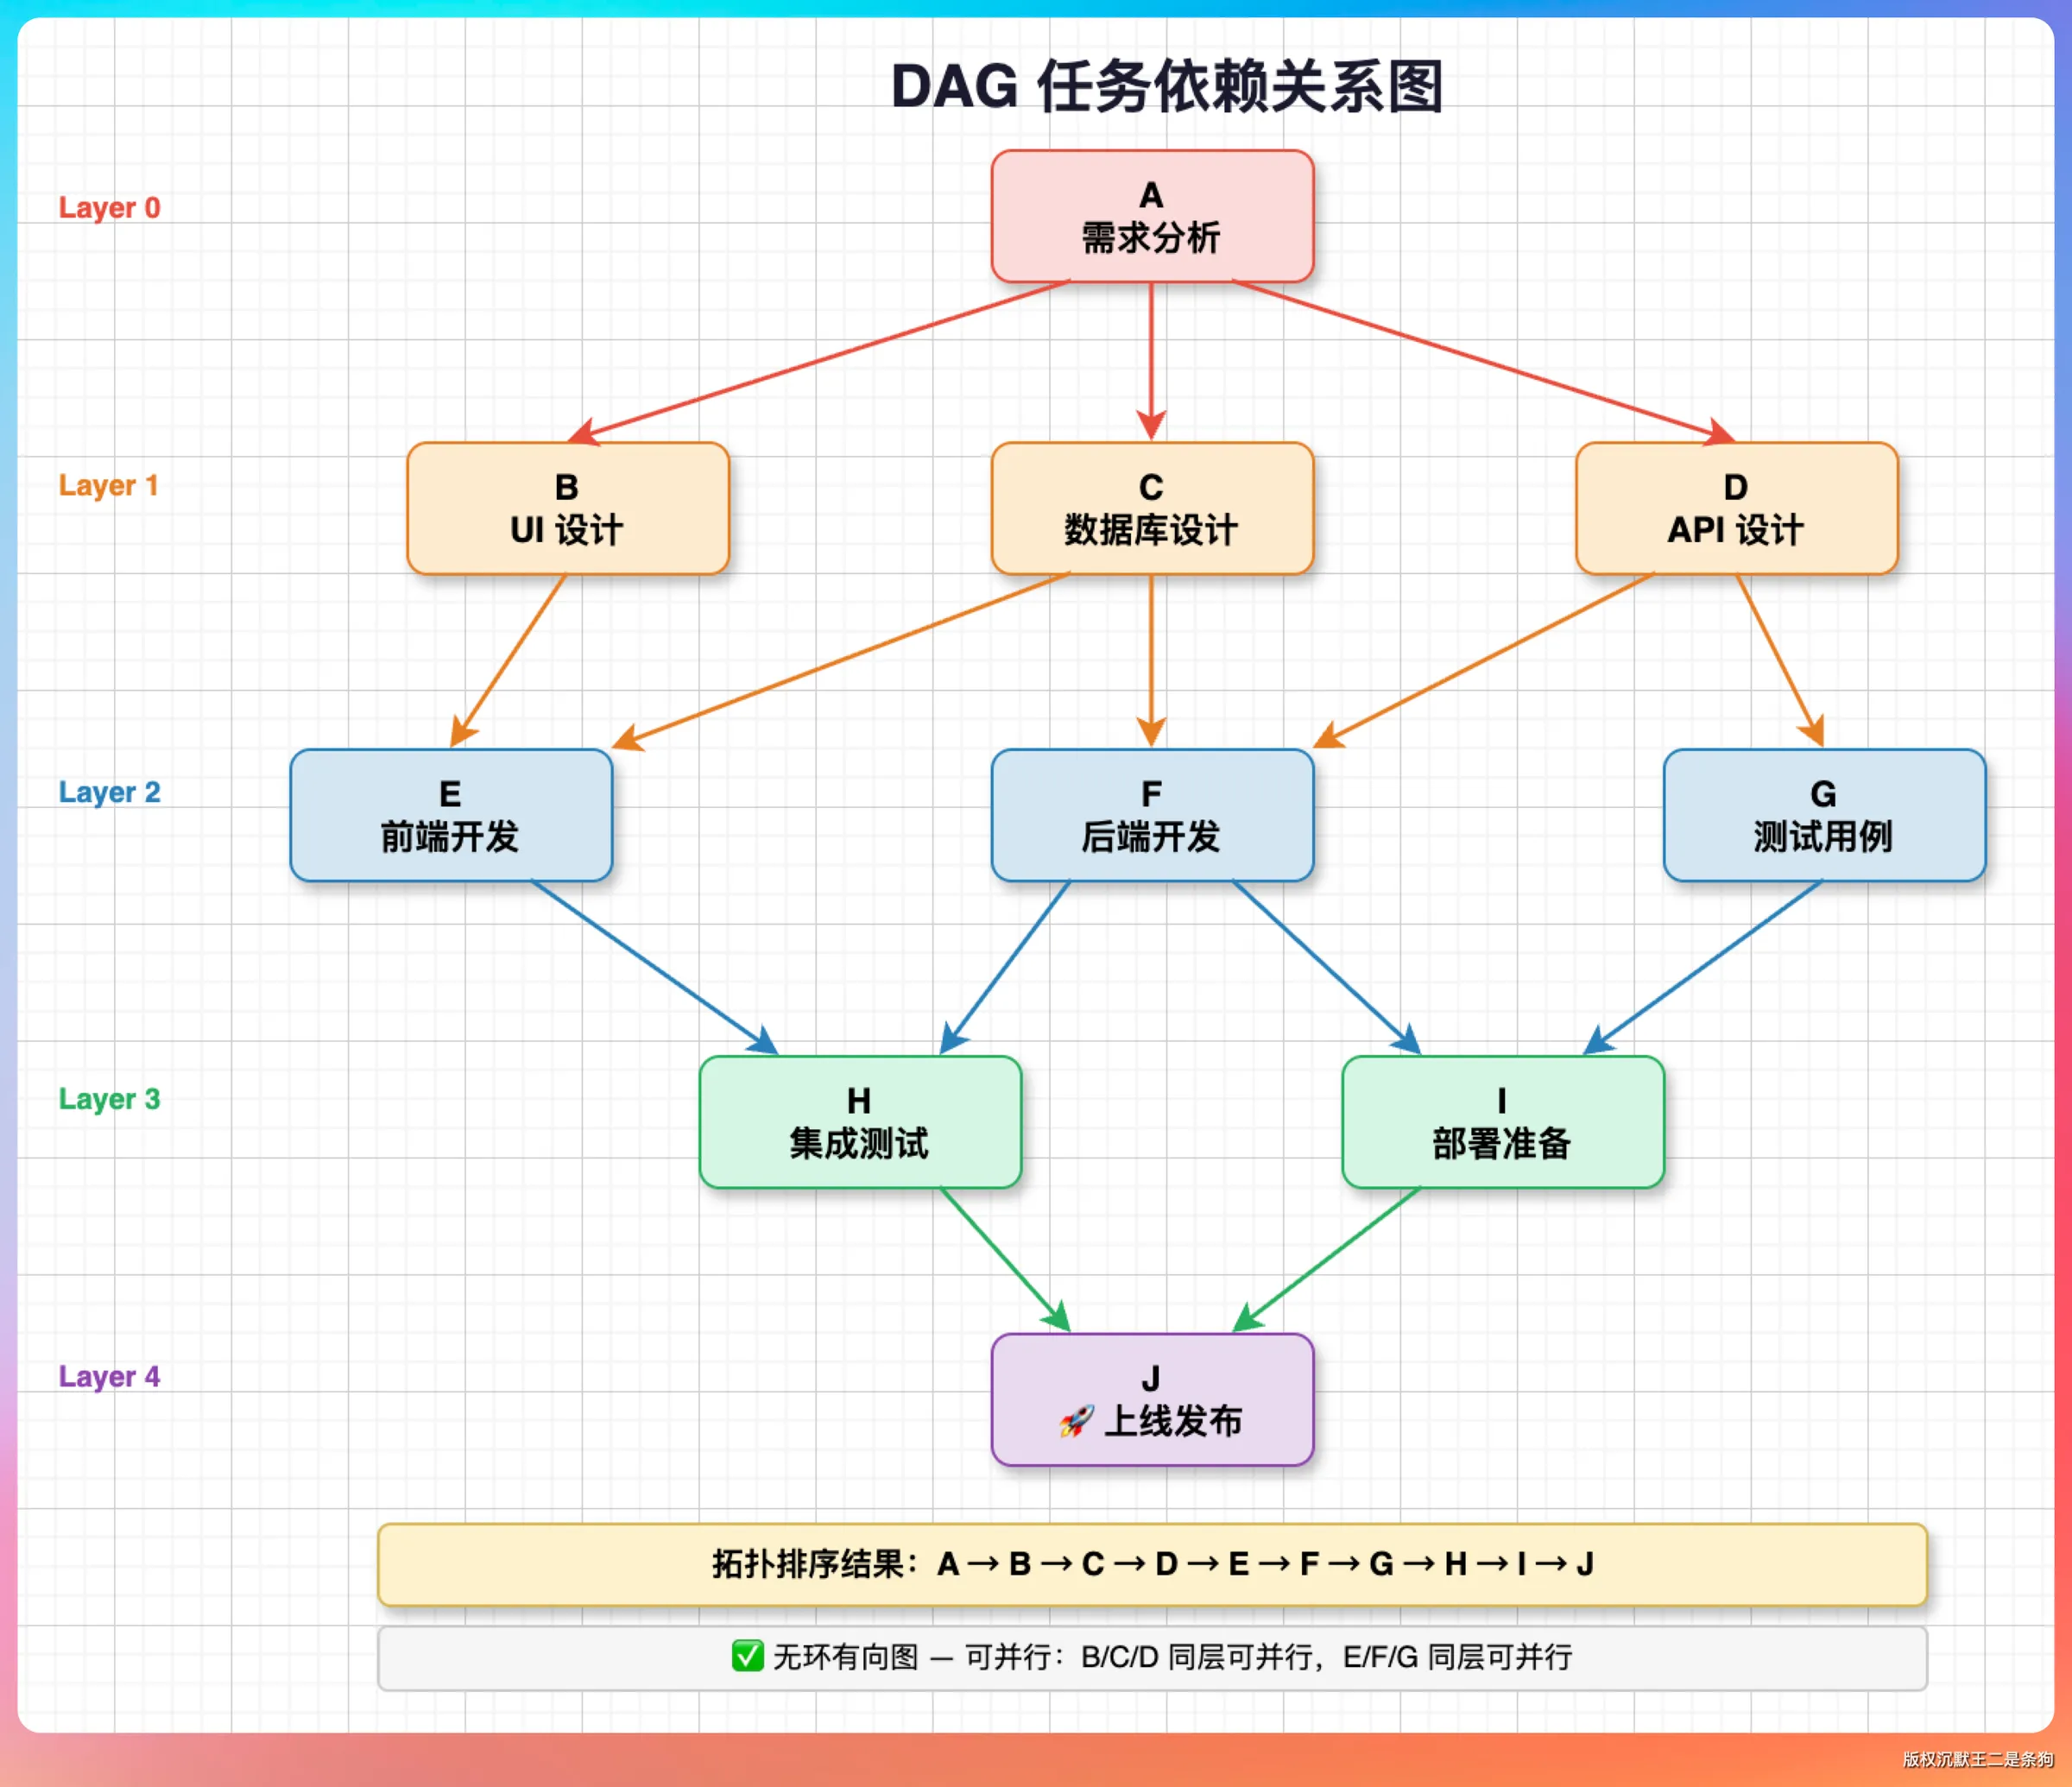
@派聪明 那DAG图是咋来的
点赞
回复1 取消回复
派聪明 2026年09月06日 23:03
DAG(有向无环图)是由**规划器(Planner)根据 LLM 生成的执行计划构建**出来的,具体过程如下: ##1. LLM生成任务列表用户输入复杂任务后,Planner 通过精心设计的提示词(明确 JSON输出格式、任务类型、约束规则),让 LLM 将任务分解为5-10 个子任务,每个任务包含: - id(如 task_1) - description(任务描述) - type(FILE_READ/FILE_WRITE/COMMAND 等) - **dependencies(依赖的任务 id)** ← 这是关键##2. 两遍扫描构建 DAG代码解析 LLM输出时采用两遍扫描: - **第一遍**:创建所有 Task 对象,同时做 ID重新映射(因为 LLM 生成的 ID 可能重复或乱序) - **第二遍**:根据每个任务声明的 `dependencies`,建立任务间的依赖关系和 `dependents`(被依赖关系) ##3. DAG 就此形成每个 Task 内部持有 `dependencies`(依赖谁)和 `dependents`(被谁依赖)两个列表,任务之间的依赖边就构成了一个有向无环图。例如“运行”依赖“编译”,“编译”依赖“写代码”,形成链式 DAG。 ##4.拓扑排序验证并展开构建完成后,`computeExecutionOrder()` 用 DFS拓扑排序把 DAG转成线性执行顺序,同时用 `visiting`集合**检测循环依赖**(如 A→B→C→A),有环则说明 LLM 生成的计划有问题,直接报错。 **简单说**:DAG 的“节点”是 LLM 分解出的子任务,“边”是 LLM 在计划中声明的依赖关系,代码负责解析这些声明并组装成图结构。
点赞
回复 取消回复
平原上的夏洛克 2026年09月05日 20:03
引用原文:第二遍再建立依赖关系
如何确定依赖关系?是由LLM确定的还是代码中确定的
点赞
回复 取消回复
平原上的夏洛克 2026年09月05日 19:57
@派聪明 在Plan-and-Execute中,任务是怎么分解的,怎么确定每个任务之间的依赖关系?
点赞
回复1 取消回复
派聪明 2026年09月05日 19:57
# Plan-and-Execute中的任务分解与依赖关系## 一、任务是怎么分解的由 **Planner规划器**调用一次 LLM完成分解: 1. **构建规划提示词**:给 LLM 发送包含规划规则和输出格式的 system prompt,然后附上用户任务2. **LLM输出 JSON 格式计划**,包含任务列表,每个任务含 id、description、type、dependencies提示词设计遵循三个原则: - **明确输出格式**:规定必须输出 JSON,并给出完整示例- **定义任务类型**:告诉 LLM 可用的6 种类型(PLANNING、FILE_READ、FILE_WRITE、COMMAND、ANALYSIS、VERIFICATION),让它知道什么场景用什么类型- **给出约束规则**:如每个任务必须有唯一 id(task_1、task_2...)、任务按执行顺序排列、复杂任务拆分为5-10 个子任务解析时采用**两遍扫描**:第一遍先创建所有任务并重新映射 ID(避免 LLM 生成的 ID重复或前向引用问题),第二遍再建立依赖关系。 ## 二、怎么确定任务间的依赖关系###1.依赖由 LLM声明在规划阶段,LLM根据任务的先后逻辑,在每个任务的 `dependencies` 字段中列出它依赖的前置任务 ID(如“写代码”依赖“创建项目”,“运行”依赖“编译”)。 ###2. 用 DAG 表示依赖图每个任务维护两个列表:`dependencies`(依赖谁)和 `dependents`(被谁依赖),形成**有向无环图(DAG)**。 ###3.拓扑排序确定执行顺序系统用 **DFS拓扑排序**把 DAG转成线性执行顺序: -找到入度为0 的节点(无依赖任务)→ 加入结果 →移除其出边 →重复直到处理完- 用 `visiting`集合检测**循环依赖**(如 A→B→C→A),有环则报错提示计划无法执行###4.运行时依赖校验任务执行前通过 `isExecutable()`检查:只有状态为 PENDING 且**所有依赖任务都已 COMPLETED** 时才可执行;若依赖失败,
点赞
回复 取消回复
是你啊 2026年08月29日 16:50
引用原文: Plan-and-Execute
@派聪明 这个模式是多agent吗
点赞
回复1 取消回复
派聪明 2026年08月29日 16:50
不是多 Agent。Plan-and-Execute 是**单 Agent** 内部的架构模式,核心思想是**规划和执行分离**,来自论文《Plan-and-Solve Prompting》。 具体来说: 1. **一个 Agent,两种角色阶段**:同一个 Agent 先让 LLM一次性生成完整执行计划(Planner 角色),然后按计划逐步执行(Executor 角色),中间不需要每一步都反复询问 LLM。 2. **它解决的问题是**:相比 ReAct模式(每步都要调用 LLM、等网络往返),Plan-and-Execute减少了 LLM调用次数,Token消耗更低、执行速度更快、可预测性更强。 3. **与多 Agent 的区别**:多 Agent 是多个独立 Agent协作(各有自己的 LLM上下文和职责);而 Plan-and-Execute 只是任务建模层面引入了 Task、DAG依赖、拓扑排序等机制,多个“任务”并非多个 Agent。 补充一点:文章中也提到可以**混合使用**——用 Plan-and-Execute 制定整体计划,每个任务内部用 ReAct执行,这仍然是架构模式的组合,而不是多 Agent 系统。
点赞
回复 取消回复
是你啊 2026年08月26日 18:59
引用原文:这里有个细节:LLM 生成的任务 ID 可能重复或格式不统一,我们需要重新映射。
@派聪明 为啥
点赞
回复3 取消回复
派聪明 2026年08月26日 19:00
因为 LLM生成的内容具有不确定性,直接使用它输出的任务 ID 会带来几个问题: **1. ID 可能重复** LLM 在生成多个任务时,可能输出两个 `task_1`,而 Task 对象以 ID 作为唯一标识(存在 `Map<String, Task>` 中),一旦重复,后面的任务会覆盖前面的,导致任务丢失或依赖错乱。 **2. 格式不统一** LLM 可能输出 `task_1`、`Task-2`、`task3`、`1`等各种风格,格式混乱会影响: -依赖关系的正确匹配(`dependencies` 里写的是 `Task-2`,但任务 ID 是 `task_2`,就找不到依赖) - 后续日志展示、可视化、错误定位**3. ID 与依赖可能前向引用** LLM 可能先定义 `task_2`,但 `task_2`依赖的 `task_1` 还没创建。所以代码采用**两遍扫描**: - 第一遍:忽略 LLM 的原始 ID,按顺序统一重新编号为 `task_1, task_2...`,同时建立“旧 ID → 新 ID”的映射表 `idMapping` - 第二遍:根据映射表把 LLM输出的依赖关系转换为新 ID,再建立任务间的依赖关系这样无论 LLM输出多不规范,系统内部拿到的都是一套规范、唯一、可执行的 ID体系,保证 DAG依赖和拓扑排序能正确运行。 **本质**:不要信任 LLM输出的结构化数据的细节格式,解析时要“清洗 +规范化”,这是处理 LLM输出的通用工程实践。
点赞
回复 取消回复
展开剩余 2 条回复
\-: 2026年08月15日 20:13
@派聪明 是怎么做的react和plan切换,具体的项目代码是在写在Runtime内吗
点赞
回复1 取消回复
派聪明 2026年08月15日 20:13
是怎么做的react和plan切换,具体的项目代码是在写在Runtime内 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
Lee 2026年08月14日 22:50
引用原文:当前的规划器只调用一次 LLM,生成完整计划。但复杂任务往往需要分层规划:
@派聪明 目前实现的plan-and-excute的PlanExecuteAgent 是无状态的吗?没有跨请求的对话历史吗?用户每次新请求都从零开始规划执行,发给 LLM 的 messages 里没有任何上次的信息吗?
点赞
回复1 取消回复
派聪明 2026年08月14日 22:50
这是我从文章中选择的一段文本:"当前的规划器只调用一次 LLM,生成完整计划。但复杂任务往往需要分层规划:" 目前实现的plan-and-excute的PlanExecuteAgent 是无状态的!没有跨请求的对话历史!用户每次新请求都从零开始规划执行,发给 LLM 的 messages 里没有任何上次的信息! 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
UoSerein 2026年08月02日 21:13
@派聪明 1.为什么用 DAG?2.有没有那种就是会存在循环依赖的任务还能采用DAG吗。3.Kahn 算法 vs DFS 你怎么选 4.如果有几千https://paicoding.com/logout个任务怎么优化?
点赞
回复1 取消回复
派聪明 2026年08月02日 21:13
1.为什么用 DAG!2.有没有那种就是会存在循环依赖的任务还能采用DAG。3.Kahn 算法 vs DFS 你怎么选 4.如果有几千https://paicoding.com/logout个任务怎么优化! 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
UoSerein 2026年08月02日 20:38
@派聪明 我有几个问题:1.为什么用 DAG?2.有没有那种就是会存在循环依赖的任务还能采用DAG吗。3.Kahn 算法 vs DFS 你怎么选 4.如果有几千https://paicoding.com/logout个任务怎么优化?
点赞
回复1 取消回复
派聪明 2026年08月02日 20:38
我有几个问题:1.为什么用 DAG!2.有没有那种就是会存在循环依赖的任务还能采用DAG。****** 算法 vs DFS 你怎么选 4.如果有几千https://paicoding.com/logout个任务怎么优化! 当前模型还在开发当中,请右上角下拉框切换到其他模型
点赞
回复 取消回复
Kal-El 2026年07月31日 09:17
引用原文:规划一次,执行多次
planner规划调用一次 每个任务都是一个小的React也得调用LLM 并没有减少反而增加了
点赞
回复 取消回复

目录