
读懂 AI Infra,看这六个关键词就够了
2025年初,DeepSeek的走红让更多人明白,不仅仅是模型本身,训练和推理过程中工程上的优化同样重要。元旦假期看了朱亦博老师的一篇帖子,很受启发,2025年过去了,我想应该尝试来把亦博老师总结的25年AI Infra六个重点方向尽可能以一些简单易懂的方式向大家介绍一下,也希望让更多的同学可以对这一年里AI Infra的发展有一些简要的了解。
作者:dorianbian,larrylyyu
一、分布式推理
前置知识点的一句话理解:
1. 混合专家模型 MoE:由门控网络+若干个专家模型组成,门控网络负责选择适合某类问题的专家模型进行激活并处理请求,不同的专家模型擅长处理不同领域的问题,单一请求一般只激活少部分专家进行处理,即稀疏激活特性。
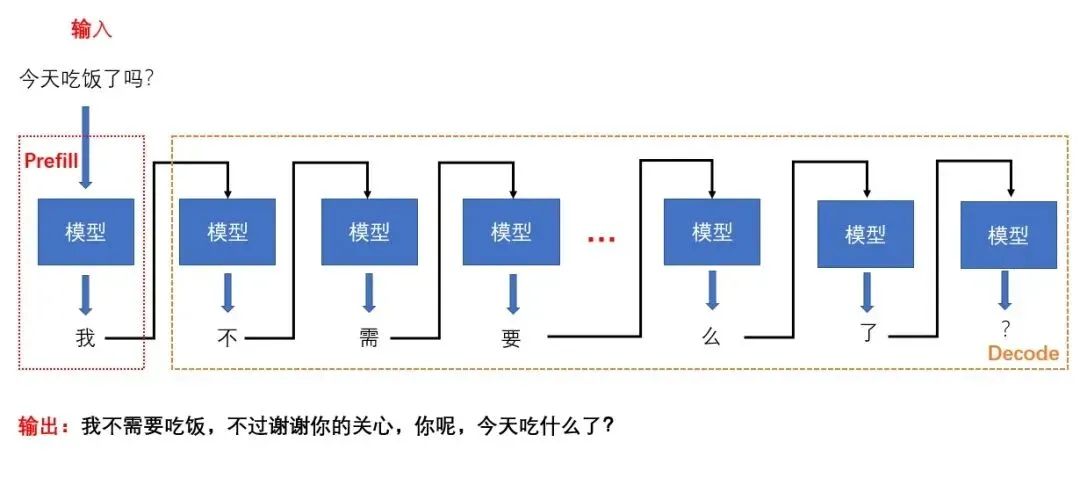
2. 自回归仅解码架构 Decode-Only:基于前文逐步生成下一个词的方式,推理分为prefill和decode两个阶段,prefill将输入计算为K、V,decode基于前序得到的K、V逐词生成输出,意味着P和D两个阶段对资源的需求完全不同。
目前主流的MoE模型 + Decoder-Only推理架构,针对MoE的稀疏激活、推理不同阶段资源需求不同的特性,进一步将不同阶段或模块解耦进行部署以提升效率,主要为以下三个方向:
1.PD分离的持续演进
Decode-Only最初是Prefill和Decode两个阶段混合部署在一起的,在优化TTFT(首个token响应时间)和TPOT(后续平均每个token生成时间)两个核心指标的过程中,出现了两个棘手的核心问题:Prefill-Decode两个阶段的强干扰和资源分配与并行策略的耦合。
(1)PD分离部署的提出
为了通过解决Prefill和Decode两个阶段资源需求不同而带来的强干扰和并行策略耦合的问题,来提升TTFT和TPOT两个核心指标,DistServe论文首次提出了PD分离的概念。
Prefill阶段:该阶段是将输入的prompt转换为Q、K和V并生成首个token,同时把K、V存储用于Decode阶段生成输出使用,因此预填充阶段通常是计算密集型的,核心优化目标是TTFT。
Decode阶段:该阶段是使用输入的prompt和生成的首个token的K、V值,来生成接下来的一个token1,再使用输入prompt+首token+token1来生成token2,依次迭代直到完成全部输出,因此解码阶段通常是访存密集型的,核心优化目标是TPOT。
以一张图来直观说明两个阶段的关系(同时也可以思考下,P和D两个过程中,为什么只存K、V cache,而不存Q cache?):
 Prefill和Decode阶段间KV cache的传输:在具备IB(或Roce)网络的环境下,把P、D两个阶段分别部署在不同的设备上,或在一个设备内把P、D两个阶段分别部署在不同的GPU上,这样就规避了前文中提到的不同阶段强干扰和并行策略耦合的问题,具备了独立优化TTFT和TPOT的可行性。下图为P、D分离部署的逻辑架构图:
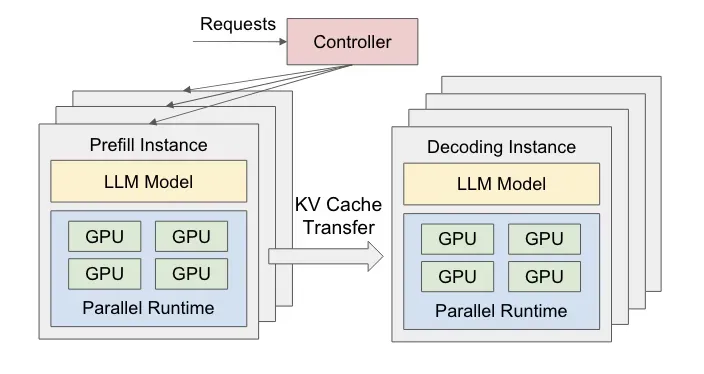
根据论文实验数据和一些具有大规模用户的推理服务部署实践情况来看,同样的资源,PD分离模式部署确实可以在相同TTFT、TPOT要求下承载更多的推理请求,或者为相同的推理请求提供更优的TTFT、TPOT体验。
(2)PD分离部署的进一步优化
PD分离的提出,解决了预填充和解码两个阶段优化过程中相互强干扰和强耦合的问题,大幅优化了推理服务过程中的吞吐量和时延等指标,但在工程实践中,特别是混合长度请求的场景下,存在KV的生产者-消费者失衡的问题:预填充实例处理请求的速度和解码实例消费的速度不匹配,导致部分实例资源利用过低或过载的问题。为了应对这样的问题,DOPD论文提出了动态调整P、D实例的策略,从而进一步提升资源利用率和推理服务效率。
注意到:推理过程中P、D实例负载很大情况下取决于推理请求的长度,而不同推理请求的长度存在较大差异。因此动态PD分离应该具备以下能力,来解决复杂推理请求场景下P、D失衡问题:
1. 具备推理请求短期负载的预测能力
2. 结合短期预测和当前实例负载计算出建议的P、D实例配比,并且该阶段的时间&资源开销是极小的
3. 缓解高并发场景下混合长度请求给预填充 - 解码解耦架构带来的干扰问题
4. 基于建议配比,实现P、D实例的自动扩缩容
DOPD论文中,设计了一种动态最优PD分离调节系统,主要包括五个组件:资源监控器、请求路由器、KV通信连接器、P&D实例管理器和请求调度器。该系统架构图如下: 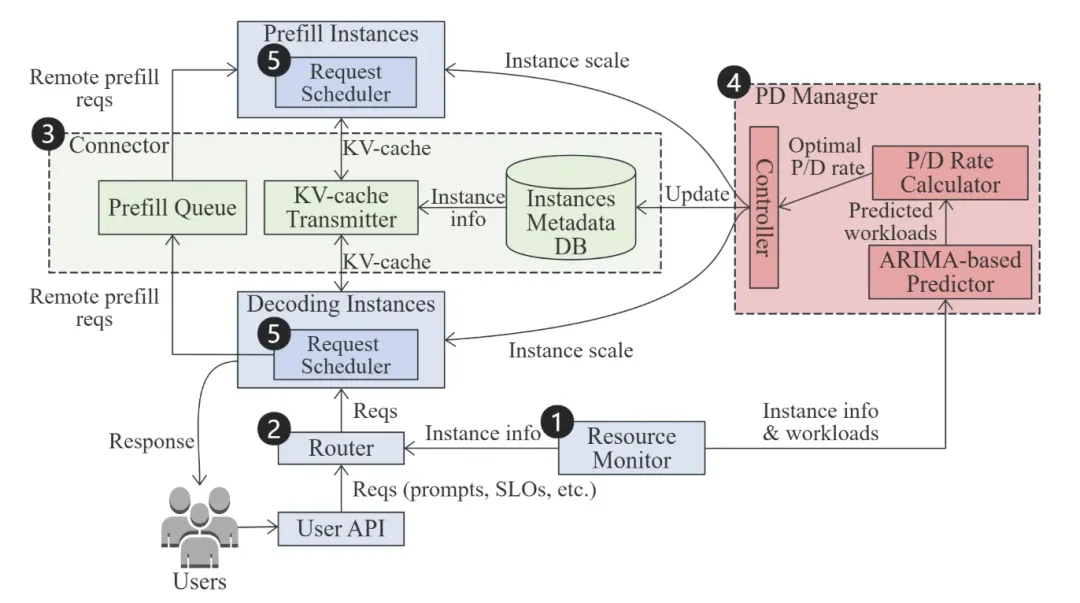
工作原理简述为,资源管理器负责监测P、D实例集群的各项运行数据,并将这部分数据提供给请求调度器、P&D实例管理器和请求路由器。P、D集群各自实例的数量,和其张量并行度(TP),则由P&D实例管理器来实时调整,确保整体资源利用率处于合理水位。当一个用户请求进来后,请求路由器将结合各D实例上的KV命中率和负载情况选择该请求的目的D实例,而需要远端P实例进行预填充时,则依赖KV通信连接器与远端P实例进行通信。当高并发且混合长度请求时,请求调度器会将请求分组进行批处理,以提升系统整体的吞吐或时延效率。
根据论文实验数据来看,动态PD分离的实践除进一步优化推理服务整体的吞吐和时延外,尤其适合负载波动大、混合长度请求的场景。
2.AFD的提出
由于预填充和解码两个阶段对资源需求显著不同,前文已经介绍了PD分离相关内容。那么是否可以...
未能定位到原文的划线
企业级Agent工作流编排项目PaiFlow
Vibe Coding版本的PaiAgent
派聪明RAG AI知识库Java版本+Go版本
微服务 PmHub、技术派、MYDB
求职派JobClaw(OpenClaw/Hermes架构
PaiCLI(类似Claude Code的Agent
派简历(代码已完成)
等实战项目。
1. 微信扫右侧的优惠券加入知识星球
2. 解锁星球的实战项目教程和源码: 项目源码+教程获取
真诚点赞 诚不我欺
回复