
好好的系统,为什么要分库分表?(完结)
球友们好,今天来跟大家聊聊分库分表。
什么是分库分表
分库分表是在海量数据下,由于单库、表数据量过大,导致数据库性能持续下降的问题,演变出的技术方案。
分库分表是由分库和分表这两个独立概念组成的,只不过通常分库与分表的操作会同时进行,以至于我们习惯性的将它们合在一起叫做分库分表。
通过一定的规则,将原本数据量大的数据库拆分成多个单独的数据库,将原本数据量大的表拆分成若干个数据表,使得单一的库、表性能达到最优的效果(响应速度快),以此提升整体数据库性能。
为什么分库分表
单机数据库的存储能力、连接数是有限的,它自身就很容易会成为系统的瓶颈。当单表数据量在百万以里时,我们还可以通过添加从库、优化索引提升性能。
一旦数据量朝着千万以上趋势增长,再怎么优化数据库,很多操作性能仍下降严重。为了减少数据库的负担,提升数据库响应速度,缩短查询时间,这时候就需要进行分库分表。
为什么需要分库?
容量
我们给数据库实例分配的磁盘容量是固定的,数据量持续的大幅增长,用不了多久单机的容量就会承载不了这么多数据,解决办法简单粗暴,加容量!
连接数
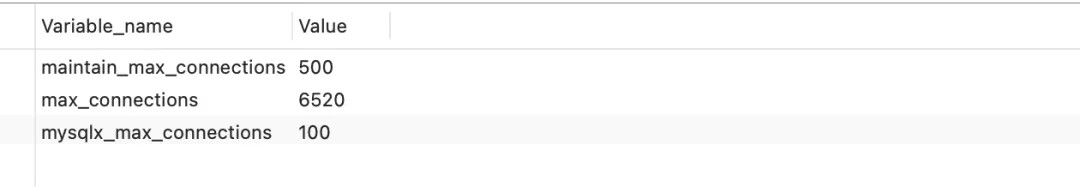
单机的容量可以随意扩展,但数据库的连接数却是有限的,在高并发场景下多个业务同时对一个数据库操作,很容易将连接数耗尽导致too many connections报错,导致后续数据库无法正常访问。
可以通过max_connections查看 MySQL 最大连接数。
show variables like '%max_connections%'
将原本单数据库按不同业务拆分成订单库、物流库、积分库等不仅可以有效分摊数据库读写压力,也提高了系统容错性。
为什么需要分表?
做过报表业务的同学应该都体验过,一条 SQL 执行时间超过几十秒的场景。
导致数据库查询慢的原因有很多,SQL 没命中索引、like 扫全表、用了函数计算,这些都可以通过优化手段解决,可唯独数据量大是 MySQL 无法通过自身优化解决的。慢的根本原因是InnoDB存储引擎,聚簇索引结构的 B+tree 层级变高,磁盘 IO 变多查询性能变慢,详细原理自行查找一下,这里不用过多篇幅说明。
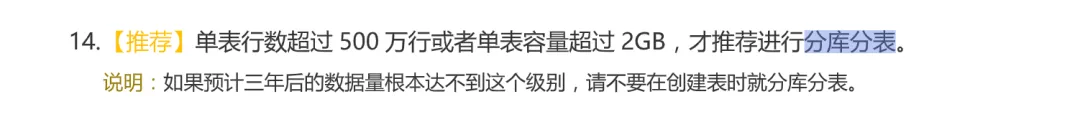
阿里的开发手册中有条建议,单表行数超 500 万行或者单表容量超过 2GB,就推荐分库分表,然而理想和实现总是有差距的,阿里这种体量的公司不差钱当然可以这么用,实际上很多公司单表数据几千万、亿级别仍然不选择分库分表。
什么时候分库分表
那到底什么情况下会用分库分表呢?
分库分表要解决的是现存海量数据访问的性能瓶颈,对持续激增的数据量所做出的架构预见性。
是否分库分表的关键指标是数据量,我们以fire100.top这个网站的资源表 t_resource为例,系统在运行初始的时候,每天只有可怜的几十个资源上传,这时使用单库、单...
未能定位到原文的划线
企业级Agent工作流编排项目PaiFlow
Vibe Coding版本的PaiAgent
派聪明RAG AI知识库Java版本+Go版本
微服务 PmHub、技术派、MYDB
求职派JobClaw(OpenClaw/Hermes架构
PaiCLI(类似Claude Code的Agent
派简历(代码已完成)
等实战项目。
1. 微信扫右侧的优惠券加入知识星球
2. 解锁星球的实战项目教程和源码: 项目源码+教程获取
真诚点赞 诚不我欺
回复